

一、概述
GPURP 的 Shading Pipeline 整体架构参考 Unreal Engine,具体实现细节主要参考 Frostbite 的公开分享。管线共设计了六种 Shading Model:
- Default Shading:标准 Cook-Torrance PBR
- Clear Coat Shading:PBR 基础上附加透明涂层
- Cloth Shading:棉布、绒毛、丝绸
- Hair Shading:毛发透射/散射及双高光
- Subsurface Shading:屏幕空间散射与透射,Beckmann 高光
- Eye Shading:眼球折射与次表面效果
二、六种 Shading Model 的定位
| Model | 目标表面 | 核心特征 | 额外开销 |
|---|---|---|---|
| Default | 通用 PBR 表面 | Cook-Torrance + Renormalized Burley | 基线 |
| Clear Coat | 车漆、贴膜表面 | 双层结构:底层 PBR + 顶层无粗糙度 Specular | +1 lobe 计算 |
| Cloth | 棉布、天鹅绒、丝绸 | Ashikhmin Velvet or Charlie Sheen NDF | 替换 NDF |
| Hair | 毛发 | Marschner 双高光(R + TRT)+ 透射 | +前向散射 |
| Subsurface | 皮肤、蜡、玉石 | 屏幕空间散射 + 屏幕空间透射 + Beckmann | +Post Pass |
| Eye | 眼球 | 双层折射 + 虹膜次表面 | +折射偏移 |
设计上每个 Model 通过 GBuffer 中的 Shading Model ID(2-bit 或 3-bit)标识,Deferred Pass 中 branch 到对应的 BRDF 计算。代价是 GBuffer 需要预留 Model ID 的存储空间,以及 Shader 中的分支开销:GPU 的 SIMD 架构下,同一 Wave 内不同 Model 会导致 divergence。
2.1 GBuffer 布局与 Model ID 编码
6 种 Model 需要 3-bit 编码(支持最多 8 种)。Model ID 存储在 GBuffer2 的 Alpha 通道高 3 位:
GBuffer0: Albedo.rgb + Metallic (RGBA8)
GBuffer1: Normal.xy (RG16F) + Roughness (B8) + AO (A8)
GBuffer2: Emissive.rgb (R11G11B10F) 或 CustomData.rgb + ModelID (RGBA8)
GBuffer3: Velocity.xy (RG16F, optional)
各通道的设计权衡:
GBuffer0 (RGBA8, 4 bytes/pixel)
- RGB 存储 Albedo,采用 sRGB 编码以充分利用低值区间的精度。8-bit 在暗色调下可能产生色阶,但 Albedo 的视觉容差较高(人眼对漫反射颜色的精度敏感度低于对法线方向的敏感度),实测未观察到可见 banding。
- A 通道存储 Metallic。Metallic 在物理上是二值的(金属 = 1,非金属 = 0),中间值仅存在于过渡区域(如金属表面的灰尘、锈蚀),8-bit 精度绰绰有余。
GBuffer1 (RGBA16 Mixed)
- RG 两通道存储法线的 XY 分量,采用 Octahedron 编码,将单位球面映射到 [-1,1]² 正方形。RG16F 提供 10-bit 尾数精度,对应法线方向误差小于 0.1°。对比 RG8 方案(误差约 0.7°),16F 在镜面高光边缘消除了量化阶梯。Z 分量通过
sqrt(1 - x² - y²)重建。 - B 通道存储 Perceptual Roughness(线性映射到 [0,1]),8-bit 精度足够:Roughness 的 1/256 步长在视觉上不可分辨。
- A 通道存储 Ambient Occlusion,8-bit。AO 本身就是低频数据,精度要求不高。
GBuffer2 的两种模式
管线支持两种 GBuffer2 格式,通过全局 Keyword 切换:
- Emissive 模式 (R11G11B10F):3 通道全部用于发光色,无 Alpha 通道。此模式下 Model ID 退化为固定值(仅支持 Default Model),适用于不需要多 Model 的轻量场景。
- CustomData 模式 (RGBA8):RGB 存储 per-Model 自定义数据(如 Clear Coat 的涂层厚度、Subsurface 的散射 Profile Index),A 通道的高 3 位存储 Model ID,低 5 位保留给额外自定义标志位。
选择 R11G11B10F 的原因在于带宽:每像素 4 bytes,而 RGBA16F 是 8 bytes。在 1080p 4 张 GBuffer 的配置下,单帧 GBuffer 的总读写带宽约为 1920×1080×(4+4+4+4)×2 = 66MB(读+写各一次)。若 GBuffer1 和 GBuffer2 都升级为 16F 格式,带宽将增加约 30%,对带宽受限的场景(移动端、低端 PC)影响显著。
实际编码中 Model ID 与其他数据共享通道,因此需要在 Lighting Pass 中执行 bit extraction:
uint modelId = (uint)(gbuffer2.a * 255.0) >> 5; // 高 3 位
half customBits = frac(gbuffer2.a * 255.0 / 32.0) * 32.0 / 255.0; // 低 5 位保留给自定义数据
解码过程:gbuffer2.a 从纹理采样得到 [0,1] 浮点值,乘以 255 恢复为整数,右移 5 位得到高 3 位的 Model ID(取值 0-7)。低 5 位通过取模运算提取,重新归一化后作为 Custom Data 传递给各 Model 的 Shading 函数。
各 Model 对 Custom Data 的使用:
| Model ID | Model | Custom Data (5-bit) |
|---|---|---|
| 0 | Default | 未使用 |
| 1 | Clear Coat | Coat Roughness(量化到 32 级) |
| 2 | Cloth | Sheen Tint Index |
| 3 | Hair | Scatter(透射强度) |
| 4 | Subsurface | Profile Index(0-31 种散射曲线) |
| 5 | Eye | Iris Depth |
| 6-7 | Reserved | — |
Divergence 的实际代价取决于场景中不同 Model 的空间分布。对于 fullscreen Deferred Lighting Pass,如果一个 8×8 Tile 内所有像素属于同一 Model(常见于大面积墙壁或地面),Branch 开销为零。混合区域(如皮肤与布料交界)会导致 Wave 内部分 Lane 空转。测试表明,在典型室内场景中 divergence 导致的性能损失约 3-5%,属于可接受范围。
替代方案是为每种 Model 生成独立的 Stencil Mask,然后用 Stencil Test 分 Pass 渲染。这种方式消除了 Shader Branch,但引入了多次 Fullscreen Pass 的 Bandwidth 开销(每个 Pass 都要读取 GBuffer)。在 Model 数量 ≤ 4 时 Stencil 方案更优;Model 数量 > 4 时 Branch 方案的总带宽开销更低。本管线选择 Branch 方案。
三、直接光:Diffuse 模型
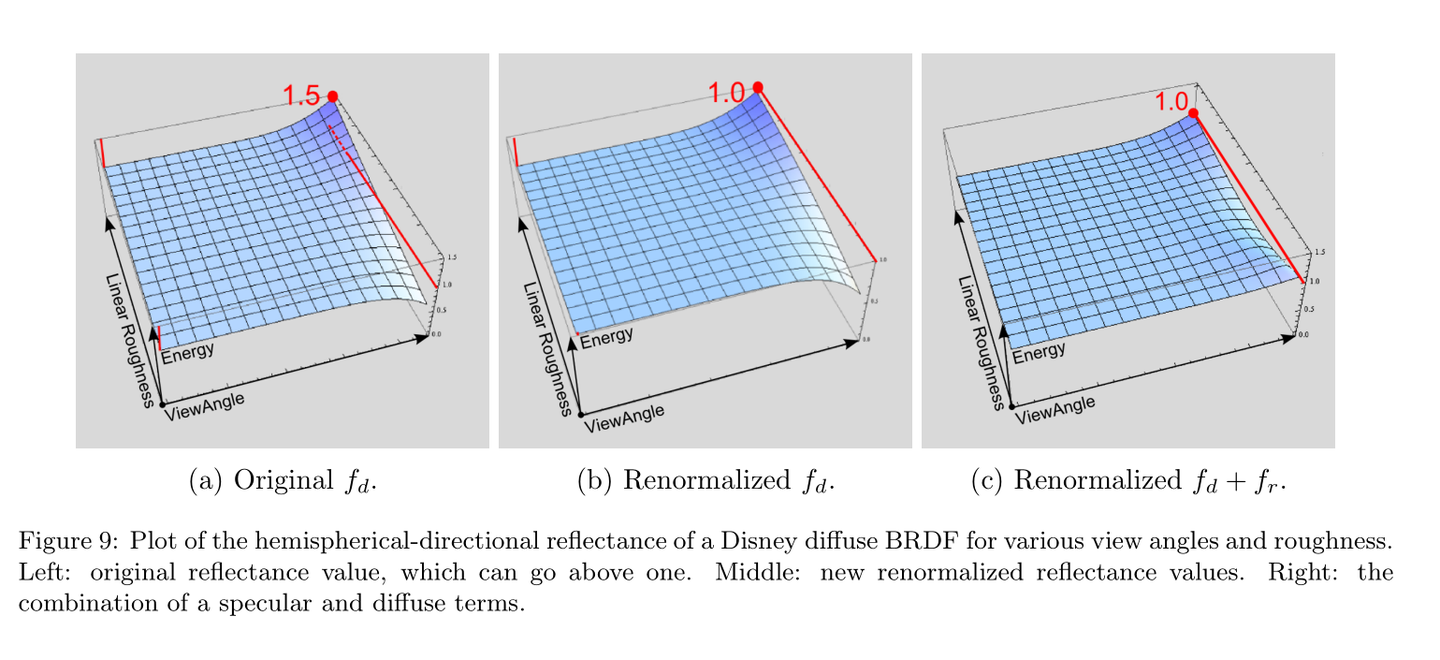
漫反射项放弃常见的 Lambert 和标准 Burley Diffuse,改用 Frostbite 提出的 Renormalized Burley Diffuse。其优势在于对 Diffuse BRDF 做了能量归一化处理,保证在任何粗糙度下漫反射能量守恒。
3.1 Lambert 与 Burley 的能量问题
Lambert Diffuse 的定义为 f_d = albedo / π,隐含假设是入射光在半球上均匀散射。Disney/Burley Diffuse 引入了粗糙度相关的掠射角增亮效果,模拟粗糙表面的逆反射(retro-reflection)行为。但标准 Burley 实现存在能量不守恒问题:对 Burley Diffuse 在半球上积分,结果不等于 1,粗糙度越高,积分值越大于 1,漫反射项可能返回超过入射能量的值。
3.2 标准 Burley Diffuse 的数学形式
Disney 原始 Burley Diffuse 的公式为:
f_d = (albedo / π) * (1 + (F_D90 - 1)(1 - NdotL)^5) * (1 + (F_D90 - 1)(1 - NdotV)^5)
其中 F_D90 = 0.5 + 2 * roughness * cos²(θ_d),θ_d 为 Half Vector 与 Light Direction 的夹角(即 LdotH)。
对 f_d 在半球上做 Cosine-Weighted 积分:
E(roughness, NdotV) = ∫_Ω f_d(l, v) * (NdotL) dω_l
当 roughness = 0 时,F_D90 = 0.5 + 0 = 0.5,Schlick 项不等于 1,积分值约为 0.97(略低于 Lambert 的 1.0)。当 roughness = 1 时,F_D90 在掠射角处可达 2.5,两个 Schlick 项的乘积在掠射角方向显著增大,积分值达到约 1.51。roughness = 1 的表面在 Burley Diffuse 下会辐射出超过入射能量 51% 的漫反射光。
3.3 Renormalized 版本的修正
Frostbite 的 Renormalized 版本通过引入 energyFactor = lerp(1.0, 1.0/1.51, roughness) 对积分值做归一化。1.51 这个常数是 Burley Diffuse 在 roughness = 1.0 时半球积分的近似值。乘以这个系数后,任何粗糙度下的能量积分结果收敛到 1.0 附近。
同时引入 energyBias = lerp(0.0, 0.5, roughness) 修正 F_D90 的基础值。两者的协同作用:energyBias 调整掠射角增亮的强度曲线,energyFactor 在最终结果上做全局归一化。这一处理使得修正后的 BRDF 在整个 (NdotV, roughness) 参数空间内的半球积分值均在 [0.98, 1.02] 范围内,误差小于 2%。
精确的数学推导过程:
- 令
I(r) = ∫_Ω f_burley(l, v, r) * NdotL dω,其中 r = roughness - 数值积分求出
I(0) ≈ 0.97,I(1) ≈ 1.51 - 假设 I(r) 近似为线性函数:
I(r) ≈ lerp(1.0, 1.51, r)(实际略有非线性但误差在 3% 以内) - 令
energyFactor(r) = 1.0 / I(r) = 1.0 / lerp(1.0, 1.51, r) ≈ lerp(1.0, 1.0/1.51, r)
最后一步的近似利用了 1/lerp(a,b,t) ≈ lerp(1/a, 1/b, t) 在 a 和 b 接近时的有效性(相当于对倒数做线性插值)。
3.4 实现代码
half DisneyDiffuseRenormalized(half NdotV, half NdotL, half LdotH, half roughness)
{
    half energyBias   = lerp(0.0, 0.5, roughness);
    half energyFactor = lerp(1.0, 1.0 / 1.51, roughness);
    half fd90 = energyBias + 2.0 * LdotH * LdotH * roughness;
    half lightScatter = F_Schlick(1.0, fd90, NdotL);
    half viewScatter  = F_Schlick(1.0, fd90, NdotV);
    return lightScatter * viewScatter * energyFactor;
}
逐行解读:
energyBias控制fd90(掠射角处的反射率)的最小值。roughness = 0 时 fd90 仅由2 * LdotH^2 * roughness决定(趋近于 0,即 Lambert 行为);roughness = 1 时 fd90 最小为 0.5,保证掠射角有明显增亮。F_Schlick(1.0, fd90, angle)计算1 + (fd90 - 1) * (1 - angle)^5,即从正视角的 1.0 过渡到掠射角的 fd90。- 最终
lightScatter * viewScatter产生双向掠射角效应(入射方向和观察方向都参与),乘以energyFactor归一化。
从视觉表现上,随着粗糙度增大,掠射角区域会呈现更高的亮度。在实际场景中颜色丰富度较高时这一差异不太显著,但从物理正确性角度仍然值得采用。
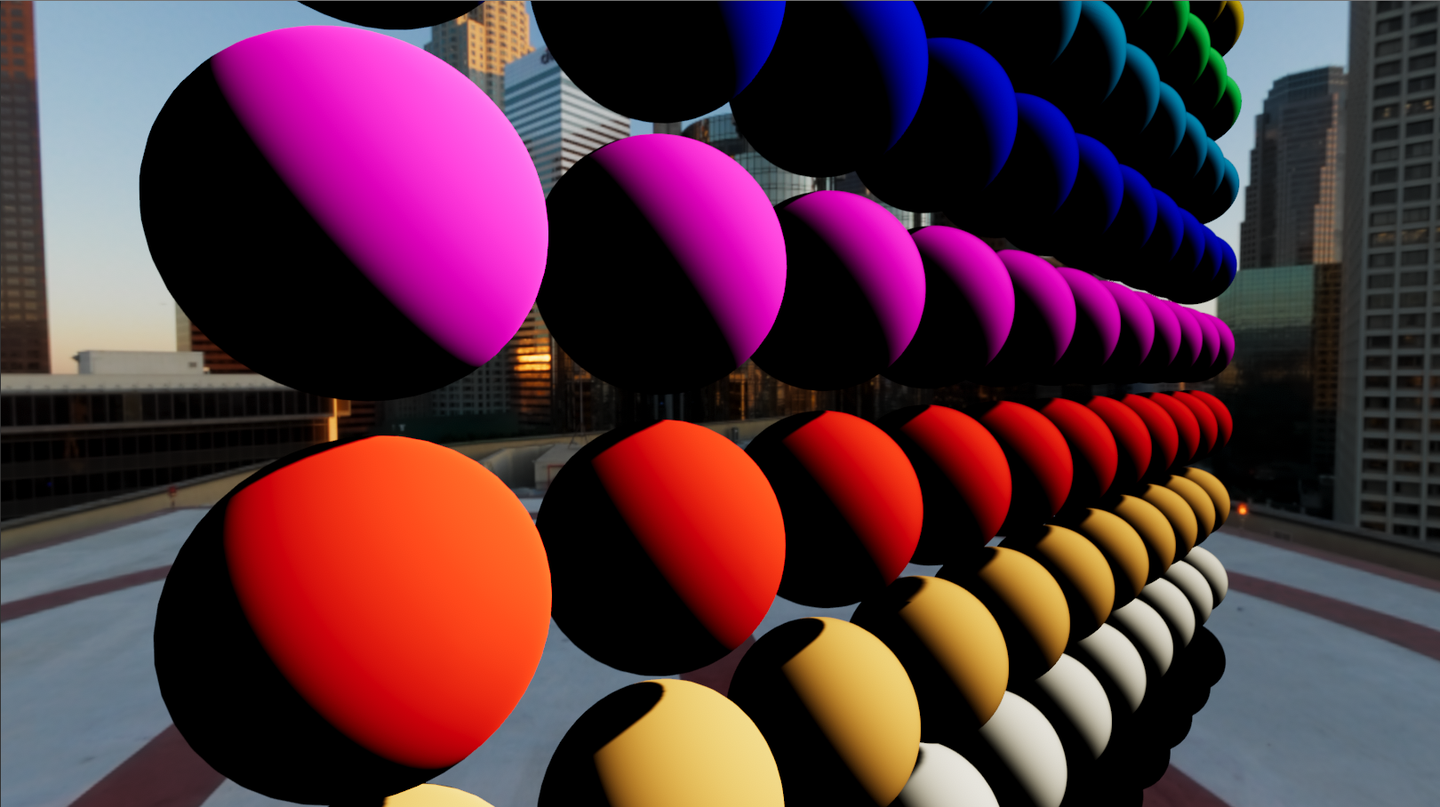
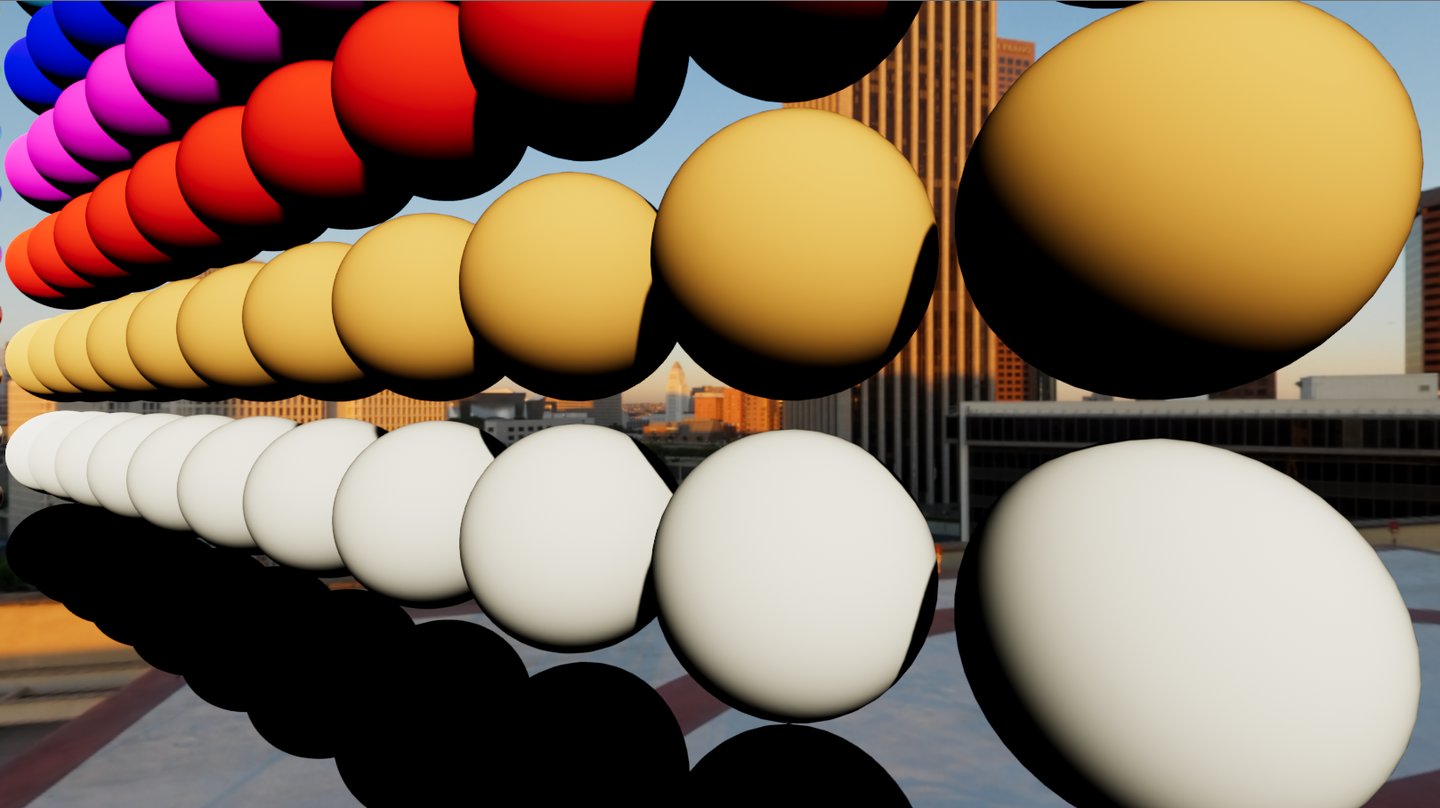
3.5 三种 Diffuse 模型的半球积分对比
| Roughness | Lambert | Burley (原始) | Renormalized Burley |
|---|---|---|---|
| 0.0 | 1.000 | 0.966 | 0.987 |
| 0.25 | 1.000 | 1.096 | 0.998 |
| 0.5 | 1.000 | 1.228 | 1.003 |
| 0.75 | 1.000 | 1.369 | 1.008 |
| 1.0 | 1.000 | 1.510 | 1.012 |
积分值使用 4096 samples 的 Monte Carlo 积分在 NdotV = 0.5 处计算。Lambert 恒等于 1.0(定义上能量守恒),Burley 原始版本的超额能量随 Roughness 单调递增,Renormalized 版本的最大偏差为 1.2%。
3.6 性能开销分析
相比 Lambert(1 次乘法),Renormalized Burley 增加了 2 次 F_Schlick 计算(各含 1 次 pow5 + 2 次乘法 + 1 次 lerp)和 3 次 lerp。总计约增加 12 条 ALU 指令。在 Deferred Lighting Pass 中这些指令被 Texture Fetch Latency 遮蔽(GBuffer 读取的 latency 约 200-400 cycles,远超 12 条 ALU),实测 GPU 时间无可观测增长。
pow5 的实现采用 x2 = x*x; return x2*x2*x,绕开 pow(x, 5.0) 的 transcendental 指令延迟(pow 在部分 GPU 上映射到 exp2(5*log2(x)),需要 SFU 执行,throughput 显著低于 ALU)。
四、直接光:Specular 模型
高光项使用标准 Cook-Torrance 微表面模型。完整 Cook-Torrance BRDF 的数学形式为:
f_s = D(H) * F(V,H) * G(L,V,H) / (4 * NdotL * NdotV)
实现上将分母项与几何遮蔽项 G 合并为 Visibility 项以减少运算:
V = G / (4 * NdotL * NdotV)
这样 BRDF 简化为 f_s = D * V * F,减少了一次除法。
4.1 D 项:GGX NDF
GGX(Trowbridge-Reitz)分布函数的推导来自微表面理论。假设微表面法线 m 的分布满足归一化条件 ∫ D(m) * (NdotM) dω_m = 1(微面元在宏观法线方向上的投影面积等于宏观表面面积),GGX 选择的具体函数形式为:
D_GGX(NdotH, α) = α² / (π * (NdotH² * (α² - 1) + 1)²)
其中 α = roughness²(perceptual roughness 到 physical roughness 的映射)。这一二次映射的原因是人眼对粗糙度变化的感知接近平方关系:perceptual roughness 在 0.5 时对应的物理粗糙度 α = 0.25,此时高光 Lobe 已经明显展开。如果直接使用线性映射(α = roughness),视觉上大部分有效粗糙度范围被压缩在 [0, 0.3] 区间内,艺术家调参体验很差。
GGX 相比 Beckmann 具有更长的尾部(heavy tail),在高光边缘产生更自然的衰减。具体的尾部行为对比:当 NdotH 偏离 1.0 时,Beckmann 的衰减为 exp(-tan²θ/α²)(高斯衰减,指数级下降),GGX 的衰减为 1/(cos²θ * (α²-1) + 1)²(幂律衰减,多项式级下降)。在 θ > 45° 的区域,GGX 的值可比 Beckmann 高一个数量级,这解释了 GGX 高光边缘更亮的视觉特征。
展开公式中的 (NdotH² * (α² - 1) + 1) 项:令 t = NdotH²,代入得 t*(α²-1)+1 = t*α² + (1-t) = α²*cos²θ + sin²θ。当 α = 1 时该项恒等于 1,D 退化为 1/π(均匀分布);当 α → 0 时该项在 NdotH = 1 处为 α²(极小),D 趋向 Dirac δ 函数(完美镜面)。
half D_GGX(half NdotH, half roughness)
{
    half a2 = roughness * roughness;
    half d = (NdotH * a2 - NdotH) * NdotH + 1.0; // NdotH² * (a2-1) + 1
    return a2 / (PI * d * d + 1e-7); // 加 epsilon 防止除零
}
代码中 (NdotH * a2 - NdotH) * NdotH + 1.0 是对 NdotH² * (a2 - 1) + 1 的等价展开,利用了 NdotH*(a2-1)*NdotH + 1 = NdotH²*a2 - NdotH² + 1 的代数恒等式。这种写法避免了先计算 NdotH*NdotH 再乘以 (a2-1) 的两步操作,在指令级别节省了一次 MAD。
epsilon 1e-7 的作用:当 roughness 极小(如 0.001)且 NdotH 极接近 1.0 时,分母 d*d 可能下溢为 0。加入 epsilon 后 D 值被钳制在 a2 / 1e-7 以下,避免了 INF 传播到后续计算。
4.2 V 项:Smith Joint GGX
Height-Correlated Smith Visibility 的完整推导:
Smith 遮蔽函数假设入射方向和出射方向的遮蔽事件相关联(Height-Correlated),相比 Separable Smith(假设独立遮蔽)更接近真实的微表面几何行为。数学形式为:
G2(L, V) = 1 / (1 + Λ(V) + Λ(L))
其中 Λ 是 Smith Lambda 函数。对于 GGX 分布,Λ 的解析形式为:
Λ(s) = (-1 + sqrt(1 + α²*tan²θ_s)) / 2 = (-1 + sqrt(1 + α²*(1-NdotS²)/NdotS²)) / 2
将 G2 代入 Visibility 项:
V = G2 / (4 * NdotL * NdotV)
  = 1 / (4 * NdotL * NdotV * (1 + Λ(V) + Λ(L)))
展开后得到:
V_SmithJoint = 0.5 / (NdotL * sqrt(NdotV² * (1-α²) + α²) + NdotV * sqrt(NdotL² * (1-α²) + α²))
推导过程中利用了 NdotS * (1 + Λ(s)) = NdotS + NdotS * Λ(s),而 NdotS * Λ(s) = 0.5 * (-NdotS + sqrt(NdotS² + α²*(1-NdotS²))) = 0.5 * (-NdotS + sqrt(NdotS²*(1-α²) + α²))。两个方向项合并后分母中的 4 与 0.5 相消,得到上式。
直接实现包含两次 sqrt,可以使用 Hammon 2017 的近似避免 sqrt:
half V_SmithJointGGX(half NdotV, half NdotL, half roughness)
{
    half a2 = roughness * roughness;
    half lambdaV = NdotL * sqrt(NdotV * NdotV * (1.0 - a2) + a2);
    half lambdaL = NdotV * sqrt(NdotL * NdotL * (1.0 - a2) + a2);
    return 0.5 / (lambdaV + lambdaL + 1e-5);
}
sqrt 内部的表达式 NdotV² * (1 - a2) + a2 可以理解为:当 α = 0 时退化为 NdotV²(sqrt 后为 NdotV,V 项退化为 0.5/(NdotL*NdotV + NdotV*NdotL) = 0.25/(NdotL*NdotV),即无遮蔽的基线值);当 α = 1 时退化为 1(sqrt 后恒为 1,V = 0.5/(NdotL + NdotV),遮蔽效应最强)。
对于移动端可进一步使用 V_SmithJointGGXApprox(用 lerp 替代 sqrt),精度损失在视觉上几乎不可见:
half V_SmithJointGGXApprox(half NdotV, half NdotL, half roughness)
{
    half a = roughness;
    half lambdaV = NdotL * (NdotV * (1.0 - a) + a);
    half lambdaL = NdotV * (NdotL * (1.0 - a) + a);
    return 0.5 / (lambdaV + lambdaL + 1e-5);
}
这一近似将 sqrt(NdotV² * (1-a²) + a²) 替换为 NdotV * (1-a) + a(线性近似),在 a ∈ [0, 0.7] 区间内相对误差小于 5%。高粗糙度(a > 0.8)时误差增大到 10-15%,但此时 Specular Lobe 很宽,单个 Texel 的亮度差异不可辨别。移动端使用此版本可将 V 项的 ALU 从 ~20 条降低到 ~8 条。
4.3 F 项:Schlick Fresnel
half3 F_Schlick(half3 F0, half VdotH)
{
    return F0 + (1.0 - F0) * pow(1.0 - VdotH, 5.0);
}
F0 为材质在正入射角时的反射率:金属由 Albedo 提供,非金属通常取 0.04(对应折射率 n = 1.5)。
Schlick 近似的物理来源:精确的 Fresnel 方程形式复杂,对于非极化光取 S 和 P 分量的平均,包含折射角的三角函数运算。Schlick 观察到精确 Fresnel 曲线在 cos(θ) ∈ [0,1] 范围内近似满足 F(θ) ≈ F(0°) + (1 - F(0°)) * (1 - cosθ)^5 的形式,最大相对误差约 1%(出现在 θ ≈ 75° 附近)。5 次方指数的选择是经验性的:4 次方低估了掠射角处的增长速度,6 次方则过度。
对于导体材料(金属),精确 Fresnel 还涉及复数折射率(n + ik),Schlick 近似在这种情况下的误差会增大到 3-5%,但由于金属的 F0 本身就在 0.5-1.0 之间,(1-F0) 项很小,绝对误差(F0 + 小误差项)仍在可接受范围。
4.4 完整 Specular 代码
half3 SpecularBRDF(half NdotV, half NdotL, half NdotH, half LdotH, half roughness, half3 F0)
{
    half  D   = D_GGX(NdotH, roughness);
    half  Vis = V_SmithJointGGX(NdotV, NdotL, roughness);
    half3 F   = F_Schlick(F0, LdotH);
    return D * Vis * F;
}
Fresnel 项使用的角度是 LdotH。在微表面模型中,光线在微面元上的反射遵循 Half Vector 的 Fresnel 关系,入射光和出射光相对于 H 的角度相等,因此 VdotH = LdotH。代码中使用 LdotH 是因为 L 和 H 通常在光照循环中已经计算好,无需额外的 dot(V, H)。
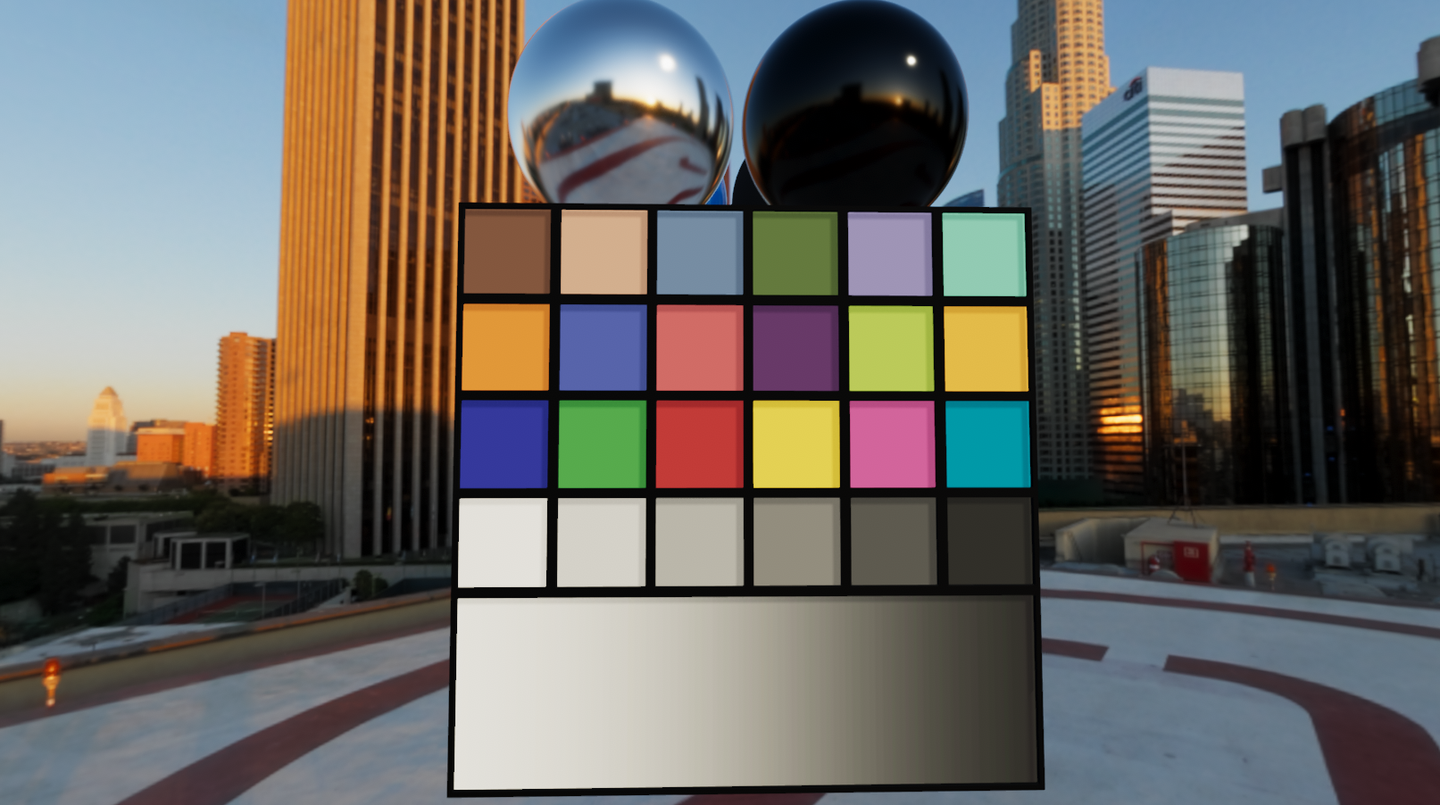
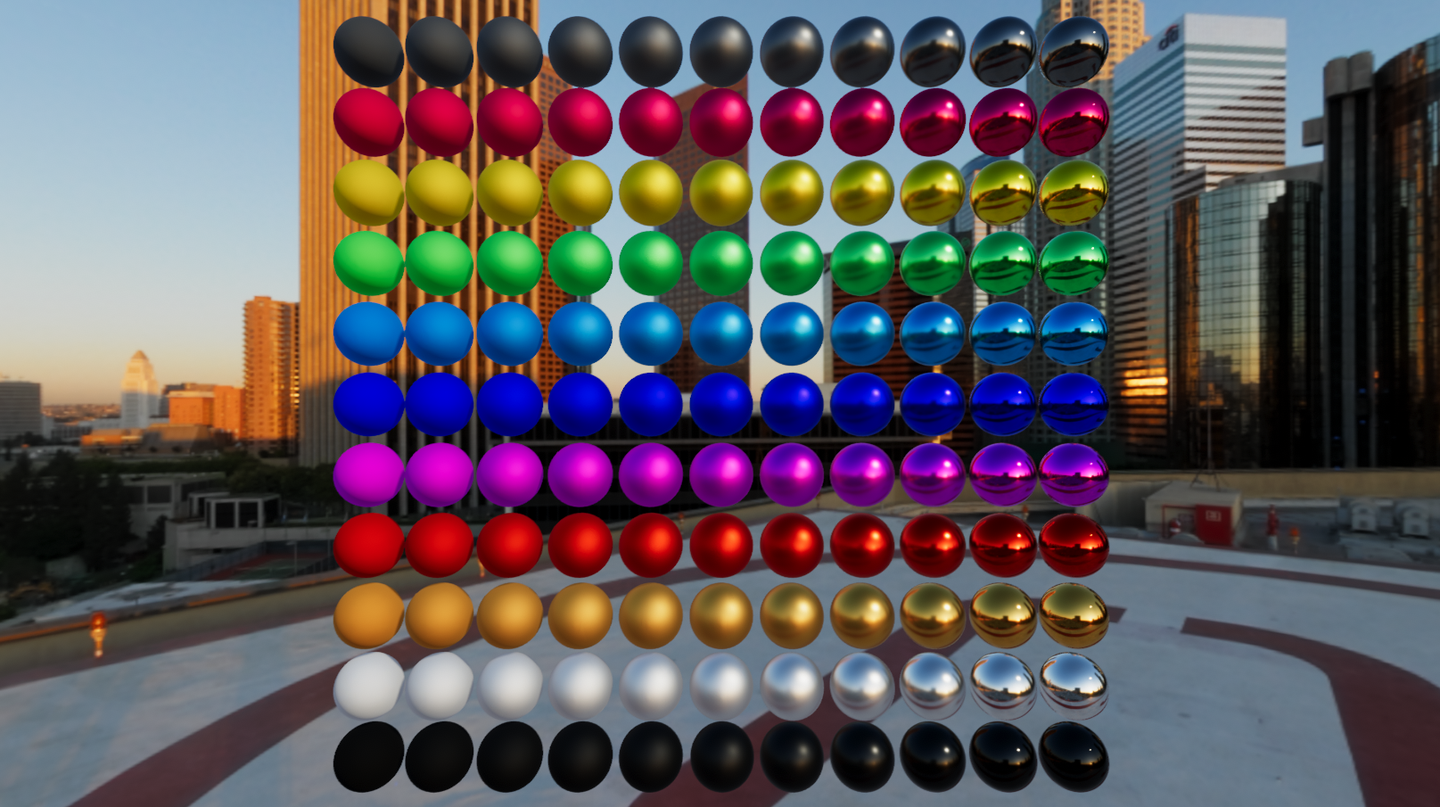
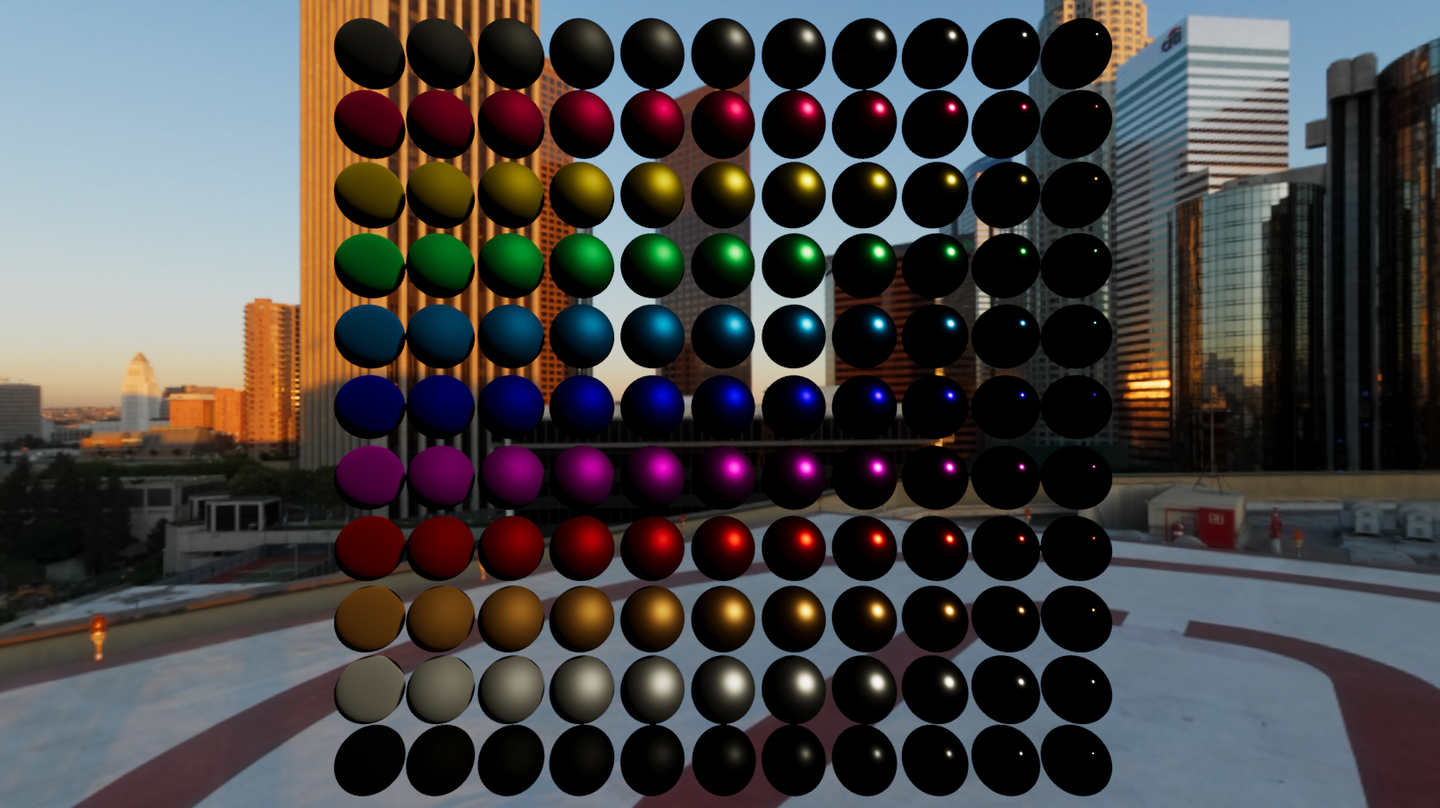
此外引入了 Multi-Bounce 补偿。高粗糙度金属表面在单次弹射模型下会出现过度偏暗的问题,Multi-Bounce 通过补偿丢失的能量来缓解这一现象。具体实现中,补偿系数来自后续 IBL 部分预计算的 BRDF LUT。
4.5 Multi-Bounce 的物理依据
微表面模型中,G 项(几何遮蔽函数)描述了光线被相邻微面元阻挡的概率。被阻挡的光线在物理上并未消失:它会在微面元之间反复弹射(inter-reflection),最终仍有部分能量从表面出射。Cook-Torrance 的 single-scattering 模型将这部分能量丢弃,导致高粗糙度时能量损失越大,此时 G 值更低、遮蔽更严重。
量化分析:对于 α = 1.0 的完全粗糙表面,Smith G2 在 NdotL = NdotV = 0.5 时约为 0.33,意味着 67% 的光线被遮蔽。在 single-scattering 模型下这 67% 直接丢失。若考虑 multi-scattering(假设每次弹射有 F0 的概率被反射),被遮蔽的光线经过 k 次弹射后出射的概率为 (1-G) * F0^k(几何级数)。对所有弹射次数求和:补偿能量 ≈ (1-G)*F0 / (1 - (1-G)*F0)。这正是 Kulla-Conty 2017 提出的能量补偿模型的简化形式。
直接光 Multi-Bounce 的处理方式与间接光略有不同。对于直接光,能量损失主要来自 G 项的遮蔽:被几何结构阻挡的光线在物理上会经过多次散射后仍有部分到达出射方向,但 Cook-Torrance 的单次散射模型忽略了这部分能量。补偿公式为:
half3 directSpecular = D * Vis * F * NdotL;
// 补偿因子近似 (Kulla & Conty 2017)
half3 FssEss = F0 * envBRDF.x + envBRDF.y; // 来自预计算 LUT
half3 Ems = 1.0 - FssEss;
half3 Favg = F0 + (1.0 - F0) / 21.0;
half3 Fms = FssEss * Favg / (1.0 - Ems * Favg);
directSpecular *= (1.0 + Fms * Ems); // 乘以能量补偿
公式中各变量的含义:FssEss 是单次散射(single-scattering)的定向反射率,等于 ∫ f_ss * NdotL dω;Ems 是被单次散射丢弃的能量比例;Favg 是 Fresnel 在半球上的平均值,Favg = ∫F(θ)*sinθ*cosθ dθ / ∫sinθ*cosθ dθ ≈ F0 + (1-F0)/21,其中 21 这个常数来自 ∫(1-cosθ)^5 * sinθ*cosθ dθ 的解析积分;Fms 是多次散射路径的等效 Fresnel,表示经过多次弹射后累积的反射颜色。
在工程实现中,直接光的 Multi-Bounce 补偿通常简化为一个标量乘子(忽略 Fms 的色彩信息),以减少 ALU 开销。
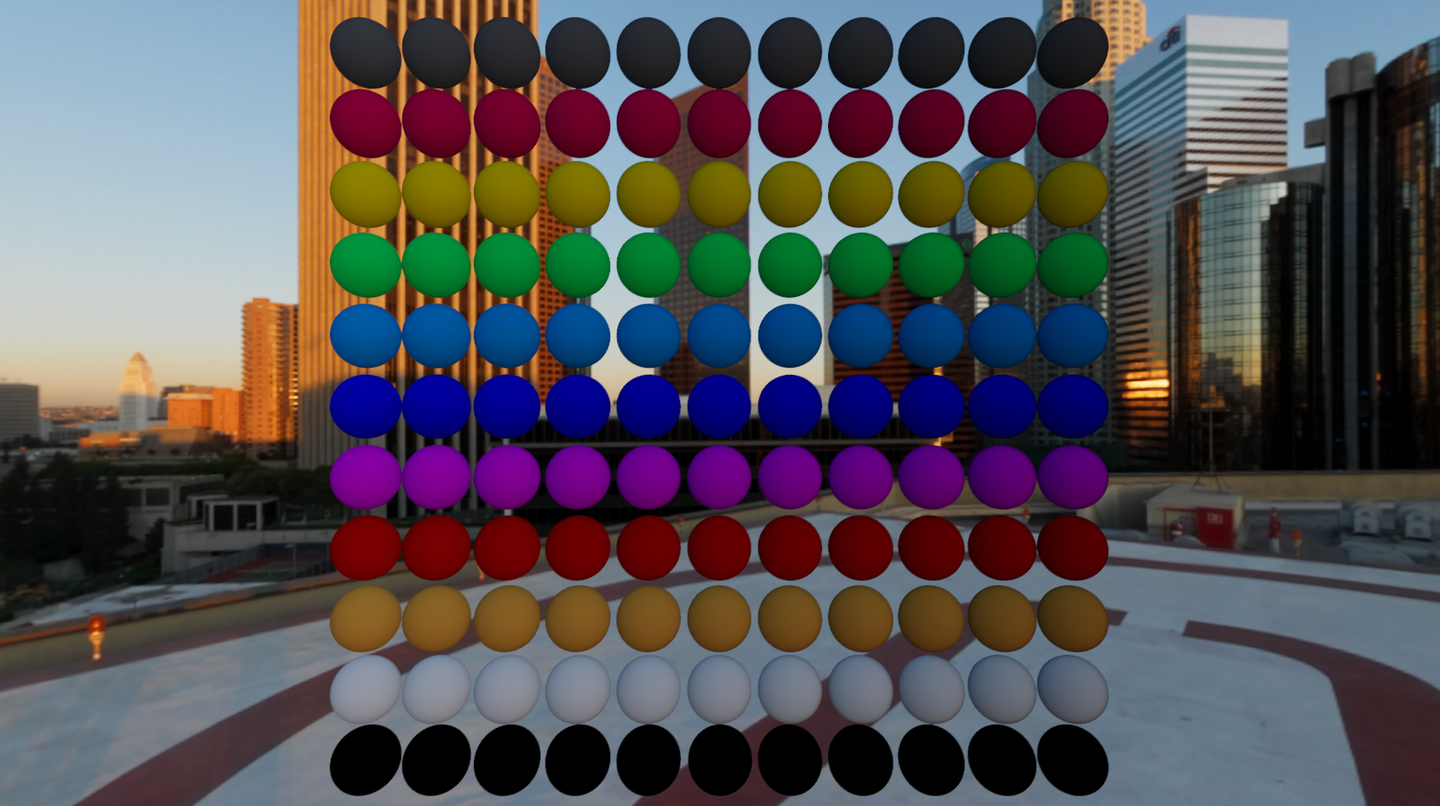
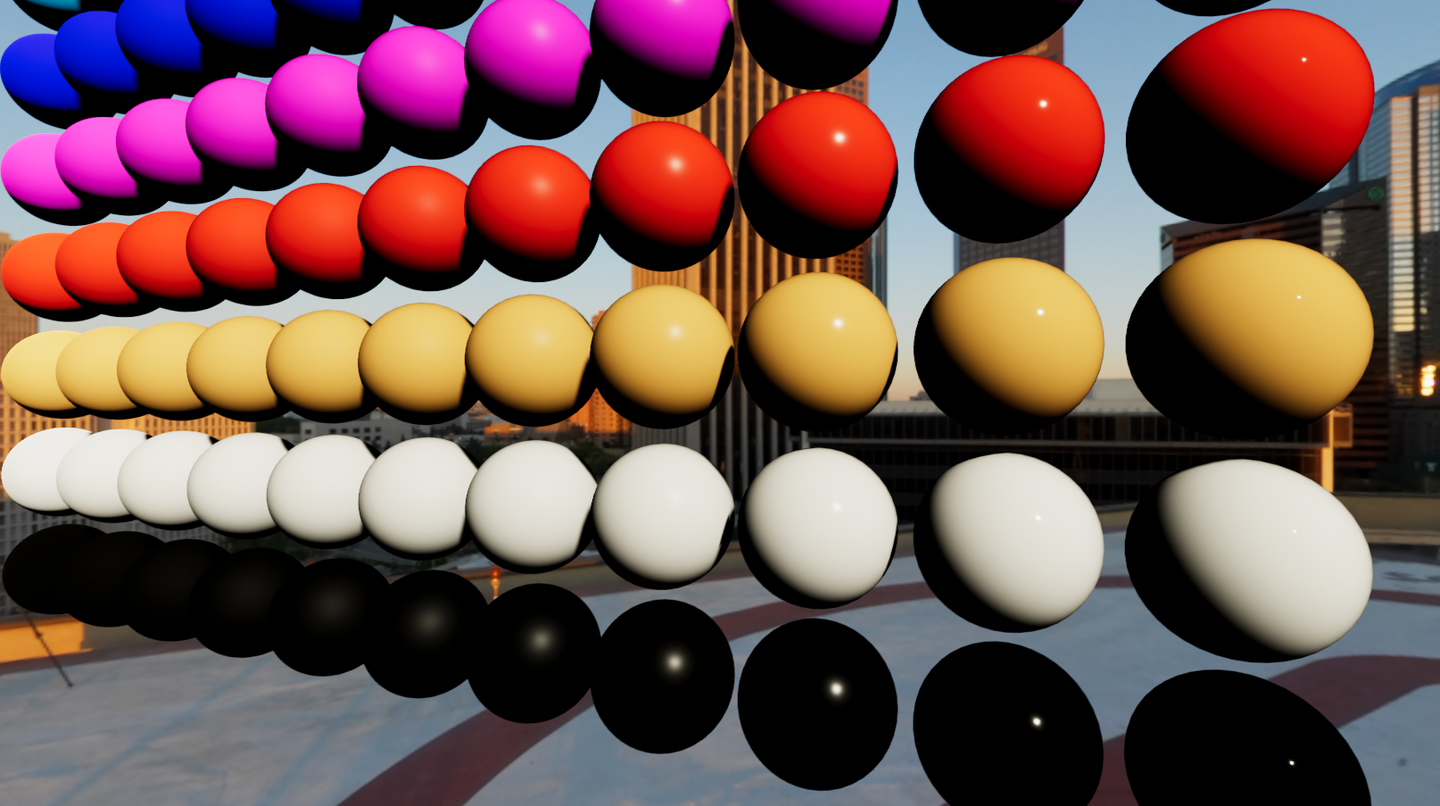
五、间接光:Diffuse
在多数 Unity 实现中,间接漫反射通常直接叠加球谐(SH)数据或高阶 Mip 的 Cubemap 采样结果。这种方式在视觉上差异不大,但为了更正确的能量分配,我给间接漫反射加了一层 Cosine-Weighted 过滤。
间接光源本身使用 Unity 的 Meta Pass 生成的 SH 数据。过滤结果以离线方式预存入 LUT,因此可以使用较高的采样数保证积分精度。对比有过滤和无过滤的结果,过滤后的间接漫反射在能量分布上更为均匀。
5.1 间接 Diffuse 的能量不守恒来源
标准做法是直接将 SH Irradiance 乘以 Albedo 作为间接漫反射输出:indirectDiffuse = SH(N) * albedo。这一做法隐含了 Lambert Diffuse 假设(f_d = 1/π,被积分到 Irradiance 中)。当使用 Burley Diffuse 替代 Lambert 时,间接光的计算也应使用对应的 BRDF 积分,不能直接乘以 Irradiance。
差异来源于 Burley Diffuse 在不同 NdotV 和 Roughness 下的半球积分值:它是 (NdotV, Roughness) 的二维函数,不恒定等于 1/π。对于 roughness = 0 的光滑表面,积分值接近 Lambert;roughness = 1 时,掠射角区域的能量增益导致积分值偏高。
严格来说,对于非 Lambert BRDF 的间接漫反射计算应为:
E_d(v) = ∫_Ω L_i(l) * f_d(l, v) * NdotL dω_l
由于 f_d 依赖于 V(通过 NdotV 和 LdotH),无法简单地将其提取到积分外部与 Irradiance 相乘。精确解法需要为每个 (NdotV, roughness) 组合做一次全半球积分,这在运行时不可行,因此预计算到 LUT 中。
5.2 LUT 的生成过程
对于每个 (NdotV, Roughness) 组合,在半球上按 Cosine-Weighted 分布生成大量采样方向,对每个方向计算 Disney Diffuse 的响应值并累加。由于是离线预计算,采样数可以开到 4096+ 保证收敛精度。最终 LUT 为 2D 纹理(通常 64×64 R16 格式),运行时一次 tex2D 采样即可获取过滤系数。
生成伪代码:
for ndotv in range(LUT_SIZE):
    for roughness in range(LUT_SIZE):
        V = float3(sin(acos(ndotv_normalized)), 0, ndotv_normalized)
        N = float3(0, 0, 1)
        accumulator = 0
        for sample in range(NUM_SAMPLES):
            L = CosineSampleHemisphere(random2D())
            H = normalize(V + L)
            NdotL = max(dot(N, L), 0)
            LdotH = max(dot(L, H), 0)
            fd = DisneyDiffuseRenormalized(ndotv_normalized, NdotL, LdotH, roughness_normalized)
            accumulator += fd  # NdotL 已被 Cosine Sampling 的 PDF 抵消
        LUT[ndotv][roughness] = accumulator / NUM_SAMPLES
关于 PDF 抵消的解释:Cosine-Weighted Hemisphere Sampling 的 PDF 为 p(l) = NdotL / π。Monte Carlo 估计器为 (1/N) * Σ [f_d * NdotL / p(l)] = (1/N) * Σ [f_d * π]。由于 LUT 存储的是相对于 Lambert(1/π)的比例系数,最终 π 与 Lambert 的 1/π 相消,积分器简化为直接累加 f_d 值。
收敛性分析:4096 samples 下,LUT 中每个 Texel 的方差小于 0.001。64×64 分辨率对于双线性插值足够平滑:NdotV 和 Roughness 的变化在相邻像素间通常小于 1/64 的步长。
运行时应用:
half dfgDiffuse = SAMPLE_TEXTURE2D(_DiffuseLUT, sampler_linear, half2(NdotV, roughness)).r;
half3 indirectDiffuse = irradiance * albedo * dfgDiffuse;
从实测来看,对 Roughness > 0.5 的表面影响最为明显:掠射角区域的漫反射能量得到了正确的归一化处理。Roughness < 0.2 时 LUT 值接近 1.0(等效于 Lambert),过滤效果几乎不可见。
六、间接光:Specular
间接反射采用 Unreal 的近似方案(Split-Sum Approximation)。该方案将 IBL Specular 积分拆分为两个独立因子的乘积:
L_spec = ∫ L_i(l) * f(l,v) * NdotL dl ≈ PrefilterEnvMap(R, roughness) * EnvBRDF(NdotV, roughness)
第一项(PrefilterEnvMap)只依赖反射方向和粗糙度,可预计算为多 Mip 的 Cubemap。第二项(EnvBRDF)只依赖视角和粗糙度,预计算为 2D LUT。这种拆分在数学上不严格成立(两个积分的乘积不等于积的积分),但在实践中误差极小。
6.1 Split-Sum 近似的数学推导
完整的 IBL Specular 积分为:
L_o(v) = ∫_Ω L_i(l) * [D(h)*G(l,v)*F(v,h) / (4*NdotL*NdotV)] * NdotL dω_l
Split-Sum 的核心假设是:环境光 L_i(l) 在 Specular Lobe 覆盖的立体角范围内近似为常数 L_avg。在此假设下:
L_o ≈ L_avg * ∫_Ω [D*G*F / (4*NdotV)] dω_l
第一项 L_avg 通过对环境贴图在 Lobe 范围内做加权平均获得:权重就是 D(h)*NdotL(GGX 分布与 Cosine 的乘积),这正是 PrefilterEnvMap 的定义。
第二项 ∫ [D*G*F / (4*NdotV)] dω_l 是 BRDF 的定向半球反射率(directional-hemispherical reflectance),仅依赖于 (NdotV, roughness, F0)。进一步利用 Schlick Fresnel 的线性结构 F = F0*(1-Fc) + Fc 将 F0 提取到积分外部,得到 F0 * Scale + Bias 的形式:这就是 EnvBRDF LUT。
该近似的误差来源:
L_i在 Lobe 范围内并非真正为常数:对于包含强方向性光源(如太阳)的环境贴图,Lobe 内的 L_i 变化剧烈。但由于太阳方向的光照通常由直接光处理,IBL 通常不包含 analytic lights,因此 L_i 的空间变化相对平缓。- PrefilterEnvMap 使用 V = N = R 的简化假设(忽略视角对 Lobe 形状的影响)。真实的 GGX Lobe 在掠射角处沿表面方向拉长,但预过滤贴图无法编码此信息。
6.2 流程
- 在 Capture 位置生成 Cubemap
- 对 Cubemap 逐 Mip 级别执行 GGX Pre-Filter
- 运行时根据粗糙度采样对应 Mip
由于使用实时捕获的动态 Cubemap,Pre-Filter 在 Shading 阶段实时执行。从对比结果看,Pre-Filter 主要在高粗糙度区域产生可观测差异:高粗糙度下 GGX Lobe 展开较大,未经过滤的 Cubemap 采样会引入不正确的高频信息。
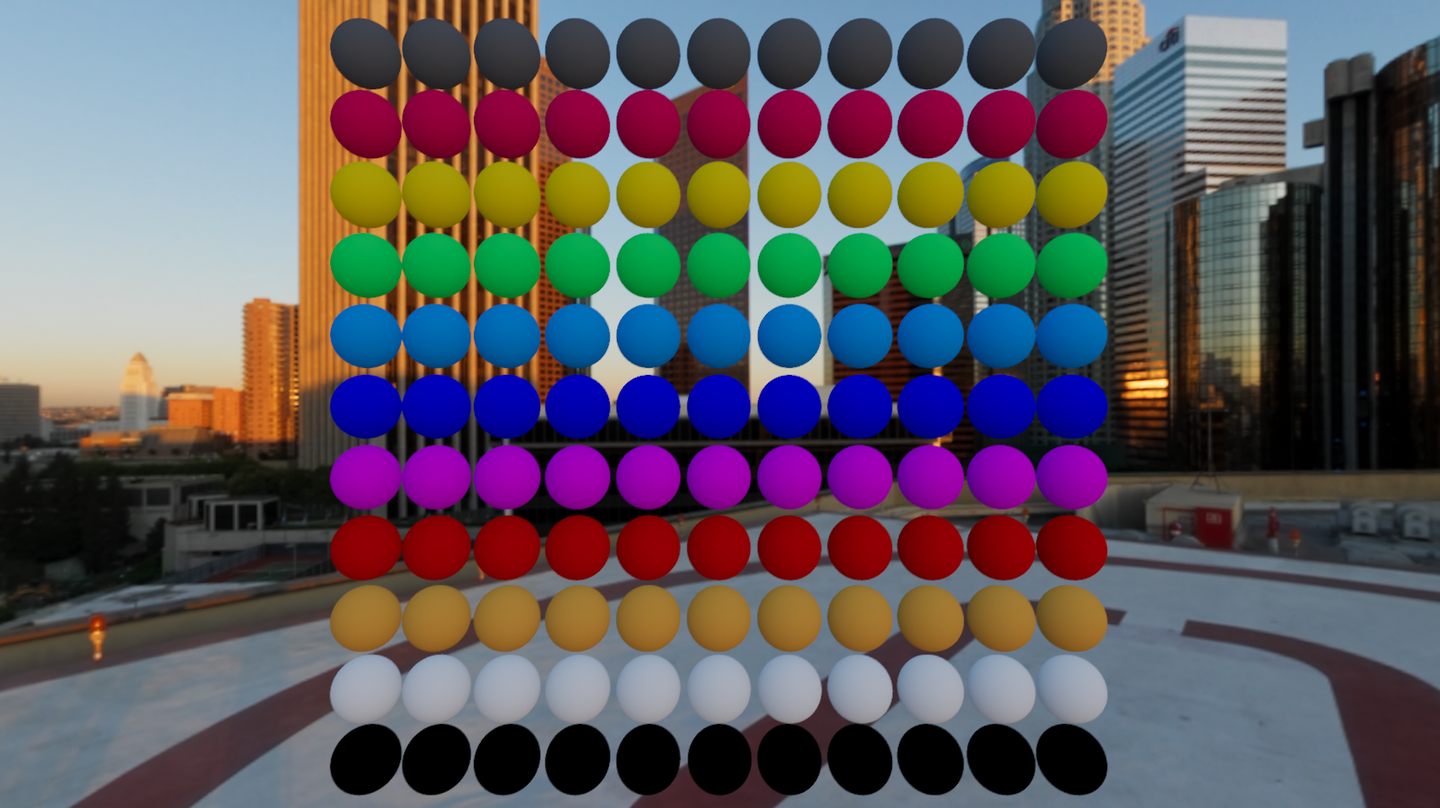
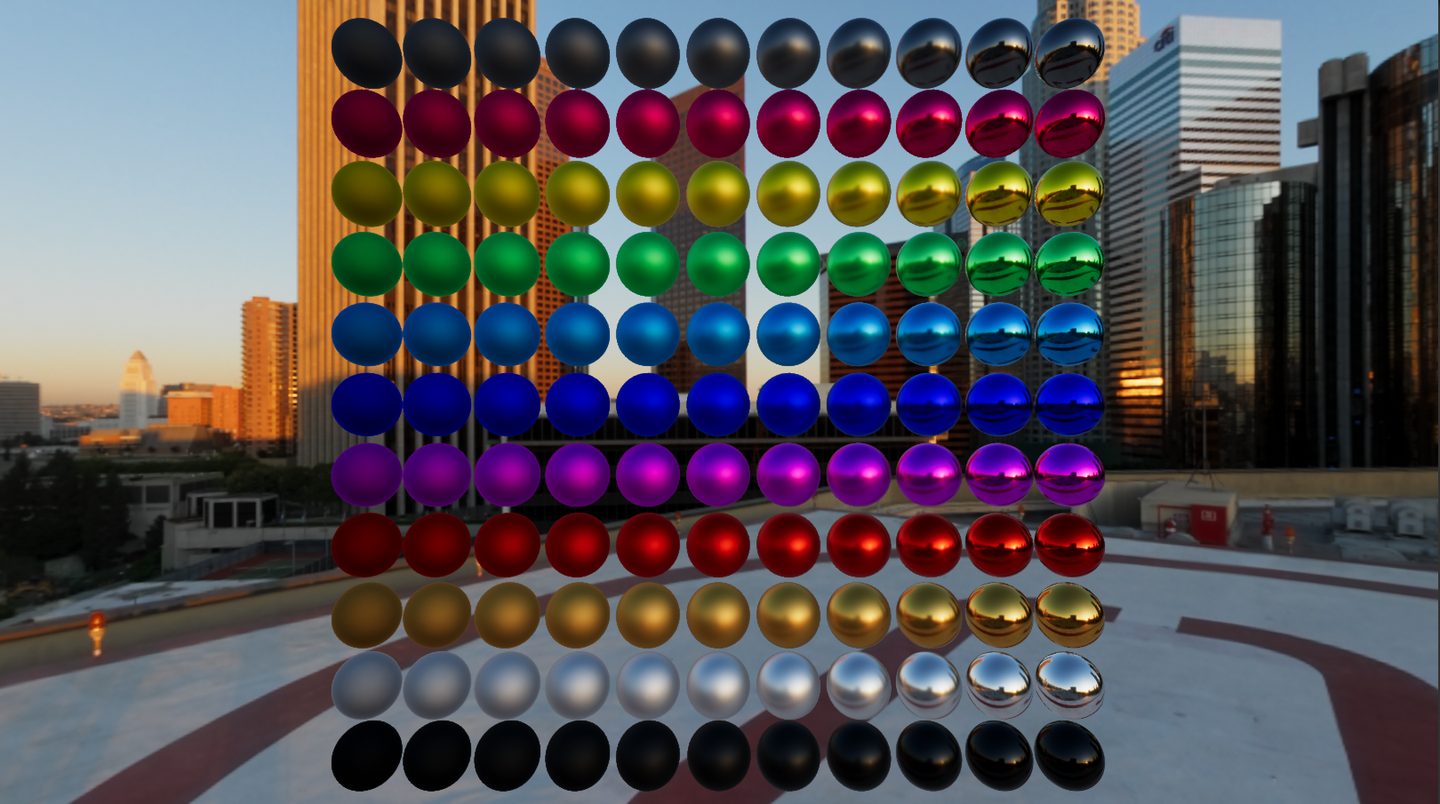
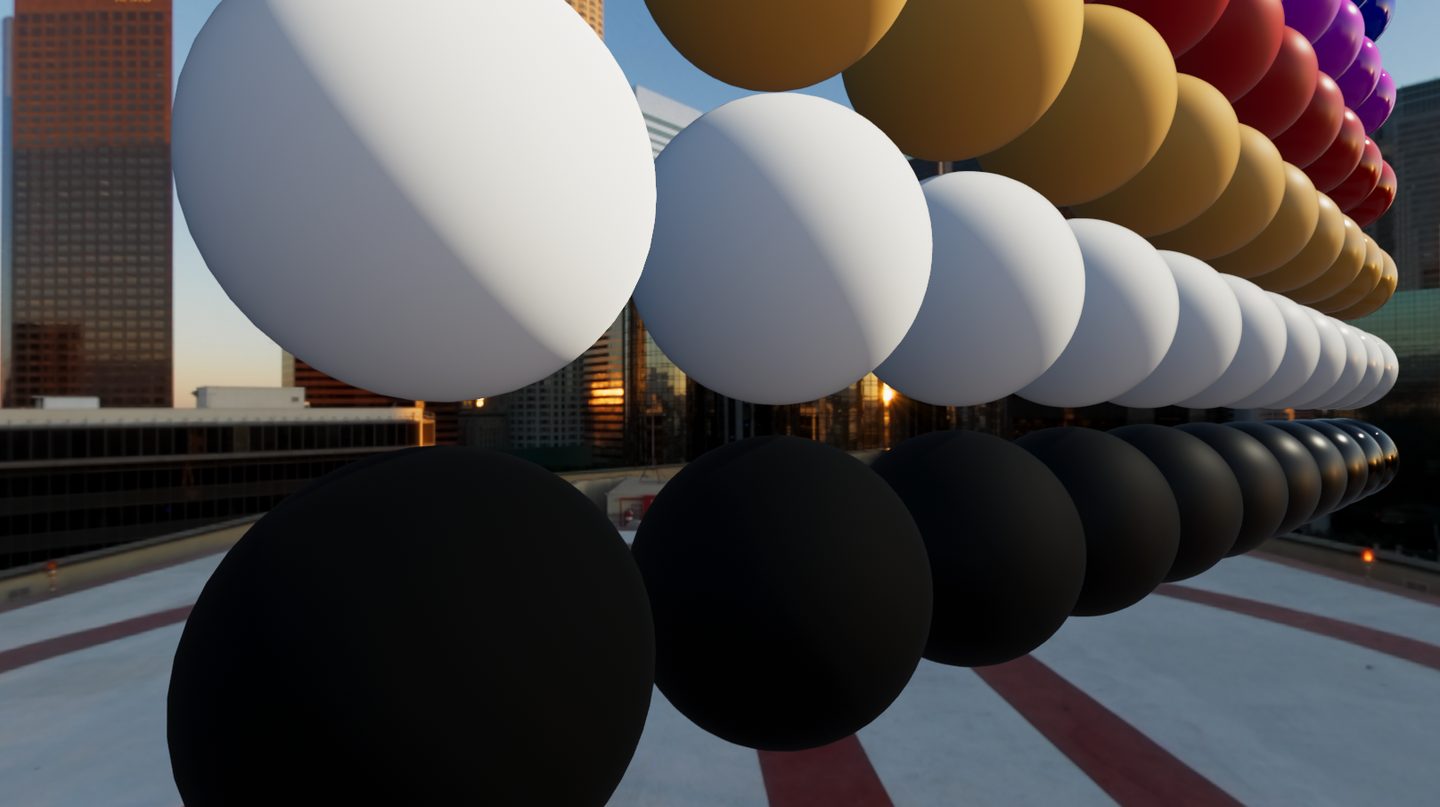
6.3 GGX Pre-Filter 的实现细节
Cubemap 的 Mip Level 与 Roughness 存在映射关系(通常 mip = roughness * maxMipLevel)。对每个 Mip,以对应 Roughness 值的 GGX Lobe 为核,对 Cubemap 面上的 Texel 做加权卷积。低 Mip(高分辨率)对应低粗糙度,此时 Lobe 很窄,几乎是镜面;高 Mip(低分辨率)对应高粗糙度,Lobe 展开很大,结果接近漫反射环境。
Pre-Filter 的采样策略使用 GGX 重要性采样。重要性采样的原理:直接在 GGX NDF 的分布上生成采样方向,使得大部分采样落在 Lobe 的高能量区域,以少量采样获得低方差的积分估计。均匀采样在 Lobe 之外浪费大量样本:对于 α = 0.1 的窄 Lobe,有效采样方向仅占半球的约 3%,均匀采样效率极低。
重要性采样的具体实现步骤:
- 生成 low-discrepancy 序列 (Hammersley 序列) 作为 [0,1]² 均匀分布输入
- 通过 GGX 的逆 CDF 变换将均匀分布映射为 GGX 分布的半向量 H
- 由 V 和 H 计算反射方向 L = 2*dot(V,H)*H - V
- 采样环境贴图在 L 方向的值,以 NdotL 为权重累加
half3 PrefilterEnvMap(TextureCube envMap, half roughness, half3 R, int numSamples)
{
    half3 N = R;
    half3 V = R; // 假设 V = N = R(Split-Sum 的近似条件)
    half totalWeight = 0;
    half3 result = 0;

    for (int i = 0; i < numSamples; i++)
    {
        half2 Xi = Hammersley(i, numSamples);
        half3 H = ImportanceSampleGGX(Xi, roughness, N);
        half3 L = 2.0 * dot(V, H) * H - V;
        half NdotL = saturate(dot(N, L));
        if (NdotL > 0)
        {
            // Mip Level 偏移减少亮点噪声
            half NdotH = saturate(dot(N, H));
            half D = D_GGX(NdotH, roughness * roughness);
            half pdf = D * NdotH / (4.0 * saturate(dot(V, H))) + 1e-5;
            half solidAngleSample = 1.0 / (numSamples * pdf);
            half solidAngleTexel = 4.0 * PI / (6.0 * envMapSize * envMapSize);
            half mipLevel = max(0.5 * log2(solidAngleSample / solidAngleTexel), 0);

            result += envMap.SampleLevel(sampler_linear, L, mipLevel).rgb * NdotL;
            totalWeight += NdotL;
        }
    }
    return result / totalWeight;
}
相比原始版本(固定采样 Mip 0),增加了基于 PDF 的 Mip Level 偏移。原理:如果某个采样方向的 PDF 很低(表示该方向不太可能被 GGX Lobe 覆盖,但仍被采样到),对应的 solid angle 很大,此时应该采样更高的 Mip Level(更模糊的值)来减少高频噪声。这一技巧来自 GPU Gems 3 中的 Pre-Filtered Importance Sampling 方法。
V = N = R 的假设下,掠射角的各向异性拉伸效果被忽略。这是 Split-Sum 方案的已知限制:在掠射角处反射 Lobe 应该沿表面方向拉长,但预过滤的 Cubemap 无法编码视角信息。实际视觉影响在大多数场景中可以接受。
6.4 Hammersley 序列
half2 Hammersley(uint i, uint N)
{
    return half2(half(i) / half(N), RadicalInverse_VdC(i));
}

half RadicalInverse_VdC(uint bits)
{
    bits = (bits << 16u) | (bits >> 16u);
    bits = ((bits & 0x55555555u) << 1u) | ((bits & 0xAAAAAAAAu) >> 1u);
    bits = ((bits & 0x33333333u) << 2u) | ((bits & 0xCCCCCCCCu) >> 2u);
    bits = ((bits & 0x0F0F0F0Fu) << 4u) | ((bits & 0xF0F0F0F0u) >> 4u);
    bits = ((bits & 0x00FF00FFu) << 8u) | ((bits & 0xFF00FF00u) >> 8u);
    return half(bits) * 2.3283064365386963e-10; // 0x100000000
}
Hammersley 序列是 quasi-random low-discrepancy 序列的一种,其第一维度为均匀等间距 i/N,第二维度为 Van der Corput 序列(对整数 i 做 base-2 radical inverse)。相比伪随机数,low-discrepancy 序列在相同采样数下具有更低的积分方差:64 个 Hammersley 点的等效精度约为 200-300 个伪随机点。
6.5 动态 Cubemap 的分帧更新策略
对于动态捕获的 Cubemap,每帧只能对有限 Mip 执行 Filter(通常 1-2 级),多帧轮转完成全部 Mip 的更新。这是实时 Cubemap 反射质量与性能之间的典型权衡。
具体调度策略:
Frame 0: 捕获 Cubemap 6 面(或分 3 帧各捕获 2 面)
Frame 1: Filter Mip 0 (roughness ≈ 0, 镜面)
Frame 2: Filter Mip 1-2 (roughness ≈ 0.15-0.3)
Frame 3: Filter Mip 3-4 (roughness ≈ 0.45-0.6)
Frame 4: Filter Mip 5-6 (roughness ≈ 0.75-1.0)
Frame 5: 回到 Frame 0,重新捕获
完整一轮更新需要 5 帧(约 83ms @60FPS)。对于快速变化的环境光照(如爆炸闪光),Mip 5-6 会有 3-4 帧的更新延迟。实践中高 Mip(高粗糙度)的过滤结果本身就是模糊的环境色,对延迟不敏感。
每个 Mip 的 Filter 使用 Compute Shader 执行,numSamples 根据 Mip Level 递减(低 Mip 需要更多 samples 保证窄 Lobe 的采样精度,高 Mip 的宽 Lobe 用较少 samples 即可收敛):
| Mip Level | Roughness | numSamples | 输出分辨率 | GPU 耗时 (估算) |
|---|---|---|---|---|
| 0 | 0.0 | 直接拷贝 | 128×128 | 0.01 ms |
| 1 | 0.15 | 256 | 64×64 | 0.15 ms |
| 2 | 0.30 | 128 | 32×32 | 0.04 ms |
| 3 | 0.45 | 64 | 16×16 | 0.01 ms |
| 4 | 0.60 | 64 | 8×8 | < 0.01 ms |
| 5 | 0.80 | 32 | 4×4 | < 0.01 ms |
| 6 | 1.00 | 32 | 2×2 | < 0.01 ms |
Mip 0 不执行 Filter 的原因:roughness = 0 对应完美镜面,GGX Lobe 退化为 Dirac δ,Pre-Filter 结果等于原始环境贴图值。直接拷贝避免了 256 次冗余的环境贴图采样。
七、BRDF LUT 与 Multi-Bounce
BRDF LUT 的参数空间为 (NdotV, Roughness),输出为 (Scale, Bias) 两个值。含义是:对于给定的视角和粗糙度,Fresnel 项可以分解为 F0 * Scale + Bias 的形式(Split-Sum 近似的第二项)。这样运行时只需一次纹理采样即可获得完整的环境 BRDF 响应,避免了运行时的积分计算。
7.1 LUT 推导
环境 BRDF 定义为:
∫ f(l,v) * NdotL dl = F0 * Scale + Bias
推导从 Cook-Torrance BRDF 中的 Schlick Fresnel 展开开始:
F(VdotH) = F0 + (1-F0)*(1-VdotH)^5 = F0*(1-(1-VdotH)^5) + (1-VdotH)^5
令 Fc = (1-VdotH)^5,则 F = F0*(1-Fc) + Fc。代入积分:
∫ [D*G/(4*NdotV)] * F * NdotL dω = ∫ [D*G/(4*NdotV)] * [F0*(1-Fc) + Fc] * NdotL dω
= F0 * ∫ [D*G*NdotL/(4*NdotV)] * (1-Fc) dω + ∫ [D*G*NdotL/(4*NdotV)] * Fc dω
= F0 * Scale + Bias
其中 Scale 和 Bias 通过以下蒙特卡洛积分得到:
Scale = (1/N) * Σ [G_Vis * (1-Fc) * VdotH / NdotH]
Bias  = (1/N) * Σ [G_Vis * Fc * VdotH / NdotH]
Fc = (1 - VdotH)^5
G_Vis = G(L,V) * VdotH / (NdotH * NdotV)
Monte Carlo 估计中 VdotH / NdotH 项的来源:重要性采样在 GGX NDF 上生成 H,采样的 PDF 为 p(H) = D(H)*NdotH。从 H 变换到 L 的 Jacobian 为 dω_H / dω_L = 1/(4*VdotH)。因此 L 空间的 PDF 为 p(L) = D*NdotH / (4*VdotH)。积分器中的 f*NdotL / p(L) 展开后,D 项相消,剩余 G*VdotH / (NdotH*NdotV)(即 G_Vis)再乘以 Fresnel 分量。
采样使用 GGX 重要性采样生成半向量 H,由 H 和 V 推导出 L。积分分为两部分的原因是 Schlick Fresnel 可以拆分为 F = F0 + (1-F0) * (1-VdotH)^5 = F0 * (1-Fc) + Fc,从而将 F0 提取到积分外部。
获得入射光后,还需要几何遮蔽和 Fresnel 项来完成完整的间接光 Specular 计算。实现上与漫反射过滤类似,预计算一个基于 GGX 分布的 2D LUT,横轴为 NdotV,纵轴为 Roughness,存储 Scale 和 Bias 两个参数。
7.2 LUT 生成代码
half2 IntegrateBRDF(half NdotV, half roughness, int numSamples)
{
    half3 V = half3(sqrt(1.0 - NdotV * NdotV), 0, NdotV);
    half3 N = half3(0, 0, 1);
    half scale = 0, bias = 0;

    for (int i = 0; i < numSamples; i++)
    {
        half2 Xi = Hammersley(i, numSamples);
        half3 H = ImportanceSampleGGX(Xi, roughness, N);
        half3 L = 2.0 * dot(V, H) * H - V;

        half NdotL = saturate(L.z);
        half NdotH = saturate(H.z);
        half VdotH = saturate(dot(V, H));

        if (NdotL > 0)
        {
            half G = G_SmithJoint(NdotV, NdotL, roughness);
            half G_Vis = G * VdotH / (NdotH * NdotV);
            half Fc = pow(1.0 - VdotH, 5.0);
            scale += G_Vis * (1.0 - Fc);
            bias  += G_Vis * Fc;
        }
    }
    return half2(scale, bias) / numSamples;
}
代码中 V 的构造:V = (sinθ, 0, cosθ),其中 cosθ = NdotV。将 V 放在 XZ 平面,Y 分量为 0,利用的是各向同性 BRDF 在方位角上的对称性:旋转 V 的方位角不改变积分结果。N 固定为 (0,0,1) 使得所有角度计算简化为对 Z 分量的读取,即 NdotL = L.z、NdotH = H.z。
LUT 分辨率取 128×128、RG16F 格式,总大小 64KB。生成时使用 1024 samples 保证收敛。
收敛性验证:在 (NdotV=0.1, roughness=0.9) 这一"最难收敛"的参数组合处,即掠射角 + 高粗糙度、G_Vis 方差最大的位置,1024 samples 的标准误差约为 0.003,相对误差 < 1%。将采样数提升到 4096 后结果变化 < 0.1%,确认 1024 已充分收敛。
7.3 Multi-Bounce 补偿
Unreal 的原始实现不包含 Multi-Bounce 补偿。根据 Google Filament 的方案,只需在最终输出处对能量损失做补偿修正即可:
half2 envBRDF = SAMPLE_TEXTURE2D(_BRDFLut, sampler_BRDFLut, half2(NdotV, roughness)).rg;
half3 specular = prefilteredColor * (F0 * envBRDF.x + envBRDF.y);

// Multi-Bounce 补偿 (Filament)
half3 energyCompensation = 1.0 + F0 * (1.0 / (envBRDF.x + envBRDF.y) - 1.0);
specular *= energyCompensation;
补偿的物理含义:envBRDF.x + envBRDF.y 代表 BRDF 在半球上的总反射能量比例。理想的无损微表面应该反射 100% 能量(对于 F0=1 的完美镜面),但由于 G 项的遮蔽,实际反射能量低于 100%。差值 1 - (envBRDF.x + envBRDF.y) 就是被遮蔽后经多次散射才到达出射方向的能量。energyCompensation 将这部分能量加回去。
Filament 方案相比 Kulla-Conty 的简化之处:Kulla-Conty 需要额外的 Eavg,即半球平均反射率的 1D LUT;Filament 直接用 envBRDF.x + envBRDF.y 近似单点的定向反射率,不做球面平均,省去了额外的 LUT 采样。二者在 NdotV ∈ [0.2, 0.8] 的常用区间内差异 < 3%,掠射角处 Filament 方案略有过补偿(约 5-8%),视觉上不可分辨。
对于 F0 接近 0 的非金属,如塑料,补偿几乎为 1.0,基本无影响,因为非金属的 Specular 能量本身就很低,损失不明显。对于 F0 接近 1 的金属,如金、铜,高粗糙度下补偿值可达 1.3-1.5,视觉上从偏暗恢复到正确亮度。
典型补偿值参考表:
| F0 | Roughness | envBRDF.x + envBRDF.y | energyCompensation |
|---|---|---|---|
| 0.04 | 0.3 | 0.92 | 1.003 |
| 0.04 | 0.8 | 0.71 | 1.016 |
| 1.0 | 0.3 | 0.92 | 1.087 |
| 1.0 | 0.8 | 0.71 | 1.408 |
| 0.9 (Gold) | 0.5 | 0.83 | 1.193 |
| 0.56 (Iron) | 0.7 | 0.75 | 1.187 |
LUT 生成使用 Unity 的 Custom Render Texture 实现。具体配置方式:创建一个 Custom Render Texture 资产,分辨率设为 128×128,格式 RG16F,绑定一个执行 BRDF 积分的 Shader 作为其 Material。Update Mode 设为 OnDemand(手动触发),在初始化时通过脚本调用 customRT.Update() 执行一次积分计算,后续帧不再更新。这样整个 LUT 的生成过程无需离线工具介入,在编辑器中修改参数后手动触发即可实时预览结果。
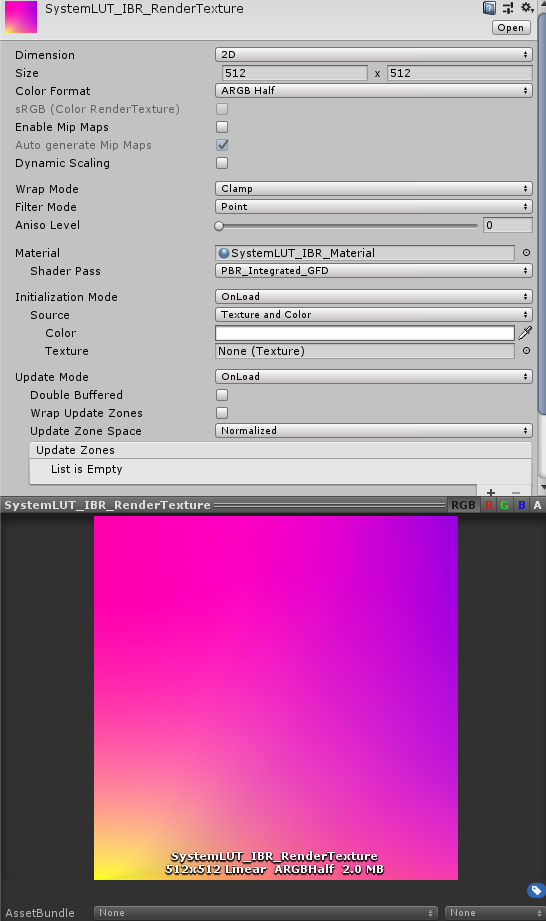
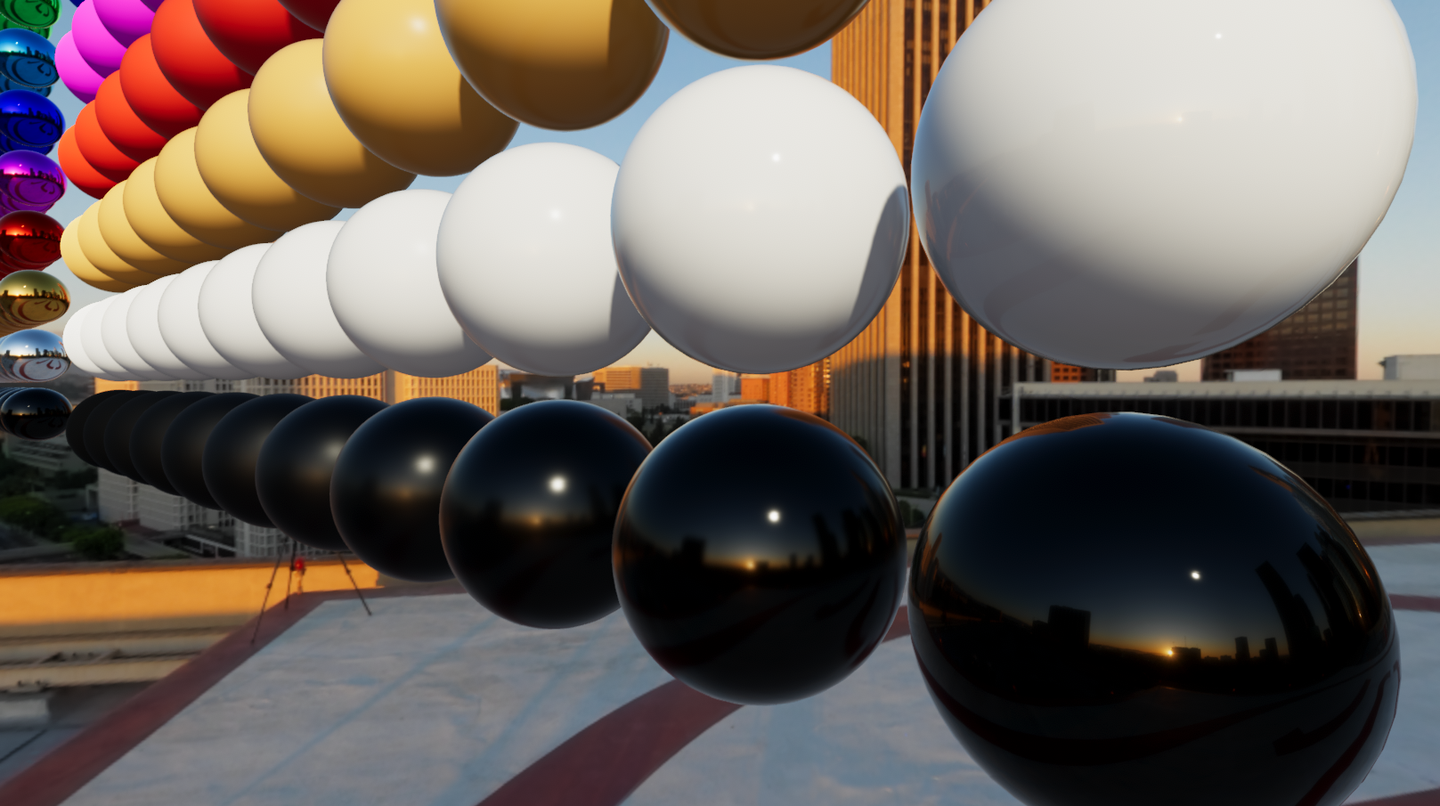
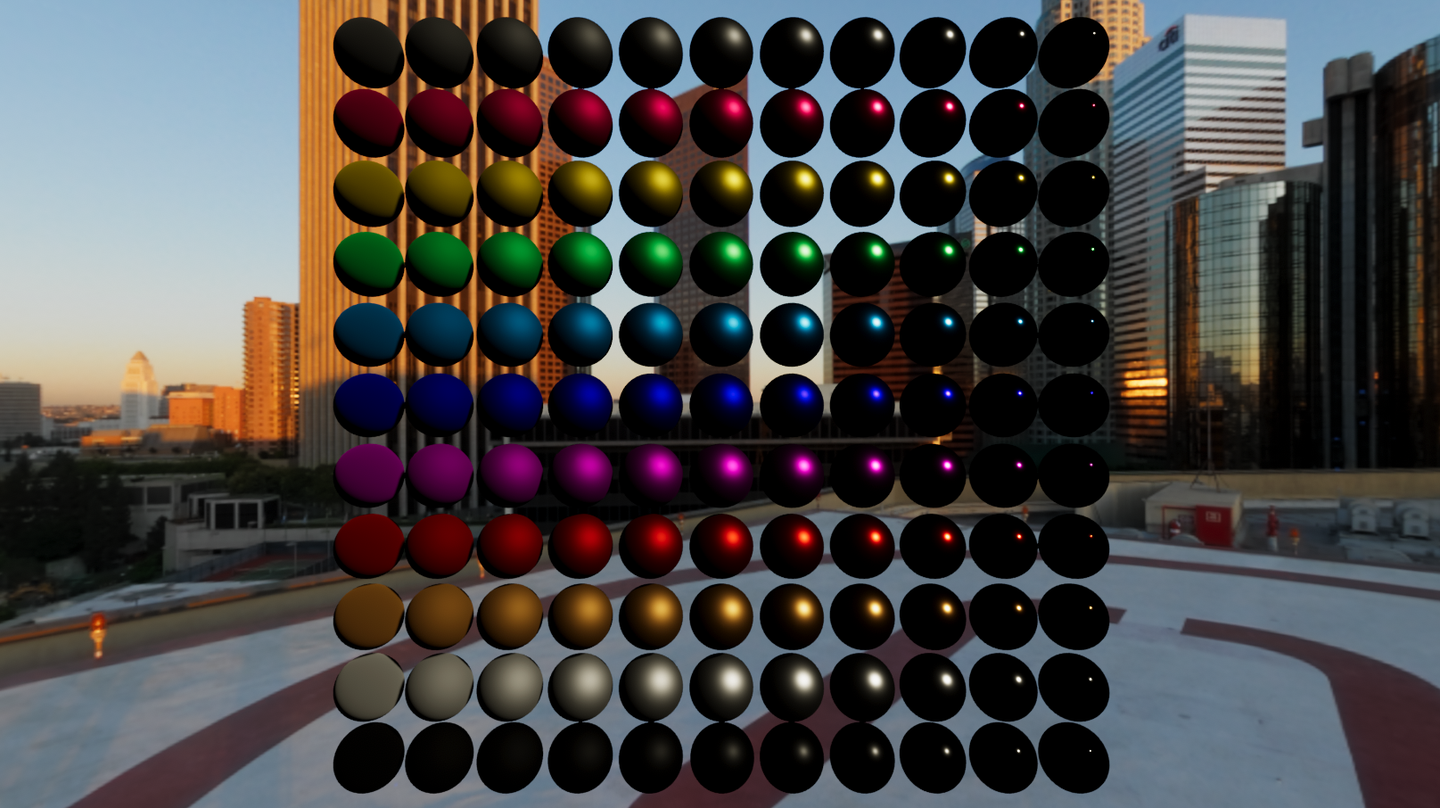
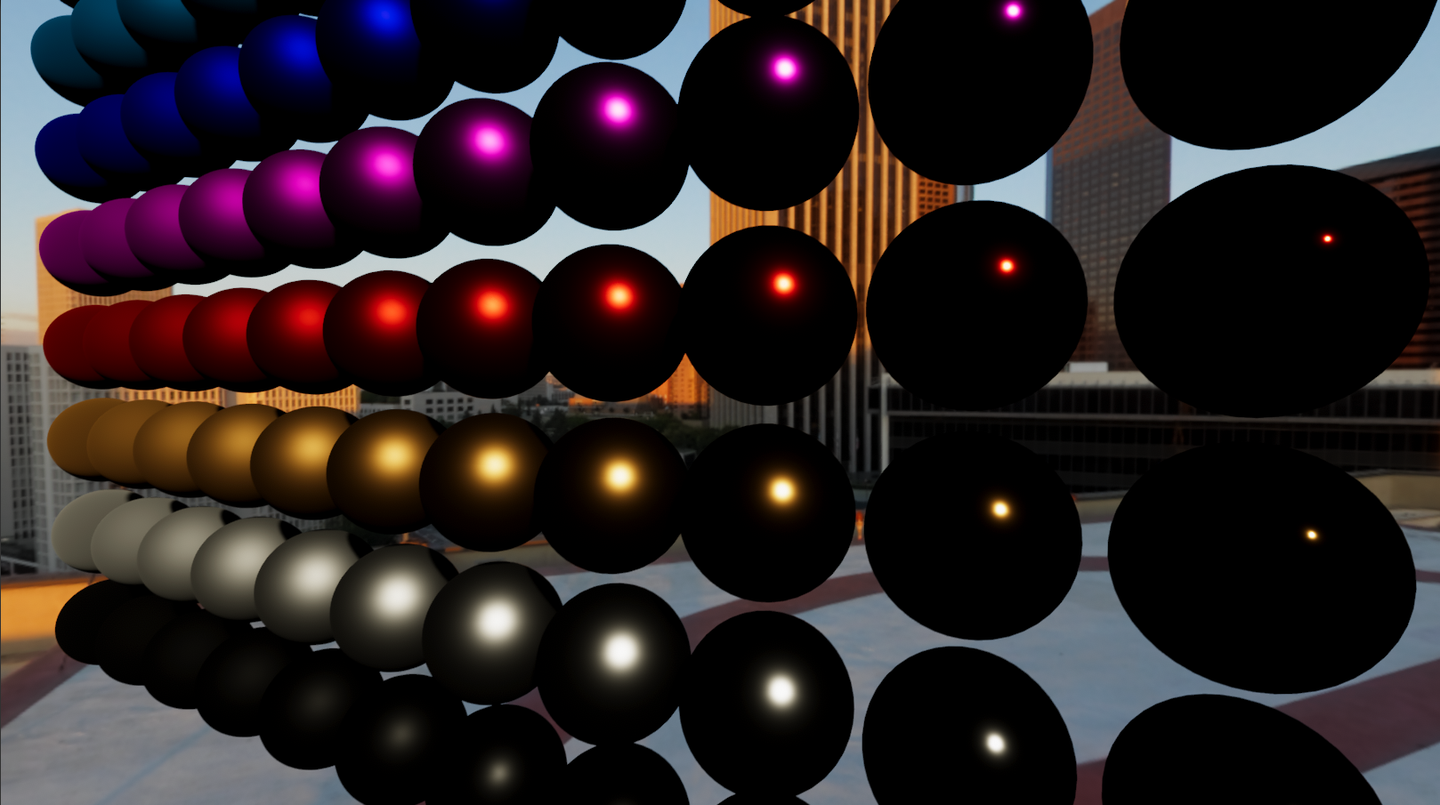
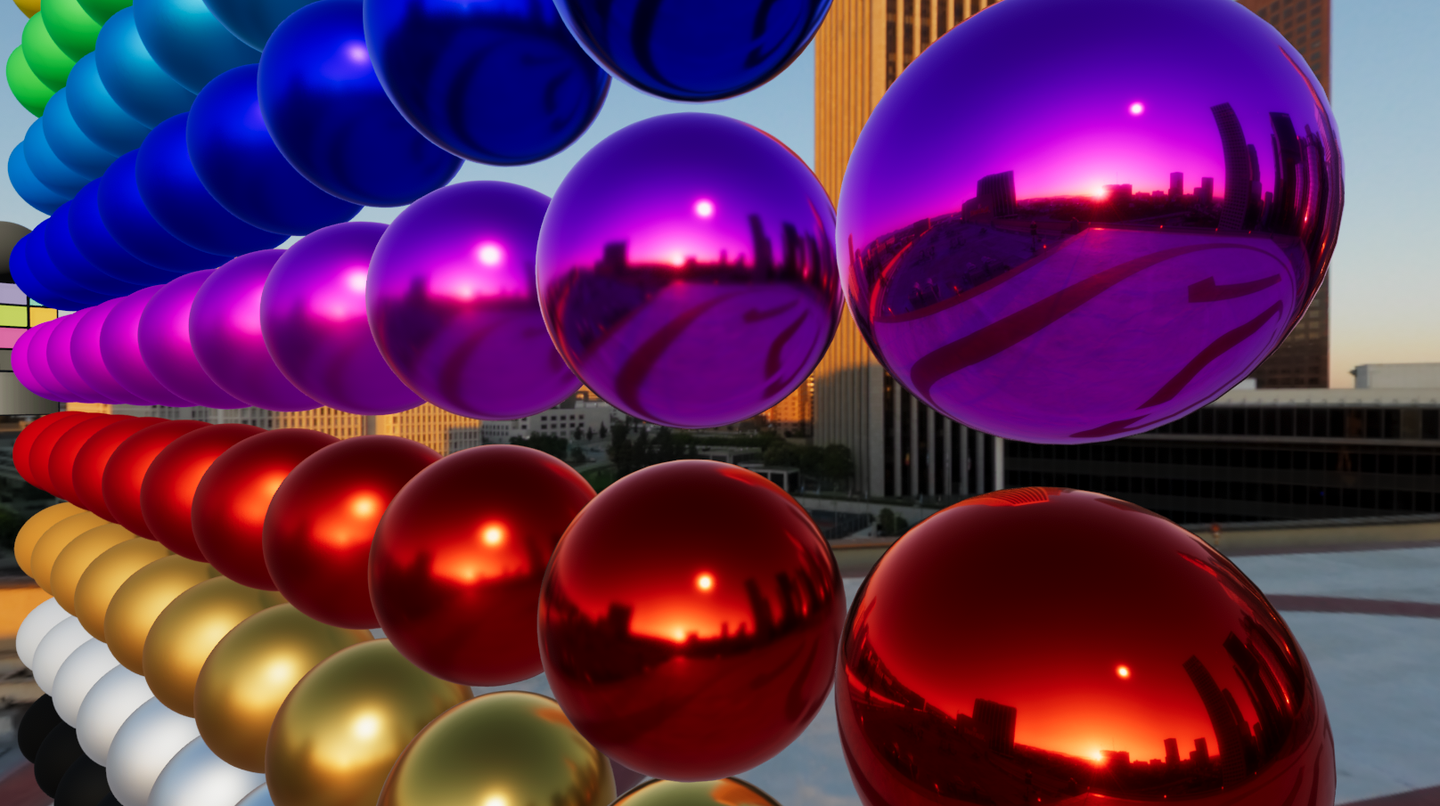
Multi-Bounce 对间接 Specular 的影响在高粗糙度金属上表现明显:未补偿时表面过度偏暗,补偿后能量分布更为合理,金属质感得到恢复。
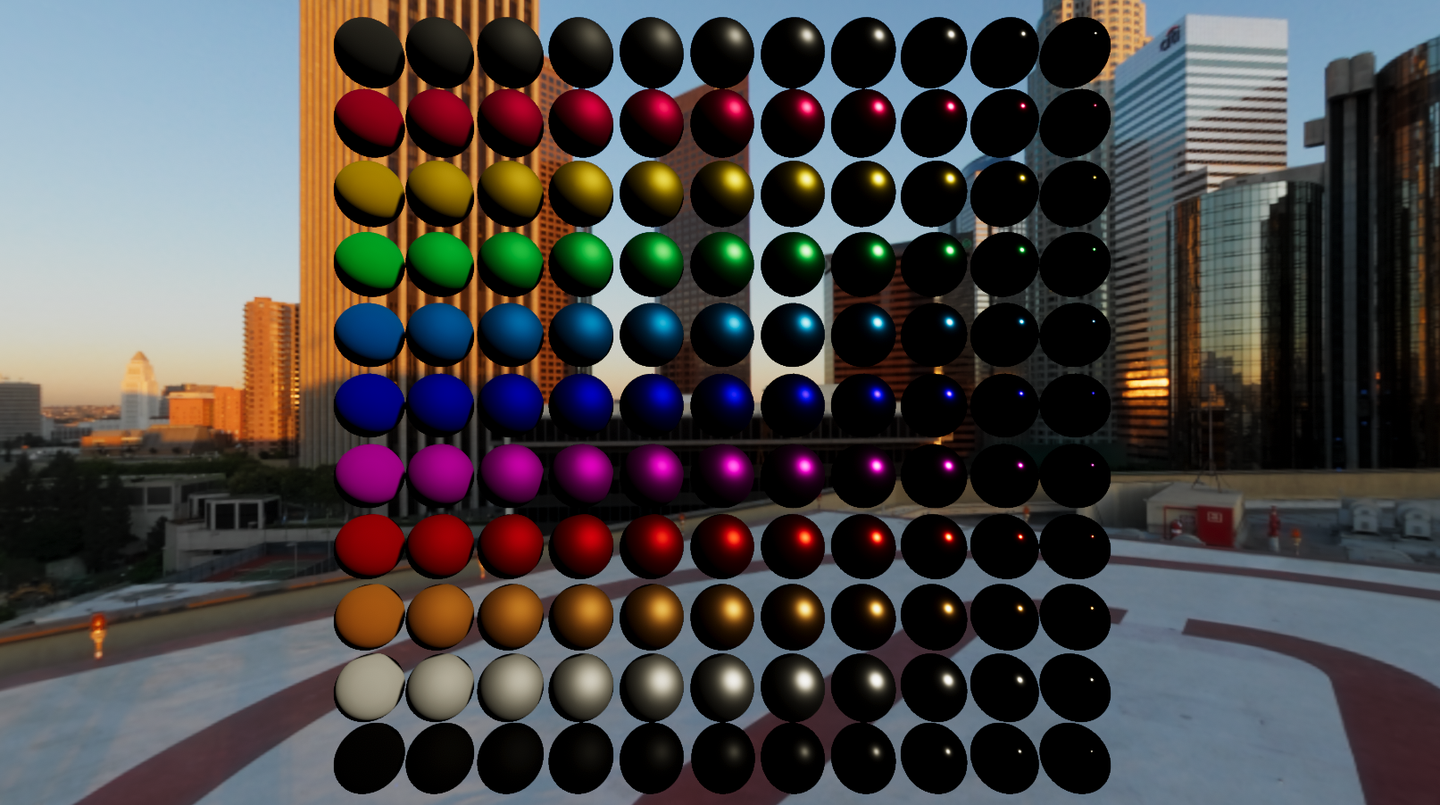
八、直接光与间接光的组合
完整的 Default Shading 输出为:
half3 DefaultShading(SurfaceData surface, LightData light, half3 irradiance, half3 prefilteredEnv)
{
    // 直接光
    half3 directDiffuse  = DisneyDiffuseRenormalized(...) * surface.albedo * (1 - surface.metallic);
    half3 directSpecular = SpecularBRDF(...);
    half3 directLighting = (directDiffuse + directSpecular) * light.color * NdotL * light.attenuation;

    // 间接光
    half dfgDiffuse = SAMPLE_TEXTURE2D(_DiffuseLUT, ...).r;
    half3 indirectDiffuse = irradiance * surface.albedo * (1 - surface.metallic) * dfgDiffuse;

    half2 envBRDF = SAMPLE_TEXTURE2D(_BRDFLut, ...).rg;
    half3 F0 = lerp(0.04, surface.albedo, surface.metallic);
    half3 indirectSpecular = prefilteredEnv * (F0 * envBRDF.x + envBRDF.y);
    half3 energyCompensation = 1.0 + F0 * (1.0 / (envBRDF.x + envBRDF.y) - 1.0);
    indirectSpecular *= energyCompensation;

    return directLighting + indirectDiffuse + indirectSpecular;
}
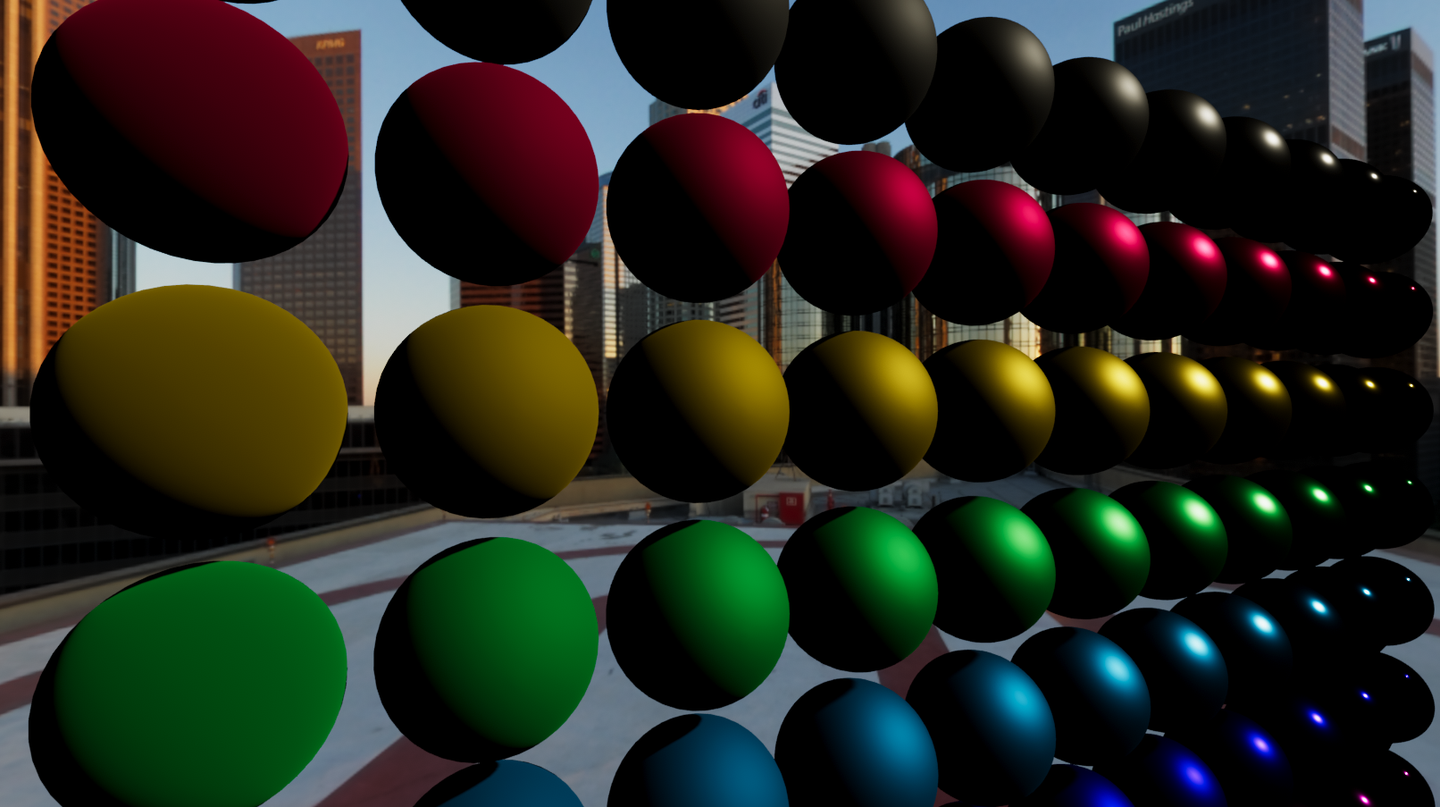
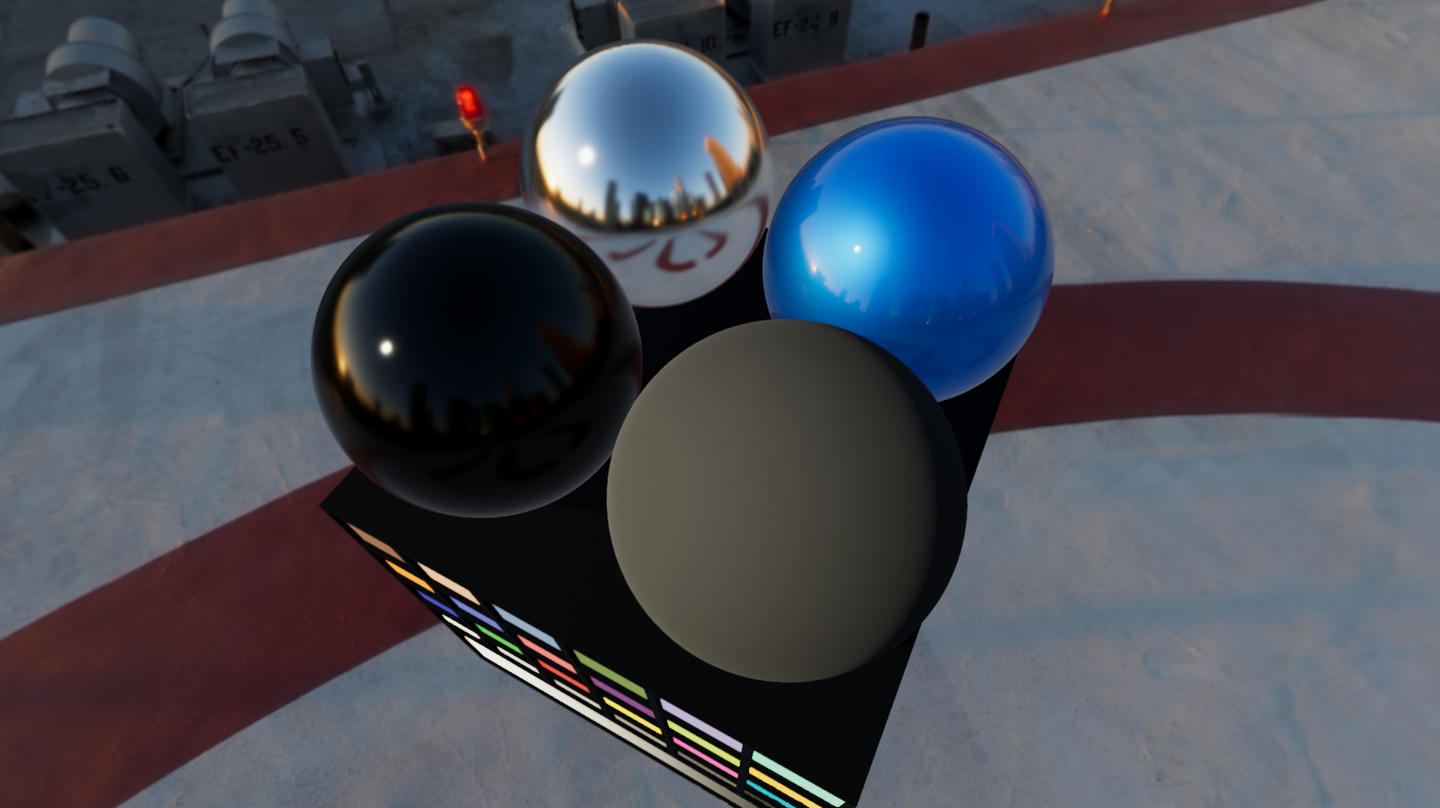
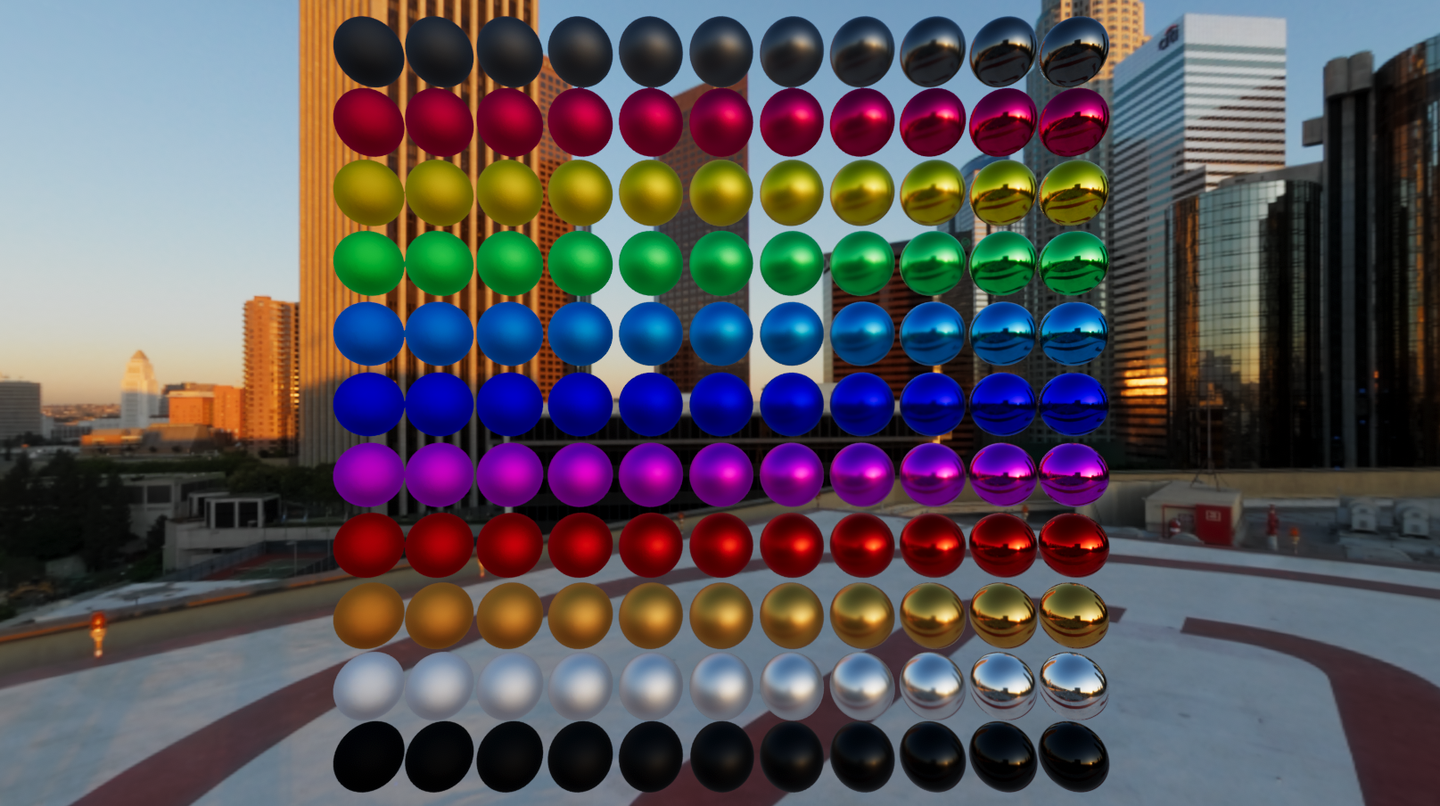
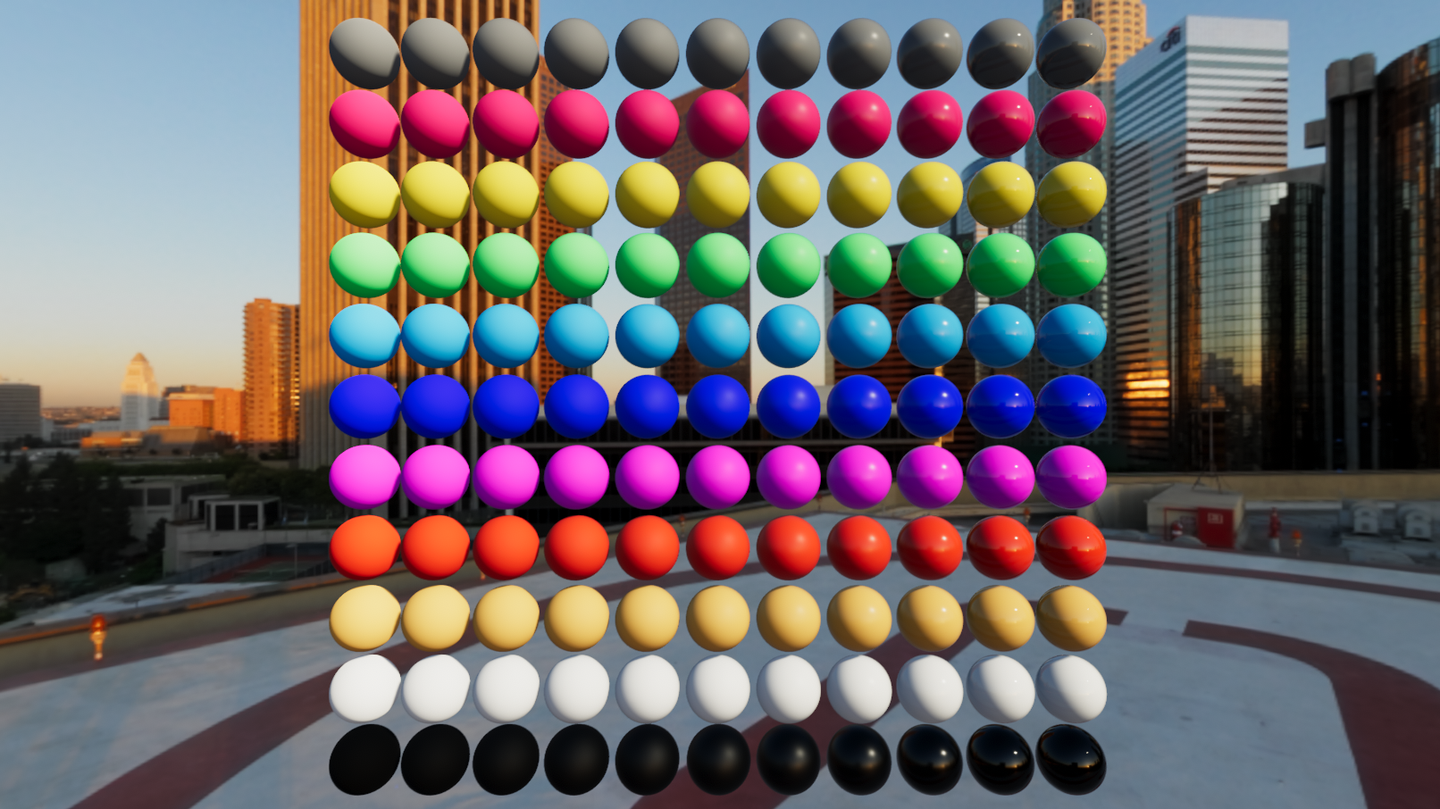
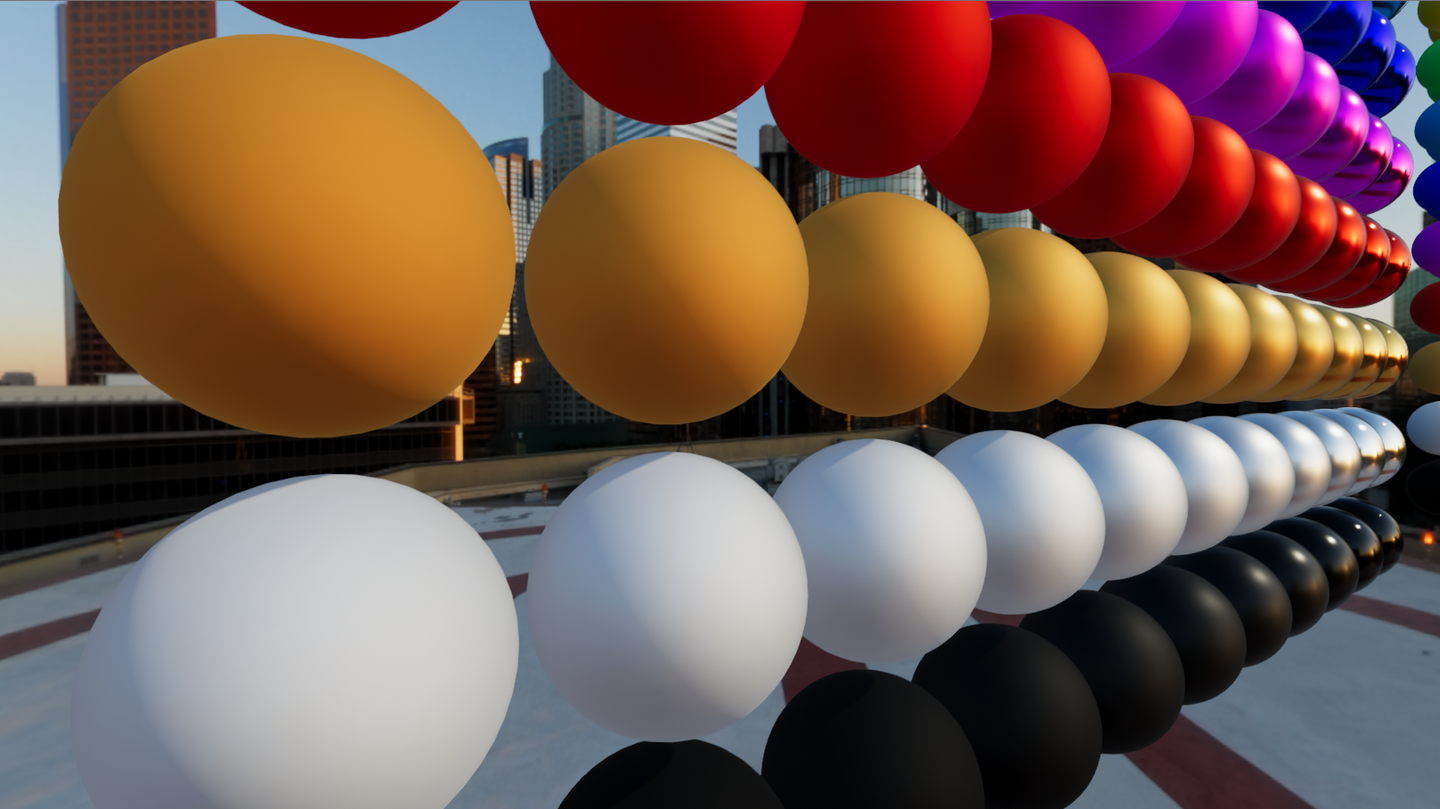
金属度通过 (1 - metallic) 控制 Diffuse 衰减。metallic = 1 时无 Diffuse 分量,所有能量通过 Specular 输出;metallic = 0 时 F0 为 0.04,Specular 仅在掠射角明显。这一能量分配保证了金属和非金属表面在同一框架内物理一致。
能量守恒的完整路径:对于非金属表面,入射能量被分配为 (1-F)*Diffuse + F*Specular。Fresnel F 在正视角约为 0.04,即 96% 能量进入 Diffuse,4% 进入 Specular。在掠射角 F 趋近 1.0,Diffuse 衰减到 0,所有能量由 Specular 反射。对于金属表面,(1-metallic) 项将 Diffuse 完全关闭,F0 取 Albedo 值(通常 > 0.5),Specular 在所有角度都是主要反射通道。Multi-Bounce 补偿确保 G 项丢弃的能量被回收,最终各通道的能量总和不超过 1.0(考虑吸收后为 ≤ 1.0)。

九、小结
Default Shading Model 的完整实现涵盖:Renormalized Burley Diffuse、Cook-Torrance Specular with Visibility、Multi-Bounce 补偿、间接漫反射 Cosine Filter、间接 Specular GGX Pre-Filter 以及 BRDF LUT。除 Default 外,管线还包含 Clear Coat、Cloth、Hair、Subsurface 和 Eye 五种 Shading Model。