

一、方案选型
实时全局光照的方案选择受限于性能预算和场景复杂度。Enlighten 是 Unity 主要的 GI 方案,动态场景表现不错,镜之边缘、往日不再等大厂产品均有使用,但静态场景难以 Bake 出精细的间接阴影。Unity 后来推出的 Progressive 渲染器在 2019.1 中更新了速度和效率,还加入了 OptiX Denoise。不过对于自定义管线,比如 MPipeline,原生 GI 系统存在诸多限制,因此决定自行实现 GI 方案。
方案调研时最初考虑过 Voxel-Based GI,但在当前硬件条件下开销过高,不适合作为通用方案。我第一次听说 SSGi 是在 Unigine 的宣传中,当时称为 Screen-Space Ray Trace GI。最终采用混合 GI 架构:Irradiance Probe 提供低频环境光照,Screen-Space GI(SSGi)补充高频间接光照细节,二者通过 SSGi 的 Mask 混合输出最终结果。
Voxel-Based GI 的开销来源主要有两个:体素化过程需要对场景几何做光栅化到 3D 纹理,通常 128³-256³ 分辨率,每帧更新的带宽和存储成本在中低端 GPU 上不可接受;Cone Tracing 阶段需要对 3D 纹理做各向异性 mipmap 查询,采样次数与 Cone 数量成正比。NVIDIA VXGI 在 GTX 1080 级别的 GPU 上典型开销为 3-5ms,这仅算 Cone Tracing 阶段;加上体素化的开销总计 5-8ms,占满 60fps 帧预算(16.6ms)的 30-50%。对于需要同时运行其他特效的游戏场景,这个比例过高。
混合 GI 架构的设计思路:将 GI 按空间频率分解为低频和高频两个部分。低频 GI 指大面积的环境光照色调、房间级别的间接光弹射,变化缓慢且空间连续,适合用稀疏的 Probe 网格捕获和插值。高频 GI 指物体接触区域的颜色渗透、近距离物体之间的间接光照细节,需要逐像素级别的精度,适合屏幕空间方法。两者的混合通过 SSGi 的命中置信度 Mask 控制:屏幕空间有有效采样的区域信任 SSGi 结果,无有效采样的区域回退到 Probe 数据。
1.1 SSGi 与 RTGI 的精度对比
SSGi 相对于 Ray-Traced GI(RTGI)的精度边界:
| 维度 | SSGi | RTGI (DXR/Vulkan RT) |
|---|---|---|
| 信息来源 | 当前帧的 Depth Buffer + Color Buffer | 完整场景 BVH(含所有几何) |
| 可追踪范围 | 仅屏幕可见区域 | 全场景(含屏幕外、被遮挡) |
| 多次弹射 | 不支持(单次间接) | 支持(递归路径追踪) |
| 背面信息 | 无(Depth Buffer 只有正面深度) | 有(BVH 包含完整三角面) |
| 典型 GPU 开销 | 3-6ms (GTX 970M, 1080P) | 3-8ms (RTX 2060+, 1080P) |
| 硬件要求 | 任何支持 compute shader 的 GPU | 需要 RT Core 或 fallback compute |
| 失败模式 | 屏幕边缘/被遮挡区域丢失 GI | 高 sample 需求导致噪声或性能问题 |
SSGi 的核心精度限制:
- 信息缺失:当光线方向指向屏幕外或被前景遮挡的区域时,无法获取正确的 radiance:这些方向的间接光贡献被丢弃或错误估计。在实践中,约 30-50% 的半球方向在典型室内场景中无有效命中(取决于相机视角和场景遮挡复杂度)
- 单次弹射:SSGi 只能捕获一次间接光弹射。场景中经过两次以上弹射的间接光(如阳光通过窗户 → 地板 → 天花板的二次弹射)在 SSGi 中丢失,需要 Probe 系统补充
- Temporal 依赖:低 SPP + Temporal 累积的方案在相机快速移动时因历史帧失效产生噪声爆发,静止时质量接近高 SPP 但动态时退化明显
RTGI 在上述三个方面都没有限制,但代价是硬件门槛和更高的 baseline 开销。对于不要求 RT 硬件的跨平台项目,SSGi + Probe 的混合方案是当前的实用选择。
SSGi 部分已实现并集成到 MPipeline 中。
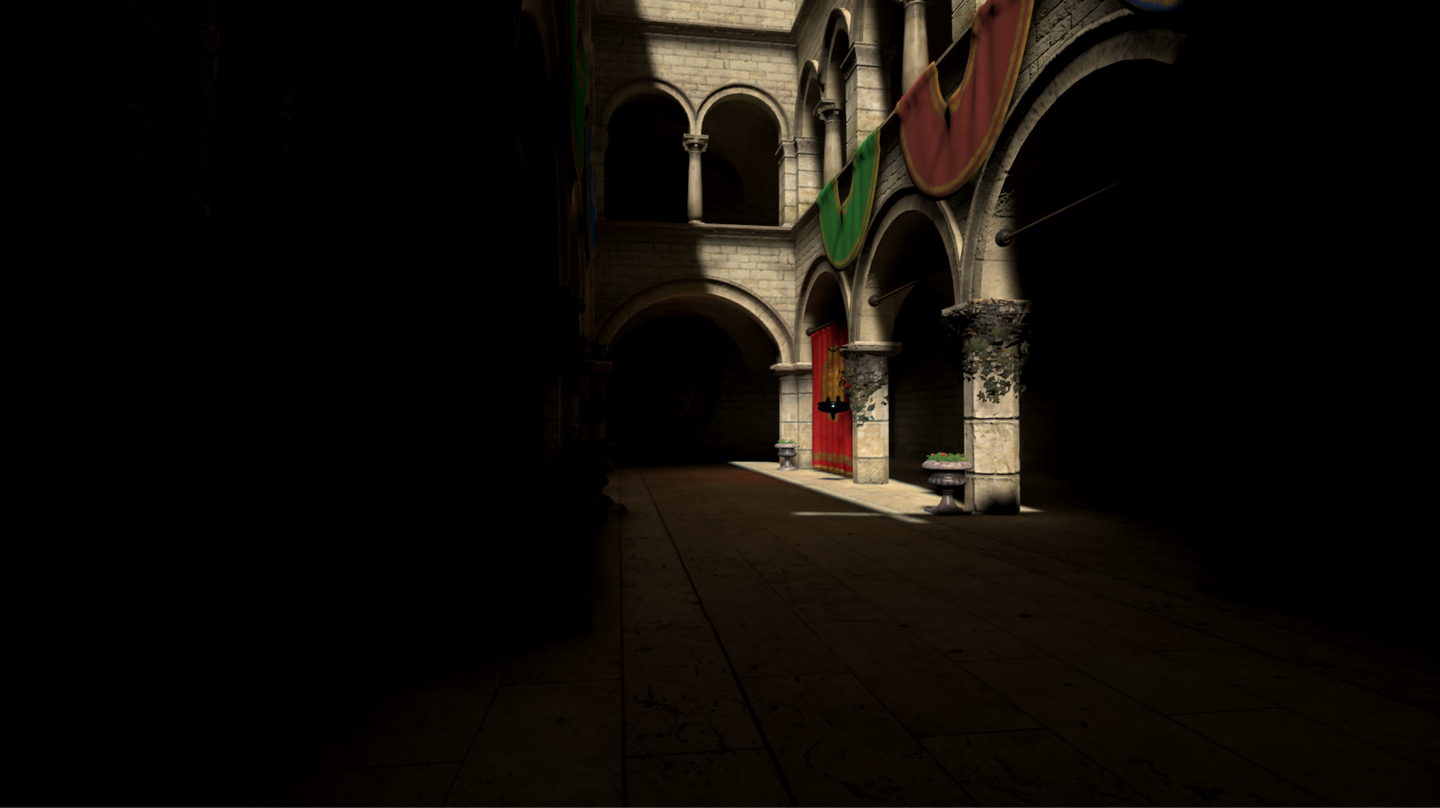
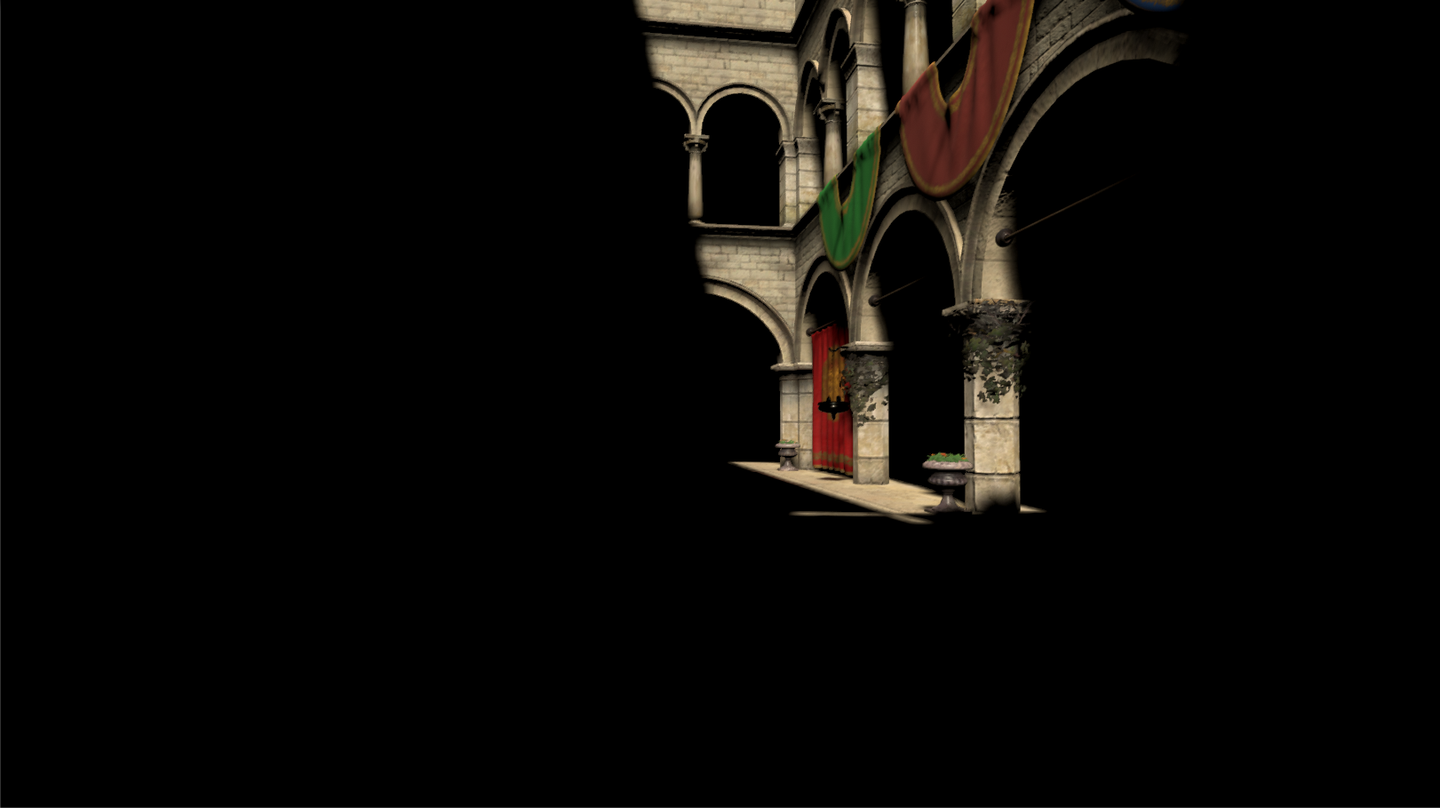
二、SSGi 核心思路
SSGi 的本质是屏幕空间的间接光照采样。与 SSR(Screen-Space Reflections)的区别仅在于光线方向:SSR 沿镜面反射方向追踪,SSGi 则在法线方向的半球内随机采样方向。因此 SSGi 可以复用 SSR 的 HiZ Ray Marching 框架,仅修改光线起点和方向的生成逻辑。
从渲染方程的角度看,间接漫反射光照的积分为:
L_indirect(x) = ∫_Ω f_diffuse · L_i(x, ω_i) · cos(θ_i) dω_i
              = (albedo/π) · ∫_Ω L_i(x, ω_i) · cos(θ_i) dω_i
SSGi 用蒙特卡洛方法估计这个积分:在半球上按 cosine-weighted 分布采样 N 个方向 ω_k,对每个方向做 screen-space ray march 获取命中点的 radiance L_i(x, ω_k),取平均值作为积分估计:
L_indirect ≈ (albedo/π) · (π/N) · Σ L_i(x, ω_k) = (albedo/N) · Σ L_i(x, ω_k)
其中 π/N 的系数来自 cosine-weighted 采样的 PDF 归一化(PDF = cos(θ)/π,Monte Carlo 估计 = f/PDF = L·cos(θ) / (cos(θ)/π) = L·π)。因为 cosine weight 已经被 importance sampling 吸收,最终估计器对采样结果直接取均值乘以 albedo 即可。
SSR 与 SSGi 的架构复用关系:
        SSR                           SSGi
─────────────────────           ─────────────────────
光线方向: reflect(V, N)         光线方向: CosineSampleHemisphere(N)
命中采样: SceneColor             命中采样: SceneColor
输出:    Specular GI             输出:    Diffuse GI
降噪:    Temporal(Ray Motion)    降噪:    Temporal(Surface Motion)
         + Spatial                        + Spatial
共享的部分包括 HiZ Buffer 构建、Ray March 循环、深度比较逻辑和命中点 UV 计算。差异仅在入口的方向生成和出口的降噪策略。
三、Ray Marching
3.1 光线生成
在每个像素位置,生成半球 Cosine-Weighted 随机方向作为光线方向。Cosine 分布确保靠近法线方向的采样概率更高,符合 Lambertian BRDF 的能量分布。
半球 Cosine-Weighted 采样的数学推导:对半球 Ω 按 cos(θ) 加权采样时,CDF 的逆变换得到 θ = acos(sqrt(1-u1))、φ = 2πu2。在笛卡尔坐标下展开:
half3 CosineSampleHemisphere(half2 u)
{
    half r   = sqrt(u.x);
    half phi = 2.0 * PI * u.y;
    half3 dir;
    dir.x = r * cos(phi);
    dir.y = r * sin(phi);
    dir.z = sqrt(1.0 - u.x);
    return dir;
}
推导过程的关键步骤:cosine-weighted 半球上的 PDF 为 p(θ, φ) = cos(θ) · sin(θ) / π(sin(θ) 来自球面积分的 Jacobian)。对 θ 的边缘 CDF:P(θ) = ∫_0^θ 2cos(t)sin(t)dt = sin²(θ)。令 u1 = sin²(θ),解得 sin(θ) = sqrt(u1),cos(θ) = sqrt(1 - u1)。φ 均匀分布于 [0, 2π],令 φ = 2π · u2。最终 x = sin(θ)cos(φ) = sqrt(u1)·cos(2πu2),y = sin(θ)sin(φ) = sqrt(u1)·sin(2πu2),z = cos(θ) = sqrt(1-u1)。
这个分布天然无需额外乘 cos(θ) 权重,直接对采样结果求均值即可无偏估计 Lambertian 漫反射积分。
随机数生成后进行半球 Cosine 变换,将方向转换到屏幕空间执行 HiZ Trace。
Tangent Space 到 World Space 的变换需要构建切线空间基底(TBN 矩阵):
half3x3 BuildTBN(half3 normal)
{
    // 选择与 normal 不平行的辅助向量
    half3 up = abs(normal.z) < 0.999 ? half3(0, 0, 1) : half3(1, 0, 0);
    half3 tangent = normalize(cross(up, normal));
    half3 bitangent = cross(normal, tangent);
    return half3x3(tangent, bitangent, normal);
}

// 将局部半球方向转换到 World Space
half3 localDir = CosineSampleHemisphere(u);
half3 worldDir = mul(localDir, BuildTBN(worldNormal));
3.2 随机数生成策略
随机数 (u1, u2) 的质量直接决定采样收敛速度。不同的随机数生成策略在空间/时间分布特性上差异显著:
Blue Noise(蓝噪声):频谱能量集中在高频区域,空间分布均匀且无明显聚集。特性是相邻像素的随机值差异最大化,这对视觉感知非常友好,因为人眼对条纹、团块这类低频图案比高频噪声更敏感。Blue Noise Texture 通常为 64×64 或 128×128 的预计算纹理,在屏幕上 tile 使用。
Interleaved Gradient Noise (IGN):由 Jorge Jimenez 提出的确定性噪声函数,计算开销极低(无需纹理采样):
half InterleavedGradientNoise(half2 pixelCoord, int frameIndex)
{
    half2 magic = half2(0.06711056, 0.00583715);
    half  magicTime = 52.9829189;
    half  frame = frameIndex * 0.1;
    return frac(magicTime * frac(dot(pixelCoord + frame, magic)));
}
IGN 的优势在于零内存开销(纯 ALU 计算),在不支持纹理采样的 compute shader early stage 或移动端低带宽环境下更实用。
Blue Noise vs IGN 的选择依据:
| 属性 | Blue Noise Texture | IGN |
|---|---|---|
| 空间分布质量 | 优(最大化相邻差异) | 良(接近均匀但非最优) |
| 时间序列质量 | 需要帧间偏移补充 | 帧间偏移内建 |
| 内存开销 | 16-64 KB(纹理) | 0(纯计算) |
| ALU 开销 | 1 次纹理采样 | ~5 ALU ops |
| Temporal 收敛速度 | 快(配合 R2 偏移) | 中等 |
| 视觉噪声感知 | 最低(高频分布) | 低(接近均匀) |
实现中使用 Blue Noise Texture + 帧间偏移:
half2 GetRandomUV(half2 pixelCoord, int frameIndex)
{
    half2 blueNoise = tex2D(_BlueNoiseTexture, pixelCoord / _BlueNoiseSize).xy;
    // R2 序列的帧间偏移(Quasi-Random,优于简单递增)
    half2 offset = frac(half2(0.7548776662, 0.5698402909) * frameIndex);
    return frac(blueNoise + offset);
}
R2 序列的数学基础:R2 序列基于二维广义黄金比例 φ₂ = 1.3247179572...,这个数是 x³ = x + 1 的实数根,步进常数为 (1/φ₂, 1/φ₂²) ≈ (0.7548776662, 0.5698402909)。这对常数在二维空间上的最低差异(low-discrepancy)性质优于 Halton 序列和 Sobol 序列在前 64 项内的表现。帧间使用 R2 偏移意味着:第 k 帧的随机值 = Blue Noise + k × (1/φ₂, 1/φ₂²) mod 1。连续帧的采样点在 [0,1]² 空间中的分布随帧数增加趋向均匀,Temporal Filter 累积多帧后等效于高质量的 quasi-random 序列积分。
帧间偏移策略对比:
| 策略 | 16帧后覆盖率 | 32帧后覆盖率 | Temporal 收敛质量 |
|---|---|---|---|
| 无偏移(同一噪声) | 1/16 (重复采样) | 1/16 | 差(不收敛) |
| 线性递增 (k/N) | ~60% | ~80% | 中等 |
| R2 序列偏移 | ~85% | ~95% | 优 |
| Cranley-Patterson Rotation | ~82% | ~93% | 良 |
3.3 HiZ Trace
采用与 SSR 相同的 Hierarchical-Z 加速结构。光线在 Depth Mip Chain 上逐级步进,利用低分辨率 Mip 快速跳过空白区域,命中后回退到高分辨率 Mip 精确定位交点。
HiZ Buffer 的构建:从全分辨率 Depth Buffer 出发,逐级 downsample,每个上层 texel 取下层 2×2 texel 的最小深度值,也就是离相机最近的深度。这保证了:如果光线未命中某个 Mip Level 的 texel,即光线 Z 值大于该 texel 的 min depth,则光线在该 texel 覆盖的整个区域内都不可能命中,可以直接跳过。
HiZ Buffer 的 Mip 选择与步长计算:
核心算法的逐级步进逻辑可以精确描述为:
-
步长计算:在 Mip Level L 上,每个 texel 覆盖 2^L 个全分辨率像素。步长设为当前 texel 的对角线长度,确保每步至少跨越一个 texel:
stepSize = texelSize_at_mip(L) * sqrt(2)。实际实现中简化为stepSize = pixelSize * (1 << mipLevel),省去 sqrt(2) 因子(代价是可能在 texel 内部多走半步,不影响正确性)。 -
Mip 选择逻辑:
- 当光线 Z > sceneDepth、穿过表面且 mipLevel > 0:回退到 mipLevel - 1,同时将位置回退一步。这确保在更高精度层重新检测交点
- 当光线 Z > sceneDepth 且 mipLevel == 0:进入命中判定,做厚度检测
- 当光线 Z ≤ sceneDepth、未穿过表面:将 mipLevel 提升 1 级以加速跳过空白区域,但不超过 maxMipLevel
-
回退逻辑的细节:回退一步后 mipLevel 降低,下一步的步长变小,在更高精度层重新步进。这个过程可能连续发生多次(从 Mip 4 回退到 Mip 3 → 2 → 1 → 0),每次回退对应一次"放大"操作。最坏情况下回退次数 = maxMipLevel,但平均情况下 1-2 次回退即可找到交点。
// 改进版 HiZ Trace:包含完整的 Mip 选择和回退逻辑
HiZTraceResult HiZTrace_V2(half3 rayOrigin, half3 rayDir,
                            int maxSteps, int maxMipLevel, half maxDistance)
{
    HiZTraceResult result;
    result.hit = false;

    // 将光线转换到 Screen Space (UV + Linear Depth)
    half3 ssOrigin = ViewToScreen(rayOrigin);
    half3 ssEnd    = ViewToScreen(rayOrigin + rayDir * maxDistance);
    half3 ssDir    = ssEnd - ssOrigin;

    // 归一化方向以确保 UV 空间中步进均匀
    half ssLen = length(ssDir.xy);
    if (ssLen < 1e-6) { return result; } // 光线垂直于屏幕,无需步进
    ssDir /= ssLen;

    half3 pos = ssOrigin;
    int mipLevel = 2; // 从中间 Mip 开始(非 0 也非 max)
    int fallbackCount = 0;

    for (int i = 0; i < maxSteps; i++)
    {
        // 计算当前 Mip 的步长
        half cellSize = _ScreenSize.x / (1 << mipLevel); // 当前 mip 的 texel 对应像素数
        half stepSize = (1.0 / _ScreenSize.x) * (1 << mipLevel); // UV 空间步长

        pos += ssDir * stepSize;

        // 越界检查
        if (any(pos.xy < 0) || any(pos.xy > 1)) break;
        if (pos.z < 0 || pos.z > 1) break; // 深度越界

        half sceneDepth = SampleHiZ(pos.xy, mipLevel);
        half depthDiff = pos.z - sceneDepth;

        if (depthDiff > 0) // 光线穿过了表面
        {
            if (mipLevel == 0)
            {
                // 最高精度层:执行厚度判定
                if (depthDiff < _ThicknessThreshold)
                {
                    result.hit = true;
                    result.hitUV = pos.xy;
                    result.hitDepth = sceneDepth;
                    break;
                }
                else
                {
                    // 穿透了薄物体,继续步进(不回退)
                    pos += ssDir * stepSize;
                }
            }
            else
            {
                // 低精度层命中:回退并降级 Mip
                pos -= ssDir * stepSize;
                mipLevel = max(0, mipLevel - 1);
                fallbackCount++;
            }
        }
        else // 未穿过表面
        {
            // 升级 Mip 以加速(每步最多升 1 级,防止跳过太远)
            if (mipLevel < maxMipLevel)
                mipLevel++;
        }

        result.iterations = i;
    }
    return result;
}
初始 Mip Level 的选择:从 Mip 0 开始步进过慢,等同于线性 Ray March;从 maxMipLevel 开始则第一步就可能跳过太远,需要多次回退。我实测时从 Mip 2 开始,对应 4×4 像素粒度的步进,是较好的平衡点:足够跳过近距离的空白区域,又不至于首步就穿过目标。
Conservative Depth 的 Min vs Max 策略:
HiZ 的 downsample 取 min depth(离相机最近)是为了保守地避免漏掉交点。如果取 max depth,光线可能在低 Mip 上判定为"未穿过"而跳过一个实际存在的表面。取 min 的代价是保守过度:光线可能在实际不存在表面的区域触发"穿过"判定,导致不必要的回退。但回退只消耗迭代次数不影响正确性。
替代方案是使用 Min-Max HiZ,同时存储 min 和 max depth:当光线 Z 在 [min, max] 范围内时认为"可能命中"需要降级检测;光线 Z < min 或 > max 时认为"确定未命中"可以安全跳过。Min-Max 方案减少了不必要的回退次数(约 15-20%),但 Mip Chain 的内存翻倍,因为需要同时存储两个值。对于带宽敏感的场景这个 tradeoff 不一定划算。
HiZ 加速的核心优势:对于屏幕空间中大面积空白区域(如天空、远景),光线在高 Mip Level 上一步即可跳过数百像素的距离。未使用 HiZ 的线性 Ray March 需要逐像素步进:在 1080P 下一条跨越半屏的光线可能需要 960 步,而 HiZ 通常只需 20-40 步。
步数分布的实测数据:
| 光线类型 | 平均步数(Linear March) | 平均步数(HiZ) | 加速比 |
|---|---|---|---|
| 命中近处物体 (< 100px) | 50 | 8-12 | 4-6× |
| 命中远处物体 (> 500px) | 500+ | 25-35 | 15-20× |
| 未命中(射向天空) | 960 (屏幕宽度) | 6-10 | 96-160× |
| 掠射方向(近平行屏幕) | 200-400 | 30-50 | 5-8× |
SSGi 的光线方向是半球随机方向,分布均匀覆盖各种情况,平均步数约 20-30 步,相比线性 March 的平均 ~200 步,整体加速约 7-10×。
Thickness Heuristic 的作用:Screen Space Ray March 只有正面深度信息,Depth Buffer 存储的是离相机最近的表面深度,无法知道物体的实际厚度。当光线穿过一个表面后,如果不做厚度限制,会在表面背后继续寻找命中,导致错误地"穿透"薄物体命中其后方的内容。通过设置厚度阈值 _ThicknessThreshold,当光线深度超过 depth buffer 深度且差值小于阈值时认为命中,差值大于阈值时认为穿透了薄物体,忽略该命中,继续步进。
Thickness Threshold 的参数调优:
阈值过小:光线在表面附近的数值精度抖动可能错过真实命中,即 false negative,导致 GI 偏暗。阈值过大:光线穿透薄物体后错误地将背后的不相关表面视为命中,即 false positive,导致错误的颜色渗透。
经验值选择:对于 reversed-Z 的 depth buffer,近平面 Z=1、远平面 Z=0,在 linear depth 空间中,阈值设为 0.5-2.0 世界单位,对应 0.5m-2m,通常合适。室内场景中墙壁厚度约 0.1-0.3m,家具厚度约 0.02-0.5m。阈值设为 1.0m 时,墙壁厚度小于阈值,光线继续步进完成穿透;家具表面刚被穿过时 depthDiff 小于阈值,判定命中。
更高级的做法是自适应阈值:根据光线步进距离动态增大阈值(远距离的步进累积误差更大,需要更宽容的命中判定):
half adaptiveThickness = _ThicknessThreshold * (1.0 + stepCount * 0.05);
3.4 颜色采样与遮挡计算
光线命中后,利用 Hit UV 采样以下信息:
- SceneColor:获取命中点的已照明颜色作为间接光照颜色
- GBuffer Normal:获取命中点法线,与入射光线方向做 Dot Product 计算遮挡权重
Cosine Hash 生成的随机方向需转换到 World Space 后再与命中点法线做点积运算,这是空间一致性的要求。最终 GI 颜色 = SceneColor * Occlusion。
遮挡权重的物理含义:命中表面的法线如果朝向光线来源方向,即 dot product > 0,说明该表面正面朝向着色点,可以向着色点辐射能量。如果法线背离光线方向,即 dot product ≤ 0,该表面背面朝向着色点,不应有能量贡献,这是 self-intersection 或错误命中的处理。
half3 ComputeSSGiColor(half2 hitUV, half3 rayDirWorld)
{
    half3 sceneColor = tex2D(_SceneColorBuffer, hitUV).rgb;
    half3 hitNormal  = DecodeNormal(tex2D(_GBufferNormal, hitUV));

    // 命中表面的法线应朝向光线来源
    half NdotL = saturate(dot(hitNormal, -rayDirWorld));

    // 距离衰减(可选):远距离命中的贡献递减
    half hitDepth = SampleLinearDepth(hitUV);
    half originDepth = ...; // 着色点深度
    half distFalloff = saturate(1.0 - abs(hitDepth - originDepth) * _DistanceFalloff);

    return sceneColor * NdotL * distFalloff;
}
距离衰减的工程动机:Screen Space 中远距离的命中可靠性较低:光线步进累积的数值误差随距离增大,远处命中的位置精度下降。加入距离衰减可以降低不可靠命中的贡献权重,减少闪烁。
SceneColor 采样的时序问题:SSGi 的 Ray March 命中后采样的 SceneColor 是哪一帧的数据?如果采样当前帧的 SceneColor,则存在循环依赖:当前帧的 indirect lighting 尚未计算完成,SceneColor 中缺少 GI 贡献。解决方案:
- 使用上一帧的 SceneColor:打破循环依赖,引入一帧延迟。对于 60fps 的帧率,单帧延迟在视觉上不可察觉
- 使用当前帧的 Direct Lighting Only Buffer:仅包含直接光照(无 GI),避免循环但丢失了被命中表面自身的间接光贡献。适用于单次弹射的场景
- 使用上一帧的 Final Composited Buffer:包含完整的上一帧光照信息(含 GI),效果最好但需要额外的 History Color Buffer 内存
实现中采用方案 1(上一帧 SceneColor),这也是 UE4/5 的 SSGi 实现所采用的策略。
当前实现为 2 SPP(Samples Per Pixel),输出含大量高频噪声的 GI Color,后续通过降噪管线处理。
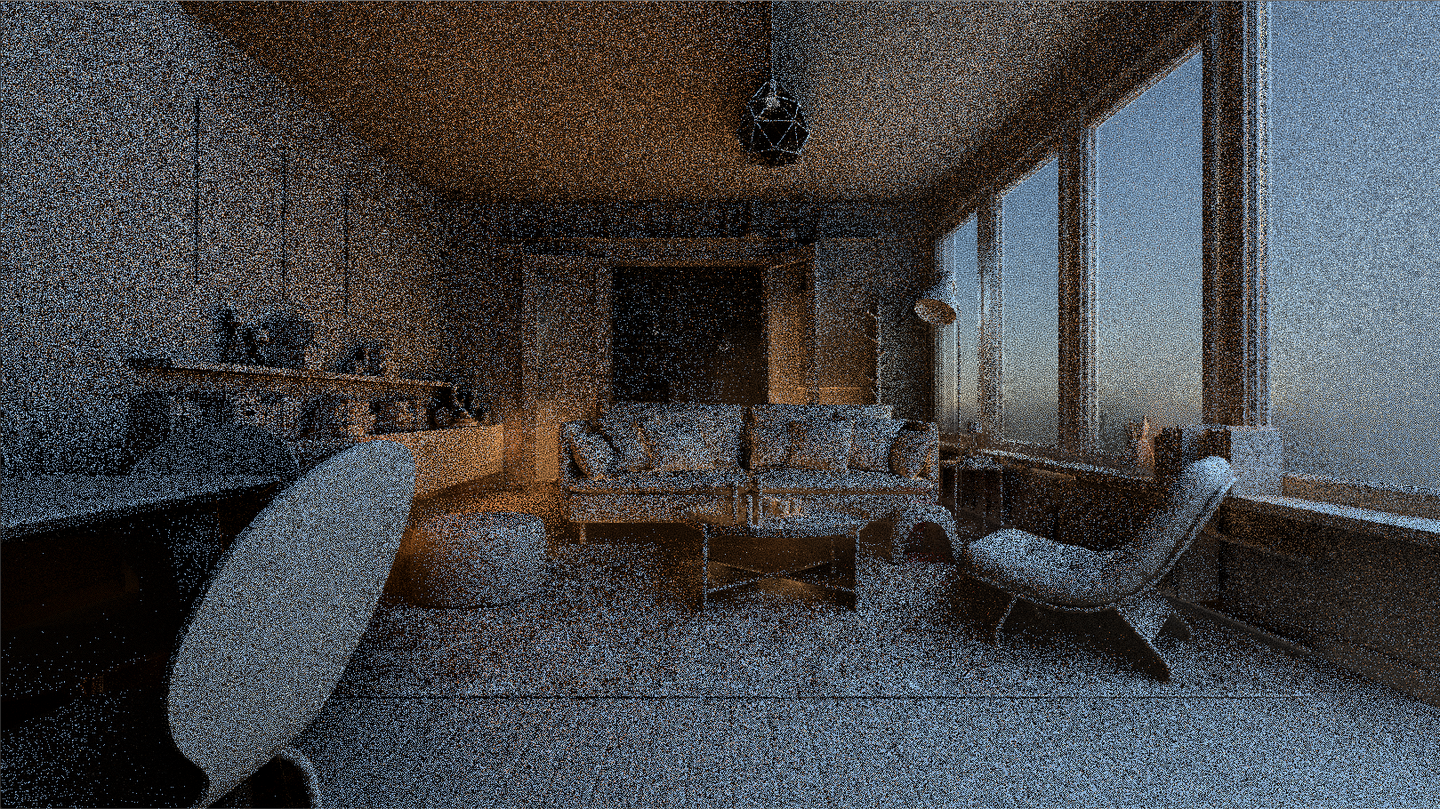
2 SPP 是我按性能预算定的:每条光线的 HiZ Ray March 约消耗 20-40 次纹理采样(取决于场景复杂度和步进距离)。2 SPP = 2 条光线/像素,在 1080P 下约 4M 条光线,总采样量约 80-160M 次。在 GTX 970M 的 bandwidth 和 texture cache 条件下,这约对应 3-4ms 的 GPU 时间。增加到 4 SPP 会将时间翻倍至 6-8ms,对于目标 60fps 而言超出预算。
SPP 与降噪质量的权衡:
| SPP | Ray March 开销 | Temporal 等效 SPP (α=0.9) | 视觉噪声(静态) | 视觉噪声(运动) |
|---|---|---|---|---|
| 1 | ~1.8ms | ~10 | 可见低频波动 | 明显噪声 |
| 2 | ~3.5ms | ~20 | 几乎无可见噪声 | 轻微噪声 |
| 4 | ~7.0ms | ~40 | 无可见噪声 | 轻微波动 |
| 8 | ~14ms | ~80 | 完全干净 | 几乎无噪声 |
2 SPP 是静态质量可接受、运动质量可容忍、性能可负担的平衡点。对于运动快的场景(如 FPS 游戏),可考虑 1 SPP + 更激进的 Spatial Filter 以换取性能。
四、降噪
4.1 Temporal Filter
由于 SSGi 处理的是 Diffuse 表面的间接光照,Temporal Reprojection 可以直接使用 Motion Vector 进行重投影,不需要像 SSR 那样混合 Ray Motion(镜面反射的重投影需考虑反射虚像的运动)。
Temporal 累积之后等效采样数上来了,噪声明显压下去。
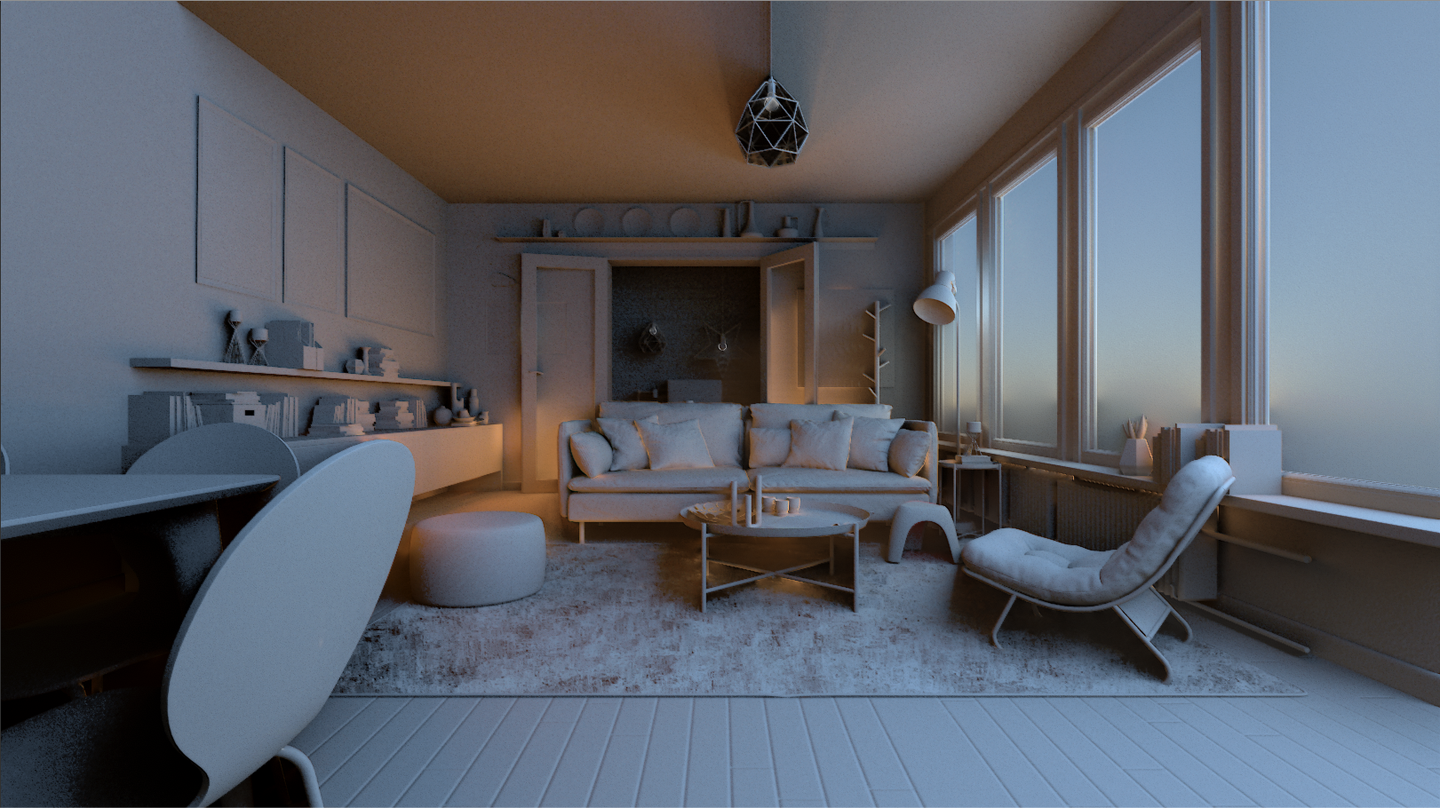
Temporal 累积的有效帧数分析:
以 2 SPP + 0.9 的 Temporal Blend Factor 为例,稳定状态下等效累积 SPP ≈ 2 / (1 - 0.9) = 20 SPP。这个等效关系来自指数移动平均的收敛性质:当 blend factor α = 0.9 时,第 k 帧之前的贡献为 (1-α)·αᵏ,有效窗口约 1/(1-α) = 10 帧,每帧贡献 2 SPP,总等效约 20 SPP。
有效帧数的准确计算:EMA 的有效样本量(Effective Sample Size)为 ESS = (1+α)/(1-α)。对 α=0.9,ESS = 19,Temporal 累积等价于使用最近 19 帧的数据做加权平均。
但有效帧数的退化主要有三个来源:
相机移动时,Motion Vector 引导的重投影将历史帧数据映射到当前帧,但遮挡/显露(disocclusion)区域没有有效历史,这些像素的有效帧数降为 1,只剩当前帧,噪声瞬间增大。场景光照快速变化时,Neighborhood Clipping 将历史颜色强制约束到当前帧邻域的 AABB 内,会大量拒绝历史数据,等效降低 α 值。重投影后的 UV 位置如果深度差异超过阈值,则认为历史帧无效,被遮挡区域的历史颜色不可用,重置为当前帧数据。
Temporal Blend Factor α 的动态调整策略:
// 根据重投影可靠性动态调整 blend factor
half ComputeAdaptiveAlpha(half depthWeight, half clipAmount, half baseAlpha)
{
    // depthWeight: 0 = 深度不连续(历史无效),1 = 深度连续
    // clipAmount: 历史颜色被 clip 的比例(0 = 未 clip,1 = 完全被 clip)
    half reliability = depthWeight * (1.0 - clipAmount * 0.5);
    return baseAlpha * reliability;
    // 当 reliability = 1 时 alpha = 0.9(正常累积)
    // 当 reliability = 0 时 alpha = 0(完全使用当前帧)
}
Temporal Reprojection 的具体实现:
half4 TemporalFilter(half2 uv, Texture2D currGI, Texture2D histGI, Texture2D motionVec)
{
    half2 motion = tex2D(motionVec, uv).xy;
    half2 histUV = uv - motion;
    half4 currColor = tex2D(currGI, uv);
    half4 histColor = tex2D(histGI, histUV);
    half currDepth = SampleDepth(uv);
    half histDepth = SampleDepth_Prev(histUV);
    half depthWeight = abs(currDepth - histDepth) < _DepthThreshold ? 1.0 : 0.0;
    half4 neighborMin, neighborMax;
    ComputeNeighborMinMax(currGI, uv, neighborMin, neighborMax);
    histColor = clamp(histColor, neighborMin, neighborMax);
    half alpha = lerp(1.0, _TemporalBlend, depthWeight);
    return lerp(currColor, histColor, alpha);
}
ComputeNeighborMinMax 的实现:遍历当前帧中心像素的 3×3 邻域,统计最小和最大颜色值,构建 AABB Color Clipping Box。这是 Variance Clipping 的简化版本:完整版本使用 μ ± γσ 构建 box,简化版直接用 min/max。min/max 版本的 clipping 更激进(box 更紧),拒绝历史数据更快,收敛速度稍慢但 ghosting artifact 更少。
Variance Clipping vs Min/Max Clipping 的数学对比:
Min/Max Clipping 的 box 边界:[min(neighbors), max(neighbors)]:box 大小完全由极值决定,对 outlier(单个亮点或暗点)敏感。
Variance Clipping 的 box 边界:[μ - γσ, μ + γσ]:基于统计分布,γ 通常取 1.0-1.5。
void ComputeVarianceClipBox(Texture2D tex, half2 uv,
                            out half4 clipMin, out half4 clipMax)
{
    half4 m1 = 0; // 一阶矩
    half4 m2 = 0; // 二阶矩
    [unroll] for (int y = -1; y <= 1; y++)
    [unroll] for (int x = -1; x <= 1; x++)
    {
        half4 s = tex2D(tex, uv + half2(x, y) * _TexelSize);
        m1 += s;
        m2 += s * s;
    }
    m1 /= 9.0;
    m2 /= 9.0;
    half4 sigma = sqrt(max(0, m2 - m1 * m1));
    clipMin = m1 - _ClipGamma * sigma;
    clipMax = m1 + _ClipGamma * sigma;
}
Variance Clipping 在噪声信号上表现更稳定,因为 outlier 对 σ 的影响通过平方根被抑制,但计算量增加约 50%,需要额外计算二阶矩和 sqrt。对于 SSGi 的高噪声输入,Variance Clipping 的 ghosting 抑制效果优于 min/max,推荐在性能允许时使用。
void ComputeNeighborMinMax(Texture2D tex, half2 uv,
                           out half4 colorMin, out half4 colorMax)
{
    colorMin = half4(1e6, 1e6, 1e6, 1e6);
    colorMax = half4(-1e6, -1e6, -1e6, -1e6);
    [unroll] for (int y = -1; y <= 1; y++)
    [unroll] for (int x = -1; x <= 1; x++)
    {
        half4 s = tex2D(tex, uv + half2(x, y) * _TexelSize);
        colorMin = min(colorMin, s);
        colorMax = max(colorMax, s);
    }
}
与 SSR 的 Temporal 实现的核心区别:SSR 需要计算 Ray Motion(反射虚像的运动向量),因为镜面反射的历史帧对应点与表面运动方向不同;Diffuse GI 不存在虚像问题,直接用 surface Motion Vector 即可。
SSR Ray Motion 的问题说明:当一面镜子移动时,镜中虚像的运动与镜面本身的运动不同:虚像的运动取决于镜面、观察者和被反射物体三者的相对位移。对 SSR 做 Temporal Reprojection 时,如果错误地使用表面的 Motion Vector 重投影反射内容,运动场景中会出现明显的 ghosting(反射图像拖影)。Diffuse GI 没有这个问题:间接漫反射光照只取决于着色点周围的几何和照明环境,不依赖观察方向,因此表面自身的 Motion Vector 是正确的重投影依据。
4.2 Spatial Filter
Temporal 之后仍存在残留噪声,使用 Cross Bilateral Filter 进行空间滤波。Bilateral 权重基于深度差异,防止跨越几何边界的模糊。
当前实现仅使用 Depth Weight。加入 Normal Weight 可以进一步保留几何细节边缘的锐利度,减少过度模糊,但在最终与场景颜色混合后差异不太明显。
4.3 Bilateral Filter 的 Kernel 设计
Spatial Filter 的实现采用分离式(Separable)两 Pass 执行:
half4 SpatialFilter(half2 uv, half2 direction, int radius)
{
    half  cDepth = SampleLinearDepth(uv);
    half4 cColor = tex2D(_InputGI, uv);
    half4 result = cColor;
    half  totalWeight = 1.0;

    [unroll]
    for (int i = 1; i <= radius; i++)
    {
        half2 offset = direction * i * _TexelSize;

        // 正方向采样
        half2 uvPos = uv + offset;
        half  dPos = SampleLinearDepth(uvPos);
        half  wPos = BilateralWeight(cDepth, dPos);
        result += tex2D(_InputGI, uvPos) * wPos;
        totalWeight += wPos;

        // 负方向采样
        half2 uvNeg = uv - offset;
        half  dNeg = SampleLinearDepth(uvNeg);
        half  wNeg = BilateralWeight(cDepth, dNeg);
        result += tex2D(_InputGI, uvNeg) * wNeg;
        totalWeight += wNeg;
    }

    return result / totalWeight;
}
Kernel 设计的关键决策:
分离式 vs 联合式:2D Bilateral Filter 需要 N×N 次采样(N=radius×2+1),对 radius=6 即 169 次采样/像素,带宽开销过高。分离式将 2D 滤波拆分为水平和垂直两个 1D Pass,每个 Pass 采样 2N+1 次,总采样 4N+2 次。对 radius=6 即 26 次采样,开销降为联合式的 15%。
分离式 Bilateral Filter 严格来说不等价于联合式(因为 Bilateral 权重是非线性的),但在实践中差异很小,且工程上节省的带宽远超精度损失。
加权 Gaussian Kernel 的叠加:当前实现使用均匀空间权重(每个采样点的空间权重为 1)。更精确的做法是叠加 Gaussian 空间衰减:
half SpatialGaussWeight(int offset, half sigma)
{
    return exp(-0.5 * offset * offset / (sigma * sigma));
}

// 完整 Bilateral Weight = Gaussian(空间) × Edge-Stop(深度) × Edge-Stop(法线)
half FullBilateralWeight(int offset, half cDepth, half sDepth,
                         half3 cNormal, half3 sNormal)
{
    half wSpatial = SpatialGaussWeight(offset, _SpatialSigma);
    half wDepth   = exp(-abs(cDepth - sDepth) * _DepthSigma);
    half wNormal  = pow(max(0, dot(cNormal, sNormal)), _NormalPower);
    return wSpatial * wDepth * wNormal;
}
A-Trous Wavelet Filter 作为替代方案:
对于需要更大 kernel radius 的情况,如 1 SPP 或 Temporal 失效区域,A-Trous(à trous wavelet)滤波是更高效的选择。它使用 sparse sampling pattern:每次迭代的采样间隔翻倍,1, 2, 4, 8, 16...,用多次小 kernel Pass 模拟大 kernel 的效果:
// A-Trous Filter: 每次 Pass 的步长为 2^iteration
half4 ATrousFilter(half2 uv, int iteration)
{
    int stepWidth = 1 << iteration; // Pass 0: 1px, Pass 1: 2px, Pass 2: 4px...
    half  cDepth = SampleLinearDepth(uv);
    half3 cNorm  = SampleNormal(uv);
    half4 result = tex2D(_InputGI, uv) * _Kernel[0]; // 5-tap kernel
    half  totalW = _Kernel[0];

    half2 offsets[4] = { half2(1,0), half2(-1,0), half2(0,1), half2(0,-1) };
    [unroll] for (int i = 0; i < 4; i++)
    {
        half2 sampleUV = uv + offsets[i] * stepWidth * _TexelSize;
        half  sDepth = SampleLinearDepth(sampleUV);
        half3 sNorm  = SampleNormal(sampleUV);
        half  w = _Kernel[1] * BilateralWeight(cDepth, sDepth)
                             * pow(max(0, dot(cNorm, sNorm)), 32);
        result += tex2D(_InputGI, sampleUV) * w;
        totalW += w;
    }
    return result / totalW;
}
3 次 A-Trous 迭代,步长 1, 2, 4,等效于 radius=7 的 Bilateral Filter,但总采样次数仅 15 次,即 3 Pass × 5 tap,远低于 radius=7 的分离式 Bilateral 的 30 次。
滤波半径的选择:对于 2 SPP 的输入,Temporal 后等效约 20 SPP,残留噪声的空间频率较高。半径 4-6 像素通常足够消除可见噪声而不引入过度模糊。更大的半径,如 8-12,适用于更低 SPP 或 Temporal 累积不足的情况,比如快速摄像机移动时历史帧失效率高。
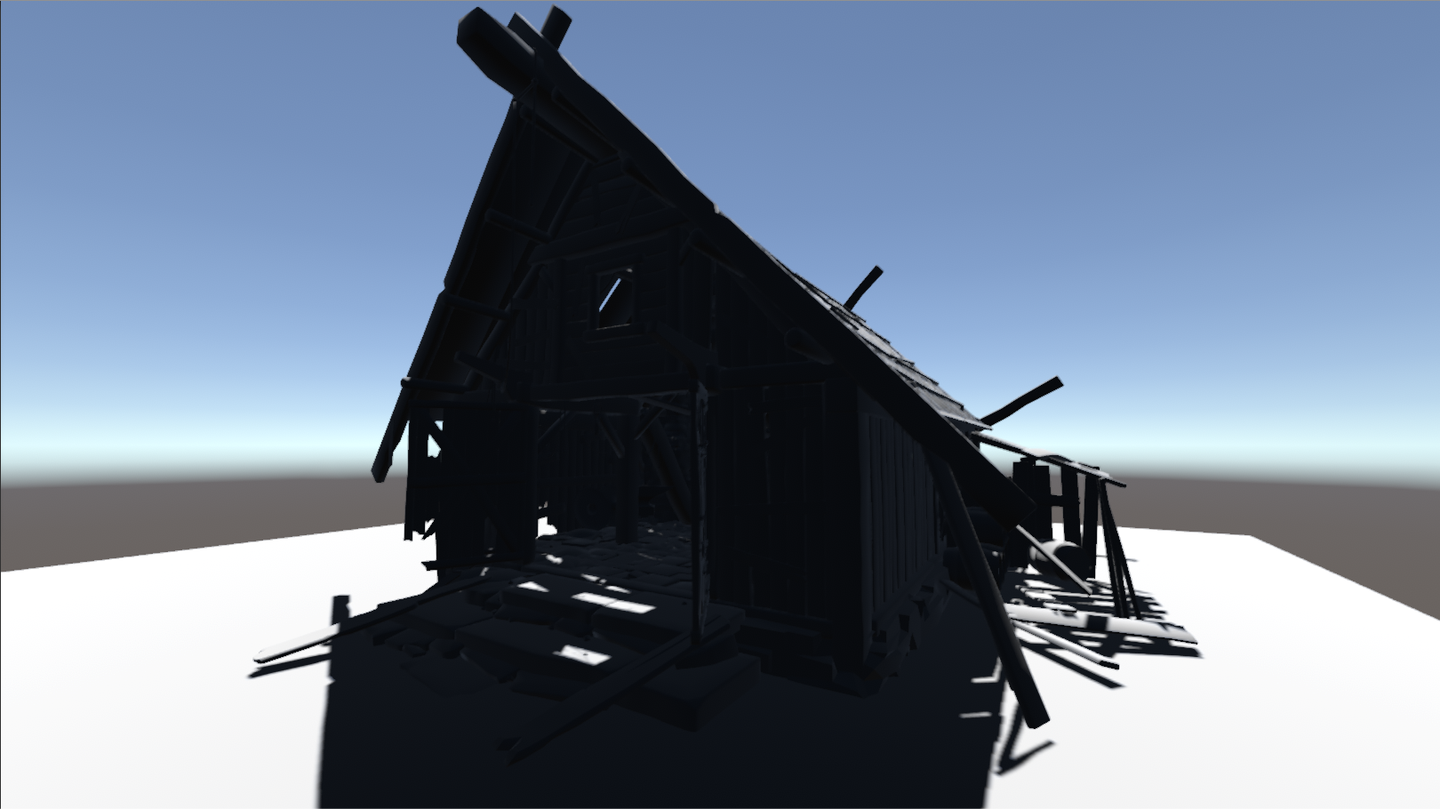
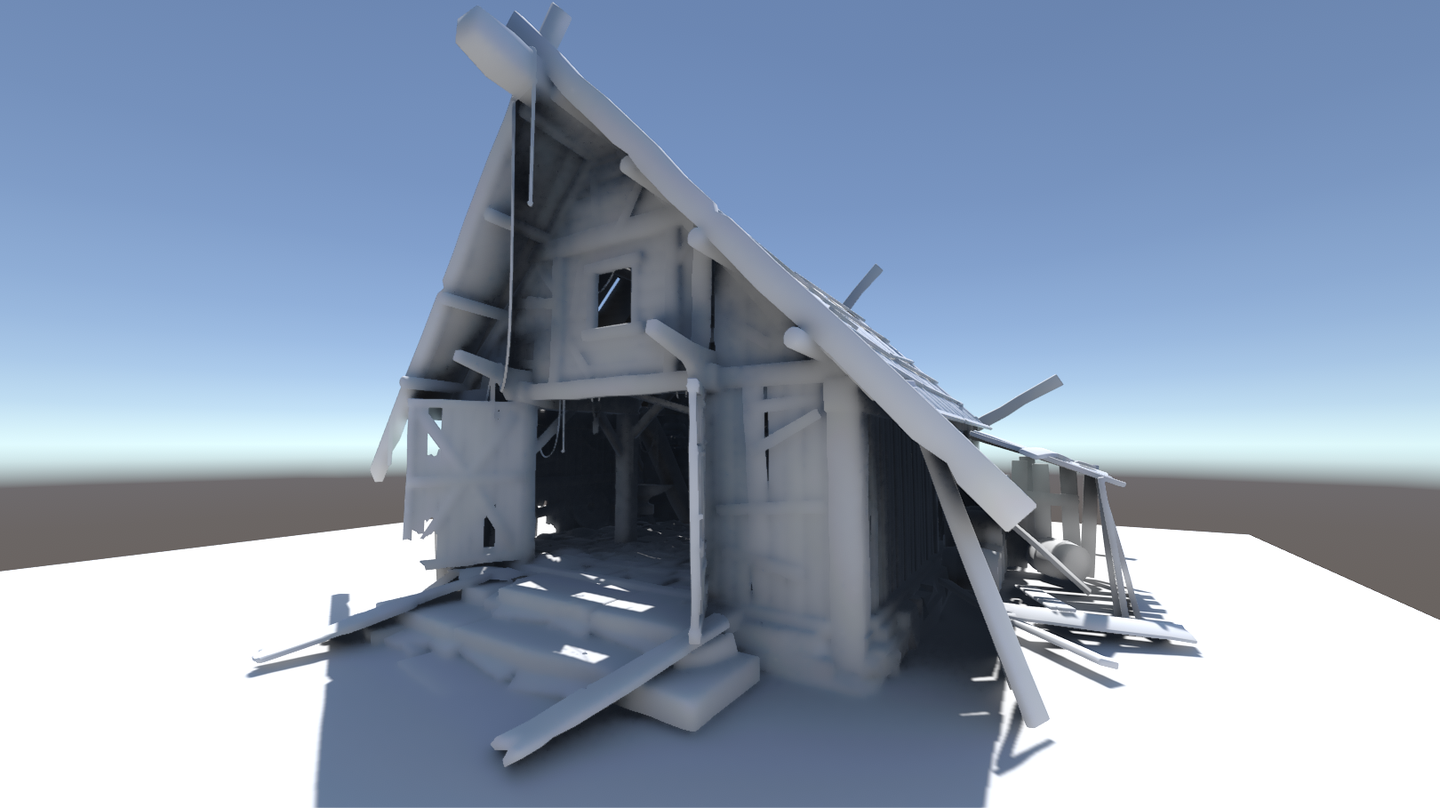
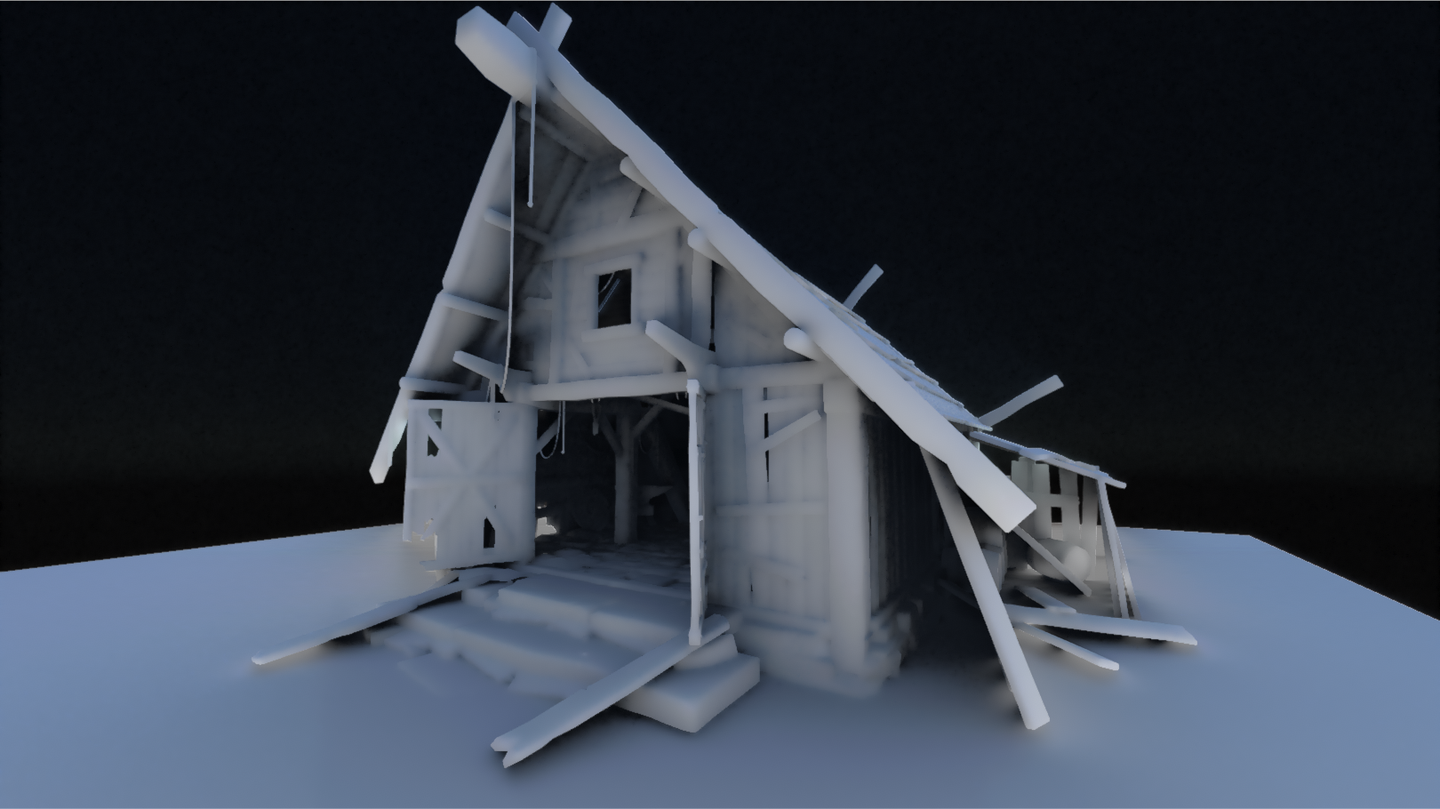
五、性能
我在 GTX 970M 上实测,1080P 全分辨率、2 SPP 配置下整体开销约 5-6ms。对于移动端或低端 GPU,可考虑降分辨率执行 Trace 后上采样。
各 Pass 的开销分解:
| Pass | 开销 | 瓶颈 |
|---|---|---|
| HiZ Buffer 构建 | ~0.3ms | Bandwidth (Mip Chain downsample) |
| Ray Generation + March (2 SPP) | ~3.5ms | Bandwidth (深度采样) + ALU (步进逻辑) |
| Temporal Filter | ~0.5ms | Bandwidth (当前帧 + 历史帧 + 邻域采样) |
| Spatial Filter (2 Pass) | ~0.8ms | Bandwidth (双向采样 × 2 Pass) |
| 合成 | ~0.1ms | — |
Ray March 占总开销的 60% 以上,是优化的首要目标。
优化方向分三条。半分辨率 Trace 在 1/2 分辨率下执行 Ray March,光线数量降为 1/4,2SPP × 1/4 像素即等效 0.5 SPP/全分辨率像素,结果上采样时使用 Bilateral Upscale 保持边缘,代价是低分辨率下 Thickness Heuristic 的精度下降,thin feature 的命中率降低。Stochastic Subsampling 用棋盘格(Checkerboard)模式执行:奇数帧计算偶数像素,偶数帧计算奇数像素,Temporal 累积后恢复全分辨率,代价是运动快速时会出现半像素级的 aliasing。自适应步数根据光线方向与屏幕的夹角决定最大步数:接近平行于屏幕的光线,比如掠射方向,需要更多步数,接近垂直于屏幕的光线很快到达 depth 表面或离开屏幕,可以减少步数。
各优化方案的开销与质量 tradeoff:
| 优化方案 | 开销节省 | 质量影响 | 适用场景 |
|---|---|---|---|
| 半分辨率 Trace | ~60% | 细节物体 GI 丢失,边缘模糊 | 移动端、低端 PC |
| Checkerboard | ~45% | 运动时半像素 aliasing | 30fps 目标 |
| 自适应步数 | ~15-25% | 掠射方向 GI 略有退化 | 通用优化 |
| 降低 Max Steps | ~20-40% | 远距离命中丢失 | 小空间场景 |
| 移除距离衰减外区域 | ~10% | 无视觉影响 | 通用优化 |
六、效果分析
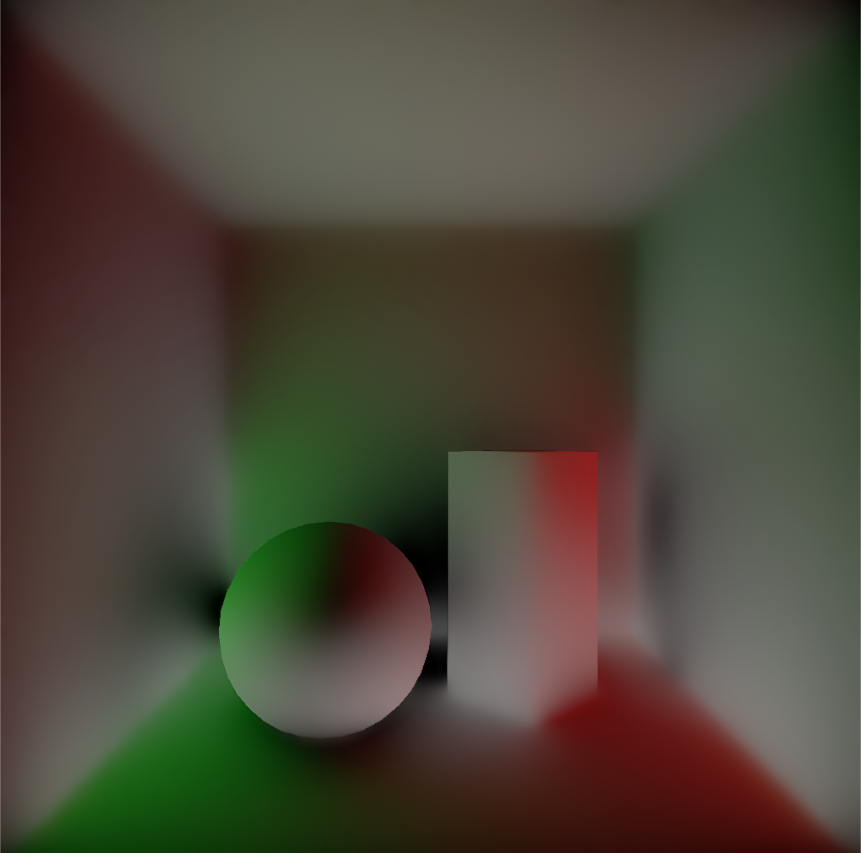
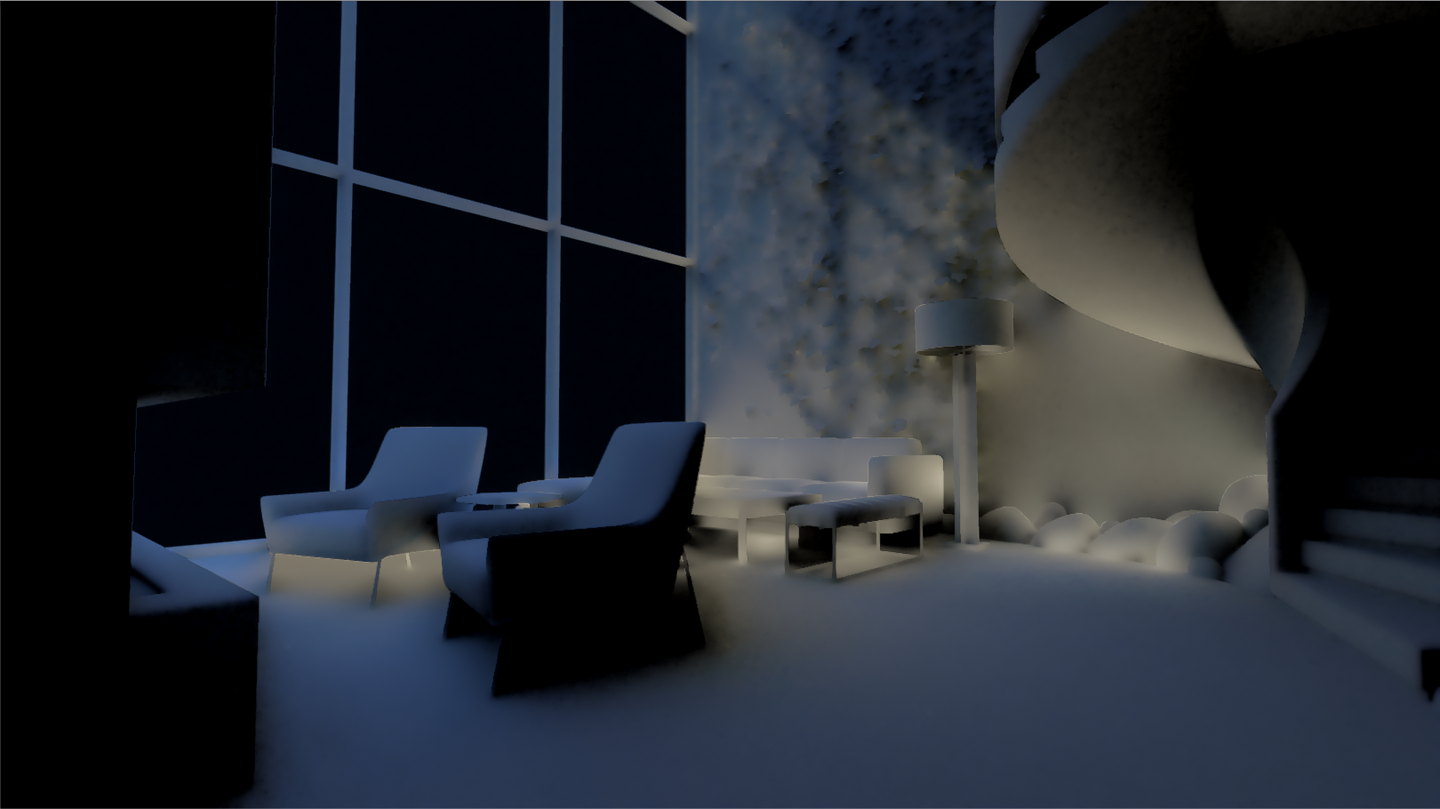
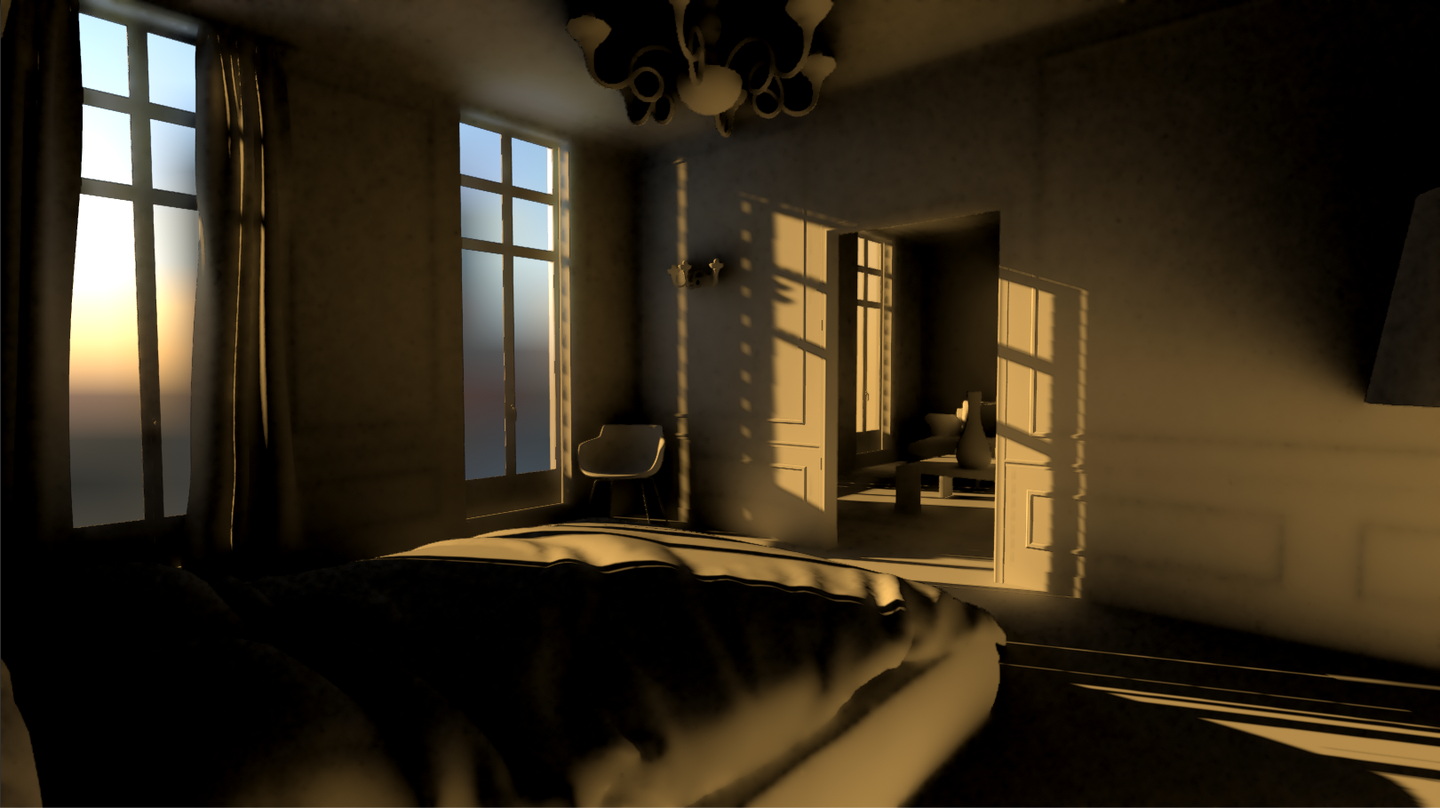
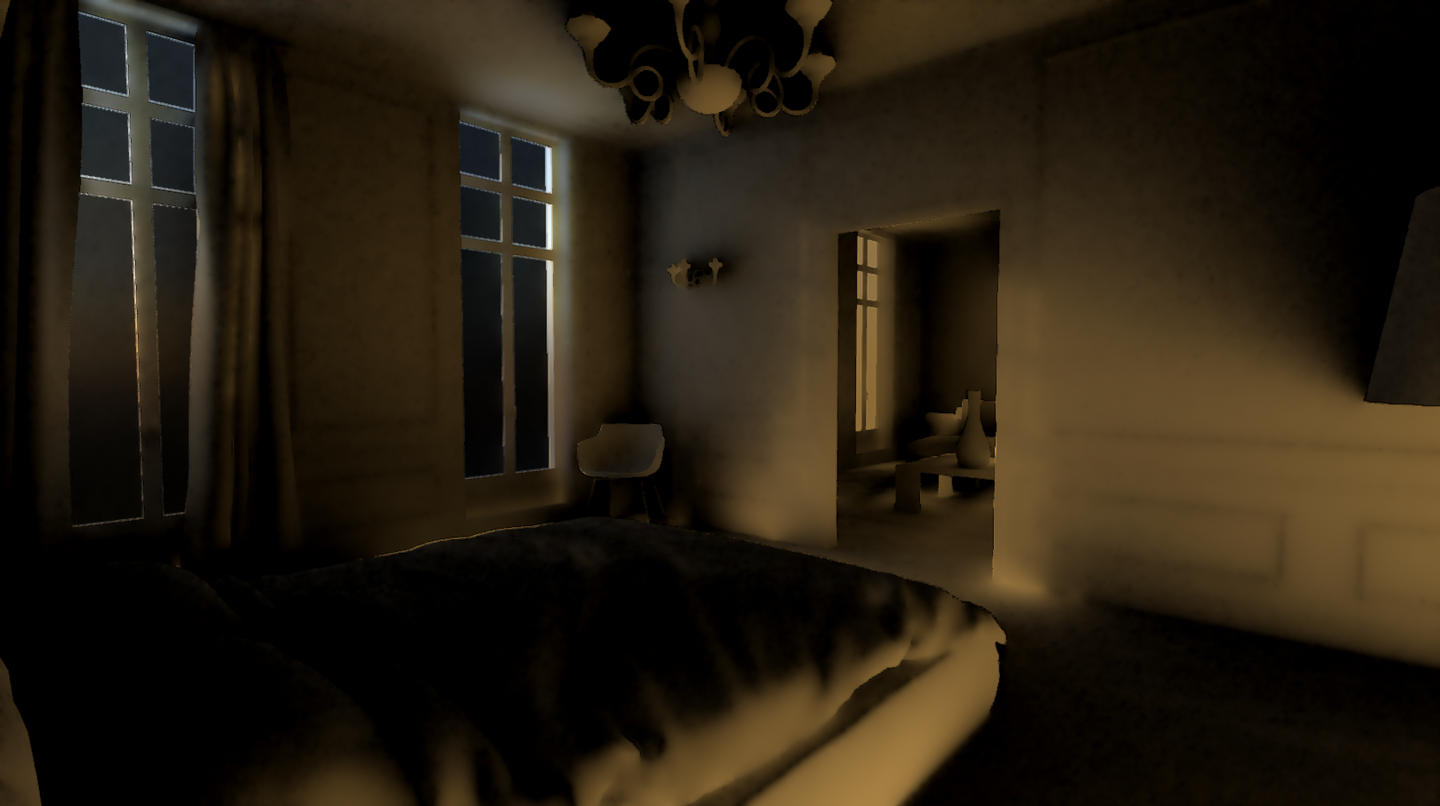
2 SPP + Denoise 的结果与 16 SPP 无降噪的结果在视觉上接近。Bilateral Filter 仅使用 Depth Weight 导致细节处有轻微模糊,但混合到最终场景后影响有限。
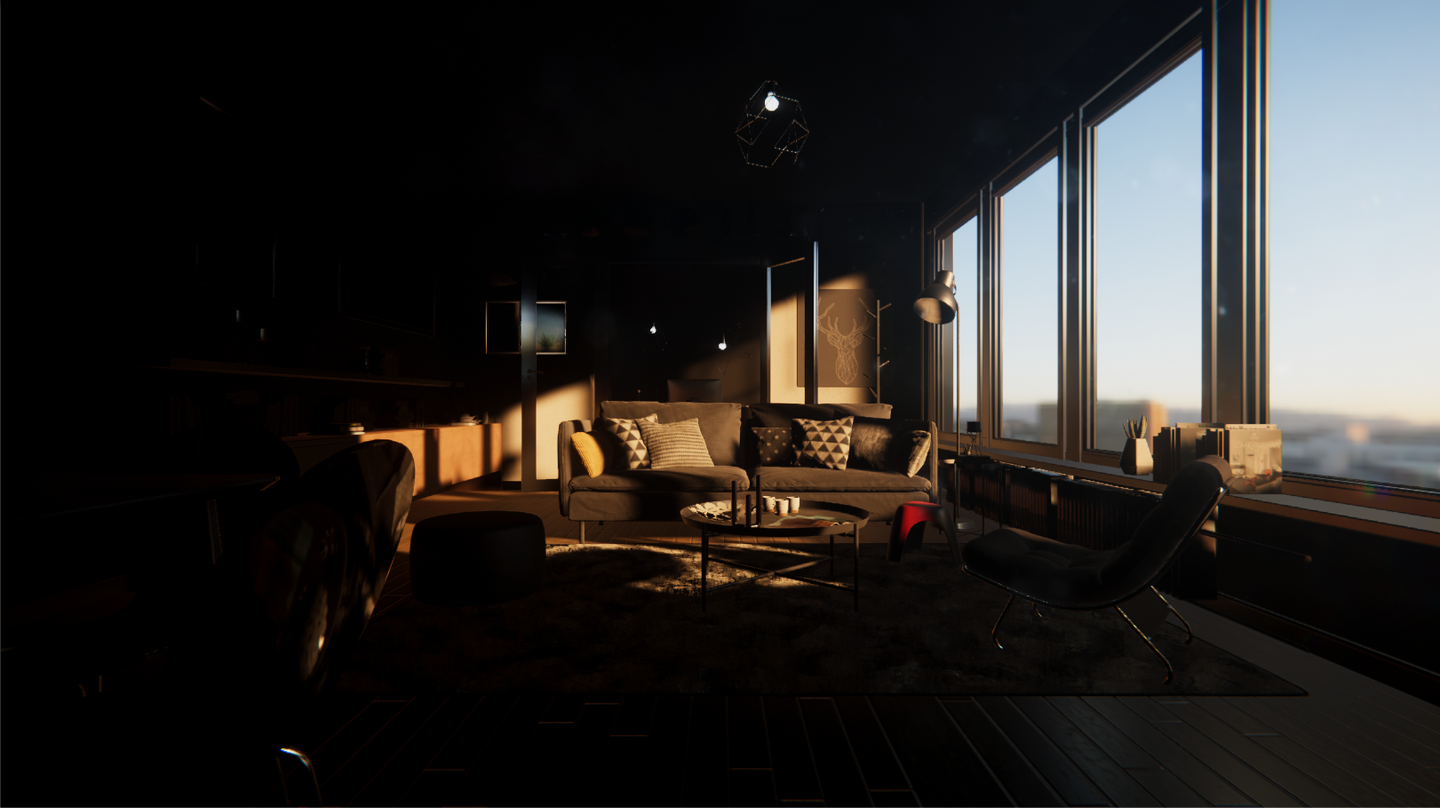
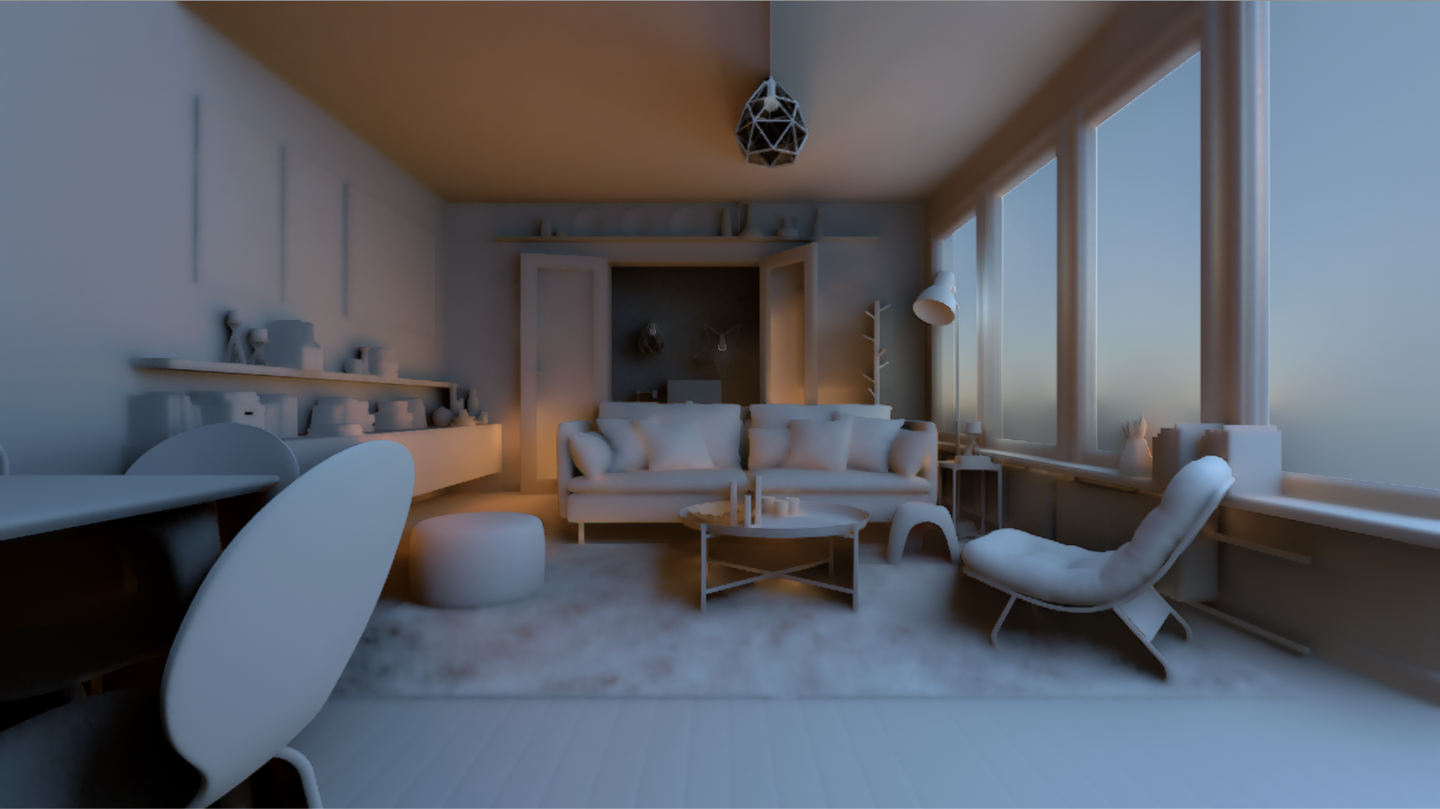
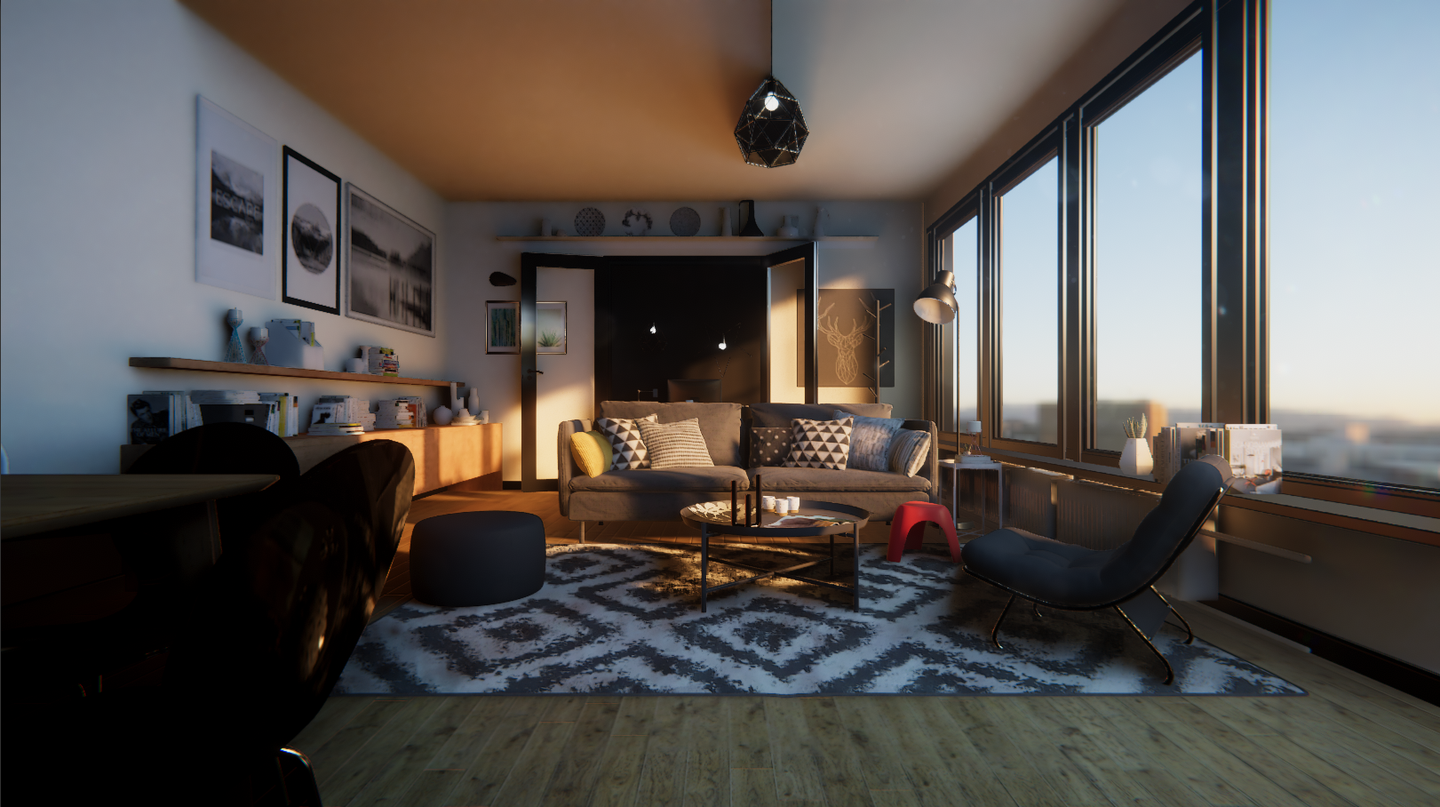
对比分析的具体表现:
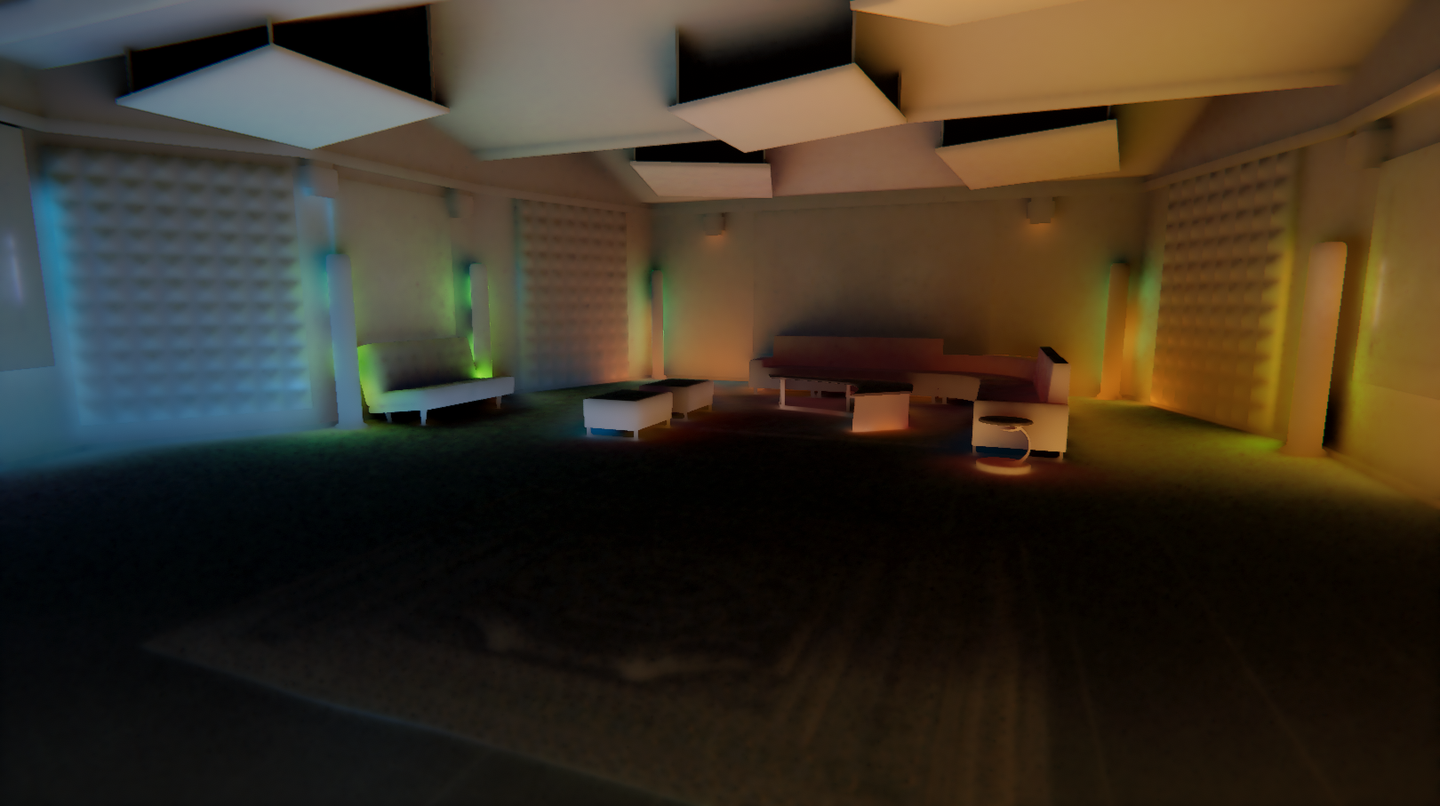
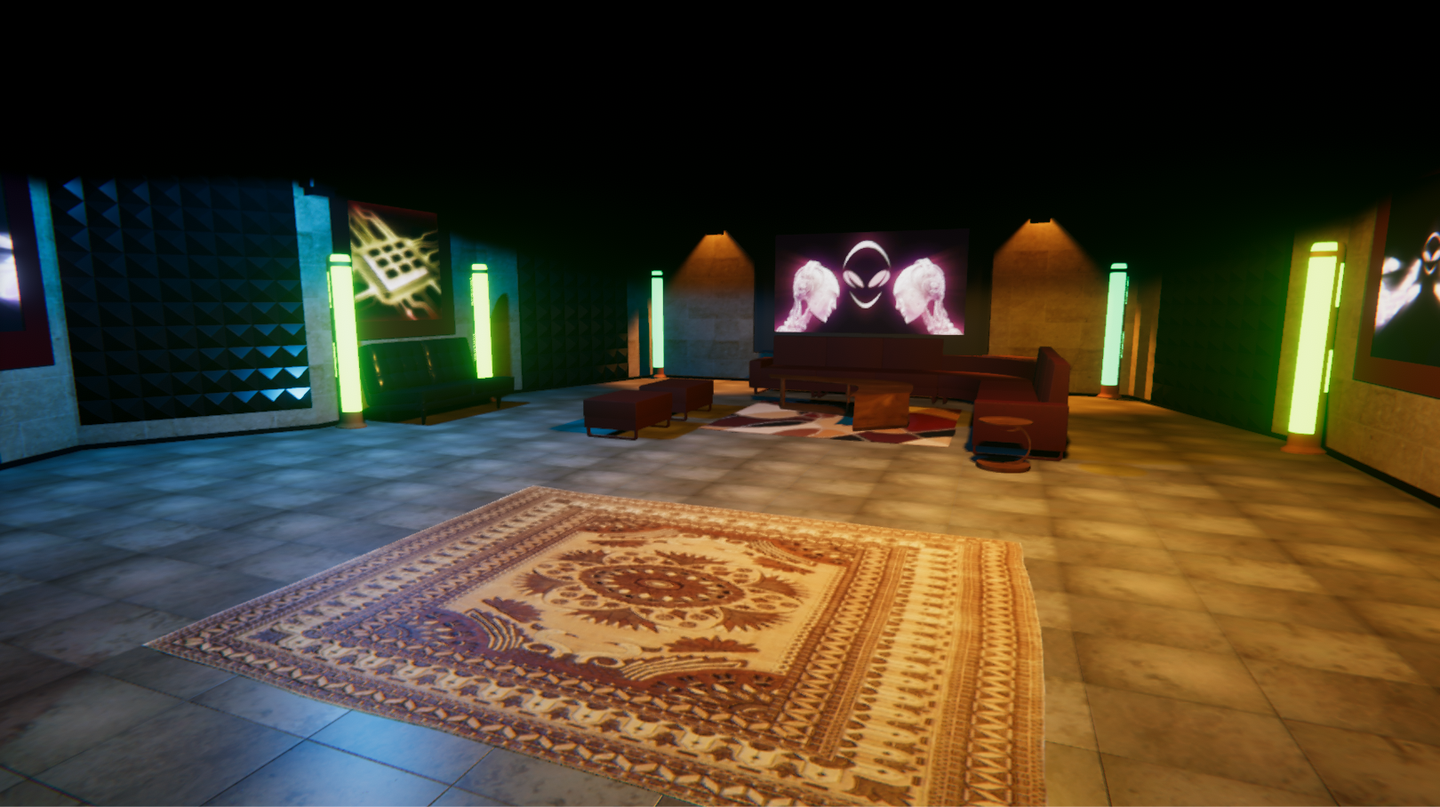
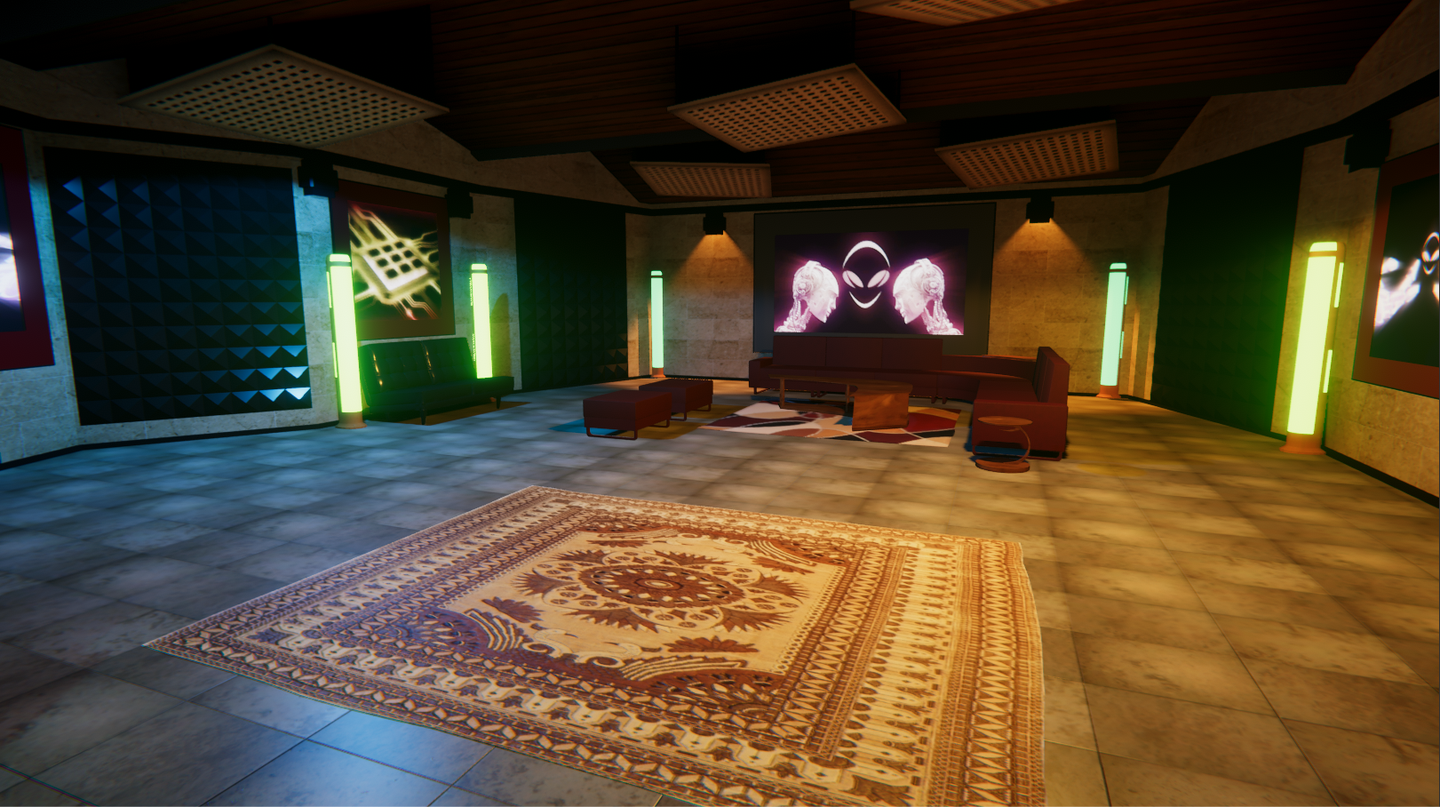
- 颜色渗透精度:红色沙发旁边的白色墙面在 2SPP + Denoise 和 16SPP 两种配置下都正确产生了暖色间接光照,色调一致
- 噪声残留:2SPP + Denoise 在几何复杂的区域(如桌椅下方)仍有轻微的低频噪声波动,16SPP 无降噪版本则表现为均匀的高频噪点
- 边缘保持:Bilateral Filter 在深度不连续处正确保持了边缘锐度,物体轮廓线上的 GI 不会渗透到背景
- 时域稳定性:Temporal 累积使 2SPP 版本在静态场景下的时域稳定性接近 16SPP(因为静态时历史帧完全有效),运动场景下随着历史帧失效率上升会短暂出现噪声增加
当前实现的 Bilateral 权重函数:
half BilateralWeight(half cDepth, half sDepth)
{
    return exp(-abs(cDepth - sDepth) * _DepthSigma);
}
指数衰减权重相比线性衰减的优势:线性衰减在阈值边界处有不连续的梯度(权重从正值跳变为 0),可能导致滤波结果在深度不连续边界处出现细微的亮度跳变。指数衰减平滑过渡至零,边界处理更自然。_DepthSigma 控制深度差异的敏感度:值越大对深度差异越敏感,边缘保持越好但降噪效果越弱。
_DepthSigma 的参数选择:
// DepthSigma 与行为的关系:
// 当 |cDepth - sDepth| = 1/DepthSigma 时,权重衰减为 1/e ≈ 0.37
//
// 推荐值选择依据:
// - 室内场景(深度范围 0.1-20m): DepthSigma = 5-10
//   → 深度差 0.1-0.2m 时权重降为 37%,对应家具边缘处的深度不连续
// - 室外场景(深度范围 1-1000m): DepthSigma = 0.1-1
//   → 深度差 1-10m 时权重降为 37%,对应建筑边缘处的深度不连续
更完善的版本应叠加 Normal Weight:weight *= max(0, dot(cNormal, sNormal))^_NormalPower。这样做的收益是保持几何边缘的锐利度,代价是需要额外的 Normal Buffer 采样。考虑到 SSGi 最终与场景颜色混合后细节差异不大,当前版本只用 Depth Weight 作为性价比选择。
Normal Weight 的作用场景:当两个相邻像素深度相同但法线方向不同时,比如墙面与地面的交线处、曲面的法线变化区域,Depth Weight 无法区分它们,会跨几何边界模糊 GI。Normal Weight 在这种情况下能正确阻止跨表面的模糊。对于以平面为主的场景,如 ArchViz,这个区别不大;对于有大量曲面或复杂几何的场景,如角色模型、有机形态,Normal Weight 的收益更明显。
七、混合 GI 架构
完整的 GI 方案为三部曲:
SSGi 提供高频间接光照细节,代价是屏幕空间的信息丢失,屏幕外物体无贡献;Irradiance Volume 在场景中布置低分辨率探针网格,实时更新 SH 数据,覆盖屏幕空间遗漏的区域,提供低频 GI 基底;两者通过 finalGI = lerp(probeGI, ssGI, ssMask) 混合输出,SSGi 的 Mask 由 Ray March 的命中率决定:有有效命中的区域信任 SSGi 结果,无命中区域 fallback 到 Probe 数据。
SSGi Mask 的生成逻辑:
half ComputeSSMask(int numSamples, int numHits)
{
    // 基础命中率
    half hitRate = (half)numHits / (half)numSamples;

    // Temporal 累积的命中率(使用 EMA 平滑)
    half histMask = tex2D(_HistoryMask, histUV).r;
    half mask = lerp(histMask, hitRate, 0.1); // 慢速收敛以稳定

    return mask;
}
当 Mask 接近 1 时,大部分光线有有效命中,SSGi 结果可信,权重高。当 Mask 接近 0 时,大部分光线命中天空或离开屏幕边界,SSGi 信息不足,权重低,回退到 Probe 数据。过渡区域的 Mask 值在 0-1 之间,两种 GI 结果线性混合。
7.1 Irradiance Volume 的 SH 更新策略
Irradiance Volume 的设计要点:
| 参数 | 配置 | 作用 |
|---|---|---|
| Probe 网格间距 | 1-3 米 | 覆盖整个可行走区域 |
| SH 阶数 | L1 或 L2(4 或 9 个系数) | 编码低频方向性光照 |
| 更新策略 | 每帧更新部分 Probe(round-robin) | 对动态光源响应 |
| 遮挡处理 | Probe 之间的 visibility 检测 | 防止光照穿墙 |
| 插值方式 | Trilinear 插值 + Visibility Weight | 确保相邻 Probe 被几何遮挡时不参与插值 |
SH 存储与评估:
L1 SH,4 个系数/通道,共 12 个 float for RGB,能表达光照的主方向和强度梯度。L2 SH,9 个系数/通道,共 27 个 float for RGB,能表达更复杂的方向性分布,如两个对向光源。对于室内场景的间接光,通常来自多个方向的散射光,L1 足够捕获主要的方向梯度;L2 在窗户附近,直接光方向性强,优势更明显。
SH 评估的着色器代码:
// L1 SH 评估:4 个系数
half3 EvaluateSH_L1(half4 shR, half4 shG, half4 shB, half3 normal)
{
    half4 basis = half4(0.282095, // Y_00
                        0.488603 * normal.y, // Y_1-1
                        0.488603 * normal.z, // Y_10
                        0.488603 * normal.x); // Y_11
    half3 irradiance;
    irradiance.r = dot(shR, basis);
    irradiance.g = dot(shG, basis);
    irradiance.b = dot(shB, basis);
    return max(0, irradiance);
}
Probe 更新的 Round-Robin 策略:
场景中 Probe 数量通常为数百到数千个。每帧更新所有 Probe 不现实(每个 Probe 需要渲染 Cubemap 或执行 Ray Cast 收集 radiance)。Round-Robin 更新按固定顺序每帧更新 N 个 Probe:
// 更新调度(伪代码)
int probesPerFrame = totalProbes / targetConvergeFrames;
int startIdx = frameIndex * probesPerFrame % totalProbes;
for (int i = startIdx; i < startIdx + probesPerFrame; i++)
{
    UpdateProbe(probes[i % totalProbes]);
}
对于 1000 个 Probe、目标 30 帧收敛,每帧更新约 33 个 Probe。每个 Probe 更新的开销取决于 radiance 收集方式:Cubemap 渲染为每个 Probe 渲染 6 面低分辨率 Cubemap(如 16×16),开销约 0.1ms/Probe,33 个就是 3.3ms,过高;Ray Cast (GPU) 为每个 Probe 发射 64-256 条光线,通过 BVH 或 Screen-Space 采样收集 radiance,开销约 0.01-0.03ms/Probe,33 个是 0.3-1.0ms,可接受;从 SSGi 结果回馈则利用 SSGi 已计算的 GI 数据更新最近的 Probe,几乎零额外开销,但只能覆盖屏幕可见区域的 Probe。
Probe Visibility 与穿墙问题:
Trilinear 插值在体积边界处会跨越墙壁:如果一个 Probe 在明亮的房间 A 内,相邻的 Probe 在黑暗的房间 B 内,墙壁附近的像素会错误地混合两个房间的光照,产生光照穿墙。
解决方案:为每对相邻 Probe 预计算 visibility(是否存在不透明几何遮挡)。插值时,被遮挡的 Probe 权重设为 0:
half3 InterpolateProbesWithVisibility(half3 worldPos, ProbeGrid grid)
{
    // 获取包围当前点的 8 个 Probe(Trilinear 的 8 个顶点)
    int3 baseIdx = GetBaseProbeIndex(worldPos, grid);
    half3 frac = GetInterpolationFrac(worldPos, grid);

    half3 result = 0;
    half totalWeight = 0;

    [unroll] for (int i = 0; i < 8; i++)
    {
        int3 probeIdx = baseIdx + cornerOffsets[i];
        half3 probePos = GetProbePosition(probeIdx, grid);

        // Trilinear 基础权重
        half3 cornerFrac = lerp(1 - frac, frac, cornerOffsets[i]);
        half triWeight = cornerFrac.x * cornerFrac.y * cornerFrac.z;

        // Visibility 检测:从着色点向 Probe 发射射线检测遮挡
        // (使用预计算的 Probe-to-Probe visibility 或运行时 Ray Cast)
        half visibility = TestProbeVisibility(worldPos, probePos);

        half weight = triWeight * visibility;
        result += EvaluateProbeSH(probeIdx, worldPos) * weight;
        totalWeight += weight;
    }

    return result / max(totalWeight, 0.001);
}
这种方案的开销来自 visibility 检测。预计算方案用离线 Ray Cast 预计算每对 Probe 的遮挡关系,适合静态场景;运行时方案每帧对可见 Probe 做 short-range Ray Cast,适合动态场景但开销更高。
八、RenderTarget 与数据流总结
完整管线的 RenderTarget 布局:
| Pass | 输入 | 输出 | 格式 |
|---|---|---|---|
| HiZ Build | Depth Buffer (R32F) | HiZ Mip Chain (R32F × N levels) | — |
| Ray March | HiZ, SceneColor, GBuffer Normal, Random | SSGi Raw (RGBA16F) + Mask (R8) | Half Res 可选 |
| Temporal | SSGi Raw, History Buffer, Motion Vector | SSGi Temporal (RGBA16F) | Full Res |
| Spatial H | SSGi Temporal, Depth | SSGi Spatial H (RGBA16F) | Full Res |
| Spatial V | SSGi Spatial H, Depth | SSGi Final (RGBA16F) | Full Res |
| Composite | SSGi Final, Probe GI, Mask | Final Indirect Diffuse | — |
使用 RGBA16F 而非 RGBA8 的原因:间接光照颜色需要 HDR 范围,强光照区域的间接光贡献可能超过 1.0,尤其是窗户附近,8-bit 会导致截断和色带。16F 在精度和带宽之间取得平衡。如果带宽严格受限,可以使用 R11G11B10F,它无 alpha 通道,带宽降为 RGB16F 的 71%。
内存 Budget 估算(1080P 全分辨率):
| Buffer | 格式 | 单帧大小 | 备注 |
|---|---|---|---|
| HiZ Mip Chain | R32F × 10 levels | ~13 MB | Mip 0 = 8MB, 后续级约 1/3 |
| SSGi Raw | RGBA16F | ~16 MB | Half Res 时 4 MB |
| SSGi History | RGBA16F | ~16 MB | Temporal 必需 |
| SSGi Temporal | RGBA16F | ~16 MB | — |
| SSGi Spatial (ping-pong) | RGBA16F × 2 | ~32 MB | 可复用其一 |
| Mask | R8 | ~2 MB | — |
| Mask History | R8 | ~2 MB | — |
| 总计 | ~97 MB | Half Res Trace 可降至 ~70 MB |
在 4GB VRAM 的 GTX 970M 上,97 MB 占总显存的 2.4%,加上 GBuffer、SceneColor、Shadow Map 等其他 RT,总显存占用约 400-600 MB,仍有充足余量。
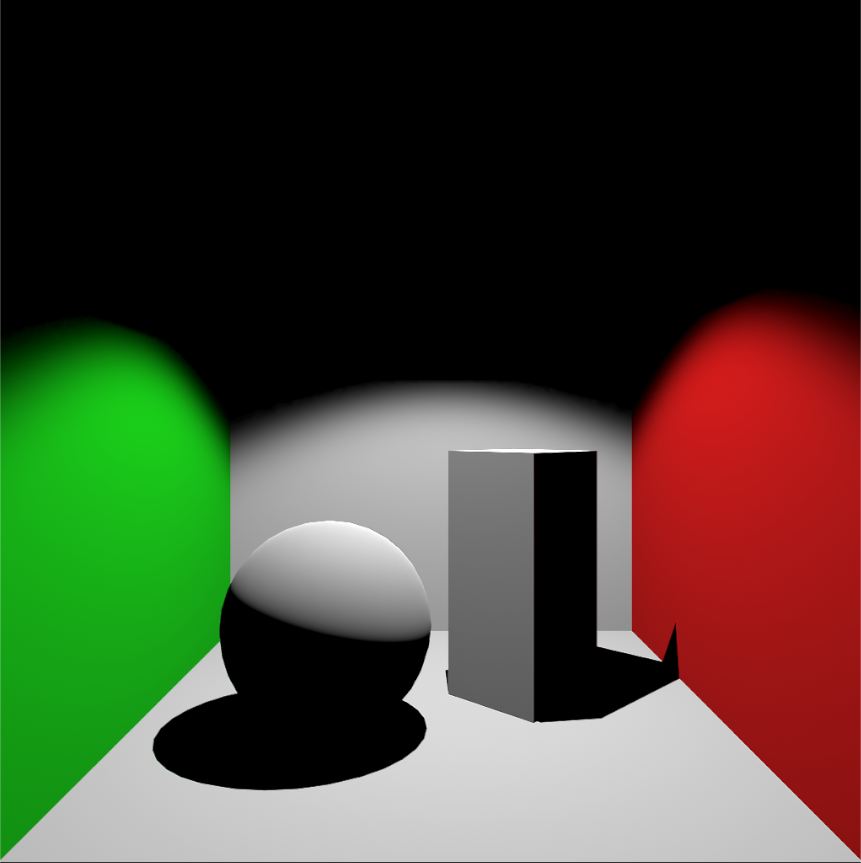
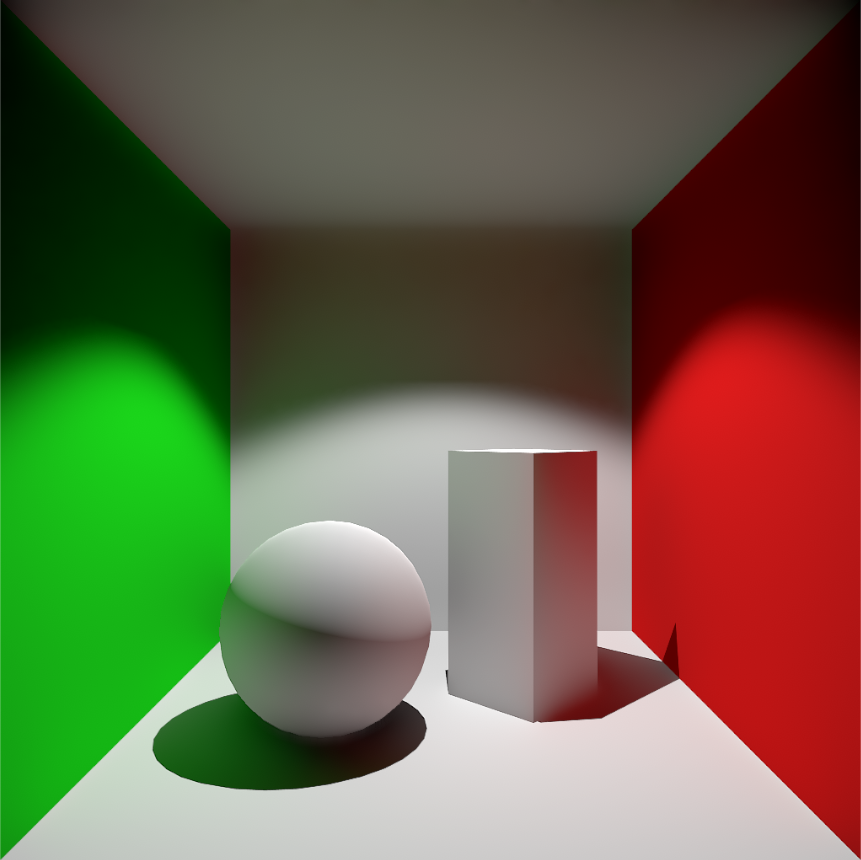
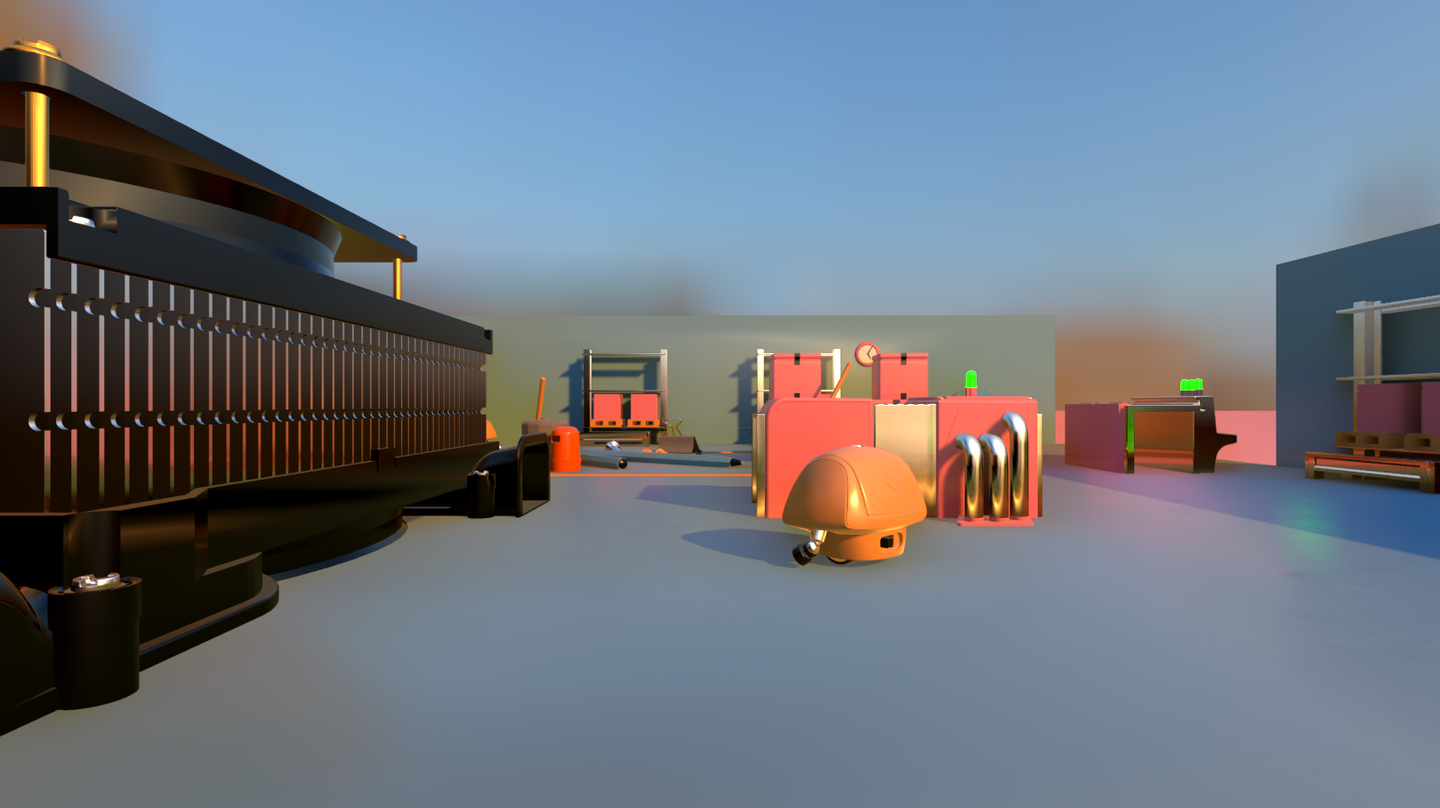
8.1 SSGi 效果展示
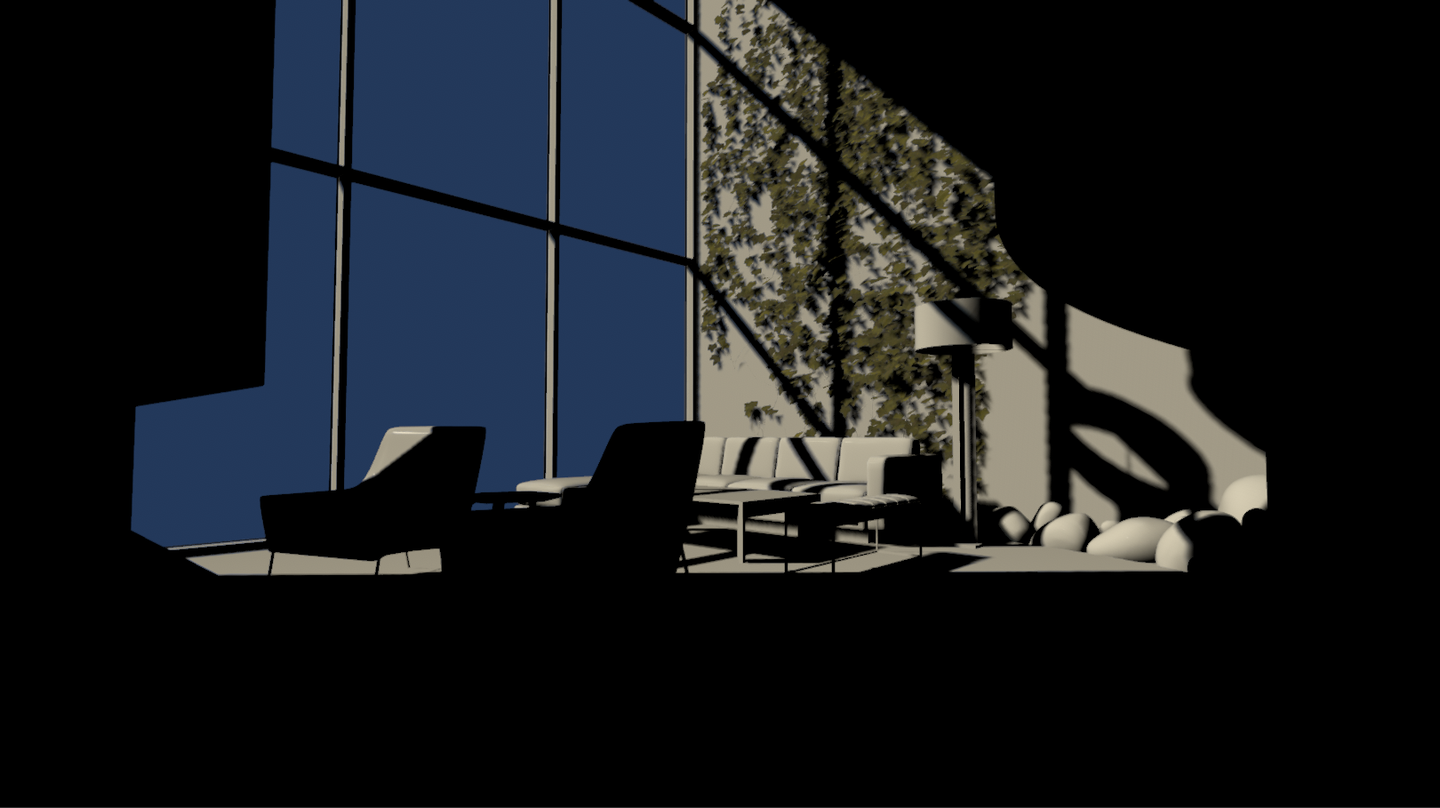
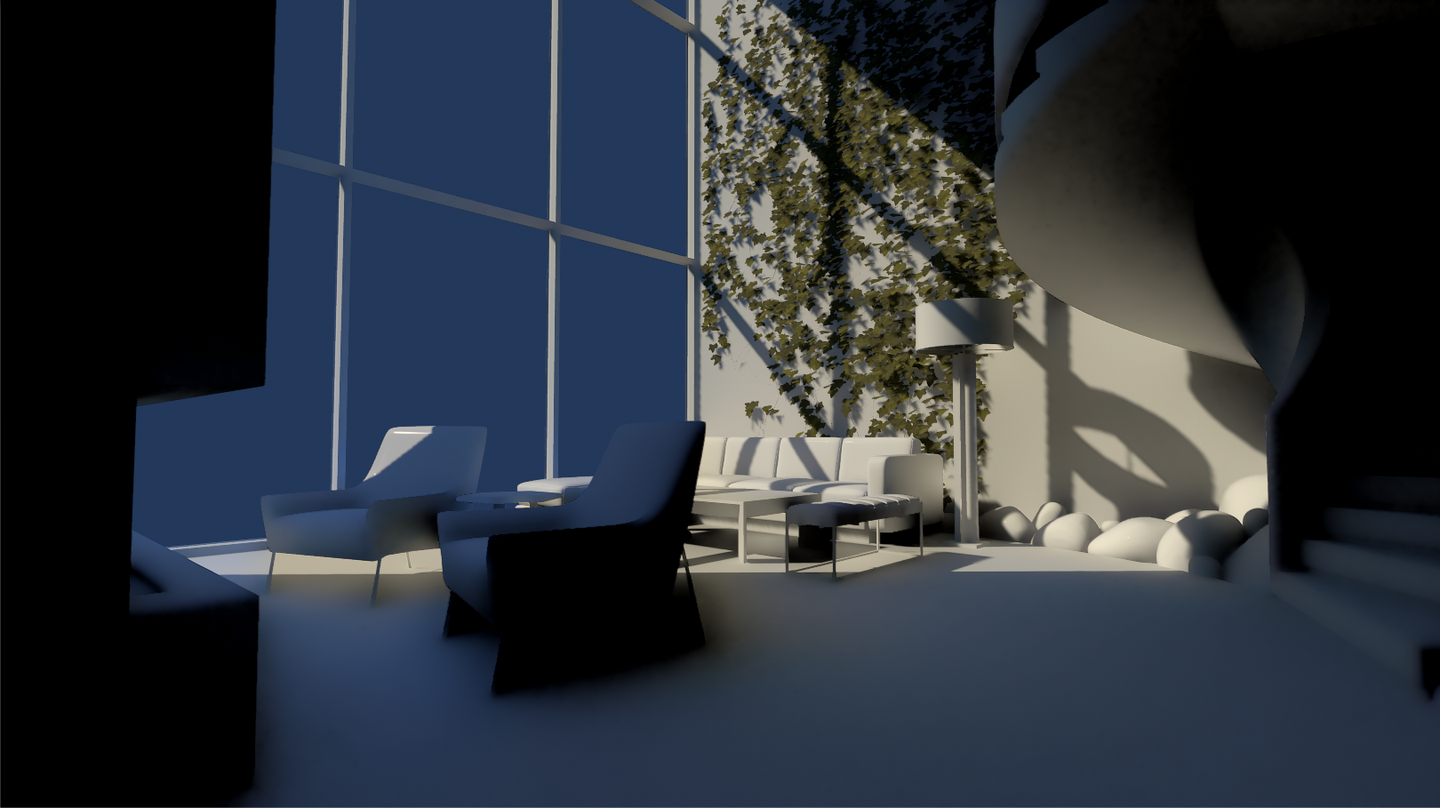
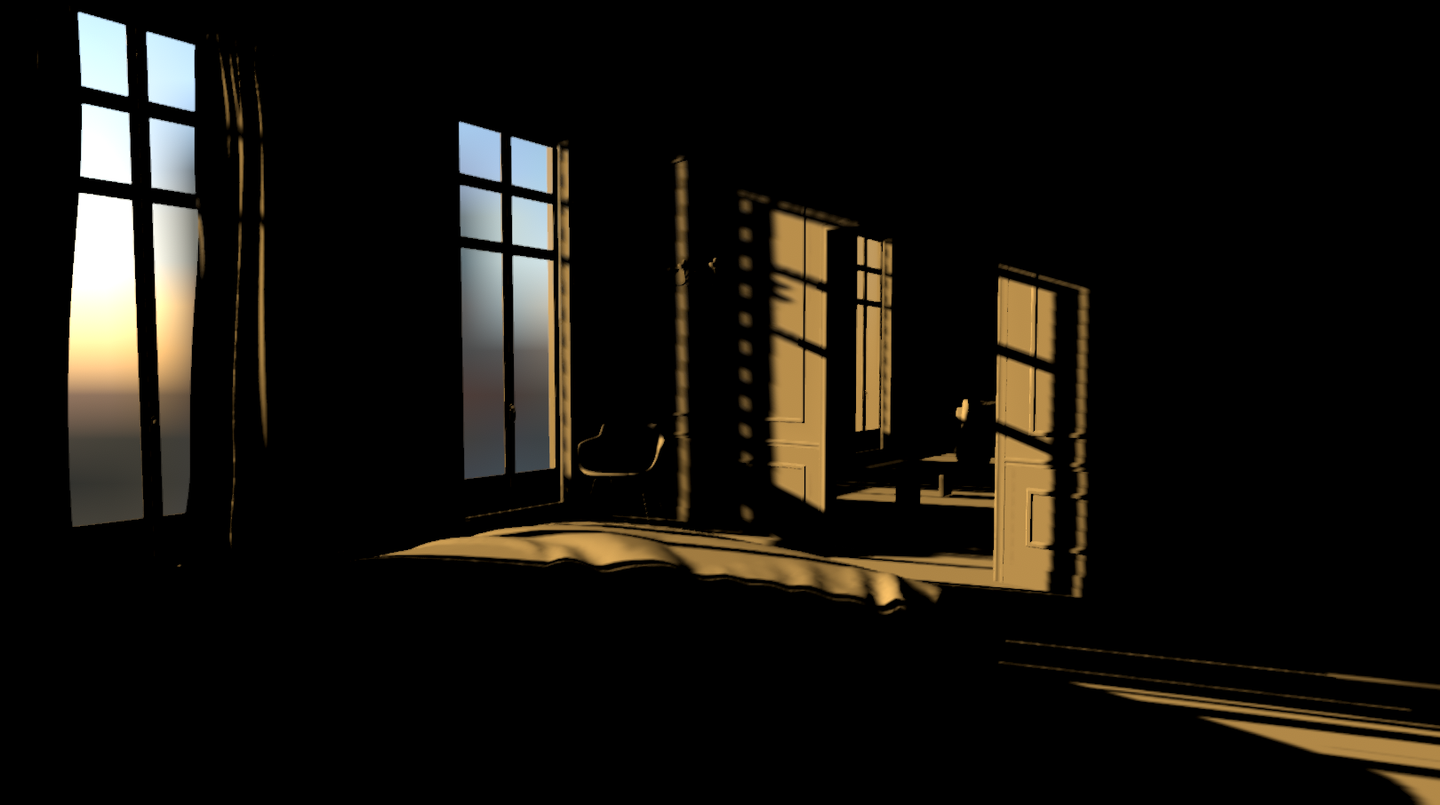
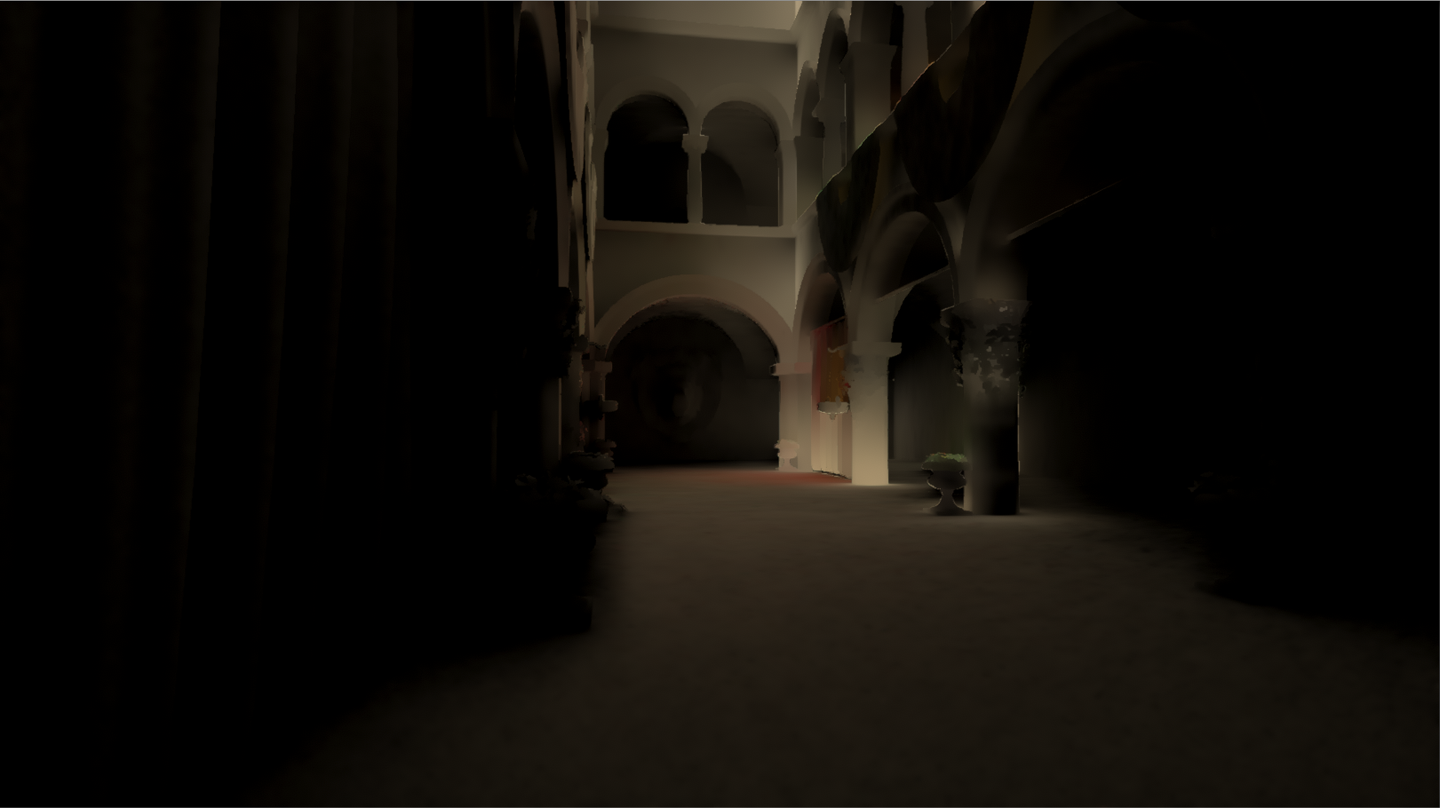
以下为 SSGi 在多个测试场景中的效果。每组包含无 GI(仅直接光照)与有 SSGi 的对比。
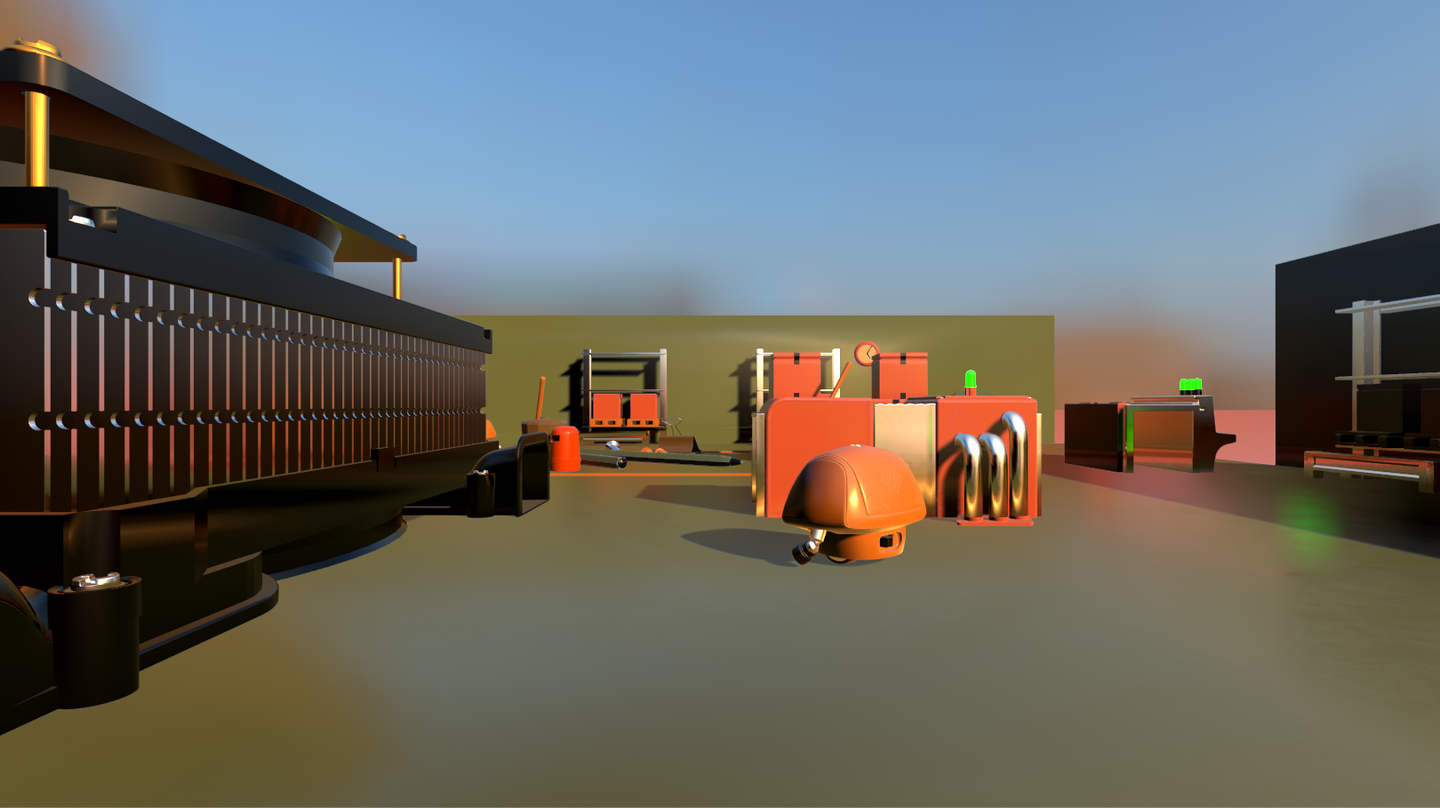
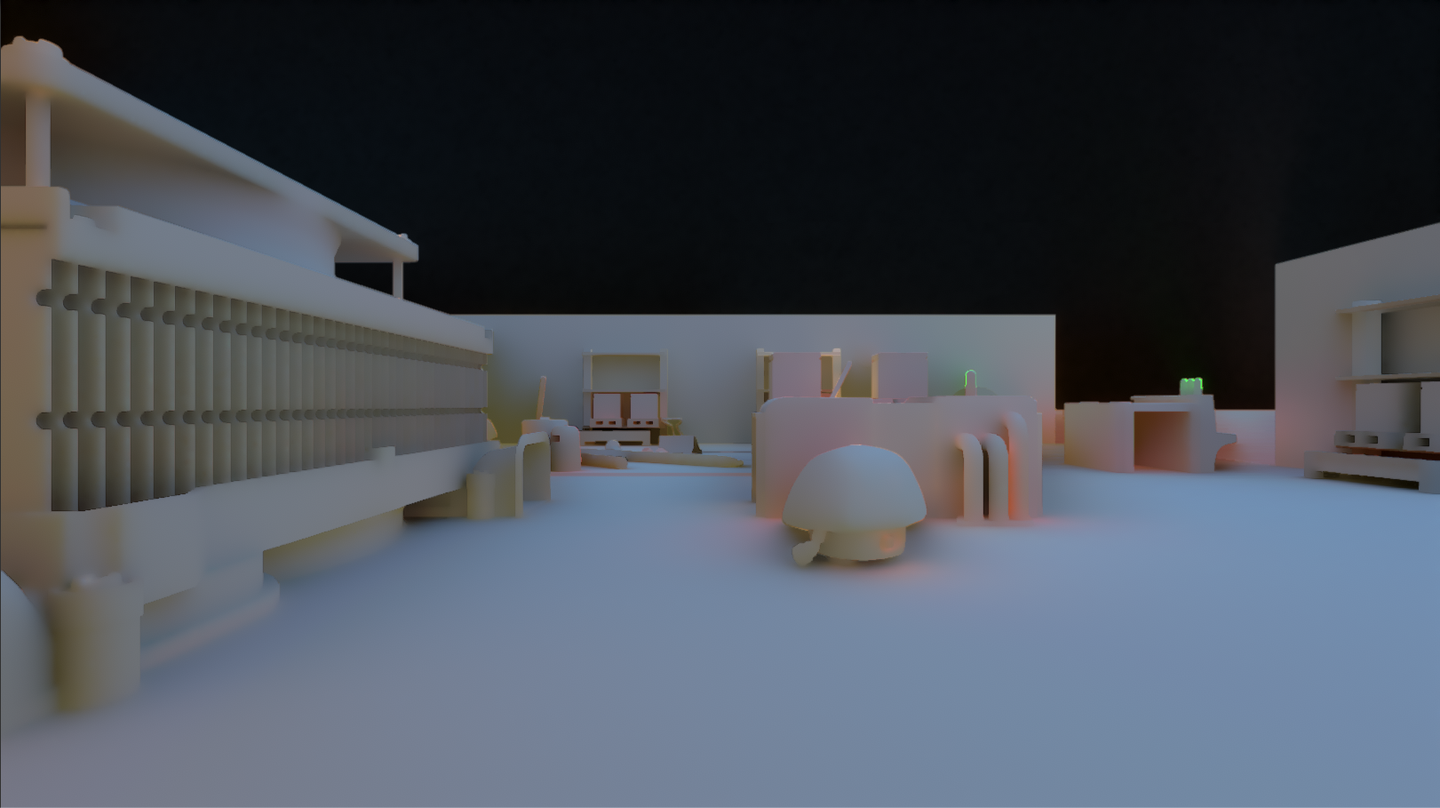
九、后续计划
- 实现 Irradiance Volume 提供低频 GI 基底
- 通过 SSGi Mask 混合两种 GI 结果:
lerp(SSGi, ProbeGi, SSMask) - 探索自适应 SPP:根据场景复杂度和运动速度动态调整每像素采样数
- 评估 Importance Sampling 的改进空间:根据上一帧的 GI 分布引导当前帧的采样方向
- 实现 A-Trous Wavelet Filter 替代当前的 Separable Bilateral,以支持更大的有效 kernel 半径
- 对比 Variance Clipping 与 Min/Max Clipping 在动态场景中的 ghosting 抑制效果
- 评估 Screen-Space Probe 方案(类似 Lumen 的 Screen Probe GI)是否在中端硬件上可行