

Unity Terrain 自带的植被渲染走 TerrainData.treeInstances 和 DetailLayer 两条路径。树的默认行为是每棵树对应一个内部 Renderer,经过引擎标准的 Culling → LOD → DrawRenderers 流程提交。当树的实例数到达数千棵以上,这条路径的 CPU 开销会迅速失控:Transform 更新、Renderer 收集、排序、裁剪、状态汇总全部跟着实例数线性增长。草的 DetailLayer 走另一套 detail patch 机制,密度与视距的关系不透明,远处过渡行为不可编程,popping 的触发条件难以解释。两条路径的 LOD 评估、Culling Distance、Wind 等表现参数都由引擎内部控制,外部几乎没有可编程的控制面。
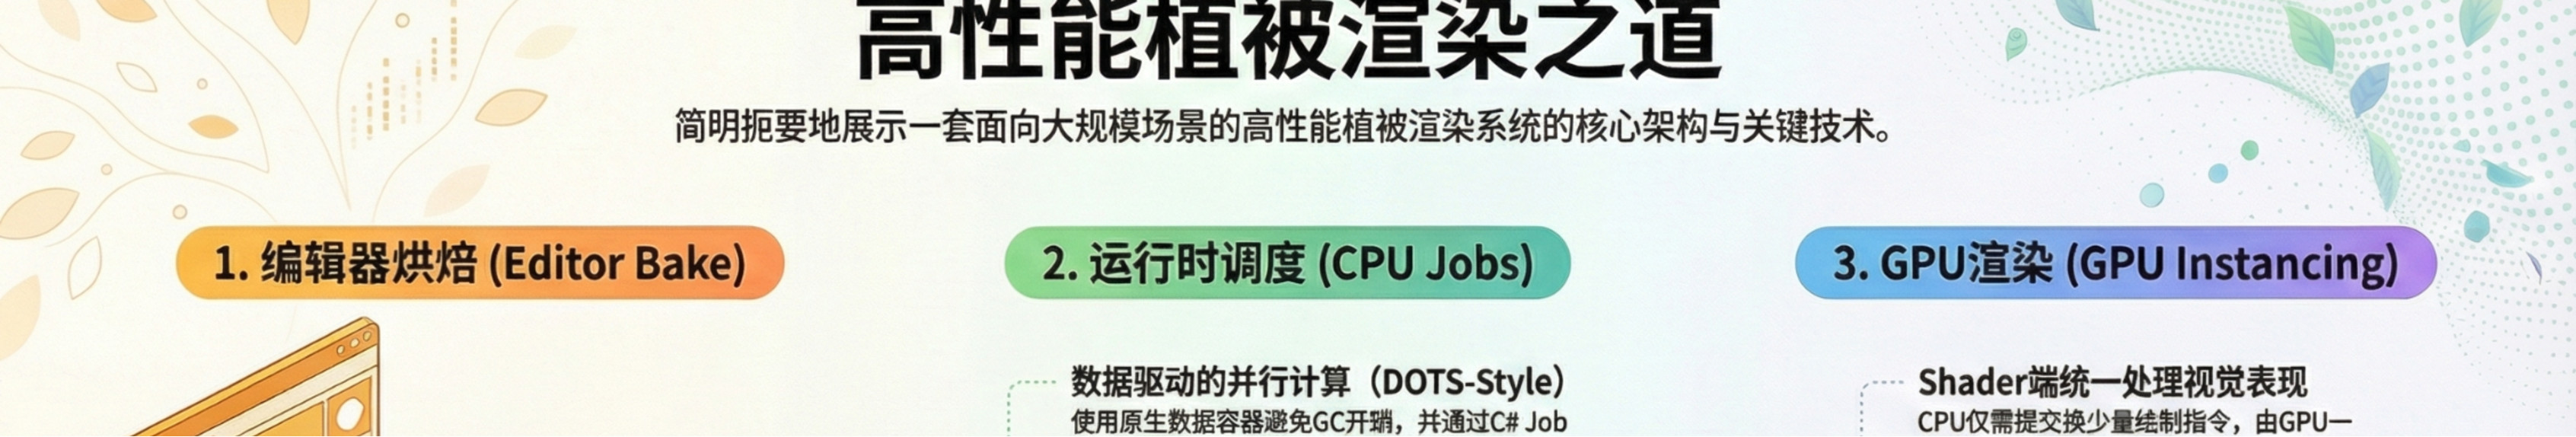
InfinityFoliage 替换了这两条路径。运行时以 GPU Instancing(DrawMeshInstancedProcedural)为绘制核心,CPU 侧用 DOTS 风格的数据组织(NativeArray / NativeList)配合 C# Job System + Burst Compiler 做批量计算。Tree 的 LOD 选取采用 screenRadiusSqr 判据,与 Mesh Drawing Pipeline 的 LOD 体系同源,但绘制提交不经过 Mesh Drawing Pipeline 的 Auto Instance 合批路径:每个 TreePrototype 对应明确的 MeshAsset,实例数量由 buffer 直接承载,无需 PSO+VB Key 的自动合并。系统保持 Render Pipeline Agnostic,不绑定特定管线的接入细节。
一、系统设计与入口
除了 CPU 提交成本外,植被渲染在开放世界尺度下还需要同时满足两组约束:
表现参数需要可控:LOD、Culling Distance、Wind、Color Variation、Transmission、远近过渡的稳定性,都需要可编程控制面,不能被默认渲染路径的黑盒行为绑死。
视觉一致性需要稳定:草需要贴地(高度与法线一致),远处的密度衰减需要可解释的规则,避免明显 popping。
把这些约束收敛为一个可执行的工程目标:在大规模 Terrain 场景中,用可控的 CPU 成本与可预测的 GPU 成本渲染高密度植被,同时保留清晰的扩展边界,允许后续接入更多数据源与更多植被类型。
这直接推导出系统分层与职责划分:
编辑阶段做 Bake:把"昂贵且不需要每帧做"的工作前置。
运行阶段做 Scheduling:把裁剪、过滤、LOD 等计算变成可并行、可向量化的批量计算。
GPU 阶段做 Instancing + Shading:把实例数量从 CPU 的 draw-call 压力迁移到 GPU 的结构化数据读取。
1.1 设计目标
绘制路径以 DrawMeshInstancedProcedural 为主,实例数量增长时 CPU 提交成本保持稳定。
CPU 侧以 NativeArray/NativeList 等 Native 容器承载热数据,尽量避免托管对象与 GC 噪声。
Culling/Filter/LOD 以 Job 形式执行,尽可能走 Burst,把热点循环变成可向量化(SIMD)的批量计算。
数据源以 Terrain 为核心:
Tree:从 TerrainData.treeInstances 派生实例 Transform。
Grass:从 DetailLayer 派生 Density Map,再散射为实例矩阵;贴地与法线融合在 Shader 侧完成。
提供生产可用的更新路径:地形编辑后可以 Update 运行时数据,避免每次完全重建。
风场、渐隐、颜色变化等高频表现逻辑尽量在 Shader 侧统一处理,减少 CPU 参与。
1.2 非目标
不做生态模拟(生长、破坏、季节、交互)。
不绑定任何特定渲染管线的 UI 与配置流程。
不追求黑盒全自动;数据流需要可追踪、可调试、可扩展。
1.3 Authoring / Bake(Editor)
读取 TerrainData,生成可序列化的运行时数据(Runtime Data)。
为裁剪与分块构建 Bounds 数据,降低运行时的空间判定成本。
把草的 DetailLayer 转成可存储的 densityMap: byte[],并预计算 instanceCount 用于预算与预分配。
这里的核心判断标准是:只要某个步骤不需要每帧做,就不允许进入运行时热路径。
1.4 Runtime / Scheduling(C# + Jobs)
运行时以 per-camera 生命周期为主线执行:
Component Culling:先裁掉完全不可见的组件(粗粒度)。
Section/Element Culling:对潜在可见的对象做细粒度裁剪。
LOD Compute:树的 LOD 基于屏幕空间估算,写回到元素数据。
Setup:构建本帧需要的实例数据与分组结果。
Draw Submit:用 CommandBuffer 统一提交 DrawMeshInstancedProcedural。
1.5 GPU / Shading(HLSL)
StructuredBuffer 读取实例矩阵与索引。
Heightmap/Normalmap 采样实现草的贴地与法线融合。
Wind、View Fade、Color Variation、Transmission 共同决定外观与远近过渡。
"可解释的稳定性"是 Shader 侧的第一约束:远处过渡、风摆幅度衰减、密度抖动都由统一规则驱动,避免 CPU 侧的离散更新造成跳变。
1.6 统一入口:FoliageComponent 与 per-camera 生命周期
系统的运行时入口是 FoliageComponent。它定义了一个组件在每个相机上的三段式流程:
InitView(viewOrigin, matrixProj, planes, taskHandles) 初始化与视图相关的任务(裁剪、可见性标记),产出 JobHandle。
DispatchSetup(viewOrigin, matrixProj, taskHandles) 准备实例数据与分组结果,允许渐进式构建。
DispatchDraw(cmd, passIndex) 提交 draw call。
组件实现分为两类:
TreeComponent per-element Culling + LOD + 按 LOD 分组绘制。
GrassComponent 以 Section 为粒度裁剪,按块渐进生成实例矩阵并上传 ComputeBuffer。
渲染接入层只关心 per-camera 生命周期,不需要理解树与草各自的内部数据结构。
二、数据模型:把热数据设计成可并行、可上传的形态
系统的性能边界高度依赖数据布局。数据拆成三类:Prototype、空间分块、实例元素。
2.1 Prototype:FMesh 与 FMeshLODInfo
FMesh 抽象"可实例化的渲染对象"。
Mesh[] meshes:按 LOD 划分的 mesh 列表。
Material[] materials:材质池(去重后的一维数组)。
FMeshLODInfo[] lODInfos:每个 LOD 的 screenSize 与 materialSlot[] 映射。
运行时只需在 LOD 与 SubMesh 两个维度上快速定位 Mesh + Material,避免在热路径上做复杂的资源查找。
MeshAsset 作为可复用的 Prototype 入口:
支持从 Prefab 解析 LODGroup 或 MeshRenderer,收集 Mesh/Material 并生成 FMeshLODInfo。
保持与 Terrain prototype 的兼容,同时为"脱离 Terrain、接入任意散点数据源"预留入口。
2.2 空间分块:FBoundSector 与 FBoundSection
草的裁剪不以单实例为粒度,而以 Section 为粒度,这属于典型的"用更粗粒度换取更低的判定成本"。
FBoundSector:代表一个地形块(通常对应一个 Terrain),持有整体 AABB 与 Section 列表。
FBoundSection:二维网格上的小块,持有 AABB 与 pivotPosition。
运行时对 Section AABB 做 Frustum + Distance 裁剪即可淘汰大量不可见草实例。草的真实实例矩阵可能非常多,但裁剪成本由 Section 数量上限约束。
2.3 Tree 元素:FTreeElement
树按"每棵树一个元素"组织:
matrix_World
boundBox (AABB) 与 boundSphere
meshIndex:当前帧选中的 LOD(由 FTreeComputeLODJob 写回)
这里同时保留 AABB 与 Sphere 是为了拆分职责:AABB 适配视锥裁剪,Sphere 适配屏幕空间 LOD 估算的数值稳定性。
2.4 Grass 元素:FGrassElement
草按"每个实例一个矩阵"组织:
matrix_World:提供 XZ 分布、旋转、缩放。
贴地(Y)与地形法线融合不在 CPU 侧计算,而在 Shader 侧通过 Heightmap/Normalmap 采样完成。这个取舍直接减少了 CPU 侧带宽与更新压力,也减少了"地形高度改变后实例需要重算"的同步负担。
2.5 Native 与 Buffer 的生命周期
数据按阶段拆分,控制内存常驻的边界。
可序列化数据留在 Editor:densityMap: byte[]、树的 transforms: List。
运行时热数据强调复用:FTreeElement (NativeArray)、element buffer(ComputeBuffer)初始化一次后长期复用。
一次性数据允许释放换内存:草的密度数据在生成实例并上传 GPU 后可以释放。该策略的含义是:默认不支持运行时反复重建同一块草实例,除非保留压缩密度或引入重建路径。
生命周期管理的约束是硬性的:
OnEnable/OnDisable 注册与反注册需要与 Dispose/Release 严格对称。
Temp/TempJob 分配在同帧 Complete() 后释放,避免泄漏与同步错误。
2.6 为什么坚持用 Native(DOTS-Friendly Data Layout)
引擎层的关键取舍是把热路径数据从托管集合迁移到 Unity.Collections 的 Native 容器中。
直接收益在三个维度:
托管侧噪声降低:减少 GC、减少装箱与迭代器开销,帧时间更稳定。
并行与向量化空间更明确:连续内存更利于 Burst 生成高效机器码,适用于 Culling、Filter、LOD 等大量重复的数值计算。
与 GPU 的结构化数据模型更接近:当数据天然线性、可批处理,后续迁移到 StructuredBuffer、argument buffer 的路径更短。
这里的 DOTS 主要指 Jobs/Burst/Collections/Mathematics 的能力集合;系统不强依赖 Entities,但数据布局与计算方式保持了兼容思路。
三、运行时管线:从 per-camera 回调到 DrawMeshInstancedProcedural
3.1 渲染接入:可控的 per-camera 生命周期
系统挂到一个稳定的 per-camera 回调点:
从相机的 CullingParameters 提取 6 个 Frustum Planes。
用 CommandBuffer 统一提交绘制,插入 Profiling 采样点。
明确"每个相机一次"的语义,避免多相机场景出现隐性重复与抖动。
回调点在不同渲染框架里可能对应 Custom Pass、Renderer Callback、Render Feature。API 名称不重要,重要的是生命周期可控。
3.2 Per-Camera Frame 的步骤分解
每个相机的一帧按这个顺序执行:
收集启用的 FoliageComponent(组件注册表维护列表)。
一级 Culling:组件整体 AABB 做 Frustum 裁剪,跳过完全不可见的地形块。
二级 Culling:
Grass:对每个 Section 做 Frustum + Distance 裁剪,得到 visibleMap。
Tree:对每个 FTreeElement 做 Frustum + Distance 裁剪,得到可见标记。
Setup:构建或更新本帧需要的实例数据与分组结果。
Draw:CommandBuffer 调用 DrawMeshInstancedProcedural 提交绘制。
裁剪、LOD、分组都放在 draw 之前完成,让 draw 阶段尽量接近"纯提交"。
3.3 并行策略:调度开销与并行度的平衡
Job Scheduling Overhead 与并行度存在实际权衡。不同粒度上选择不同的执行方式与 batch size。
组件级裁剪数量较少时用 Run(),数量上来后使用 Schedule() 并行。
草的 section 裁剪用 IJobParallelFor,batch 典型值为 32。
树的 element 裁剪与 LOD 计算用 IJobParallelFor,batch 典型值为 256。
这些阈值的意义在于把调度开销控制在可接受范围内,同时让 Burst 对热点循环的优化收益覆盖调度成本。
3.4 多相机语义:成本来源需要显式化
系统以"相机"为单位执行整套流程:
同一帧多相机会重复执行 Culling/LOD(反射相机、离屏相机、编辑器视图相机都会触发)。
当前实现倾向只在 Play Mode 提交 foliage draw,避免编辑器视图下的资源分配与状态干扰。
如果需要编辑器预览,需要单独设计资源生命周期与回收策略,而不是直接放开运行时路径。
多相机语义的价值在于可预测:成本与相机数量直接相关,不会以隐性方式扩散。
四、Grass:从 DetailLayer 到 GPU 实例数据
Grass 的难点不是"生成实例",而是把生成与上传控制在预算内,并保持远近过渡稳定。
4.1 数据源与编辑阶段烘焙
Terrain 的 DetailLayer 为每个草原型提供二维密度网格(整数密度)。编辑阶段把它持久化为:
densityMap: byte[]
instanceCount:累计密度,用于预估与预分配
FBoundSector/FBoundSection:裁剪分块的 AABB 与 pivot
烘焙的意义是把托管数组扫描与统计工作搬出运行时,同时把运行时需要的空间结构准备好。
4.2 Section 裁剪:用 visibleMap 控制后续预算
运行时对 Section 做 Frustum + Distance 裁剪,输出 visibleMap。这一层的成本由 Section 数量决定,和草实例总数解耦。
伪代码示意:
草的距离裁剪保留略大于 draw distance 的缓冲(例如 +50%),降低视距边缘的抖动与 popping。这不是视觉装饰,而是为裁剪阈值附近的稳定性提供更可控的过渡区间。
4.3 Scatter:densityMap → 实例矩阵
FGrassScatterJob 把 densityMap 转换为实例矩阵列表。单元格内的实例数由密度决定,实例的 offset/rotation/scale 由 hash 型随机函数生成,避免引入额外状态。
伪代码示意:
随机函数选择 hash 的原因是确定性与成本。给定坐标与 uniqueValue,随机结果稳定,运行时不需要维护随机序列状态。
4.4 渐进式构建:把尖峰拆成预算
Grass 的实例生成与 GPU 上传会形成明显峰值。采用渐进式构建,把:
密度图 → 实例矩阵 → GPU 上传
拆成可平摊的预算。每帧限制处理的 Section 数量(例如一次最多 16 个),进入场景时的成本被拆散到多帧。
这个预算旋钮是生产可用性的一部分:它让"加载/进入新区域"时的帧时间波动变成可控参数,而不是不可解释的尖峰。
4.5 GPU 贴地与法线融合
草的贴地与法线融合放在 Shader 侧完成。实例矩阵只负责 XZ 的分布与变换。
伪代码示意(HLSL 语义):
该设计的效果是:地形高度与法线变化不需要回写 CPU 实例数据,运行时带宽与更新压力更低。
五、Tree:per-element 裁剪、LOD 写回、按 LOD 分组提交
Tree 的关键在于把 per-element 逻辑保持在可并行的数值计算上,把 draw-call 维度收敛为"LOD 组数 × submesh 数"。
5.1 编辑阶段 Transform 提取
编辑阶段从 TerrainData.treeInstances 中按 TreePrototype 筛选实例,写入 FTransform 列表(世界空间 position/rotation/scale)。
5.2 运行时初始化:Transform → FTreeElement
启动时把 FTransform[] 转为 FTreeElement[]:
计算 matrix_World
由 mesh 的 local bound 推导 world AABB
计算 boundSphere,用于屏幕空间 LOD 估算
这些信息在运行时长期复用,避免每帧重复构建。
5.3 Culling:AABB vs 6 planes + Distance
FTreeCullingJob 对每个元素做视锥裁剪与距离裁剪,输出可见标记。
伪代码示意:
5.4 LOD Compute:screenRadiusSqr → meshIndex
FTreeComputeLODJob 计算 screenRadiusSqr 并选择 LOD,写回 meshIndex。这里的关键是把 LOD 选择变成纯数值计算,避免依赖引擎默认的 LOD 评估路径。这套 MeshAsset + screenRadiusSqr 的 LOD 估算框架与 Mesh Drawing Pipeline 的 LOD 体系同源。
伪代码示意:
5.5 按 LOD 分组:IndexBuffer + DrawMeshInstancedProcedural
每个 LOD 对应一个组(SubSector):
把"可见且 LOD = K"的元素索引收集到 NativeList。
上传为 IndexBuffer (ComputeBuffer)。
Shader 在 SV_InstanceID → elementIndex 映射下读取正确的 FTreeElement。
伪代码示意:
Tree 的提交成本由 LOD 组数与 SubMesh 数量约束。实例数量增长会增加 IndexBuffer 的上传带宽,draw-call 数量不会随实例数线性增长。
六、表现系统与编辑器工作流
表现系统的目标不是"效果堆叠",而是用统一规则保证远近稳定性与可调性。
6.1 全局风场:WindComponent + FWindSettings
FWindSettings 把 WindDirection/WindStrength/WindSpeed/Turbulence 写入全局 Shader 参数(例如 g_WindDirection/g_Wind/g_Turbulence)。
WindComponent 支持两种驱动方式:
使用内置预设(Calm/Breeze/StrongBreeze/Storm)
从 WindZone 同步,便于场景统一管理风向与强度
g_SmoothTime 让 gust/turbulence 的时间推进在变速时保持连续,避免跳变。
6.2 Editor Time:非运行时的时间源
为了让风在非 Play Mode 下也能连续推进,编辑器下使用 EditorApplication.timeSinceStartup 推进 UpdateTime()。该设计的目的在于降低调参时的响应误差,不改变运行时路径的核心逻辑。
6.3 View Fade:距离衰减与密度抖动
Grass 在 Shader 侧做两类衰减:
windFade:远处逐渐降低风摆幅度,减少远景噪点感。
scaleFade:远处逐渐把顶点收缩回 pivot,实现渐隐而非突然消失。
阈值附近使用基于位置的 dither 做空间抖动,使远处衰减更均匀。
6.4 Color Variation:PerlinNoise 驱动的空间变化
g_PerlinNoise 全局噪声纹理,通过 PerlinNoise(uv) 产生空间一致的随机量,驱动草地的顶/底色混合与暗部变化,降低大面积草地的贴图重复感。
6.5 Transmission:轻量透光近似
草与叶片的透光采用轻量 Transmission 近似,避免引入复杂的 SSS 依赖,同时保持背光条件下的可解释响应。
6.6 编辑器工作流:构建、保存与烘焙桥接
菜单命令从 Terrain 生成或刷新数据:BuildTerrainTree / UpdateTerrainTree、BuildTerrainGrass / UpdateTerrainGrass。整体策略是 Build 初始化结构,Update 刷新数据。分离的目的是让生产流程具备更明确的操作边界,降低误操作导致的数据不同步。
GrassComponent/TreeComponent 在场景保存前执行 OnSave(),刷新 bounds 等依赖数据。该钩子用于降低"忘记更新导致运行时不一致"的概率。
编辑器烘焙不可避免要处理 TerrainData 返回的托管数组(TreeInstance[]、int[,] 密度图)。当前实现采用务实的桥接方式:把筛选/拷贝/统计封装为 ITask.Execute(),用普通 IJob 在工作线程里执行该 task,通过 GCHandle 持有 task 实例。价值是并行化托管数组扫描,缩短大地形更新等待时间。代价与约束是明确的:该路径不走 Burst;GCHandle 分配与释放需要严格对称,否则存在泄漏风险。
七、结果与边界
7.1 性能边界
CPU 热路径主要由 Jobs 承载,Culling/Filter/LOD 的成本与 Section 数、element 数呈线性关系,成本上限可通过分块粒度与视距参数控制。Grass 实例构建采用渐进式预算,进入新区域时的峰值被拆散到多帧。托管侧噪声降低:热数据在 Native 容器中迭代,减少 GC 与迭代器/虚分派成本。
绘制通过 DrawMeshInstancedProcedural 提交,draw-call 数量主要由 LOD 组数与 SubMesh 数量决定,而不是实例数决定。Tree 按 LOD 分组,Grass 按 Section 分组,实例数增长的压力主要体现在 buffer 带宽与 GPU 读取成本上,CPU 提交维度保持稳定。
贴地、法线融合、风场、渐隐、颜色变化在 Shader 侧统一实现,CPU 侧只负责可见性与实例数据准备。视距边缘通过距离缓冲与 dither 规则控制过渡区间,popping 的触发条件更可解释。
7.2 扩展与兼容
FoliageComponent 把 per-camera 生命周期统一成三段式接口,新类型接入只需要实现同一组流程。MeshAsset 把 prototype 入口从 Terrain 扩展到 Prefab,为后续接入非 Terrain 数据源保留接口形态。
以 TerrainData.treeInstances 与 DetailLayer 为数据源,兼容现有地形制作流程与原型资源。材质与 Shader 只要求支持 GPU Instancing 并能从 StructuredBuffer 读取实例数据,未绑定特定渲染管线 UI。
调参的目标是把瓶颈归因到三个维度:视距与裁剪、分块粒度、构建与上传预算。
7.3 视距与裁剪
Tree Distance / Detail Object Distance:运行时把 Terrain 默认树/草渲染距离置为 0,由系统的 drawDistance 接管,避免双重渲染与不一致。
Grass 距离裁剪保留缓冲区间(例如 +50%),用于降低边缘抖动。
7.4 分块粒度:numSection
numSection 越大:裁剪粒度更细,潜在浪费 draw 更少;Section 数量增加会提高裁剪计算成本。
numSection 越小:裁剪成本下降,可见块更粗,远处可能出现更多无效提交。
该参数直接决定 visibleMap 的长度与裁剪循环的工作量。
7.5 构建与上传预算
Grass 渐进构建的每帧 Section 上限(例如 16)是控制进入场景尖峰的核心旋钮。
Tree 每帧按 LOD 分组写入 IndexBuffer。实例数很大时需要关注 SetData() 的带宽成本与潜在 CPU-GPU 同步风险。
7.6 已知限制
数据更新粒度:当前工作流以地形整体或分块为主。若需要刷子级增量更新,需要更细粒度的 dirty 标记与局部重建策略。
Grass 运行时重建:上传 GPU 后释放密度数据,默认不支持运行时反复重建。若需要动态刷草或破坏效果,需要保留压缩密度或引入重建路径。
多相机成本:以相机为单位执行 Culling/LOD,大量离屏相机需要评估复用与缓存策略。
渲染阶段插入策略:draw API 通用,但如何插入渲染框架的阶段、如何参与阴影/深度,需要项目侧定义策略。