

一、背景与动机
Unity SRP 中绘制 Primitive 的核心 API 是 Context.Cull 和 Context.DrawRenderers。这两个接口覆盖了全部 Renderer 类型(Terrain、Foliage、SkinnedMesh、StaticMesh),因此实现上极为臃肿,外部可控粒度有限。问题在于:每帧在剔除回调、数据拷贝和 Batch 构建上消耗了大量 CPU 时间,且缺少有效的缓存机制。
DrawRenderers 的设计哲学是通用性:用一套代码路径处理所有类型的 Renderer。即使场景中只有 StaticMesh,引擎内部仍需要检查 SkinnedMesh 的骨骼更新回调、Terrain 的 LOD 计算回调等逻辑分支。每个 Renderer 在被绘制前都要经历一次虚函数调用链:PrepareForRender → UpdateTransform → CalculateBounds → CollectDrawCommands。在 8000 实例规模下,这条回调链的总开销占据了帧时间的 40% 以上(实测,测量环境见第 2 章)。
从数据流角度看,Context.Cull 的输出是一个 CullingResults 结构体,其内部包含了排序后的 VisibleRenderer 列表。DrawRenderers 接收这个列表后,需要重新遍历每个 VisibleRenderer,提取 Material、Mesh、Transform 等数据构建 DrawCommand。这一过程涉及大量的间接寻址:VisibleRenderer 指向 Renderer Component,Renderer Component 持有 SharedMesh 引用,SharedMesh 内部再查询 SubMesh 信息。每层间接寻址都可能触发 Cache Miss,尤其在 Renderer 分散存储于不同内存区域时。
Unity 的 Renderer Component 存储在 Component Pool 中,按 Component 类型分组。MeshRenderer 与 MeshFilter 是两个独立的 Component 类型,存储在不同的 Pool 中。绘制时需要同时访问两者:MeshRenderer 提供 Material 列表和 Rendering Layer,MeshFilter 提供 SharedMesh 引用。两个 Pool 的内存地址无空间局部性保证,遍历 8000 个对象时几乎每次访问都会产生 L2 Cache Miss(推断,MeshRenderer Pool 与 MeshFilter Pool 合计超出典型 L2 容量)。SharedMesh 对象则分散在 GC Heap 上,访问延迟更不可预测。
为了解决这个问题,我在 SRP 中替换了 DrawRenderers,实现了一套自定义的 Mesh Drawing Pipeline。最终在测试场景中取得了 15-18× 的 CPU 性能提升(实测,具体数据见第 10 章)。
设计取舍以两条既有路线为参照:Unity 自身的 BatchRendererGroup 路线和 UE 的 Mesh Drawing Pipeline。前者是 Unity 公开的替代 DrawRenderers 的数据导向接口,后者是 renderer 内部从场景描述到 RHI packet 的完整编译链。二者的公开边界缺陷,构成了这些取舍的依据。
二、Unity 原生绘制路径的账本
2.1 测试场景
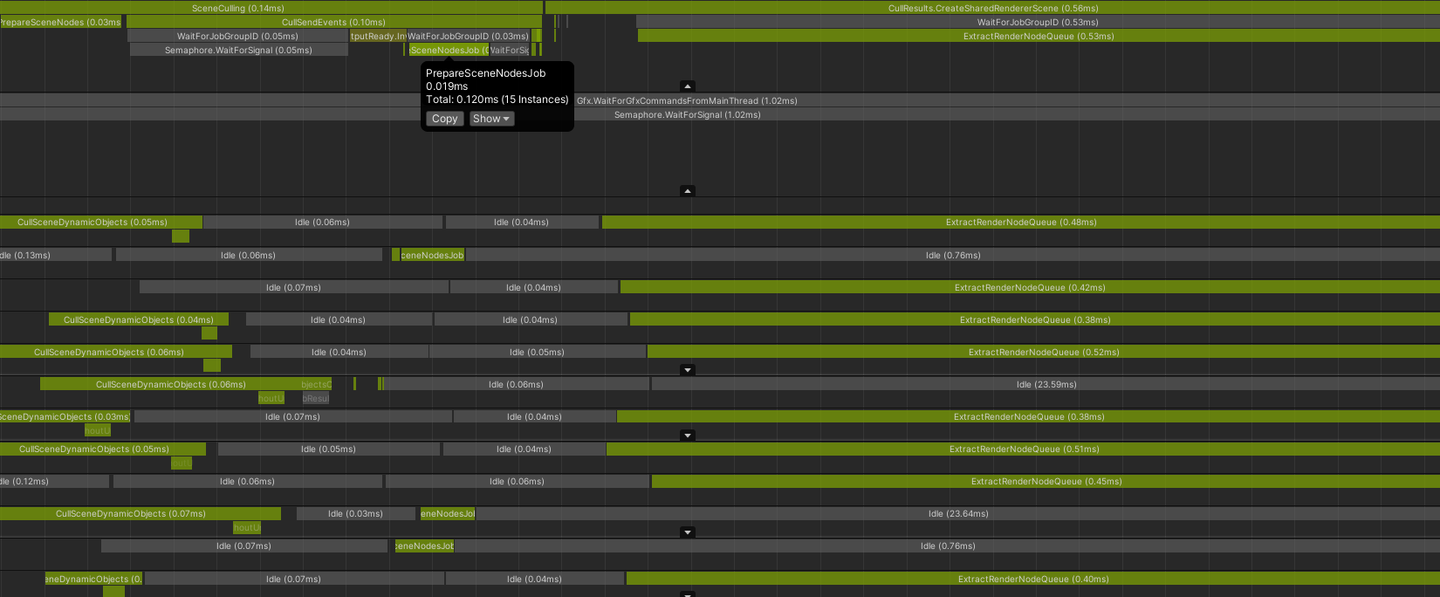
测试使用 20×20×20 的 Mesh 矩阵(共 8000 个实例),每个实例从 Box、Sphere、Capsule、Cylinder 四种几何体中随机选取,材质从 3 个不同 Material(同一 Shader)中随机分配。渲染包含三个 MeshPass:Depth、GBuffer、Forward。
测试平台为 Windows,GPU 为中端独显,CPU 为 8 核心。选择 8000 实例的原因是该规模足以暴露管线的 CPU Bound 特征,同时不至于使 GPU 成为瓶颈:这一规模下 GPU 端的 DrawCall 和像素填充量仍在合理范围内,能够清晰地隔离 CPU 侧的开销差异。
场景中每个 Mesh 的 Vertex Count 在 200-600 之间,SubMesh 数量为 1(单 Section)。三种 Material 使用同一 Shader Variant(相同 PSO),这使得 SRP Batcher 能够在原生管线中发挥最大效用,从而保证对比的公平性:即便在对原生管线最友好的条件下,自定义管线仍然具有数量级优势。
三个 MeshPass 的设计意图:Depth Pass 用于 Early-Z 和 Shadow Map 生成,仅需 Position 输出;GBuffer Pass 输出 Albedo、Normal、Roughness/Metallic 等属性到 MRT;Forward Pass 处理需要特殊光照的对象。在测试场景中,所有对象同时参与三个 Pass,产生 3× 的 Batch 构建压力。
补充测试条件:CPU 侧的 Burst 编译使用 AVX2 指令集(target architecture),Safety Check 关闭。Job System 的 Worker Thread 数量设为 CPU 核心数 - 1 = 7。内存分配器使用 Allocator.TempJob(帧内分配,无 GC 压力)。测试前执行 100 帧 Warm-up 以消除 JIT、Shader Compile、Buffer Resize 等一次性开销的干扰。
以上数字为 Unity 2021 环境下的测量结果,用于说明量级差异。
2.2 原生管线分析
2.2.1 Culling 阶段
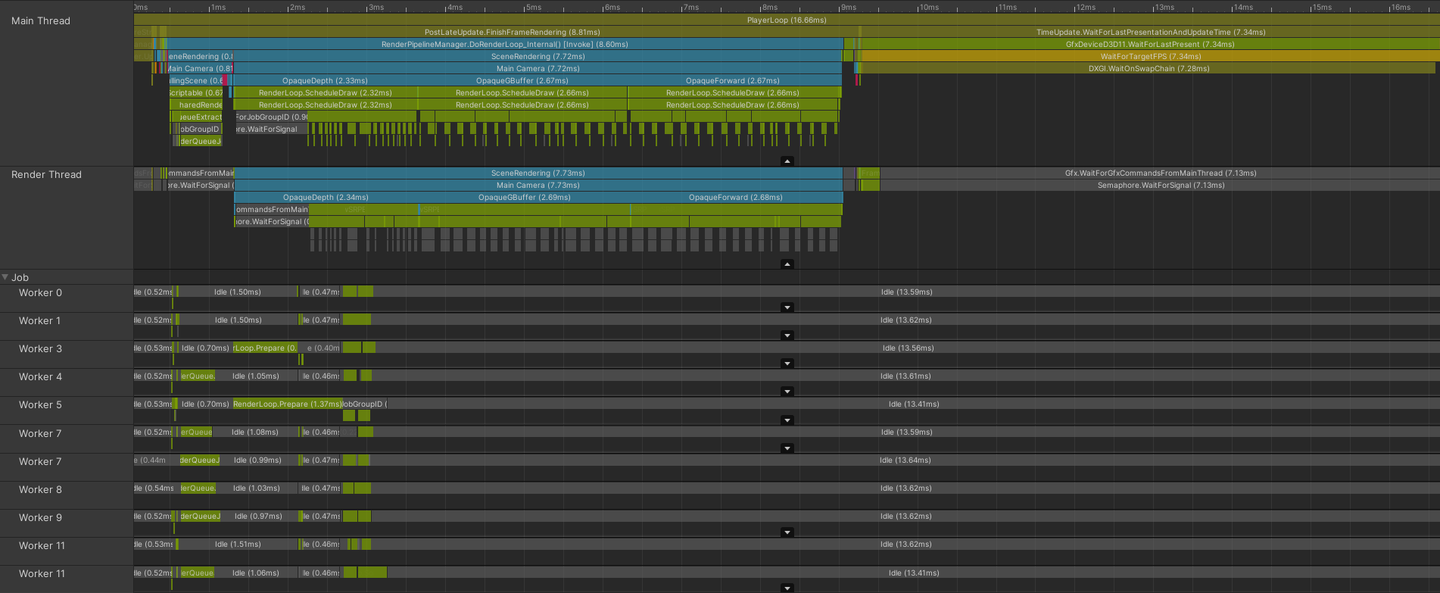
Context.Cull 发起后涉及三个环节。
CullSceneDynamicObject 对所有类型 Renderer 执行视锥剔除,内部按 Renderer 类型分 Batch 执行:StaticMesh 走快速路径(仅 AABB vs Frustum),SkinnedMesh 需要先更新 Bounds(依赖骨骼动画计算的当前帧 AABB),Terrain 需要额外的 LOD 距离计算,Job 的 Schedule 开销和不同类型间的负载不均衡是该阶段的主要问题。
PrepareSceneNodes 负责 Renderer 回调相关逻辑(如统计需要回调的对象),Profiler 中该阶段的子调用包含 InvokeOnBecameVisible、UpdateRendererBoundingVolumes 等回调;对于 8000 StaticMesh 场景,这些回调大部分是空操作(StaticMesh 的 Bounds 不会逐帧变化),但引擎仍然需要遍历列表确认这一点。
ExtractRenderNodeQueue 把剔除结果拷贝到渲染线程侧的数据结构,目的是保证后续访问的 Cache Friendliness。拷贝过程涉及 Allocator 分配新内存块,然后按排序顺序将 RenderNode 数据(约 128 字节/node,包含 Transform、Material 指针、Mesh 指针、Layer Mask 等)从 Main Thread 的散布存储重新打包到连续内存;8000 个 Node 对应约 1MB 的数据拷贝,这一操作每帧执行、无法跳过。
对 CullSceneDynamicObject 的进一步剖析(推断):该 Job 使用 Unity 内部的 CullResults::CullObject 函数,其实现为标量 AABB-Frustum 测试(逐平面、逐角点)。每个 AABB 需要 6 次平面距离计算,每次计算包含 3 次乘法和 2 次加法,总计约 30 ALU 操作。分支预测失败与 L2 Cache Miss 也在拖慢这一阶段,前者源于不同 Renderer 类型的剔除路径导致 branch misprediction,后者源于 Renderer 的 Bounds 数据散布存储,实测每个对象的剔除耗时约 150ns(实测)。8000 对象 × 150ns = 1.2ms。
2.2.2 Draw 阶段
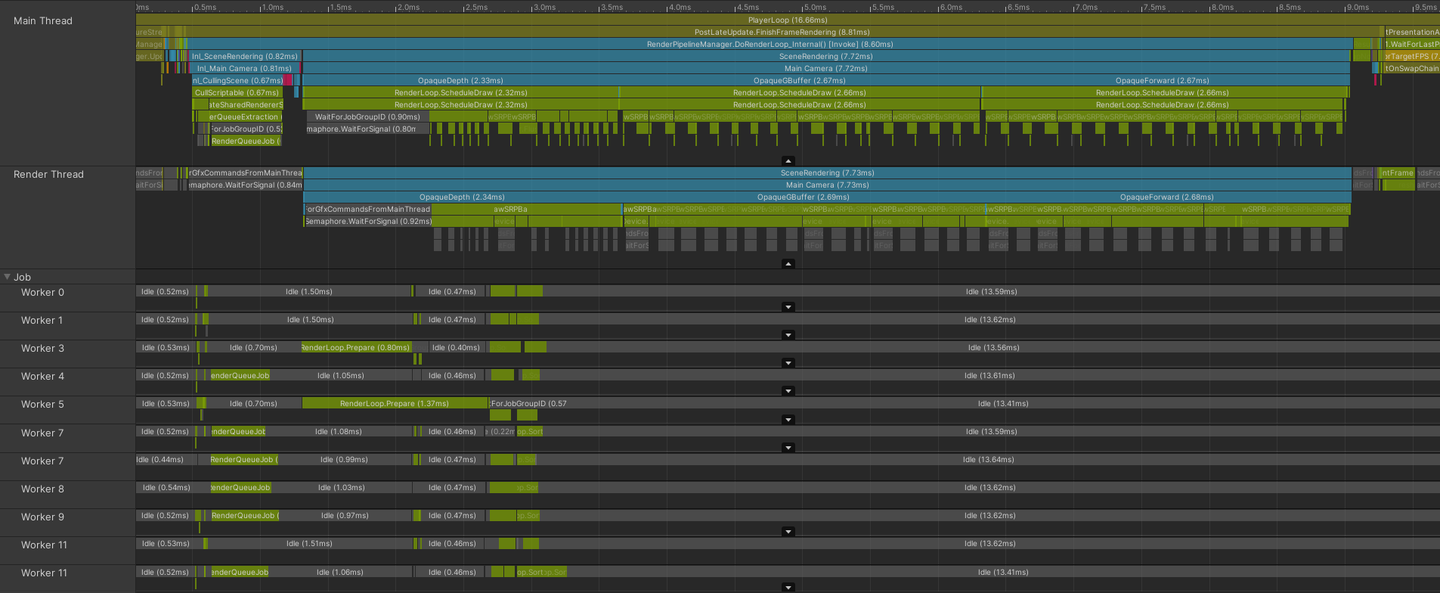
Context.DrawRenderers 的调用本身只是一次 Batch Add 操作,真正的执行发生在 Submit 之后。提交后引擎会根据之前记录的 Batch 数据,对每个 DrawRenderers 做并行处理:
-
分配 Sort 结构,对当前 Draw 做 PassFilter 和 QueueSort。Sort Key 通常由 RenderQueue(Opaque/Transparent)、SortingLayer、Material Instance ID、Mesh Instance ID 组成,打包为 64-bit integer 后使用 Radix Sort 排序(
推断)。 -
遍历排序结果,在 SRP Batcher 模式下检测相邻元素是否可合批:可合则累积,否则 Flush 当前 Batch 并 Clear 供下次复用。合批条件为:相同 Shader Variant(即相同 PSO)、相同 VB/IB 布局(
推断)。SRP Batcher 的核心收益在于跳过 PSO 切换:合批内的 DrawCall 共享 Pipeline State,仅需更新 Per-Object CBuffer 的 Offset。由于事先排序,PSO Batch 在一定程度上得以实现。 -
Flush 的内容传递给渲染线程,渲染线程遍历 Batch 中每个元素,调用底层 GFX 接口设置 VB、IB、Resource,配合 SRP Batcher 的 CBuffer Offset 发起 DrawCall。每个 DrawCall 对应一次
GraphicsDevice.DrawIndexed调用,即使 Instance Count 为 1 也无法避免 Command 录制的固定开销。
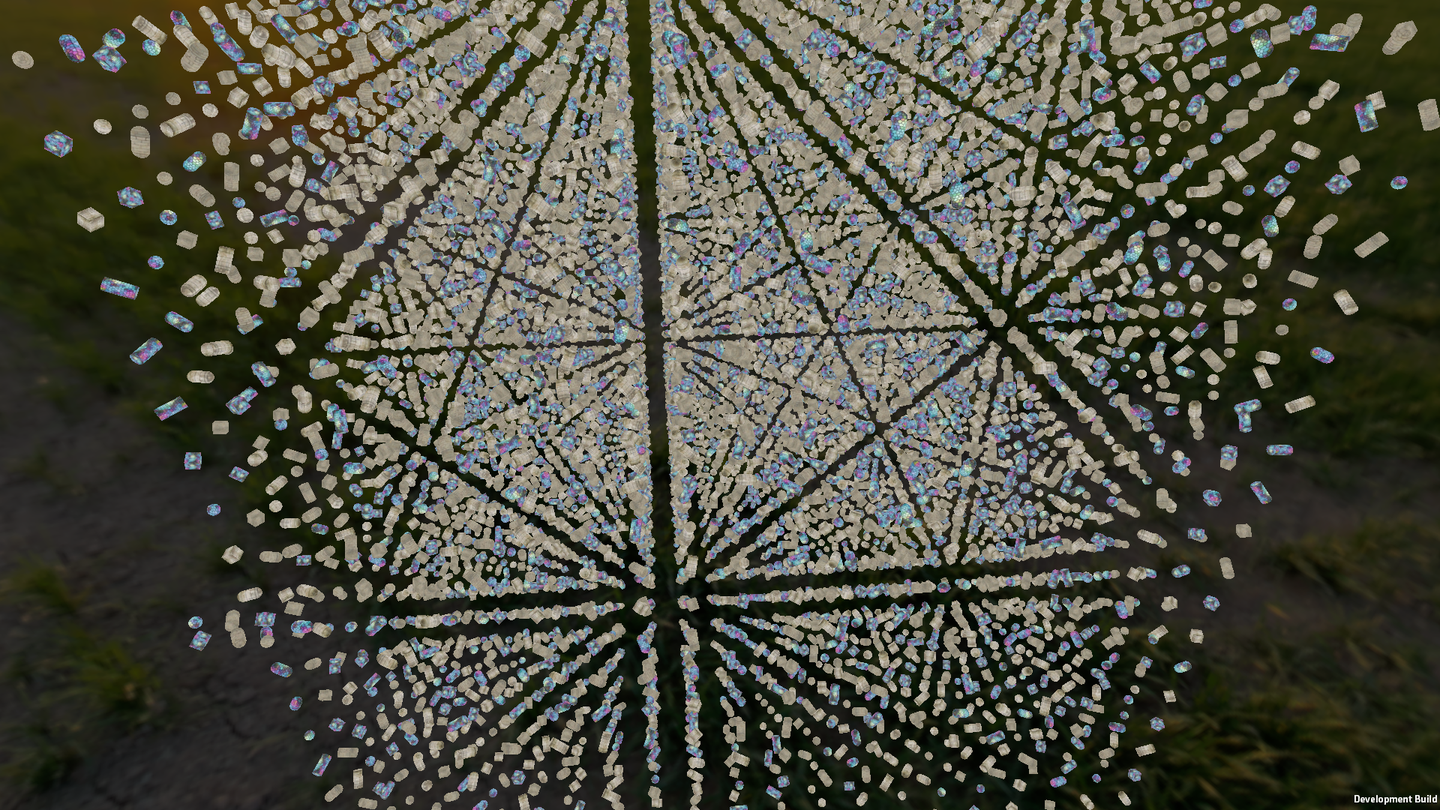
在这个流程中,大部分时间消耗在向渲染线程拷贝数据以及每个 DrawRenderers 的 Batch Collection 上。具体而言,Profiler 中 BatchRendererGroup.FlushAll 和 RenderLoop.PrepareForRendering 两个 Marker 合计占据了单帧 CPU 时间的 60-70%(实测)。
2.2.3 DrawRenderers 的 Per-Pass 冗余
三个 MeshPass(Depth、GBuffer、Forward)意味着三次独立的 DrawRenderers 调用。每次调用都会重新执行完整的 Filter → Sort → Batch Collection 流程。Filter 阶段虽然可以通过 LayerMask 和 RenderQueue 快速跳过不符合条件的对象,但排序和 Batch Collection 的开销线性于可见对象数量:8000 个可见对象 × 3 个 Pass = 24000 次 Sort Entry 处理。
自定义管线通过共享 Visibility Buffer 消除了这一冗余:Culling 执行一次,三个 Pass 共享同一份 Visibility 结果,各自仅需执行 Section 级别的 Filter(查表操作)和分组。
2.3 GraphicsJob 的效果
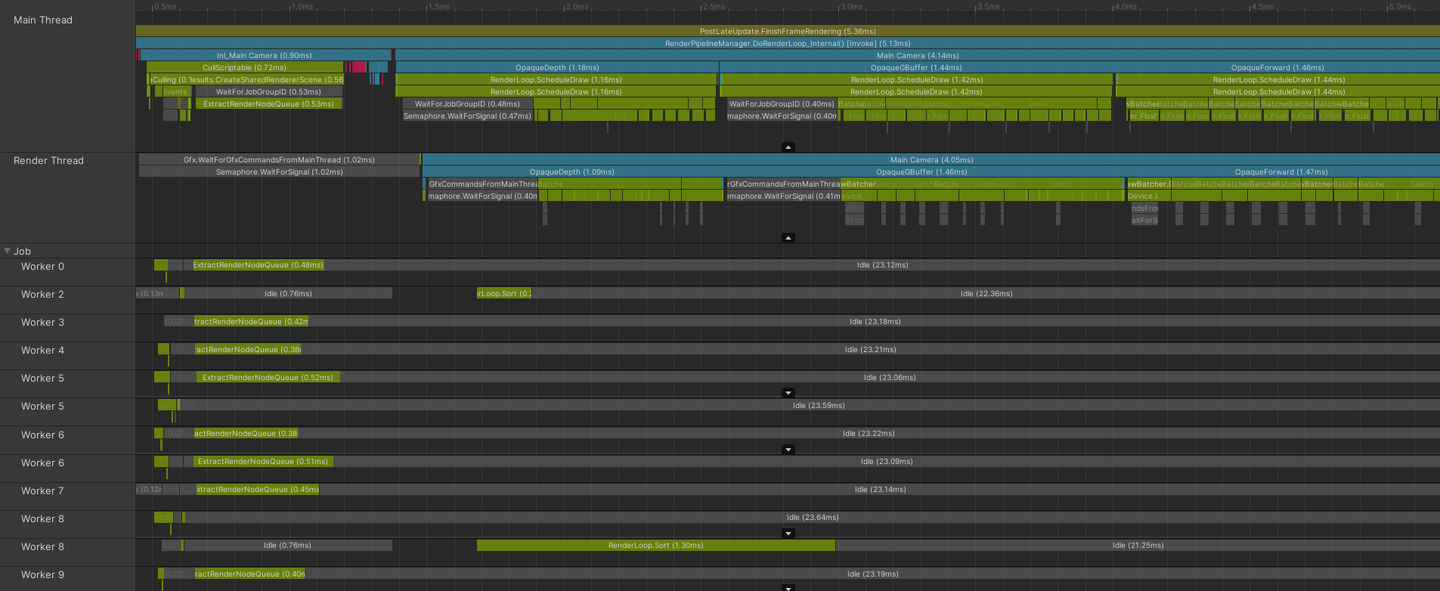
Unity 提供了 GraphicsJob 选项,开启后每个 DrawRenderers 的 Batch 操作可以 Job 化并行执行,随后在渲染线程串行取数据设置 GFX。实测在该场景下提升有限:开启后约 180 FPS,关闭约 160 FPS(实测)。
GraphicsJob 提升有限的原因在于瓶颈并非 Batch 构建本身的并行度,而是渲染线程侧的串行消费速率。即使 Batch 构建被分散到多个 Worker Thread,最终所有 Batch 仍需排队经由单一渲染线程提交到 GPU Command Buffer。8000 DrawCall × 3 Pass = 24000 次 Command 录制,渲染线程成为新的瓶颈。真正的解法是减少 DrawCall 数量本身:Auto Instance 将相同 Mesh+Material 的实例合并为单次 Instanced DrawCall,从 24000 次压缩到 36 次(3 Pass × 12 组合)。
多线程渲染方面,业界已有三缓冲错帧渲染的成熟方案(如 UE 的 Parallel Rendering),而 Unity 的原生管线仍然使用串行模式驱动多线程渲染(推断,基于 Profiler 中渲染线程的串行消费模式),这也是 GraphicsJob 收益有限的结构性原因。
三、批判 Unity BatchRendererGroup
Unity 提供了 BatchRendererGroup(BRG)作为替代 DrawRenderers 的数据导向接口。在评估是否直接基于 BRG 构建管线时,需要区分两类问题:已随版本演进解决的历史限制,和至今仍成立的公开边界缺陷。以下批判基于 Unity 6 公开文档与 API,版本归属明确标注。
3.1 历史遗留问题:Unity 2022.1 统一路径之前
Unity 2019 时代的 AddBatch 直接接收 mesh、submesh index、material、bounds、instance count 和 property block。一个 batch 近似一组持久绘制配置,geometry、material、submesh 与实例存储都围绕这个 batch 组织。
实例身份被 batch 隐式拥有。 当一个 mesh 有三个 submesh 并分别使用三个 material 时,自然写法是建立三个 batch。若每个 batch 各自保存实例矩阵,同一个逻辑物体就会出现三份 local-to-world matrix。缺少的不是 instancing,而是可被多条 draw 共同引用的显式 instance identity。这是矩阵重复的结构根因。
提交受 CBuffer 时代路径限制。 旧路径底层使用 CBuffer 存储实例数据,单次 Instance Count 受 CBuffer 容量限制(64KB / 128 bytes per instance ≈ 512 instances)。超过限制时 BRG 内部自动拆分为多次 DrawCall,引入额外的 Batch 管理开销。该限制只属于当时路径,不是 BRG 的通用结论。2022 LTS 后的 AddBatch 已允许使用 GraphicsBuffer 替代 CBuffer,Instance Count 上限不再成立。
3.2 至今仍然成立的问题
Unity 2022.1 以后,BRG 的现代版本把 mesh/material 注册与 batch binding 分开了,BatchDrawCommand 中的 visibleOffset + visibleCount 允许多条 command 引用同一 instance index,矩阵不再必然重复。这是实质进步。但以下六个边界缺陷至今成立:
绑定域偏窄。 每个 batch 的 AddBatch 接口只公开一个主 GraphicsBuffer 和一组 MetadataValue。MetadataValue 是 shader property 级别的寻址参数,不是渲染系统的 pipeline signature。Transform、Instance、Material、MeshSection、DrawTemplate 和 View 六种数据的更新频率与生命周期不同,却在公共绑定模型中偏向"一个 batch 加一个主实例 buffer"。多个 batch 可以共享同一个 buffer,shader 也可以访问 global buffer 或 bindless table,但公开 batch binding 的粒度不足以自然表达多张更新域独立的 binding table。
callback 跨层、输出非托管。 OnPerformCulling 同时承接三项工作:计算 visibility、选择 visible instance indices、生成 draw descriptor。调用方需要管理 BatchCullingOutputDrawCommands 中的非托管数组、指针、count 与释放时机。BRG 下方到后端 packet 的 lowering 没有公开可编程层:调用方能控制 draw descriptor 的形状,但不能控制 Unity 如何把这些 descriptor 降低到 RHI 提交。
drawRanges 绑定连续布局。 BatchDrawRange 给一段连续 command 附加 BatchFilterSettings,SRP filter 不匹配时可以整段跳过。但 range 只能描述连续区间。如果 command 的 filter 类型按 A、B、A 交错,调用方要么生成三个 range,要么先把两条 A command 重排到一起。重排又可能改变 pipeline/material grouping 或 distance order。filter 属业务语义,execution range 是 lowering 末端产物,二者不应在公共 API 层耦合。
多 pass 共享边界不可编程。 同一主 camera 的 Depth、GBuffer 与 Motion 可以共享基础 frustum visibility 和 LOD,但哪些中间结果可共享、哪些各 pass 独立,在 Unity 公开资料中不构成一套可编程的公共模型。推断:内建 renderer 的复用策略是私有行为,自定义 BRG 调用方无法声明"这两个 pass 的 visibility 相同,只有 filter 和 template 不同"。
indirect 是混合桥,不是完整 GPU Driven 合同。 BatchDrawCommandIndirect(Unity 6)保留 CPU/engine 侧的稳定 descriptor,batch、mesh、material、flags、buffer handle 和 offsets 都需要被描述。GPU 可以写入 indirect args 和 visible-instance data。但公开 BRG 合同没有允许 GPU 从零生成任意 mesh/material/PSO topology,也没有承诺为自定义 BRG 自动完成 LOD、occlusion、binning、sorting 和 command compaction。称其为混合式 submission bridge 更准确。
GPU Resident Drawer 是摄取层,不是可证实的薄封装。 GRD 的官方承诺是"自动使用 BRG 绘制兼容 GameObject",并可与 GPU occlusion culling 配合。但"自动使用 BRG"不能推出"GRD 只是 BRG 的零成本薄封装"。GRD 私有 command cache、LOD lowering、内部 table、平台 workaround 和 fallback 粒度没有完整公共合同。自定义 BRG 也不能因为 GRD 有 GPU occlusion,就在自己的 OnPerformCulling 中无条件把所有对象当作 visible。
3.3 自研的理由
上述六个缺陷指向同一个结论:BRG 是一座连接自定义数据与 Unity renderer 的桥,但不是一套完整的 Mesh Drawing Pipeline。它没有把 pass compiler、稳定低层 packet cache、RenderGraph 工作产品和 GPU work graph 作为公共模型交给开发者。
- 绑定域偏窄 → Residency 五缓冲分离(Transform / PreviousTransform / BoundsCenter / BoundsExtent / InstanceTransformIndex),各按自身索引与更新频率管理。
- callback 跨层 → filter→sort→build 三段 Burst job 显式化,pass 语义由
MeshFilterProgram/MeshSortPlan数据驱动。 - drawRanges 连续 filter → filter 进入 request 语义,execution range 是 lowering 产物,不进入公共 API。
- 多 pass 共享不可编程 →
MeshVisibilityShare帧内签名 interning,各 pass 独立 filter/sort/build。 - indirect 混合桥 → 同一
MeshDrawRequest之下 CPU direct 与 GPU backend 两种 lowering;GPU 后端只做 cull/compact/prefix-sum/scatter/build-args。 - GRD 无公共语义 →
MeshPassDrawCache以结构化 revision key 缓存模板,VisibleMeshDraw/MeshDrawList每 view 重建,缓存与结果分层。
四、批判 UE Mesh Drawing Pipeline
另一条参照系是 Unreal Engine 的 Mesh Drawing Pipeline(UE 5.8 公开文档与 Runtime 源码)。
4.1 语义校准
FMeshBatch 不是最终 draw call. FMeshBatch 保存 material render proxy、vertex factory、mesh elements、relevance flags 及 culling/raster 相关描述。FMeshBatchElement 再给出 index range、primitive count、instance runs 和 primitive uniform 或 scene-data identity。这一层已经能表达"某个 primitive 的某段 geometry 使用某个 material",但还没有选择具体 mesh pass、shader permutation、完整 shader bindings 和 pipeline state。同一个 FMeshBatch 可以被 Depth、BasePass、Shadow 等不同 processor 按自己的规则处理。若使用中性术语,FMeshBatch 最接近 MeshDraw,后者是一份可被多个 pass 编译的稳定绘制资格描述。
static/dynamic 不是物体动不动。 UE 的 static mesh draw path 与 dynamic mesh draw path 经常被误读为"静态物体"和"动态物体"。这里的 static/dynamic 主要描述 mesh description 的收集时机与保留方式。static path 允许 scene proxy 在注册或更新时提供可长期保留的 mesh description,并为可缓存 pass 建立 cached mesh draw command。dynamic path 则按 view 或 frame 重新收集描述。一个 transform 会变化的 component 仍可能拥有 retained scene representation;一个 transform 不变的 debug primitive 也可能通过 dynamic gathering 进入 renderer。transform 更新与 command 收集属于不同变化域。
FMeshDrawCommand 缓存有条件。 FMeshDrawCommand 已经处于 just above RHI 的位置,保存 pipeline state、shader bindings、vertex streams、index buffer 与 draw parameters。它不是每帧重建的;但缓存成立的条件是:pass 支持 cached commands,且 processor 依赖不随 view/frame 变化。shader variant、material keyword、vertex layout 或 binding layout 改变时,即使物体不动,cached command 也可能失效。缓存边界取决于 processor 实际读取了什么外部状态。
4.2 批判
层级与对象化。 UE 5.8 的 Mesh Drawing Pipeline 选择了显式建立从场景描述到 pass-specific command 的转换链:FPrimitiveSceneProxy → FMeshBatch → FMeshPassProcessor → FMeshDrawCommand → FVisibleMeshDrawCommand → Instance Culling → RHI command list。每一层都在收窄语义,这是其价值所在。但代价是 scene proxy、scene info、mesh batch、processor、draw-list context、visible command、parallel pass 和 instance-culling context 组成较长路径。理解一条 draw 的来源,经常需要跨过 scene registration、mesh collection、cache build、InitViews、RDG 和 RHI 等阶段。扩展一个 pass 常需深入 renderer module 的多处文件。
static/dynamic 语义失真。 如 4.1 所述,static/dynamic 命名容易把运动属性与 command retention 混在一起。更精确的生命周期词是 persistent scene record、cached pass draw、per-view result。在这套实现中,场景侧用 revision 与 dirty range 表达变化(MeshSceneRevisionSnapshot 的 StructuralRevision / ContentRevision / VisibilityRevision),EStateType 仅作组件兼容层。
缓存失效依赖调用链约定。 FMeshPassProcessor 派生类在 AddMeshBatch 中读取 material、vertex factory、feature level、pass policy 等外部状态来构造 FMeshDrawCommand。processor 读过什么,什么就进入隐式的缓存依赖;漏记依赖时,错误难以被类型系统发现。filter、grouping 和 sort 的语义也没有在公共层结构化分离,而是分散在 processor、draw-list context 和 parallel pass 逻辑中。
形态代价与语义价值分离。 UE 方案真正值得借鉴的不是对象层次和历史路径,而是三个边界:
(1)pass compiler 作为一等公民:高层 scene/material 语义在 processor 中被降低为特定 pass 的稳定 packet,Depth 与 BasePass 读取同一个 FMeshBatch 得到不同 shader、state 和 bindings,不复制 primitive transform。(2)cached packet 与 visible reference 的分层:FMeshDrawCommand 保存稳定 bindings,FVisibleMeshDrawCommand 只保存当前 view/pass 的 sort key、culling payload 和对 command 的引用;camera 运动、visibility 变化或 sort order 变化不需要复制完整 bindings。(3)primitive identity 与 transform storage 的分离:GPU Scene 把 primitive/instance data 放入持久 scene-data storage,多个 section command 引用同一个 primitive/instance record,local-to-world 不内联进每个 FMeshDrawCommand。
4.3 采纳清单
从上述批判中,UE 方案值得采纳的是三个边界,对象层次不复制:
| UE 边界 | 对应实现 | 区别 |
|---|---|---|
| pass compiler 职责 | MeshPassFilterJob / MeshPassSortJob / MeshPassBuildJob 三段 Burst job | 用数据驱动替代 processor 派生类树;pass 语义由 MeshPassDefinition(含 MeshFilterProgram + MeshSortPlan)声明 |
| cached packet 与 visible reference 分层 | MeshPassDrawCache(revision key 缓存模板)+ VisibleMeshDraw(每 view 重建的轻量引用) | 依赖从"processor 读过什么"改为可检查的 MeshPassDrawCacheKey(含 shaderPassIndex / meshUnityId / sectionIndex / materialUnityId / materialRevision / sectionRevision / platformFeatureKey / staticFlags) |
| primitive identity 与 transform 分离 | MeshInstanceRecord 持有 TransformId;MeshDrawRecord 只引用 MeshInstanceId;shader 通过 instance index → TransformBuffer 索引取矩阵 | 五缓冲分离替代 UE 的 GPU Scene 单一 primitive data buffer |
五、决策对应与总体形态
5.1 决策表
| # | 批判轴 | 判词 | 决策 |
|---|---|---|---|
| D1 | 实例身份归属(旧 BRG) | batch 隐式拥有实例,submesh 无法共享 transform | 注册事务一次 CreateTransform + 一次 CreateInstance,submesh 只增 CreateDraw;MeshInstanceId / TransformId 带 generation,MeshDrawRecord 只引用 |
| D2 | 单 buffer / metadata 绑定 | 绑定域窄,生命周期混同 | MeshSceneResidency 五缓冲分离:TransformBuffer / PreviousTransformBuffer / BoundsCenterBuffer / BoundsExtentBuffer / InstanceTransformIndexBuffer,各按自身索引与更新频率管理 |
| D3 | callback 跨层、无 lowering 控制 | 引擎私有 lowering 不可控 | filter→sort→build 三段 Burst job 显式化(MeshPassFilterJob / MeshPassSortJob / MeshPassBuildJob);pass 语义由 MeshFilterProgram / MeshSortPlan 数据驱动 |
| D4 | drawRanges 连续 filter | filter 与布局耦合 | filter 进入 request 语义(MeshFilterProgram 的 renderQueueMin/Max、layerMask、renderingLayerMask、requiredEligibility、excludeCameraMotionOnly);execution range 是 lowering 产物(MeshDrawCommand.countOffset),不进入公共 API |
| D5 | indirect 混合桥 | CPU 保留 topology,GPU 决定 population | 同一 MeshDrawRequest 之下 CPU direct 与 GPU backend 两种 lowering;GPU 后端五类 kernel(cull / clear-counts / compact / prefix-sum / scatter / build-args)+ per-command DrawMeshInstancedIndirect;能力探测与溢出回退 CPU |
| D6 | UE 对象层级 | 语义对、形态重 | MeshScene typed tables(五类记录:MeshInstanceRecord / TransformRecord / MeshDrawRecord / MeshSectionRecord / MaterialDataRecord)+ Burst jobs,无 processor 派生类树 |
| D7 | static/dynamic 语义 | 命名误导 | 场景侧用 revision 与 dirty range 表达变化(StructuralRevision / ContentRevision / VisibilityRevision);EStateType 仅作组件兼容层 |
| D8 | 缓存失效依赖调用链 | processor 读什么就是什么 | MeshPassDrawCache 以结构化 MeshPassDrawCacheKey 缓存模板(含 shaderPassIndex / meshUnityId / sectionIndex / materialUnityId / materialRevision / sectionRevision / platformFeatureKey / staticFlags);VisibleMeshDraw / MeshDrawList 每 view 重建,缓存与结果分层 |
| D9 | 三层语义分离 | UE 未在公共层分离 | MeshFilterProgram(资格)/ MeshGroupingKey(兼容)/ MeshSortPlan(顺序)三种独立语义,各有结构化 Equals |
| D10 | 多 pass 共享边界 | 共享与独立要可编程 | MeshVisibilityShare 帧内签名 interning(MeshVisibilitySignature 含 sceneId / viewKey / frustumHash / sceneVisibilityRevision / policyId);各 pass 独立 filter/sort/build |
| D11 | RenderGraph 工作产品 | 无符号句柄的构建无法判活 | RGDrawListRef:DeclareDrawList 只登记请求,pass 判活后才 ScheduleLive,被 cull 的 pass 零 job 零分配 |
| D12 | 技术选型 | GPU Driven 在 Unity 中维护成本高,CPU 侧优化保持 GPU 标准管线 | CPU 侧排序 + GPU Instanced Draw 的混合路径;GPU 后端为同一合同延伸(MaxCommands=1024 / MaxInstances=65536),不要求修改现有 Shader |
5.2 数据分层原则
决策表中反复出现一条分界线:模板归缓存,结果归 view。
MeshPassDraw(缓存模板)保存可跨 view 复用的 lowering:shader pass、mesh/section/material identity、revision。transform 更新、camera 运动和 visibility 变化不应造成模板 miss。shader hot reload、material keyword、vertex layout、binding layout 或 section geometry 改变时,受影响的 entry 按 revision 精确失效。
VisibleMeshDraw(view 结果)保存当前 view/pass 的临时引用:template ID(MeshPassDrawId 或 MeshGroupingKey 回退)、instance、sortKey、drawIndex、transformIndex。它每 view 重建,不跨帧缓存。
这两层分离确保:
- camera 移动只重建 view 结果,不触碰模板;
- material 变化只失效相关模板,不重建全部 view 结果;
- 场景静止时模板命中,view 结果仍按新的 camera position 重建 sort key。
5.3 两处自我修正
设计过程中有两处走过弯路。
单表绑定的诱惑。 批判 BRG 单主 buffer 时,容易把方案设计成"一张表装下实例数据"。如果那样做,会与批判对象同构。最终拆成五缓冲(决策表 D2),是因为 transform(current + previous)、bounds(center + extent)和 instance-to-transform 映射的更新频率与失效边界不同。单表会在 transform 更新时波及无关的 bounds 数据,也会在 instance 增删时迫使整个 buffer 重建。五缓冲让 dirty range 精确对应数据类别,MeshSceneResidency.Update() 中 transform dirty range 和 bounds dirty range 独立判定、独立上传。
缓存对象的错位。 容易犯的错误是把排序结果与 command 列表跨帧缓存,用一个 dirty 标记决定是否复用上一帧的 Batch 列表。UE 文档给的正确边界是缓存 pass 模板、每帧重建 view 结果。在这套实现中,MeshPassDrawCache 缓存的是模板(mesh + section + material + pass + revision 的组合),VisibleMeshDraw 和 MeshDrawList 每 view 重建。这样 camera 运动不会读到过期的排序结果,而静止场景的模板命中率仍然很高。
六、数据模型:MeshScene
MeshScene 是 CPU 侧的权威场景表。它只做一件事:用五类 typed table 管理从"一个 MeshComponent 注册到场景"到"GPU 缓冲随脏区间增量上传"的全部数据。不做 culling,不做排序,不做 draw command 构建,那些属于第 7 章。
6.1 Typed ID:六种身份
批判 BRG 时指出的第一个缺陷是"实例身份被 batch 隐式拥有"(§3.1)。MeshScene 的回应是让每种实体拥有独立的、带 generation 的 typed ID。
// 六类 typed ID,结构完全对称
public readonly struct MeshInstanceId : IEquatable<MeshInstanceId>
{
    public readonly uint Index;
    public readonly uint Generation;
    public bool IsValid => Generation != 0;
    public static readonly MeshInstanceId Invalid = default;
}

public readonly struct TransformId    { ... }  // Index + Generation
public readonly struct MeshDrawId     { ... }
public readonly struct MeshSectionId  { ... }
public readonly struct MaterialDataId { ... }
public readonly struct MeshPassDrawId { ... }  // 模板缓存 ID,第 7 章使用
六种 ID 共享同一套模式:Index 是 NativeArray 槽位,Generation 是该槽位被分配的世代编号。Generation == 0 即 Invalid。验证存活的逻辑只需一次下标 + 一次 uint 比较:
public bool IsInstanceAlive(MeshInstanceId id)
{
    return id.IsValid
        && id.Index < (uint)m_InstanceCapacity
        && m_InstanceGenerations[(int)id.Index] == id.Generation;
}
为什么要 generation。 场景是长期容器,Component 的 OnEnable/OnDisable 会在整个运行期不断注册和注销。一个在第 50 帧注册时拿到 slot 7 的实例,在第 200 帧被销毁后 slot 7 被新实例重用。如果外部系统(比如编辑器 Undo、异步 GPU 回读)仍缓存着 slot=7 的旧句柄,generation 不匹配会立即判定为 stale,因此不会读到新占用者的数据,也不会触发对错误实例的操作。这是 ECS 和 GPU 驱动渲染中普遍采用的 slotmap 模式。
6.2 五类记录
决策表 D6 用 typed tables 替代 UE 的对象层级。五类记录分别管五种生命周期:
MeshInstanceRecord — 一个逻辑实例的渲染描述。
// 五类记录之一:逻辑实例的渲染描述
public struct MeshInstanceRecord
{
    public TransformId transform;       // 引用,不内嵌矩阵
    public FBound worldBounds;
    public int layerMask;
    public uint renderingLayerMask;
    public EMeshInstanceFlags flags;    // Visible 位控制是否参与 cull
    public EMotionType motionType;
    public ECastShadowMethod castShadow;
    public int drawStart;               // 诊断用首条 draw 槽位
    public int drawCount;               // 诊断用 draw 数量
    public EGeometrySourceKind geometrySource;
    public uint deformationDataId;
}
关键:transform 是 TransformId 引用,不是 float4x4 内嵌。一个实例有多少个 submesh,矩阵只存一份,这是对旧 BRG "submesh 各持矩阵"结构根因的直接回应。MatrixDuplicateRatio 的稳态目标是 1.0:一个逻辑实例对应恰好一个 transform。
TransformRecord — 矩阵对,current + previous。
public struct TransformRecord
{
    public float4x4 current;
    public float4x4 previous;   // Motion Vector 用
}
previous 在每次 SetTransform 时自动从旧 current 滚动。transform 的更新只发生在 WriteTransform,不波及 bounds 数据,也不波及 draw 记录,这是五缓冲分离(D2)在 CPU 侧的依据。
MeshDrawRecord — 一条绘制资格描述。
public struct MeshDrawRecord
{
    public MeshInstanceId instance;     // 属于哪个实例
    public MeshSectionId section;       // 引用 geometry 描述
    public MaterialDataId material;     // 引用 material 描述
    public EPassEligibility eligibility;// 资格位:哪些 pass 可用
    public int renderQueue;
    public int priority;
    public int meshUnityId;             // Unity Mesh InstanceID
    public int materialUnityId;         // Unity Material InstanceID
    public int sectionIndex;            // submesh index
    public uint staticFlags;            // 静态标记,进入缓存 key
}
一个拥有 N 个 submesh 的 MeshComponent 在注册时产生 N 条 MeshDrawRecord,每条引用同一个 MeshInstanceId。draw record 不持有矩阵、不持有 bounds,它只是"这个实例的这个 submesh 用这个 material 参与这些 pass"的资格声明。第 7 章的 filter job 扫描的就是 draw 表。
MeshSectionRecord — geometry 身份,按 (meshUnityId, sectionIndex) 去重。
public struct MeshSectionRecord
{
    public int meshUnityId;
    public int sectionIndex;
    public EGeometrySourceKind geometrySource;
    public int refCount;
    public uint revision;
    public uint geometryRevision;  // geometry 指纹变化 → revision 递增
}
MaterialDataRecord — material 身份,按 materialUnityId 去重。
public struct MaterialDataRecord
{
    public int materialUnityId;
    public int renderQueue;
    public uint revision;
    public int refCount;
}
Section 和 Material 都是引用计数管理:draw 创建时 AddRef,draw 删除时 ReleaseRef,refCount 降至零后回收槽位。它们的 revision 字段直接参与模板缓存 key(第 7 章 MeshPassDrawCacheKey),geometry 或 material 属性变化时 revision 递增,对应的缓存条目自动失效。
6.3 事务写入
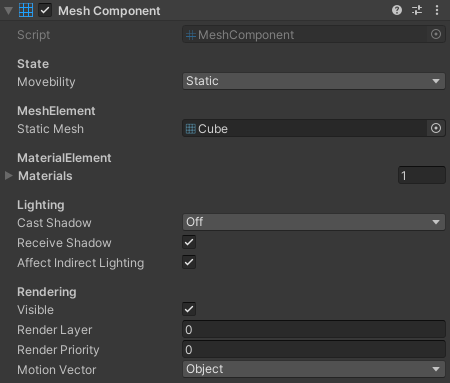
注册一个 MeshComponent 不是散落的三五次函数调用,而是一个事务(MeshSceneUpdate)。事务通过 BeginUpdate() 开启,内部维护 undo log;异常或主动放弃时 Rollback() 沿 undo log 逆序恢复全部状态。
一次典型注册的时序:
using (var update = scene.BeginUpdate())
{
    // 1. 分配一个 transform 槽位
    TransformId transform = update.CreateTransform(localToWorld);

    // 2. 分配一个 instance 槽位,引用上面的 transform
    MeshInstanceId instance = update.CreateInstance(
        transform, worldBounds, layerMask, renderingLayerMask,
        flags, motionType, castShadow);

    // 3. 按 submesh 循环,每个 submesh 产生一条 draw
    for (int sub = 0; sub < mesh.subMeshCount; sub++)
    {
        update.CreateDraw(instance,
            mesh.GetInstanceID(), sub,
            materials[sub].GetInstanceID(),
            eligibility, renderQueue, priority);
    }

    update.Commit();  // 成功:undo log 清空,revision 递增生效
}
// 如果 Commit 前异常,Dispose → Rollback 自动执行
不变量:一个 TransformId 恰好被一个 MeshInstanceId 拥有。 AllocInstance 会检查 m_TransformOwners[transformIndex],如果已有活实例拥有该 transform,抛出异常。这避免了两个实例共享 transform 后更新冲突的问题。
CreateDraw 内部的去重。 CreateDraw 对 section 和 material 执行 AllocOrUpdateSection / AllocOrUpdateMaterial,它们在表中线性扫描已有记录:匹配则复用(并在属性变化时递增 revision),不匹配则新建。一个 mesh+submesh 组合在多个实例之间共享同一个 MeshSectionRecord 槽位,section 记录的 refCount 统计的就是引用它的 draw 数量。
Rollback 的保证。 undo log 按操作的逆序包含完整的 Free/Restore 配对(EMeshSceneUndoOp 枚举有 16 种操作),回滚时恢复 revision、dirty range 和所有记录的前值。事务快照在 BeginUpdate 时保存(MeshSceneStateSnapshot),RestoreTransactionState 负责将 revision 和 dirty 区间回退到事务开始前的状态。
6.4 Free List 与 Generation 槽位
五类 NativeArray 各使用 free list + generation 槽位,删除后不压缩数组:活元素的下标不会因为其他元素的删除而变动。
// 统一分配策略
private static int AllocIndexedSlot(
    ref NativeList<int> freeList,
    ref int highWater,
    ref int liveCount,
    NativeArray<uint> generations)
{
    int index;
    if (freeList.Length > 0)
    {
        index = freeList[freeList.Length - 1];
        freeList.RemoveAtSwapBack(freeList.Length - 1);
        // generation 保持已递增后的值
    }
    else
    {
        index = highWater;
        highWater += 1;
        generations[index] = 1;
    }
    liveCount += 1;
    return index;
}
释放时 generation 递增、记录清零、槽位归还 free list(LIFO)。generation 永远跳过零(NextGeneration 中 next == 0 ? 1u : next),保证 Generation == 0 始终代表 Invalid。
为什么不压缩。 压缩意味着活元素的下标会因他人的删除而变动,所有外部引用都需要间接表转译。这里的 typed ID 直接以数组下标作为 Index,generation 就够了,因为 Job 系统中无锁并发读取 NativeArray 时,固定下标比间接表开销更低,也更容易与 GPU 缓冲保持对齐。代价是数组中存在空洞,遍历时需检查存活(filter job 已经做了这件事)。
容量管理用倍增策略(GrowCapacity),扩容时分配新 NativeArray 并拷贝旧数据,不影响已发放的 ID 有效性。
6.5 Revision 与 Dirty Range
每次结构性变更(create/remove instance/draw)递增 StructuralRevision,每次内容变更(transform/bounds/material 属性)递增 ContentRevision,每次可见性相关变更(flags/bounds/instance 增删)递增 VisibilityRevision。三个 revision 的用途分别是:
StructuralRevision:模板缓存的全量失效判定(第 7 章)。ContentRevision:增量上传的触发条件。VisibilityRevision:MeshVisibilityShare的 interning 签名成分(第 7 章)。revision 变化意味着实例集合或 flags 发生了变化,帧内已缓存的 culling 结果不可复用。
Transform 和 Bounds 各维护独立的 dirty range(begin/end),写入时只 min(begin) / max(end) 扩展区间。这避免了维护 per-slot dirty bitfield 的内存和遍历开销,代价是连续注册大量实例时 dirty range 会退化成一次整段上传。
private void MarkTransformDirty(int index)
{
    m_TransformDirtyBegin = math.min(m_TransformDirtyBegin, index);
    m_TransformDirtyEnd   = math.max(m_TransformDirtyEnd, index);
}
清除在 Residency 上传完成后调用 ClearTransformDirtyRange() / ClearBoundsDirtyRange()。
6.6 驻留五缓冲与增量上传
决策表 D2 的实体化是 MeshSceneResidency。它持有五个 GPU StructuredBuffer,分两组索引域:
| 缓冲 | 索引域 | 元素类型 | 说明 |
|---|---|---|---|
| TransformBuffer | TransformId.Index | float4x4 | 当前帧矩阵 |
| PreviousTransformBuffer | TransformId.Index | float4x4 | 上一帧矩阵 |
| BoundsCenterBuffer | MeshInstanceId.Index | float4 | 实例包围盒中心 |
| BoundsExtentBuffer | MeshInstanceId.Index | float4 | 实例包围盒半径 |
| InstanceTransformIndexBuffer | MeshInstanceId.Index | uint | 实例→transform 下标映射 |
Transform 缓冲按 transform 槽位索引,Bounds 和映射按 instance 槽位索引。GPU 侧 culling 以 instance index 采样 bounds,shading 通过 InstanceTransformIndexBuffer[instanceIndex] 间接找到 TransformBuffer 中的矩阵。两组索引域的分离确保 transform 更新不波及 bounds 缓冲,bounds 更新不波及 transform 缓冲。
上传策略。 MeshSceneResidency.Update() 的逻辑:
- 容量不足时全量重建:释放旧缓冲、分配新缓冲、从槽位 0 到 highWater 全量上传。
- 容量够且有 dirty range 时只上传
[dirtyBegin, dirtyEnd]区间,使用buffer.SetData(array, srcOffset, dstOffset, count)。
if (!recreateTransforms && m_Scene.HasTransformDirtyRange)
{
    int begin = m_Scene.TransformDirtyBegin;
    int end   = m_Scene.TransformDirtyEnd;
    UploadTransformRange(begin, end + 1);
    m_Scene.ClearTransformDirtyRange();
}
Bounds 上传同理:全量重建时扫描全部 instance 槽位(包含空洞时写零),增量时只扫描 [BoundsDirtyBegin, BoundsDirtyEnd] 区间。
为什么五缓冲而不是一张大表。 这是 §5.3 "单表绑定的诱惑"自我修正的具体实现。Transform 每帧可能有数百个实例更新(运动物体),但 bounds 只在实例注册或 bounds 重算时变化。如果全部压入一张 StructuredBuffer,transform dirty 会迫使上传操作扫过 bounds 字段,浪费 CPU→GPU 带宽。五缓冲让 dirty range 精确到数据类别:8000 实例场景中只有 800 个运动物体时,transform 上传量约 800 × 64B × 2 = 100KB,bounds 上传量为零;单表方案下每帧至少 800 × (64+64+16+16+4)B = 131KB,且 SetData 的 srcOffset/count 无法跳过中间的 bounds 字段。
七、编译:从场景到 DrawList
MeshScene 提供了五类 typed table。但 table 不是 draw call。从注册表到每帧每 view 的 MeshDrawCommand 列表,中间需要一条完整的编译路径。这条路径有五个阶段,全部在 CPU 上以 Burst job 执行,不依赖 UE 式 processor 派生类,也不依赖 BRG callback。
7.1 可见性:Burst 标量剔除
编译的第一步不属于 pass,而属于 view。一个 camera 的一次 frustum cull 产出一份 MeshViewCullingResult,多个 pass 可以共享这份结果。
// 每 view 的剔除结果
public struct MeshViewCullingResult
{
    public NativeArray<byte> instanceVisibility;  // 每 instance 一字节,0/1
    public NativeArray<FPlane> frustum;            // 6 平面
    public bool isValid;
}
核心 job 是 MeshInstanceCullingJob:逐实例、标量 AABB × 6 平面测试。
[BurstCompile]
public unsafe struct MeshInstanceCullingJob : IJobParallelFor
{
    [ReadOnly] [NativeDisableUnsafePtrRestriction]
    public FPlane* viewFrustum;
    [ReadOnly] public NativeArray<MeshInstanceRecord> instances;
    [ReadOnly] public NativeArray<uint> generations;
    [WriteOnly] public NativeArray<byte> instanceVisibility;

    public void Execute(int index)
    {
        byte visible = 0;
        if (generations[index] != 0)
        {
            MeshInstanceRecord instance = instances[index];
            if ((instance.flags & EMeshInstanceFlags.Visible) != 0)
            {
                int inside = 1;
                FBound bound = instance.worldBounds;
                for (int i = 0; i < 6; ++i)
                {
                    ref FPlane plane = ref viewFrustum[i];
                    float2 distRadius;
                    distRadius.x = math.dot(math.abs(plane.normalDist.xyz), bound.extents);
                    distRadius.y = math.dot(plane.normalDist.xyz, bound.center)
                                 + plane.normalDist.w;
                    inside = math.select(inside, 0, distRadius.x + distRadius.y < 0);
                }
                visible = (byte)inside;
            }
        }
        instanceVisibility[index] = visible;
    }
}
几个要点:
- per-instance 粒度。 visibility 以 instance 为单位,不是 per-draw。一个有 4 个 submesh 的实例只做一次 AABB 测试,这是第 6 章"draw 只引用 instance"的直接收益。批判 BRG 矩阵重复时提到的"同一空间区域被重复剔除"问题在此消除。
- generation 检查。
generations[index] != 0跳过空洞槽位,配合IJobParallelFor的 batch size 256,空洞密集区域的开销接近于零。 - Visible flag 前置。
EMeshInstanceFlags.Visible位为零的实例直接跳过 6 平面测试。这为 GPU Occlusion Culling 的 CPU 回读结果、编辑器 hidden flag 等场景提供了免测试的关闭通道。 - 标量而非 4-wide。 这里采用标量写法、依赖 Burst 编译器自动向量化,不做 4-wide SOA 布局配合手写 SSE/NEON 映射。理由是 instance 表存在空洞(free list 不做压缩),4-wide 打包需要额外的 gather/scatter 或 SOA 双写副本,维护成本高于收益。对于当前 8000 实例规模,标量 Burst job 在 256 batch size 下的耗时已低于 0.1ms。
7.2 可见性共享:MeshVisibilityShare
批判 BRG 时指出"多 pass 共享边界不可编程"(§3.2)。MeshScene 的回应是 MeshVisibilityShare,即帧内 visibility 结果的 interning。
// visibility interning 签名
public struct MeshVisibilitySignature : IEquatable<MeshVisibilitySignature>
{
    public int sceneId;
    public ulong viewKey;
    public ulong frustumHash;
    public int sceneVisibilityRevision;
    public int policyId;
}
签名的五个成分:sceneId 区分不同 MeshScene(多场景并存时),viewKey 区分 camera(由 MakeCameraViewKey(camera) 或 MakeCascadeViewKey(lightId, cascadeIndex) 生成),frustumHash 是 6 平面的量化 FNV-1a 哈希(精度 ~1e-3 防浮点噪声拆分),sceneVisibilityRevision 是 MeshScene 的 VisibilityRevision,实例增删或 flags 变化会递增它,令帧内已缓存结果失效。policyId 区分主 frustum(0)、cascade shadow(1)、local shadow(2)。
Acquire 以签名查表:命中则 AddRef 返回已有结果,未命中则执行 CullInstances 并 Insert。同一主 camera 的 Depth、GBuffer、Forward、Motion 四个 pass 如果 frustum 和 revision 相同,共享一次 cull,4 次 cull 降为 1 次。cascade shadow 的各级使用不同 frustumHash,分别 cull 但不与主 camera 混淆。
帧结束时 EndFrame() 释放全部 entries,不跨帧缓存,因为 visibility 是 per-view 结果,不是模板。
7.3 Filter:MeshPassFilterJob
每个 pass 独立运行一个 filter job,从 draw 表中筛出该 pass 的 VisibleMeshDraw 列表。
// filter job:扫描 draw 表,产出 VisibleMeshDraw
[BurstCompile]
public struct MeshPassFilterJob : IJob
{
    [ReadOnly] public NativeArray<byte> instanceVisibility;
    [ReadOnly] public NativeArray<MeshInstanceRecord> instances;
    [ReadOnly] public NativeArray<uint> instanceGenerations;
    [ReadOnly] public NativeArray<uint> transformGenerations;
    [ReadOnly] public NativeArray<MeshDrawRecord> draws;
    [ReadOnly] public NativeArray<MeshPassDrawId> passDrawIds;
    [ReadOnly] public MeshFilterProgram filter;
    [ReadOnly] public MeshSortPlan sort;
    public float3 viewPosition;
    public int shaderPassIndex;
    public int drawHighWater;
    public NativeList<VisibleMeshDraw> visibleDraws;
    // ...
}
filter 逻辑是 draw 表的线性扫描(0..drawHighWater),逐条检查七项条件:
- draw.instance 存活 — generation 匹配
- instance visibility — culling 结果 byte != 0
- transform 存活 — generation 匹配(防止 transform 先于 instance 被释放)
- eligibility —
(draw.eligibility & filter.requiredEligibility) == filter.requiredEligibility - renderQueue 区间 —
[renderQueueMin, renderQueueMax] - layerMask & renderingLayerMask — 逐位与
- motion 排除 —
excludeCameraMotionOnly && motionType == Camera时跳过
全部通过后构造 VisibleMeshDraw,同时计算 sort key。
MeshFilterProgram 是 filter 的数据描述(决策表 D4 "filter 进入 request 语义")。每种 pass 在 MeshPassDefinition 中声明自己的 defaultFilter:
// 示例:Motion pass 排除 camera-only motion
public static readonly MeshPassDefinition Motion = new MeshPassDefinition
{
    defaultFilter = new MeshFilterProgram(
        renderQueueMin: 0,
        renderQueueMax: 2999,
        requiredEligibility: EPassEligibility.Motion,
        layerMask: ~0,
        excludeCameraMotionOnly: true),
    // ...
};
这使得 pass 的 filter 语义是可声明的数据结构,不是散布在 processor 代码中的 if/else 链。
7.4 Sort:MeshSortPlan 与 PackSortKey
每个 pass 声明自己的排序计划(MeshSortPlan),最多 4 个字段,每字段一个 16-bit 段,合成 64-bit lexicographic key。
// 排序计划:最多 4 个 16-bit 段
public struct MeshSortPlan
{
    public MeshSortField field0, field1, field2, field3;
    public int count;  // 实际使用 1-4 个字段
}

public struct MeshSortField
{
    public EMeshSortSemantic semantic;  // RenderQueue/Material/Mesh/Distance/...
    public ESortDirection direction;     // Ascending / Descending
    public float quantizeScale;          // distance 量化比例,0 = 默认 100 (cm)
}
MeshSortKey.PackSortKey 按 plan 中的字段顺序将每个语义编码为 16-bit 段。编码方式因语义而异:
- RenderQueue / Section / PassPriority — 直接 clamp 到 16-bit。
- Material / Mesh — Unity InstanceID 经
HashInt(两轮乘法混洗)映射到 16-bit,保证 ID 值不连续时仍均匀分桶。 - Distance —
math.length(center - viewPos) × quantizeScale,线性量化到[0, 65535]。quantizeScale 默认 100(厘米精度),Depth/Motion pass 用 10(分米精度,扩大 camera range),Shadow 用 1(米精度,适配 cascade 大范围)。 - StableDrawId —
EncodeUnsigned(drawIndex)作为粗桶;超过 65535 条 draw 时 sort key 可能碰撞,VisibleMeshDraw.CompareTo用 drawIndex 做最终仲裁。
排序计划是可组合语义,位布局是编译细节。五种内建 pass 的排序计划各不相同:
| Pass | field0 | field1 | field2 | field3 |
|---|---|---|---|---|
| Depth | Distance↑(10) | Material | Mesh | StableDrawId |
| GBuffer | RenderQueue | Material | Mesh | Section |
| Forward | RenderQueue | Material | Mesh | StableDrawId |
| Motion | Distance↑(10) | Material | Mesh | StableDrawId |
| Shadow | Distance↑(1) | Material | Mesh | StableDrawId |
Depth 和 Motion 优先 front-to-back(减少 overdraw / 提高 Early-Z 命中),GBuffer 优先 RenderQueue 和 Material 聚合(减少 PSO 切换),Shadow 使用更粗的距离桶(cascade 范围大)。扩展新 pass 时只需声明新的 MeshSortPlan,不需要修改 sort job 代码。这是决策表 D9 "三层语义分离"的排序层体现。
排序本身由 MeshPassSortJob 执行,内部调用 NativeList<VisibleMeshDraw>.Sort()(Burst 友好的 introspective sort)。
7.5 分组:两级策略
排序完成后,MeshPassBuildJob 做线性扫描,将连续的、属于同一组的 draw 合并为一条 MeshDrawCommand。分组使用两级策略:
// MeshPassBuildJob.Execute 核心逻辑
if (visible.passDrawId.IsValid)
{
    // 优先级一:模板缓存 ID 相同 → 同组
    newGroup = !hasLast || !lastUsedPassDrawId
            || !visible.passDrawId.Equals(lastPassDrawId);
}
else
{
    // 优先级二:缓存关闭时退回 MeshGroupingKey
    newGroup = !hasLast || lastUsedPassDrawId
            || !visible.grouping.Equals(lastGrouping);
}
MeshPassDrawId(优先):模板缓存开启时,filter job 已为每条 draw 查询了 MeshPassDrawCache,拿到稳定的 MeshPassDrawId。相同 passDrawId 的 draw 共享同一份 lowered template(shader pass + mesh + section + material + revision),天然是同组。
MeshGroupingKey(回退):缓存关闭(MeshPassDrawCache.Enabled = false)或缓存未命中时,passDrawId 为 Invalid,分组退回到结构化比较:
public struct MeshGroupingKey : IEquatable<MeshGroupingKey>
{
    public int meshUnityId;
    public int sectionIndex;
    public int materialUnityId;
    public int pipelinePassIndex;
}
四字段 Equals 判定兼容性:mesh/section/material/pass 完全一致才合并。这是决策表 D9 "MeshGroupingKey(兼容)"的实体。
每组的 MeshDrawCommand 记录 countOffset:x 为 instance count,y 为 instanceIndices 数组中的起始偏移。Build job 同时填充两个并行数组:
instanceIndices[i] = visible.transformIndex— CPU 提交路径使用,shader 通过 TransformBuffer[index] 取矩阵。instanceSlotIndices[i] = visible.instance.Index— GPU 后端使用,instance-indexed cull/bounds 采样。
7.6 模板缓存:MeshPassDrawCache
决策表 D8 的实体。MeshPassDrawCache 缓存的是 pass-level 的 lowered template,不是 sort 结果,也不是 command 列表。
// 模板缓存 key
public struct MeshPassDrawCacheKey : IEquatable<MeshPassDrawCacheKey>
{
    public int shaderPassIndex;
    public int meshUnityId;
    public int sectionIndex;
    public int materialUnityId;
    public uint materialRevision;
    public uint sectionRevision;
    public uint platformFeatureKey;
    public uint staticFlags;
}
八字段结构化 key。GetOrCreate 以 key 查表:命中则返回已有 MeshPassDrawId,未命中则分配新槽位。缓存开启时诊断计数器 TemplateCacheHits / TemplateCacheMisses 记录命中率。
失效边界:什么不会造成 miss。 transform 更新、camera 运动、visibility 变化只影响 per-view 结果(§5.2),不进入 cache key。模板缓存只在以下条件下 miss 或失效:
- material revision 变化(
renderQueue改变)→MaterialRevisionInvalidated事件广播,所有 cache 实例收到后扫描并失效匹配条目。 - section revision 变化(geometry 改变)→ 新 key 的
sectionRevision不同,自然 miss。 - 新 mesh/material/pass 组合→新 key,自然 miss。
这承接了 §5.3 "缓存对象的错位"自我修正:缓存 pass 模板,不缓存排序结果。
Enabled 开关。 MeshPassDrawCache.Enabled 是静态开关。设为 false 时 GetOrCreate 始终返回 MeshPassDrawId.Invalid,BuildJob 退回 MeshGroupingKey 分组,功能等价,但每帧全量重建模板。这为调试和 A/B 测试提供了开关。
7.7 全流程时序
综合以上五个阶段,一次 pass 编译的完整时序:
visibility = MeshVisibilityShare.Acquire(scene, viewKey, frustum, policy)
    ↓
MeshPassFilterJob.Schedule()     // 扫描 draw 表,七项 filter,构造 VisibleMeshDraw + sort key
    ↓
MeshPassSortJob.Schedule()       // 64-bit key introspective sort
    ↓
MeshPassBuildJob.Schedule()      // 线性扫描,两级分组,产出 MeshDrawCommand[]
    ↓
MeshDrawCommand[] + instanceIndices[] + instanceSlotIndices[]
filter / sort / build 三个 job 之间有依赖(sort 等 filter 完成,build 等 sort 完成),但不同 pass 之间的 filter job 可以并行:它们读取同一份 draw 表和 visibility 数组(只读),写入各自独立的 visibleDraws 列表。
每帧每 view,visibility 计算一次(或 interning 复用),filter/sort/build 各 pass 独立执行。camera 移动时 sort key 中的 Distance 段变化,排序结果重建,但模板缓存不受影响。静止场景的 cache hit rate 接近 100%,运动场景的开销集中在 sort 阶段(O(N log N)),而非模板重建。
八、提交与后端
第 7 章产出的 MeshDrawList 只有三组数组加两个计数:commands、instanceIndices、instanceSlotIndices、commandCount、instanceCount。它不绑定任何提交方式。把这份 list 翻译成 GPU 命令,有两条 lowering。
8.1 CPU 直出:每 command 一次 procedural draw
SubmitCpuDirect 对每个 MeshDrawCommand 做四件事:由 command.meshUnityId / command.materialUnityId 还原 Unity 对象、用 MeshPassShaderUtility.ResolvePassIndex 解析 shader pass、填 MaterialPropertyBlock、调用 DrawMeshInstancedProcedural。MPB 只有四项绑定:
m_PropertyBlock.SetInt(InfinityShaderIDs.InstanceIndexOffset, command.countOffset.y);
m_PropertyBlock.SetBuffer(InfinityShaderIDs.InstanceIndexBuffer, indexBufferRef.buffer);
m_PropertyBlock.SetBuffer(InfinityShaderIDs.TransformBuffer, m_Residency.TransformBuffer.buffer);
m_PropertyBlock.SetBuffer(InfinityShaderIDs.PreviousTransformBuffer, m_Residency.PreviousTransformBuffer.buffer);
cmdBuffer.DrawMeshInstancedProcedural(mesh, command.sectionIndex, material, passIndex, command.countOffset.x, m_PropertyBlock);
countOffset 的两个分量分工是第 7.5 节分组结果的直接消费:x 是 instance count,y 是 instanceIndexBuffer 中的起始偏移。同一 pass 的所有 command 共享一个 index buffer,一次 SetBufferData 覆盖该 pass 整帧的实例索引,因此 command 数越多,这个共享的收益越大。
上传与退役时序。 index buffer 由 PrepareCpuDirect 从 ResourcePool 租借,size 取 math.max(indexCount, 16),写入 drawList.instanceIndices 后进入 m_FrameRentedBuffers。它不能在本帧归还:command buffer 记录的是 GPU 稍后要读取的地址,在 ScriptableRenderContext.Submit 之前归还同一 FBufferRef,下一次租借会命中它并覆写尚未执行的绘制数据。退役因此拆成两步:
ReleaseFrameBuffers()只把m_FrameRentedBuffers搬进m_RetiredBuffers,是逻辑回收;FlushRetiredBuffers()逐个调用m_ResourcePool.ReleaseBuffer,是物理回收。
物理回收点在帧末 Submit 之后:先 MeshDrawGPUBackend.FlushRetiredPayloads(),再依次 flush Depth / GBuffer / Forward / Motion / Shadow 五个 processor。ReleaseFrameBuffers 被设计成幂等,因为 RGDrawList.ReleaseAll 对每个 record 都调用一次,而多个 record 可能共用同一个 pipeline 实例;幂等性来自"只搬移、不归还",重复调用不会 double free。
8.2 GPU 后端:从同一份 list 生成 indirect args
后端选择发生在 MeshDrawGPUBackend.SelectPolicy:
if (requested == EMeshBackendPolicy.CpuDirect) return EMeshBackendPolicy.CpuDirect;
if (requested == EMeshBackendPolicy.GpuIndirect)
    return SupportsIndirect ? EMeshBackendPolicy.GpuIndirect : EMeshBackendPolicy.CpuDirect;
return SupportsIndirect ? EMeshBackendPolicy.GpuIndirect : EMeshBackendPolicy.CpuDirect;
SupportsIndirect 要求 SystemInfo.supportsInstancing && SupportsCompute,后者再要求 SystemInfo.supportsComputeShaders && s_Shader != null && s_KernelsValid。s_KernelsValid 由 ResolveKernels 逐个 HasKernel 校验 s_RequiredKernelNames 里的六个名字;缺任何一个则全部 kernel index 置 -1、s_KernelsValid = false,整条 GPU 路径降级为 CPU direct。这是能力探测而不是异常捕获:Auto 策略在没有 compute 的平台上不会抛异常,只是换一条 lowering。
六个 kernel。 compute shader 声明 CullInstances / ClearCommandCounts / CompactCommandInstances / PrefixSumCommands / ScatterVisibleInstances / BuildIndirectArgs(决策表 D5 记作五类,实际上 prefix-sum 与 scatter 是两个独立 kernel)。PrepareBatch 按顺序 dispatch:
CullInstances— 对全部驻留 slot 跑一次 frustum 测试,写_InstanceVisibility位数组,dispatch 规模(boundsCount + 63) / 64。读的是residency.BoundsCenterBuffer/BoundsExtentBuffer,与 CPU 路径用的是同一份 bounds 表。ClearCommandCounts— 清_VisibleCounts/_CommandInstanceOffsets/_IndirectArgs。CompactCommandInstances— 逐 command 一次 dispatch。PrefixSumCommands— thread 0 串行累加 command 级偏移。ScatterVisibleInstances— 把_CommandCandidateOffsets抄回_CommandInstanceOffsets。BuildIndirectArgs— 组装 5 个 uint:(indexCount, instanceCount, startIndex, baseVertex, 0),instanceCount取自 GPU 写入的_VisibleCounts。
// 可见实例的压缩写入
uint instanceIndex = _CandidateIndices[candidateIndex];
if (_InstanceVisibility[instanceIndex] == 0u) { return; }
uint slot;
InterlockedAdd(_VisibleCounts[_CommandIndex], 1u, slot);
uint baseOffset = _CommandCandidateOffsets[_CommandIndex];
_CompactedIndices[baseOffset + slot] = _InstanceTransformIndex[instanceIndex];
这五行是整个后端的语义枢纽:候选流以 instance 为索引,压缩输出以 transform 为索引,_InstanceTransformIndex(MeshSceneResidency 五缓冲之一)完成域转换。CPU 路径里同样的转换由 MeshPassBuildJob 写 instanceIndices[i] = visible.transformIndex 完成(第 7.5 节)。两条 lowering 在这一点上等价,只是一个在 Burst job 里做,一个在 compute shader 里做。
推断:两条路径在静态场景上应当给出相同的可见集,因为它们读同一份 residency bounds 表、同一组 frustum 平面。这个一致性由调用顺序保证——MeshSceneResidency 的 dirty range 上传必须早于 PrepareBatch 的 dispatch——代码里没有显式 barrier 表达该依赖。
容量与溢出回退。 MaxCommands = 1024 / MaxInstances = 65536。TryPlanBatches 按这两个上限把 command 序列切成批;单条 command 的候选数超过 MaxInstances 时直接返回 false,因为 command 内部无法再切。ComputePayloadBudget 汇总各批所需的 maxCommands / maxInstances。MeshDrawGpuPayload 区分两种容量操作:TryEnsureCapacity 会 Release 并重建 ComputeBuffer,只允许在录图之前调用;RequireCapacity 在录图期间只检查不重建。这个区分对应 9.4 节的 D3D12 约束。
溢出回退发生在三处,都累加 MeshPipelineDiagnostics.GpuOverflowCount:分批或容量检查失败、PrepareGpu 前置条件未过、EnsureResolved 里 staging 为空或 maxCommands <= 0。回退结果都是 selectedBackend = EMeshBackendPolicy.CpuDirect,同一份已 resolve 的 list 改走 8.1 的路径,不重跑 filter / sort / build。
8.3 Shader 侧:两跳寻址
两条 lowering 共享同一套 shader 绑定:instanceIndexOffset、instanceIndexBuffer、transformBuffer、previousTransformBuffer。顶点着色器的取矩阵代码是两跳:
uint primitiveId = instanceIndexBuffer[In.InstanceId + instanceIndexOffset];
FTransformData meshBatch = transformBuffer[primitiveId];
In.InstanceId 由 DrawMeshInstancedProcedural 或 DrawMeshInstancedIndirect 提供,instanceIndexOffset 在 CPU 路径是 command.countOffset.y,在 GPU 路径是 batch-local 的 candidate 偏移。第一跳取出 transform 表下标,第二跳取矩阵。Motion pass 再加一次 previousTransformBuffer[primitiveId]。
这个结构说明了两件事。instanceIndexBuffer 必须每帧重传,因为它承载的是"可见实例的排列",是 view-dependent 结果;transformBuffer 是 resident 表,按 dirty range 增量更新,不随 view 变化。GPU 路径只把第一跳的产出从 CPU 写的 instanceIndices 换成 compute 写的 compactedIndices,着色器代码一行不改,这正是 D12 中"不要求修改现有 Shader"的落点。
8.4 两种 lowering 的对照
| CPU direct | GPU backend | |
|---|---|---|
| 输入 | MeshDrawList | 同一份 MeshDrawList |
| 可见集由谁定 | MeshInstanceCullingJob + MeshPassFilterJob | CPU 给候选上界,GPU CullInstances + CompactCommandInstances 定终值 |
| instance count 来源 | command.countOffset.x | BuildIndirectArgs 读 _VisibleCounts |
| index buffer | ResourcePool 租借 + SetBufferData | payload compactedIndices + InterlockedAdd |
| transform 索引解析 | MeshPassBuildJob 写 instanceIndices | CompactCommandInstances 查 _InstanceTransformIndex |
| 提交 API | DrawMeshInstancedProcedural | DrawMeshInstancedIndirect |
| 溢出行为 | 无 | 分批;单 command 超限则整条 list 回退 CPU |
MeshDrawRequest 是合同,MeshDrawList 是合同的编译结果,CPU direct 与 GPU backend 是把这份结果翻译成 GPU 命令的两种 lowering。GPU 后端没有引入新的 pass 语义,也没有给 request 增加字段,只把"最终可见集"这个 CPU 无法同步得知的量交给 GPU 决定。这个边界与 GPU Driven 的通常定义一致:CPU 保留稳定语义与资源所有权,GPU 决定 view-dependent population。
九、与 RenderGraph 集成
9.1 RGDrawListRef 是一个符号句柄
RGDrawListRef 只有三个字段:contextId、index、generation,IsValid 只检查 contextId > 0。真正的世代校验在 IsLiveRef:contextId、generation、index 三者同时匹配才算活动引用。m_GraphGeneration 从 1 起算,使得 default(RGDrawListRef) 的 {0,0} 永远不会误配到一张活图。
DrawList 有独立的 registry(RGDrawListContext),不是 ERGResourceType 的一个成员。理由是可 alias 的显存资源和需要编译的绘制工作产品生命周期不同:前者由资源系统做 transient allocation,后者要先经过判活、backend 选择、job 调度才能谈论物理存储。塞进同一个 enum,等于让资源系统在它还不知道 pass 是否存活的时候就去分配。
9.2 录图阶段只做登记
DeclareDrawList 往 m_Records 里加一条 RGDrawListRecord,state = Declared,selectedBackend 默认 CpuDirect,返回句柄。没有分配数组,没有 schedule job,没有 backend 探测。
UseDrawList 把句柄加进 pass.usedDrawLists,陈旧的 ref 返回 RGDrawListRef.Invalid 而不是抛异常。以 DepthPass 为典型调用侧:request 在录图时构造完成,DeclareDrawList 拿到 depthDraws,pass setup 里 passData.draws = passRef.UseDrawList(depthDraws),execute 里只有一行 cmdEncoder.Draw(passData.draws),后者转发到 RGDrawListContext.Submit。Pass 的编写者看不到 MeshDrawBuild、看不到 JobHandle、看不到 backend 选择。
9.3 先判活,再构建
CompilePass 的编译序是 InitializeCompileData → CountPassReference → CullingUnusedPass → CompileDrawLists → UpdateResource。DrawList 的编译紧跟在 pass 判活之后、资源生命周期分析之前。这个位置的核心约束是:backend lowering 会改变物理图,必须晚于结构活性分析、早于物理资源最终化。
CompileDrawLists 遍历未被 cull 的 pass,对每个 usedDrawLists 条目调 MarkLiveConsumer,把 Declared 的记录推进到 Live;然后 ScheduleLive:
if (record.state != ERGDrawListCompileState.Live)
{
    // Culled / unused: zero schedule, zero TempJob alloc.
    record.state = ERGDrawListCompileState.Released;
    continue;
}
record.selectedBackend = MeshDrawGPUBackend.SelectPolicy(record.request.backendPolicy);
record.build = record.pipeline.Schedule(record.request, record.culling);
record.state = ERGDrawListCompileState.Scheduled;
非 Live 的记录连 Schedule 都不调用。而 Schedule 里的五次 Allocator.TempJob 分配(passDrawIds 与 visibleDraws / drawCommands / instanceIndices / instanceSlotIndices)是唯一为编译分配内存的地方,被 cull 的 pass 因此是零 job 零分配,不是"编译完再丢弃"。MeshPipelineDiagnostics.CulledPassSkippedBuilds 和 TempAllocCount 是这条性质的两个可读取证据。backend 选择也放在这一步:它需要 platform 能力,而能力与录图先后无关。
9.4 执行前:Resolve 与 PrepareSubmit 分离
执行前有两个紧邻的循环:先对每个 DrawList 调 EnsureDrawListResolved,再调 PrepareSubmit。
EnsureResolved 只动 CPU 侧:build.dependency.Complete()、pipeline.Resolve(ref build) 拿到 MeshDrawList,若 backend 是 GpuIndirect 则建 MeshDrawGpuStaging、ComputePayloadBudget、RentPayload + EnsureCapacity。它可以在 raster pass 内部触发。
PrepareSubmit 录制的全是 GPU 命令:PrepareGpu 内部的 SetBufferData 与 DispatchCompute。分离的原因是 D3D12 不允许这些操作出现在 BeginRenderPass 之内,这一约束在 PrepareIndirect 的文档注释里同样写明。
PrepareSubmit 也是 GPU 回退 CPU 的最后一个判定点:PrepareGpu 返回 false 就把 selectedBackend 改回 CpuDirect 并走 PrepareCpuDirect。此时 resolved list 已在手上,回退不需要重跑编译。
异常路径由 graph 的 try/finally 统一兜底:Execute 保证 ClearPass → ReleaseAllDrawLists 一定执行;ReleaseAll 释放 build、RetirePayload、释放 visibility 引用、调 ReleaseFrameBuffers,全部是逻辑回收。物理回收在 ScriptableRenderContext.Submit 之后由帧末统一 flush。
9.5 与 RendererList 的对照
Unity RendererList 与 UE 的 mesh pass 工作产品遵循同一条原则:录图期拿到的是符号句柄,句柄在编译期绑定到实体,实体在绑定之前不存在。DepthPass 里的 CreateRendererList 就是这个形状:RendererListDesc 是描述,RendererList 是句柄,实际绘制在 DrawRendererList。RGDrawListRef 与它同构,差别只在句柄绑定的是什么:RendererList 绑定的是 Unity 内建的剔除与排序(推断:Unity 未公开其内部 lowering 的可编程层),RGDrawListRef 绑定的是第 7 章的三段 job 和第 8 章的两种 backend。
判活语义上有一处差异值得单独记下。Unity 提供 RendererListStatus.Empty / Populated,可在 CPU 已知结果时做动态剔除;GPU Driven 路径无法同步复制这个策略,因为最终 count 在 GPU 上。这里的取舍是 graph 编译只做结构判活(有无非 culled consumer),不做数量判活:数量为 0 时 GPU 路径靠 BuildIndirectArgs 写入的 instanceCount = 0 自然 no-op,CPU 路径靠 SubmitCpuDirect 开头的 commandCount == 0 提前返回。两条路径结果一致,只是优化机会不同,并且不为了判断 empty 发起同帧 readback。
十、性能
10.1 口径
这组数字来自 Unity 2021 Editor 环境下的一次测量,用于说明量级差异。 测量环境为 Windows / 中端独显 / 8 核 CPU,Burst target 为 AVX2、Safety Check 关闭、Worker Thread 数 7、测试前 100 帧 Warm-up。这些数字只能作量级参照,不能逐项外推到其他章节描述的链路上。这套实现的目标 Editor 是 Unity 6000.0.26f1,尚未在同一测试场景下复测;10.4 节列出待复测的指标与各自的当前状态。
10.2 测量结果
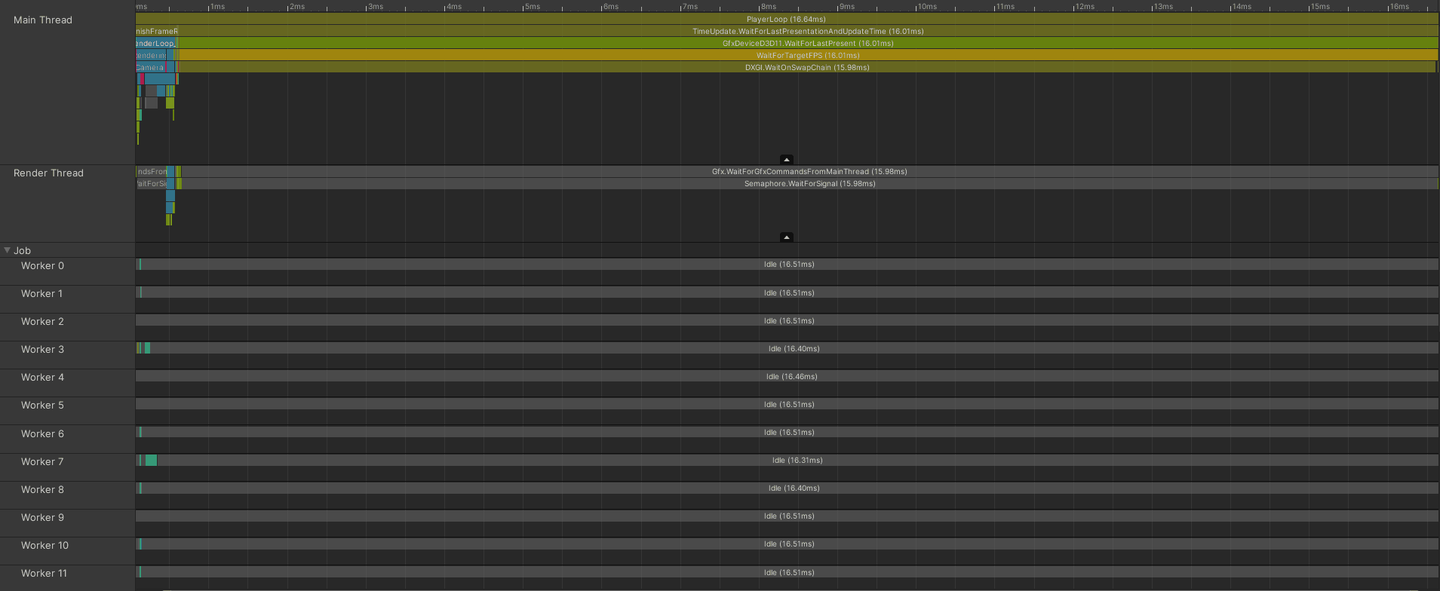
自定义管线在 8000 实例、3 个 MeshPass 下的分阶段耗时:
| 阶段 | 数值 |
|---|---|
| Culling | 0.06 ms |
| MeshBatch 生成(Filter + Sort + Batch Build) | 0.22 ms(Depth Pass 因约半数物体被剔除,耗时减半) |
| DrawCall 数量 | 12(3 Material × 4 Mesh,Auto Instance 合并) |
| GPU Scene 更新 | ~0.01 ms(静态场景下上传队列为空) |
| 总 CPU 时间(到渲染线程末尾) | 0.65 ms |
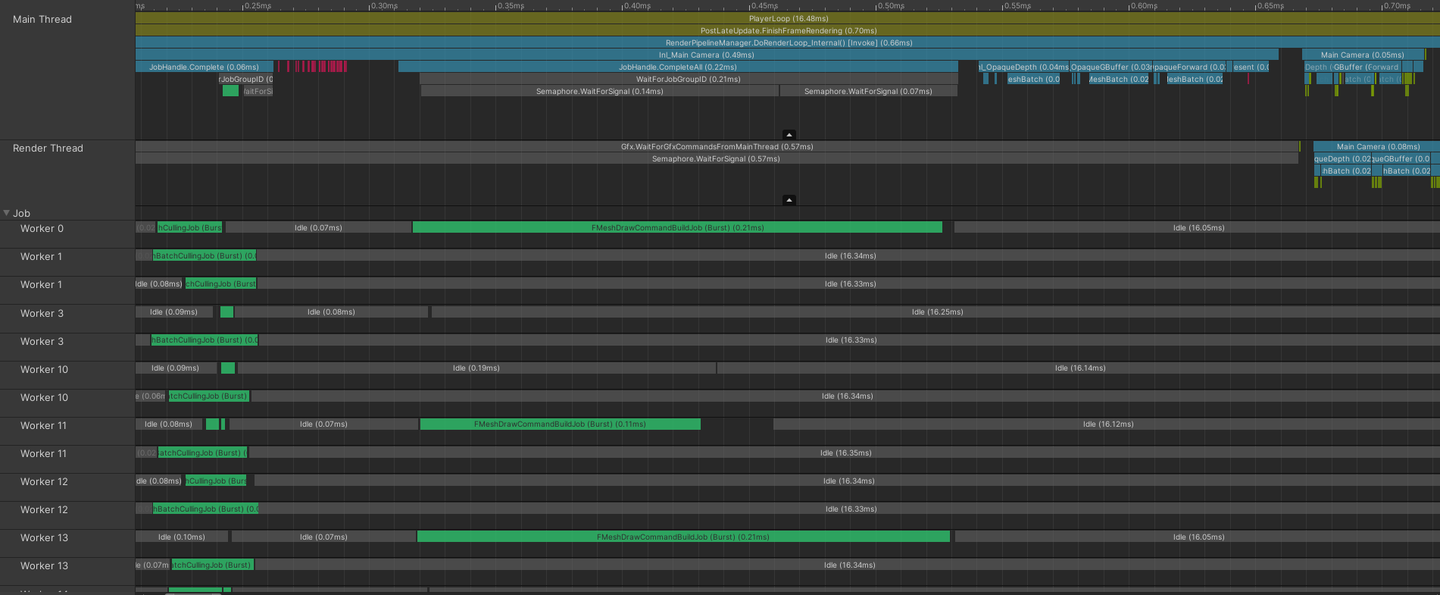
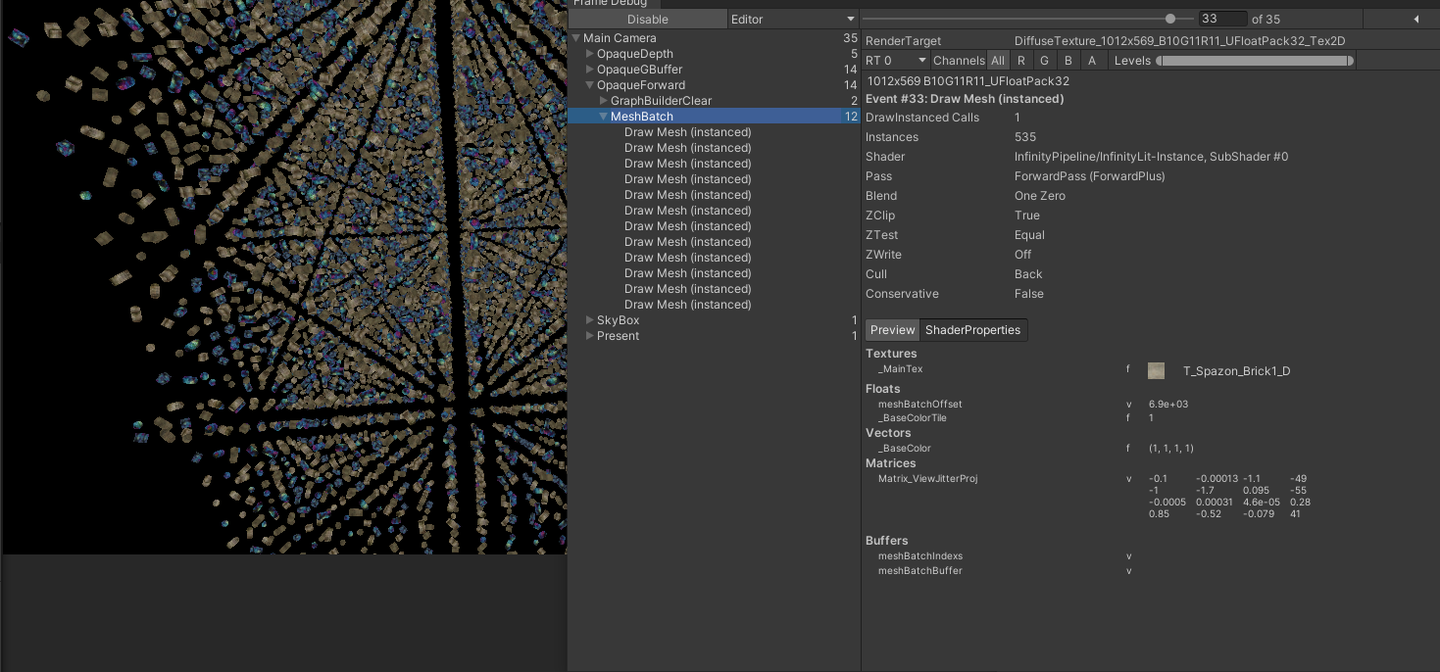
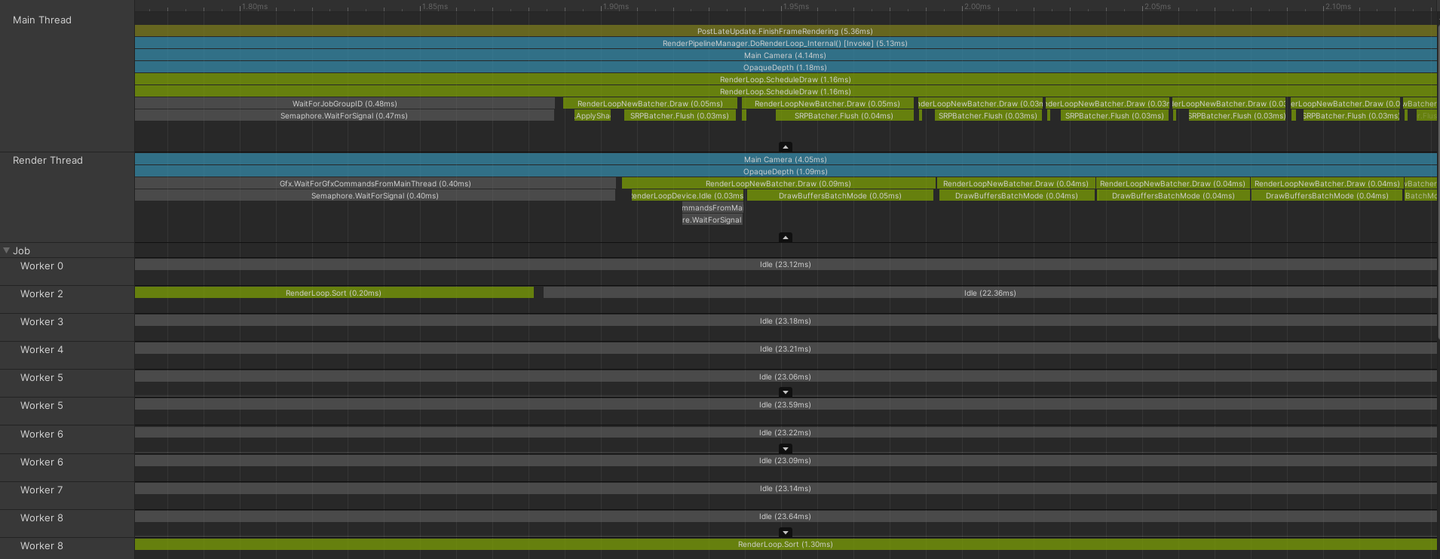
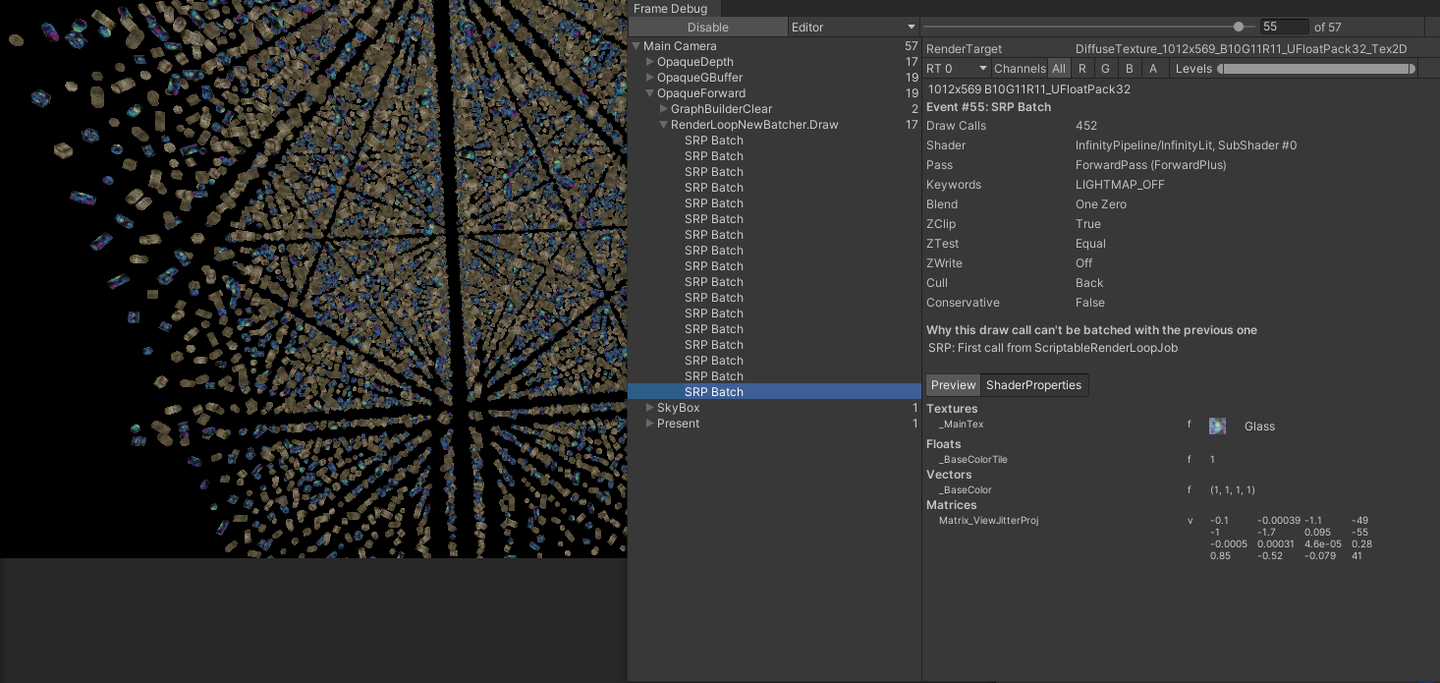
同一场景走 Unity 原生 DrawRenderers:SRP Batcher 合并了 PSO 切换,但 DrawCall 仍然每个 Batch 约 300-400 次,且每帧重新生成完整数据流,Culling + Batch Collection + Render Thread Submit 合计 9.5 ms。
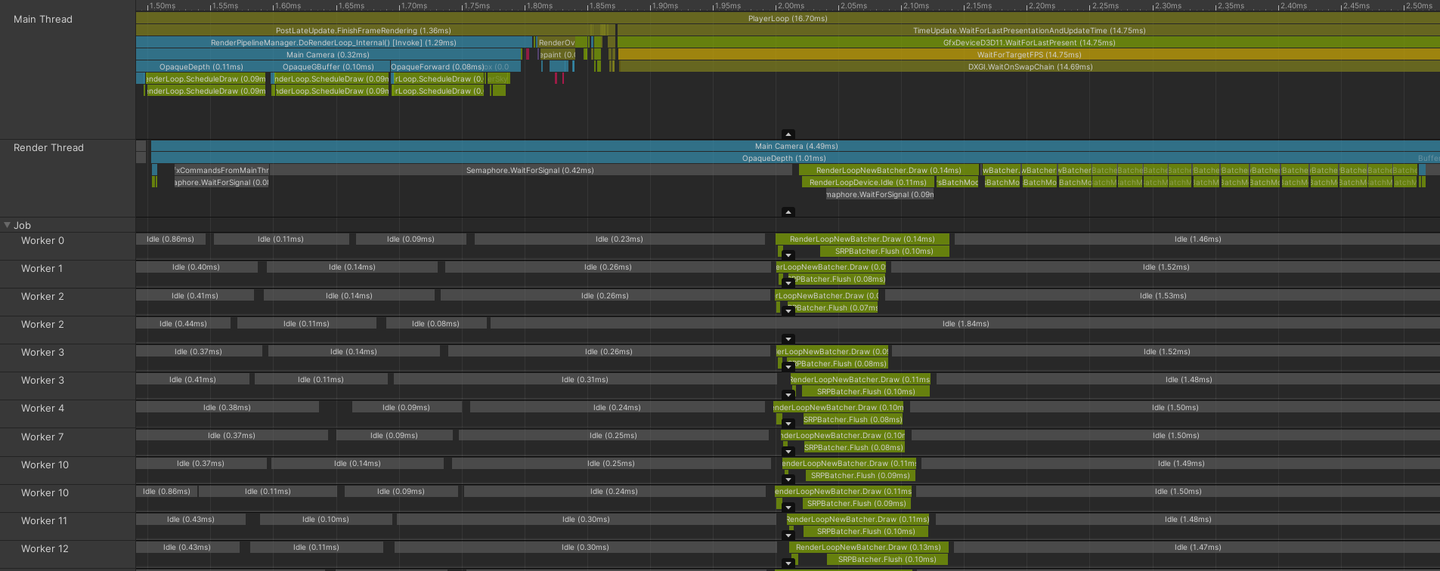
到渲染线程末尾为止,自定义实现 0.65 ms、原生 9.5 ms,约 15×;从帧率看,原生 55 FPS、自定义 970 FPS,约 18×。两个倍率不是矛盾,是测量粒度不同:Profiler 只覆盖 CPU 侧特定 Marker 区间,帧率包含 VSync Off 状态下 CPU 与 GPU 的完整管线,原生管线在 GPU 端还要额外承担 Command Processor 解析与状态切换的开销。
10.3 差异来源
| 阶段 | 原生管线 | 自定义管线 | 差异原因 |
|---|---|---|---|
| Culling | 1.2 ms | 0.06 ms | 消除回调链;连续内存上的标量 AABB 测试 |
| Data Copy | 2.8 ms | 0.01 ms | GPUScene 缓存,增量更新 |
| Batch Build | 2.5 ms | 0.22 ms | 无重复 Sort,线性 Batch 生成 |
| Render Thread | 3.0 ms | 0.36 ms | 36 DrawCall vs ~3000 DrawCall |
加速比随实例规模上升:
| 实例数量 | 原生 FPS | 自定义 FPS | 加速比 |
|---|---|---|---|
| 1000 | 420 | 4800+ | ~11× |
| 4000 | 130 | 2100 | ~16× |
| 8000 | 55 | 970 | ~18× |
| 16000 | 22 | 510 | ~23× |
| 32000 | 9 | 260 | ~29× |
两条路径的 culling 与 batch collection 都是 O(N),差距全在常数因子上。原生管线的常数因子来自回调链、Renderer 分散存储导致的 Cache Miss,以及每帧重跑的完整数据流;自定义管线的常数因子来自连续内存访问。N 增大时差距继续拉开,是因为原生管线的工作集随 N 超出 Cache 容量后 Cache Miss 比例非线性恶化,而连续访问模式在 prefetch 下保持线性。
10.4 待复测的指标
这套实现有自己的可观测点,但还没有一次把测试场景跑满并取数的记录:
| 指标 | 观测点 | 状态 |
|---|---|---|
| 剔除耗时(每 view 一次 cull) | MeshVisibilityUtility.CullInstances,job 以 Schedule(instanceCount, 256).Complete() 逐 view 同步等待 | 尚未实测 |
| filter + sort + build 总耗时 | MeshDrawPipeline.Schedule 内的 MeshPassFilterJob / MeshPassSortJob / MeshPassBuildJob | 尚未实测 |
| 模板缓存 hit / miss | MeshPipelineDiagnostics.TemplateCacheHits / TemplateCacheMisses | 计数器已实现,未取数 |
| 被跳过的 DrawList 构建数(含被 graph cull 的 request) | MeshPipelineDiagnostics.CulledPassSkippedBuilds,在 Schedule 被跳过与 culling 前置条件不成立时累加 | 计数器已实现,未取数 |
| 矩阵重复比 | MeshScene.MatrixDuplicateRatio(TransformCount / max(1, LogicalInstanceCount)),稳态目标 1.0 | 不变量有 EditMode 用例覆盖,运行时取值尚未实测 |
| GPU 溢出次数 | MeshPipelineDiagnostics.GpuOverflowCount,在分批失败、容量检查失败与 GPU 前置条件未过时累加 | 计数器已实现,未取数 |
补测的门槛不高:一次 Editor Play Mode 的 Profile 加一次 MeshPipelineDiagnostics.Snapshot() 就够,不需要推理。缺的是执行,不是方法。
值得单独记一条:这里的剔除是标量 Burst job(第 7.1 节),没有采用 4-wide SOA 加手写 SSE/NEON 映射,并在调用点同步 Complete()。这意味着剔除耗时直接落在 Acquire 的调用帧上,不与后续 filter job 重叠。它是可测量的,只是还没测,因此剔除耗时这一项不能沿用上面的 0.06 ms,即使规模相同。
十一、边界与现状
GPU Occlusion Culling、LOD、Skinned Mesh 与透明路径这四件事没有闭环。区分"设计上预留"和"代码里可用"只有一条判据:代码里有没有写入者。
11.1 GPU Occlusion Culling
视锥剔除只解决视锥外的部分。密集室内场景中,视锥内仍有大量被墙和其他物体挡住的实例,它们会完整走完 filter、sort、build 并最终进入 DrawCall。GPU 端遮挡剔除的做法是用上一帧的深度做一次保守测试,把这份集合预先压掉。
设计上分四步:
- 把上一帧 Depth Buffer 降采样成 HiZ 金字塔。Mip N 的每个 Texel 存对应 2^N × 2^N 区域的最远深度(Reverse-Z 下取 min),逐级以 8×8 numthreads 的 compute 生成。非 2 的幂次分辨率下边缘 2×2 采样会越界,用 clamp 采样器或边界检查复制最近有效 Texel,保证金字塔保守,否则越界处理不当会变成错误剔除,而不是漏剔除。
- 对每个实例的 AABB 做一次 screen-space quad 绘制,VS 把 8 个顶点投影到屏幕空间输出包围矩形,同时输出 AABB 最近点深度。
- PS 在 HiZ 上做保守深度测试。Mip 级别取
mip = ceil(log2(max(W, H))),使单个 HiZ Texel 覆盖整个 AABB 投影区域。更精确的做法是在选定 mip 上采样覆盖的全部 Texel(最多 2×2)取 min,多三次采样换掉因 mip 选大带来的过度保守。Reverse-Z 下objectMinDepth > hizDepth即判遮挡。 - 可见性结果落回 CPU 侧,在 pass filter 阶段额外检查,未通过的实例跳过绘制。
代价是延迟:深度来自上一帧,回读本身又要一帧,结果滞后两帧。相机快速移动时会出现已被剔除的物体短暂不可见的 Pop-in。缓解手段有两条:对刚进入视锥的实例强制标记可见,只对持续在视锥内的实例应用遮挡结果;或采用 Two-Phase:Phase 1 用上一帧结果绘制"确认可见"的集合并产生部分深度,Phase 2 用这份深度对被剔除者重测并在本帧补绘,把延迟压到 0,代价是 HiZ 生成与遮挡测试各跑一遍。
现状:mesh 路径没有闭环。 代码里确实有一个 HiZ pass,它建 HiZBuffer 纹理(R32_SFloat、useMipMap、autoGenerateMips = false、Point/Clamp),按 PyramidMipBatch 分批 dispatch,每批写 4 个 mip 的 UAV,并开了 EnableAsyncCompute(true)。但这个 pass 的消费者只有两个:屏幕空间反射与屏幕空间 GI,都在用它做加速步进。把 HiZBuffer 接到 MeshScene 的可见性上的代码不存在。
闭环需要的两半都不难定位。落点已经在:MeshInstanceCullingJob 在 6 平面测试之前先查 EMeshInstanceFlags.Visible,把遮挡结果写进 instance flags 就不需要改 filter job,也不需要给 MeshFilterProgram 加字段。缺的是回读:这里没有任何 AsyncGPUReadback 调用,"不做同帧可见数回读"是一条明确的约束,它同时也是 GPU 后端不读回 _VisibleCounts 的原因(第 8.2 节)。
11.2 LOD
MeshAsset 是为 LOD 准备的资产:meshes[]、materials[]、lODInfos[],每项 MeshLODInfo 带 screenSize 和 materialSlot[](该 LOD 用到的材质在 materials[] 中的下标)。Editor 侧有完整的采集链路:MeshAssetWizard : ScriptableWizard 调 MeshAsset.BuildMeshAsset,后者按 GameObject 上有没有 LODGroup 分两路:BuildMeshAssetFromLODGroup 遍历各级 LOD 收集 mesh 与 material,并按 screenSize = 1 - l * 0.125 生成阈值;BuildMeshAssetFromMeshRenderer 处理无 LOD 的普通物体,产生单级 screenSize = 1。采集结果打包进 FMesh Tree 代理。
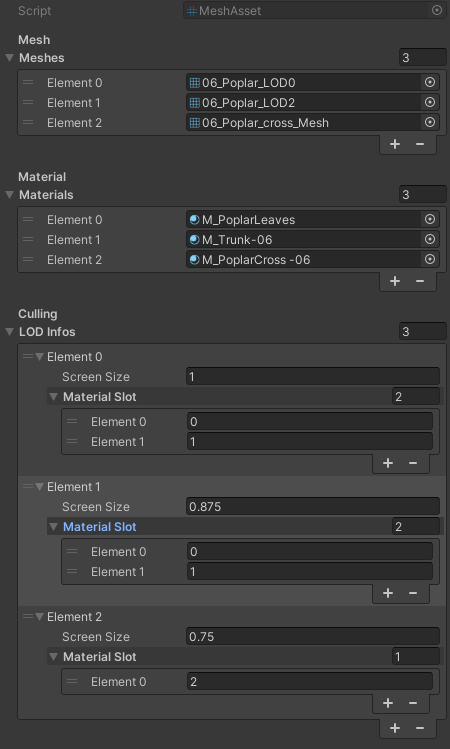
运行时没有消费者。 检索 lODInfos 与 FMesh 的全部引用,命中只出现在 MeshAsset 自身;MeshComponent 不持有 MeshAsset,它注册的是单个 Unity Mesh:
// 注册:按 submesh 逐条 CreateDraw
int subMeshCount = meshAsset.subMeshCount;
m_DrawIds = new MeshDrawId[subMeshCount];
int meshUnityId = UnityEntityId.ToInt32(meshAsset);
...
m_DrawIds[i] = update.CreateDraw(m_InstanceId, meshUnityId, i, ...);
没有 LOD 级别的选取逻辑,没有 screen size 估算,没有 hysteresis。MeshComponentEditor 里也没有对应的 LOD 字段。
接入点在设计上是留好的:切换 LOD 等价于换 CreateDraw 的 meshUnityId 并更新 geometryRevision,后者经 section.revision 传导到 MeshPassDrawCacheKey,模板自然 miss(第 7.6 节);排序 key 的 Mesh 段会变,但 sort job 不需要改。这是预留,不是功能;完整的 GPU LOD 选级尚未实现。
11.3 Skinned Mesh
EGeometrySourceKind 有四个值:IndexedMesh、SkinnedDeformed、Procedural、MeshletCluster。MeshInstanceRecord 也留了 deformationDataId 字段,MeshSceneUpdate.CreateInstance 有同名参数,默认 0。
SkinnedDeformed 是预留枚举,没有实现。MeshComponent 的两处注册(CreateInstance 与 CreateDraw)都硬编码 EGeometrySourceKind.IndexedMesh,从没有任何调用方传非零的 deformationDataId。一种常见做法是"给 Skinned 分配动态 Mesh Slot、每帧由 compute 写蒙皮后的 VB、localToWorld 固定为 Identity",这条路径在这里没有对应物。
现状是 seam only:接口留着,等地形与植被系统升级时再接。
11.4 透明路径
透明与不透明是两条互不重叠的路由,分界线是对象归属,不是 renderQueue。
不透明侧走 MeshDraw。 五个内建 pass 的 defaultFilter 全是 new MeshFilterProgram(0, 2999, ...),没有任何 pass 声明 EPassEligibility.Transparent 作为 requiredEligibility。
透明侧走 Unity RendererList。 RenderTranslucentDepth 与 RenderTranslucentColor 各建一个 RendererListDesc,renderQueueRange = InfinityRenderQueue.k_RenderQueue_AllTransparent,范围是 3000-3500(TransparentFirst = RenderQueue.Transparent,TransparentLast = Transparent + 500)。深度 prepass 用 SortingCriteria.QuantizedFrontToBack,颜色 pass 用 CommonTransparent,分 T0/T1/T2 三个 lightMode 分别在 fog、color pyramid 绑定上区分。执行体只有一行 cmdEncoder.DrawRendererList(passData.rendererList)。MeshScene 不覆盖这条路径,MeshDrawPipeline 也不参与。
MeshComponent 上的透明材质落在两路之外。 MeshComponent.BuildPassEligibility 读材质的 _SurfaceRoute 与 _TranslucentStage:_TranslucentStage > 0 时 eligibility 被置为单纯的 EPassEligibility.Transparent,不再叠加 Depth / GBuffer / Forward,也不叠加 Motion 和 Shadow。这条 draw 因此在全部五个 MeshDraw pass 的 filter 里都被拒:要么 renderQueue 越界(透明材质 queue ≥ 3000,filter 上限 2999),要么 requiredEligibility 不匹配。
而它进不了 RendererList:OnRegister 把同 GameObject 上的 MeshRenderer 设成 forceRenderingOff = true,MeshComponent 与 MeshRenderer 对 MeshDraw 与 RendererList 的归属是互斥的。Unity 的 CullingResults 不再包含这个 renderer,TranslucentPass 建的 RendererList 里也就没有它。
结论是:透明材质挂在 MeshComponent 上,当前既不进 MeshDraw 也不进 RendererList。这是通读调用链得到的判断。
因此 Forward 是 renderQueue 0-2999 的不透明 pass(shaderPassIndex = 3),不是处理透明混合的 pass;透明内容分 stage 走 TranslucentPass 的 RendererList。
十二、与地形、植被、多 Camera 的衔接
GPU Terrain。 一个 terrain chunk 落到 MeshScene 里的映射关系是明确的:chunk 注册为一个 MeshInstanceRecord,worldBounds 覆盖该 chunk 的世界范围;绘制侧一条 MeshDrawRecord,section 是那张共享的 grid mesh(meshUnityId + sectionIndex = 0),material 指向全局 terrain shader 的 MaterialDataRecord。
不同 LOD 级别的 grid 分辨率不同(LOD0 是 64×64、LOD1 是 32×32,以此类推),meshUnityId 也就不同,MeshSectionRecord 按 (meshUnityId, sectionIndex) 去重后各自成一条记录。切 LOD 等价于换掉 draw 的 meshUnityId 并递增 geometryRevision,revision 经 section.revision 进 MeshPassDrawCacheKey,模板自然 miss,这正是第 11.2 节说的那个接入点,运行时目前没有调用它。
有一处是 MeshScene 现在接不住的:chunk 的 UV offset 和 scale。Residency 的五缓冲分别是 transform、previous transform、bounds center、bounds extent、instance→transform 索引,全都是位置与包围信息,没有 per-instance 自定义参数的通道。地形要么给 Residency 加一条缓冲,要么把 offset/scale 编码进现有通道,后者会破坏 transform 的语义,不划算。分块策略、LOD morph 与 splatmap 的渲染不在 MeshPipeline 的职责范围内。
GPU Foliage。 LOD 的设计是同一套:Tree 的 LOD 和 MeshPipeline 的 LOD 都按实例在屏幕上的投影尺寸选级,阈值随 LOD 级别递减(MeshAsset 里 MeshLODInfo.screenSize = 1 - l * 0.125 就是 screenRadiusSqr 那套估算的资产侧形态)。但植被的绘制提交不走 MeshScene:它按 prototype 走 DrawMeshInstancedProcedural / DrawMeshInstancedIndirect 直接提交,不经过注册、filter、sort、build 与 MeshDrawCommand 合并。一个 TreePrototype 对应明确的 MeshAsset,分组在原型层面已经确定,再交给编译期自动合并没有收益。因此植被系统不消费第 7 章的任何一段,两者共享的只有 LOD 选取的判据。
规模问题也跟着变了位置。MeshScene 的剔除是 per-instance 单级(MeshInstanceCullingJob,第 7.1 节),没有 patch / cluster 层级。十万级实例进 MeshScene 意味着十万次 AABB 测试的线性扫描,这条路径既没有实现也没有实测;第 10 章的 0.06 ms / 8000 不能外推到这里,基线本身就不成立。是否引入两级剔除,取决于植被系统要不要走 MeshScene;按上一段,它现在不走。
多 Camera。 共享与独立的分界在 MeshScene 里是清楚的。场景侧的五类表是全场景共享的,cascade shadow camera、反射 probe camera 都不重建表;每 view 独立的是 culling 结果与编译结果。MeshVisibilityShare 按五成分签名(sceneId / viewKey / frustumHash / sceneVisibilityRevision / policyId)做帧内 interning,签名不同则各自 cull,filter / sort / build 的结果每 view 重建(第 7.6 节)。cascade 各级用 MakeCascadeViewKey(lightId, cascadeIndex) 区分,主 frustum、cascade、local shadow 用 policyId 区分。
并行是结构上的可能性,不是现状。MeshInstanceCullingJob 只写自己那一份 visibility 数组,多 view 之间没有数据竞争,可以一起调度;当前调用点是 Schedule(instanceCount, 256).Complete(),逐 view 同步等待(第 10.4 节),多 camera 的 cull 实际上是顺序执行的。改成批量 Acquire 需要把等待点往后挪,没做,收益也没测。
运行时状态的入口是 MeshPipelineDiagnostics.Snapshot(),取的是第 10.4 节那六个指标:剔除耗时、filter/sort/build 耗时、模板缓存 hit/miss、被跳过的 DrawList 构建数、矩阵重复比、GPU 溢出次数。计数器已经接好了,没有取过数。
多 Camera 的结构是活的(viewKey 与 policyId 参与 interning 签名),terrain 与 foliage 的接入都还没有写入者,和 11.2 / 11.3 的 LOD、Skinned 属于同一类状态。