

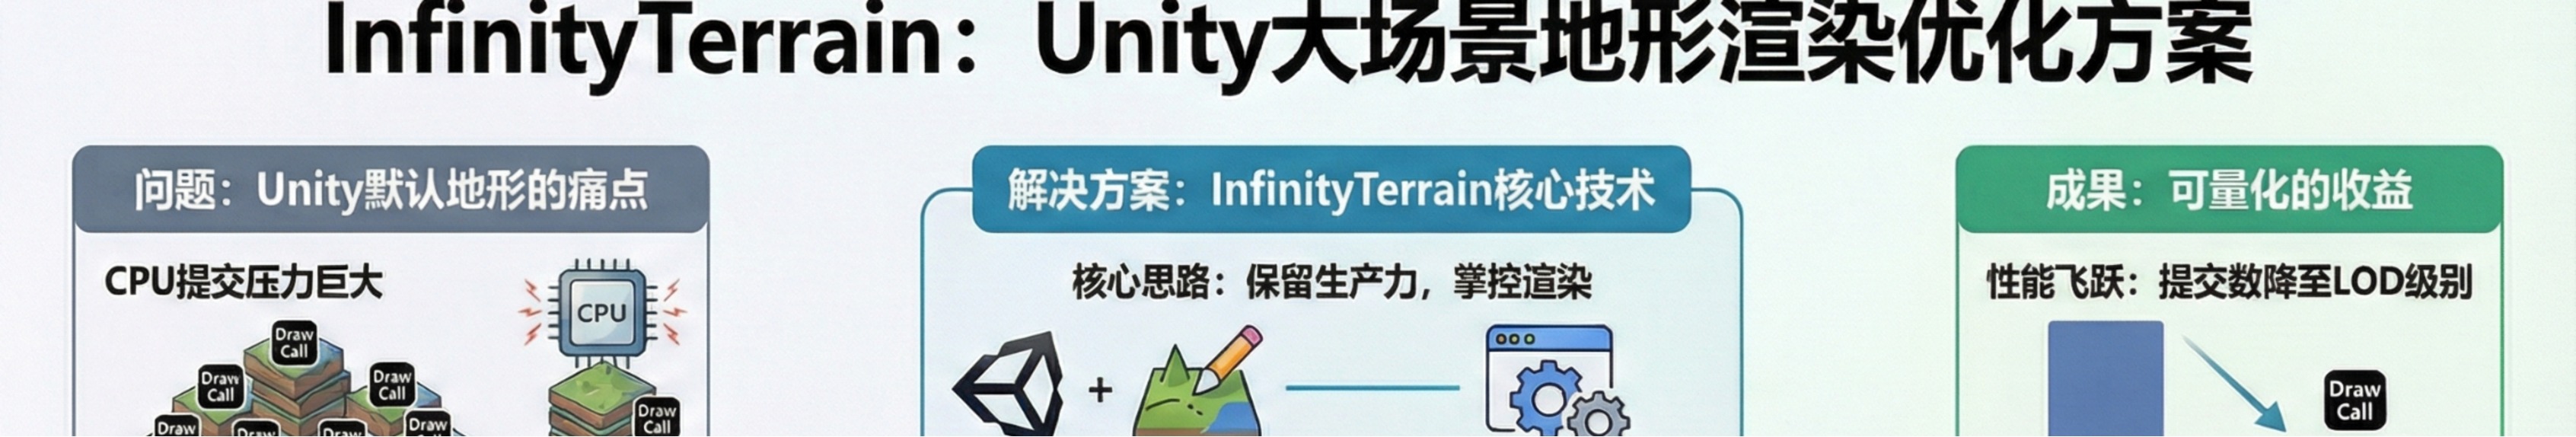
Unity Terrain 的 Authoring 工具链覆盖了 Heightmap 雕刻与导入、Splatmap 权重绘制、TerrainLayer 资源组织,以及植被、碰撞等生态配套。在内容生产阶段,这套工具链已经形成稳定流程,替换与协作成本都很高。
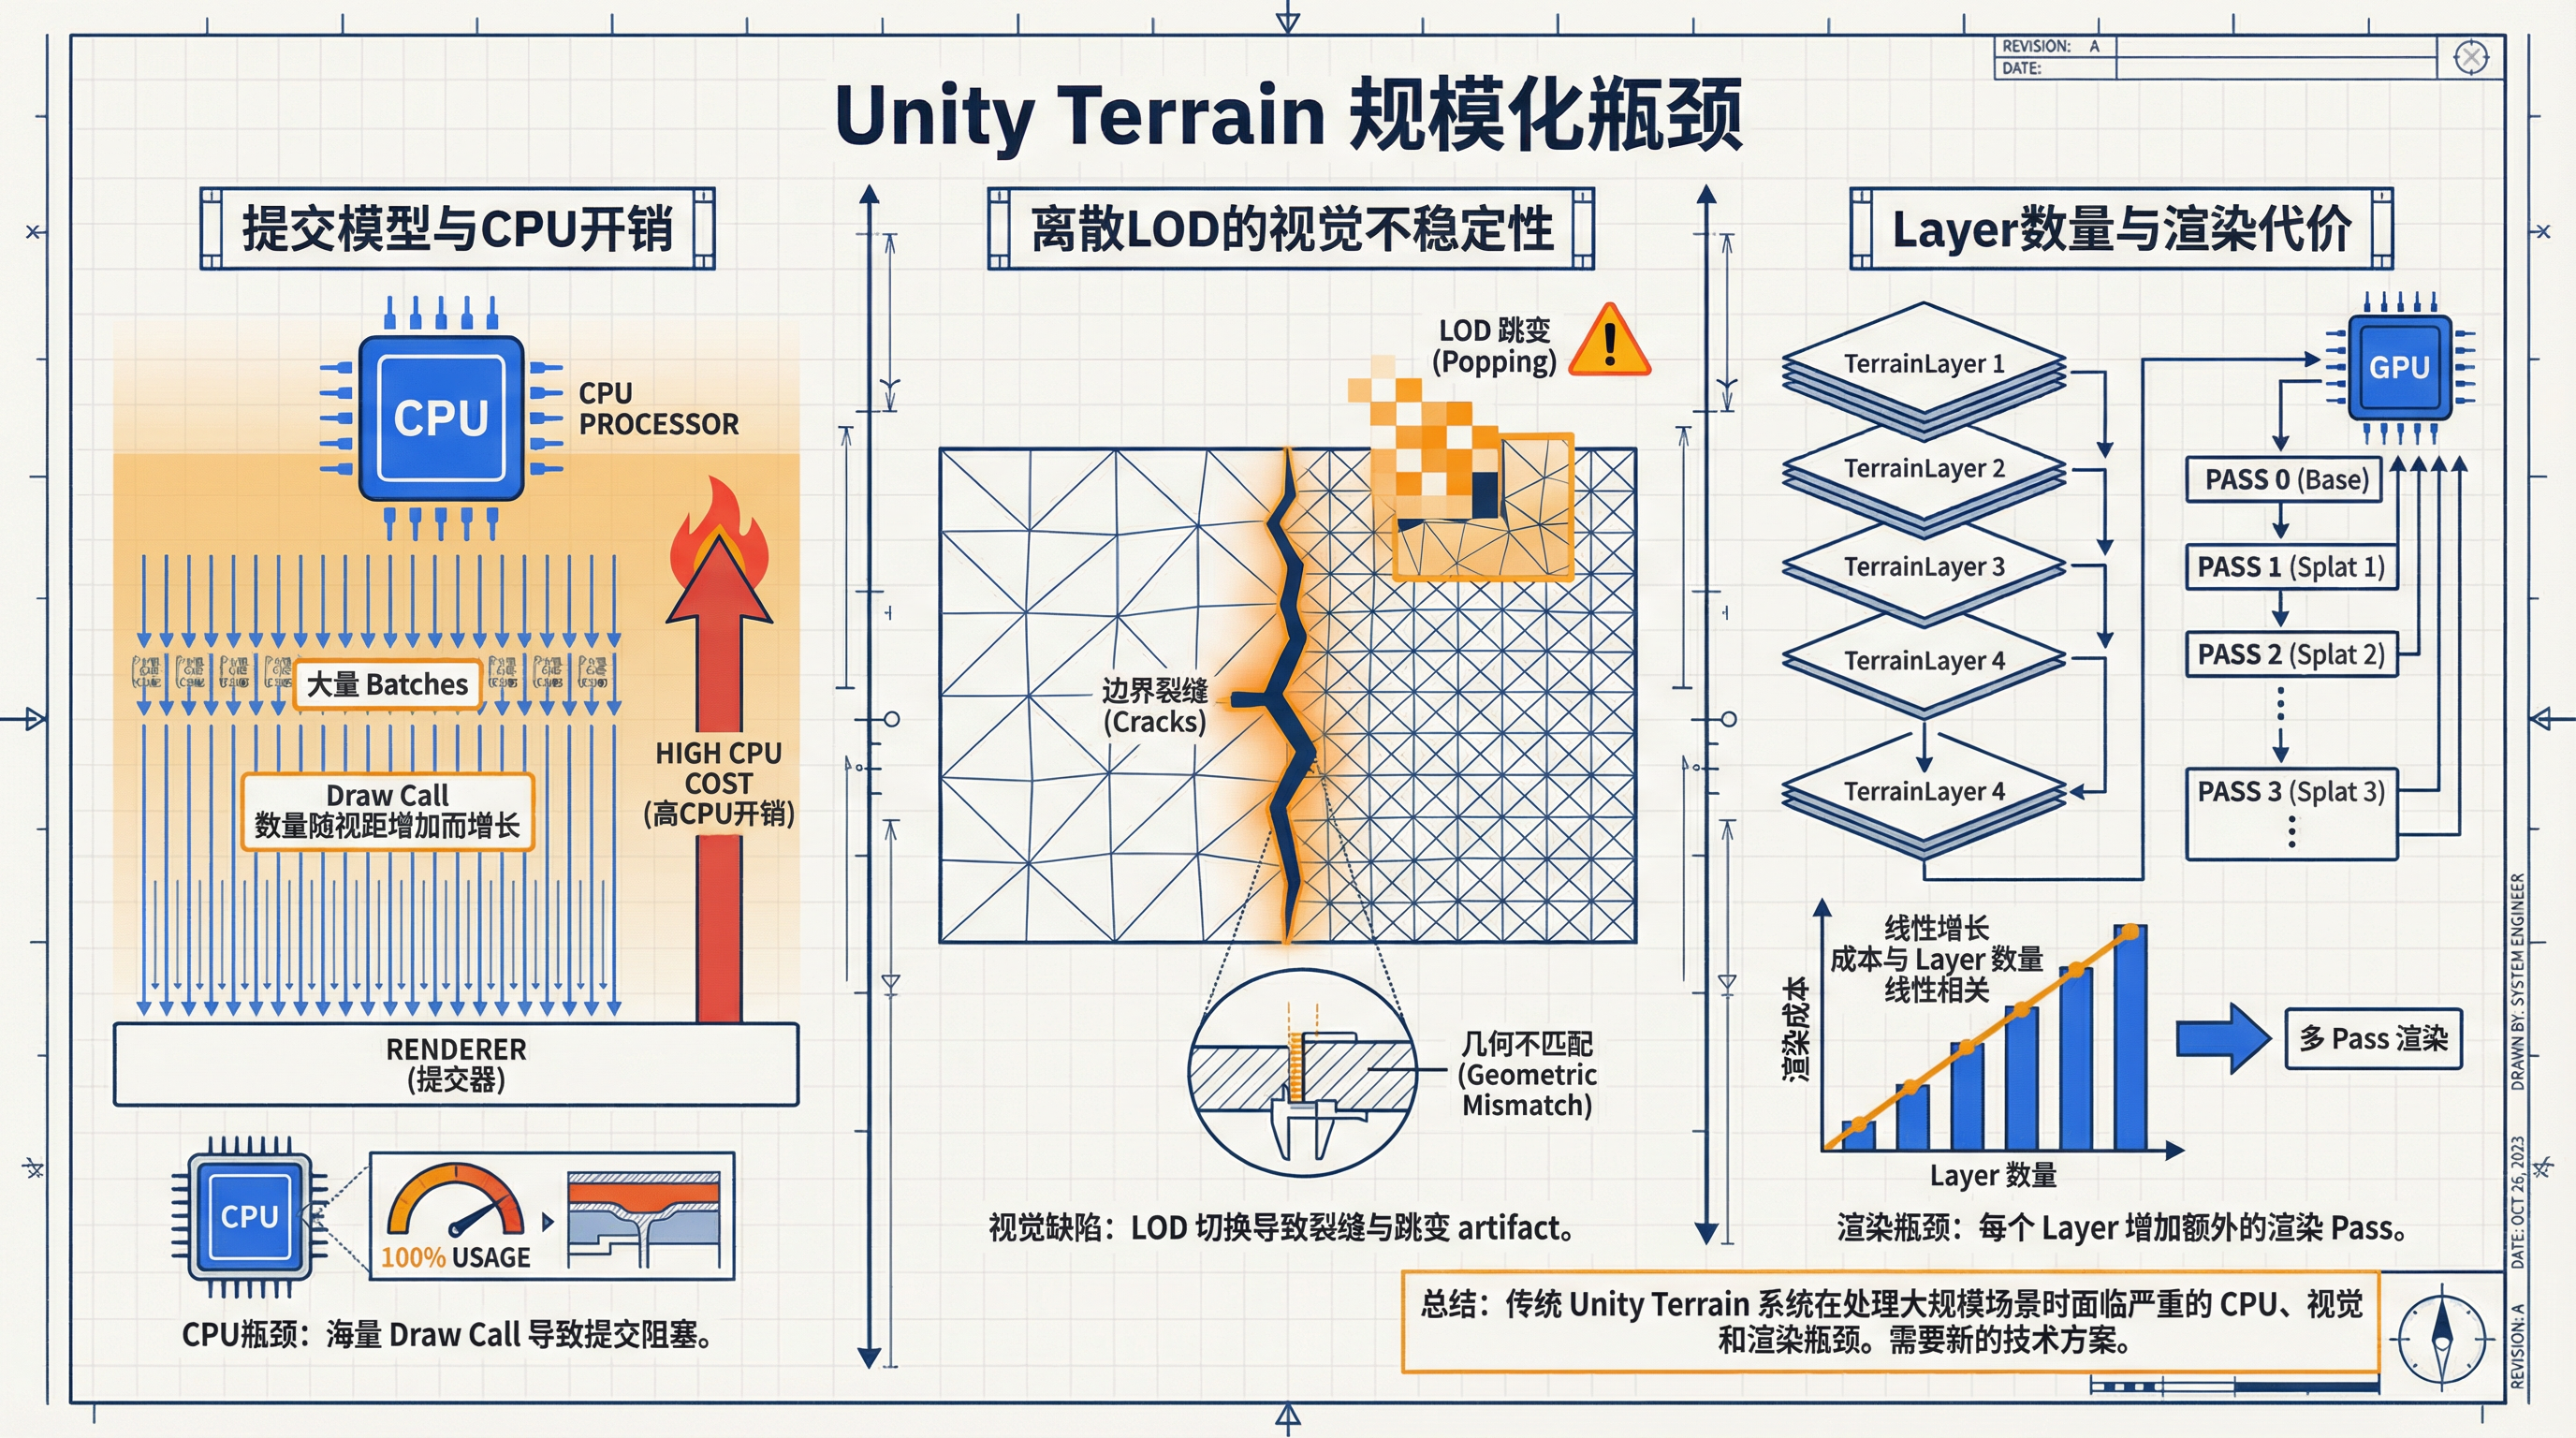
运行时的问题出在 Unity 默认的 Terrain Renderer 上。它的提交模型是 per-patch draw call:每个可见 patch 独立提交一次绘制,patch 数量随视距和 tile 拆分线性增长,没有 instancing 收敛机制。2018.3 版本引入的 instancing 缓解了部分场景的 draw call 压力,但在大世界多块 Terrain 并存时,可见 patch、植被与 detail 的数量仍会持续推高提交开销。LOD 方面,Unity 使用离散分块 LOD,相邻块 LOD 不同时边界会出现 T-junction 裂缝,相机移动时 LOD 切换产生明显 popping。TerrainLayer 数量在 URP/Built-in 下以 4 个为一组触发额外 pass,HDRP 单 pass 最多支持 8 个,超出部分直接被忽略。这些限制靠调参(Pixel Error、far clip、tile 拆分)只能缓解峰值,无法让提交数量与可见规模之间的关系变得可控。
做法是保留 Unity Terrain 作为 Authoring 与数据容器,替换掉它的渲染路径。InfinityTerrain 将地形渲染拆解为一组明确的数据定义与执行流程:规则分块、按 LOD 分组的 instancing 提交、基于邻接关系的连续 LOD 过渡。CPU 写入与 GPU 读取之间的字段含义、索引关系、尺寸约束与格式解码都是显式定义的,可验证、可调试、可迁移。
一、系统设计与分层
替换的只是渲染路径,Unity Terrain 的工具链能力全部保留:
Heightmap:雕刻与 RAW/R16 导入。
Splatmap/Alphamap:权重绘制与跨块无缝 painting。
TerrainLayer:表面纹理与参数的组织。
植被、碰撞:依赖 Terrain 的生态能力形成闭合工作流。
这些工具链对项目产能贡献明确,替换成本远高于改造渲染路径。另一条常见思路是直接换成 Mesh + HLOD,但那意味着重建整套内容生产工作流。InfinityTerrain 选择保留 Terrain 的生产链路,只接管 Runtime Rendering。
InfinityTerrain 围绕"大规模场景渲染的可预测性"定义设计目标。
1.1 系统目标
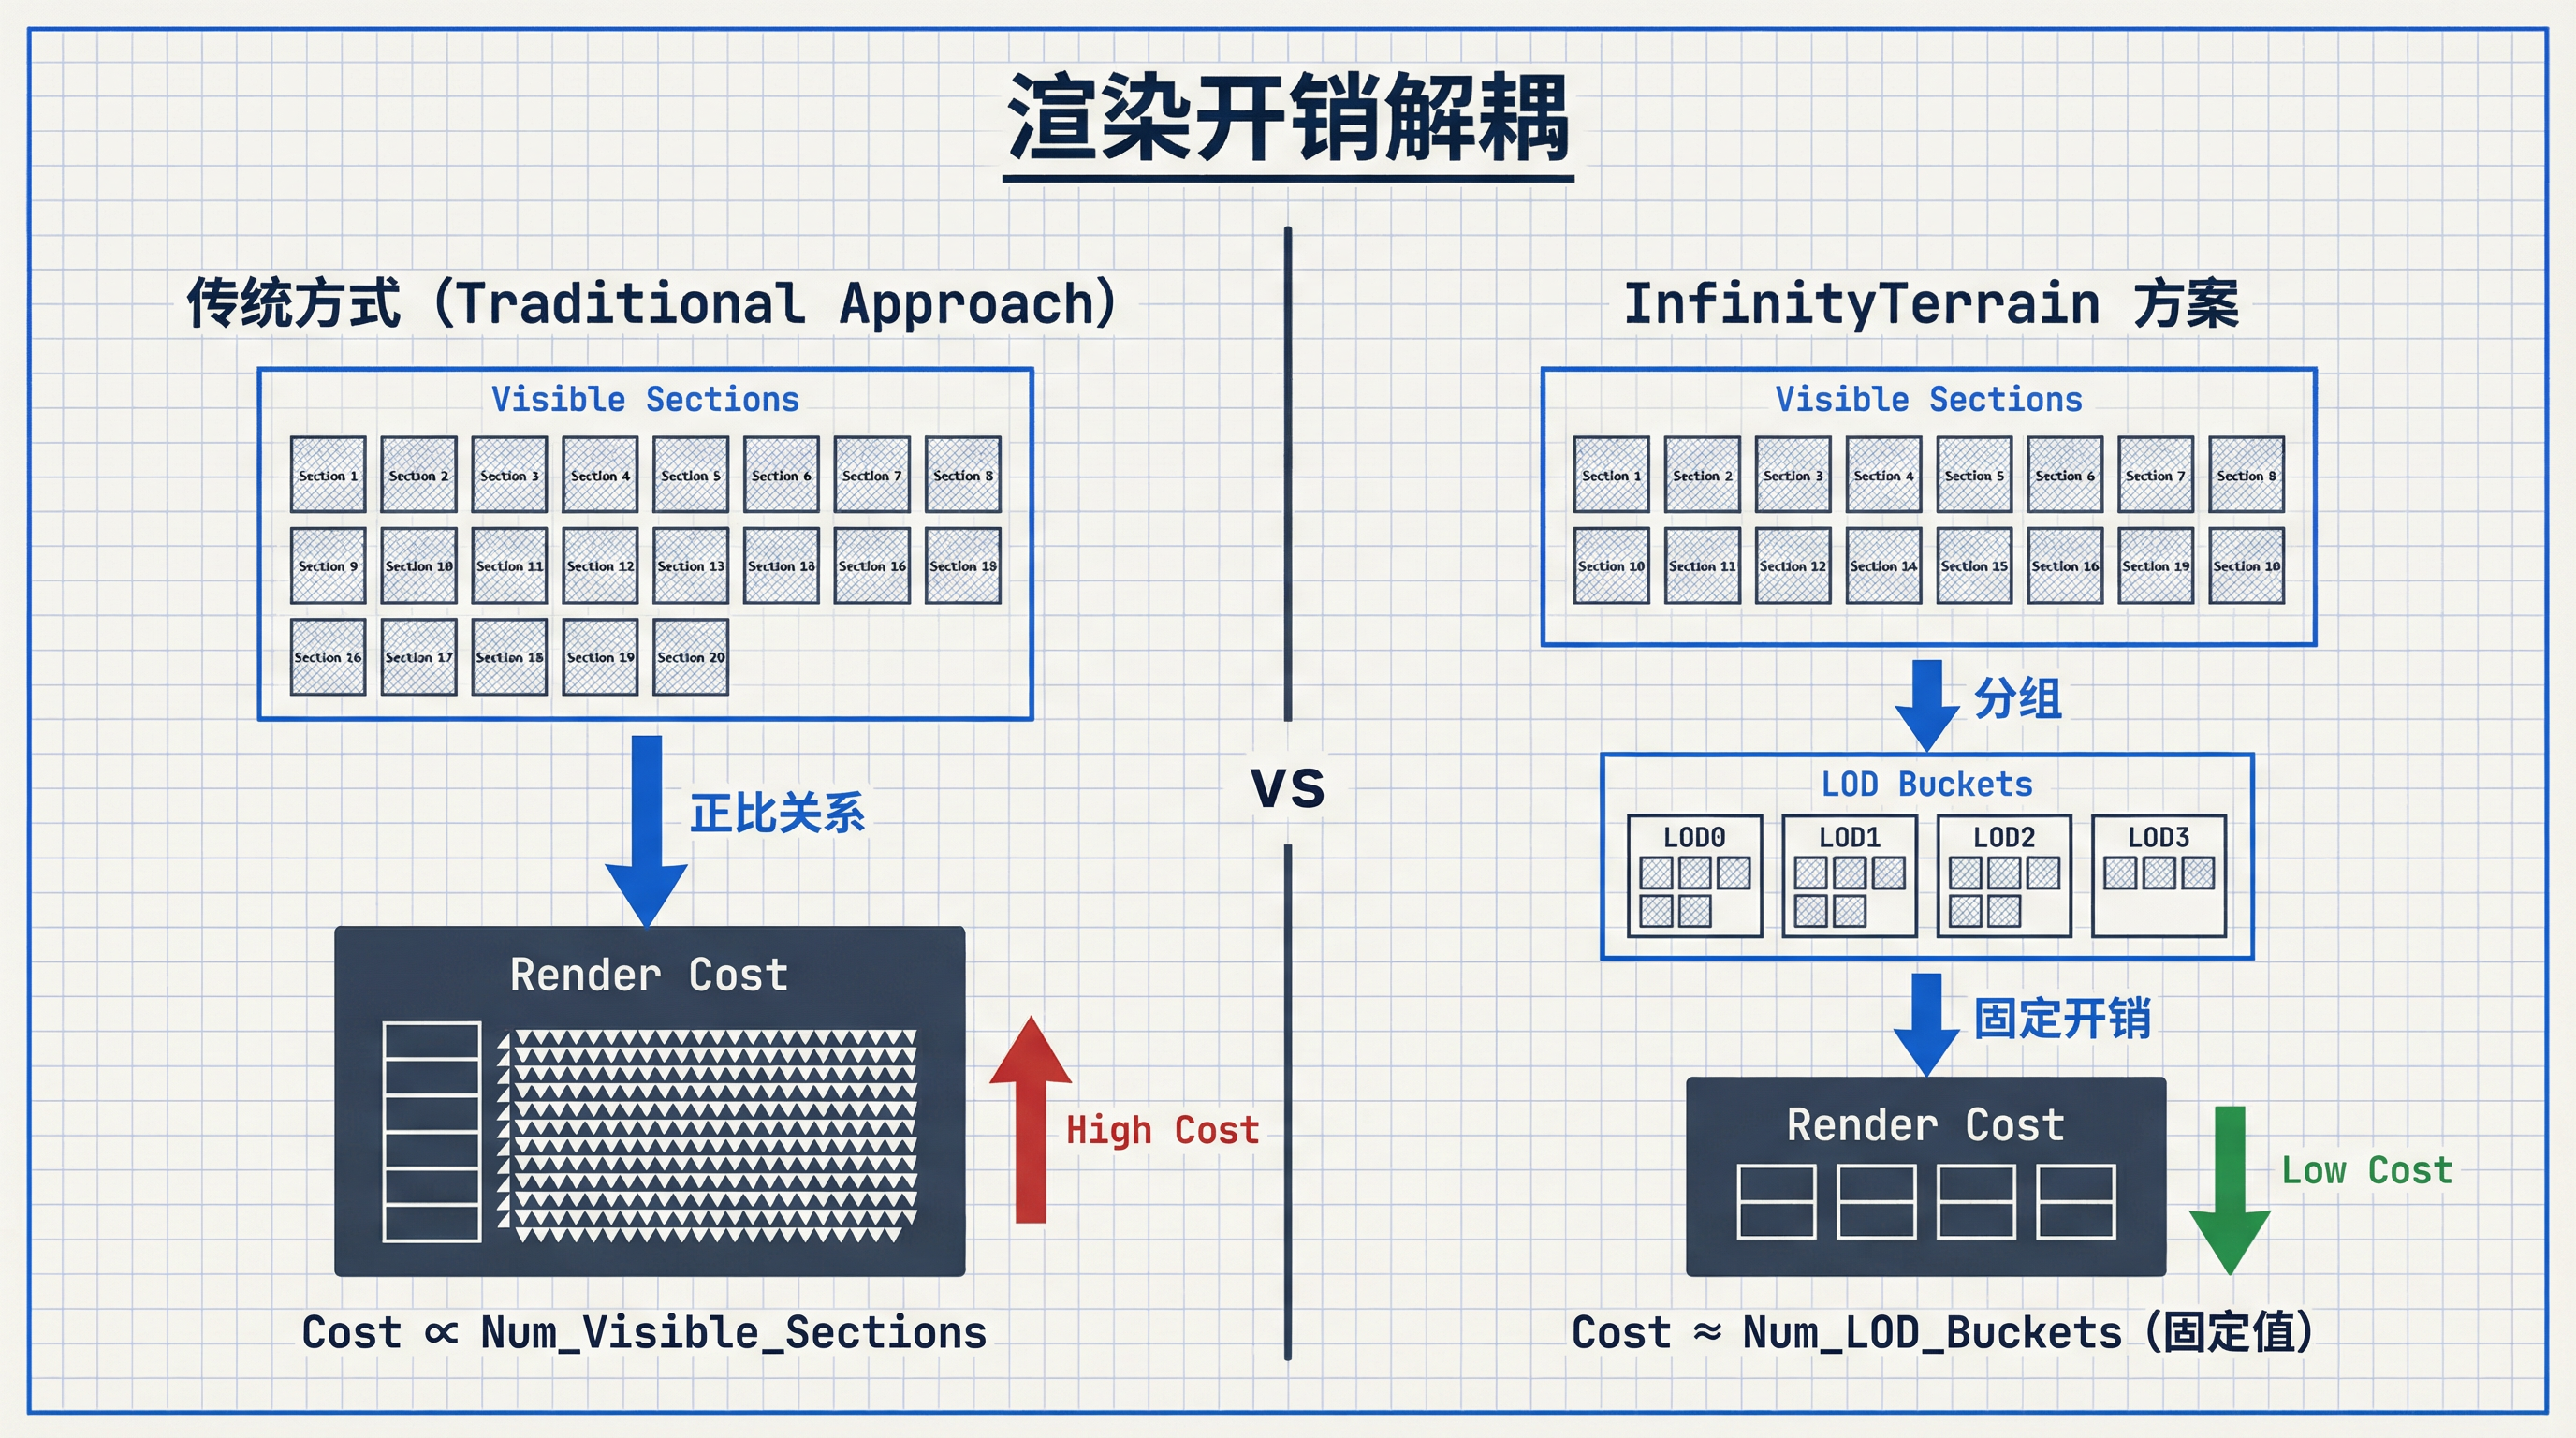
渲染提交数量与可见 Section 数量解耦,使提交上限主要由 LOD 桶数量决定。
在 vertex stage 实现连续 LOD 过渡,并在边界处保证几何连续性。
直接复用 TerrainData,包括 Heightmap、Normalmap、Alphamap 与 TerrainLayer。
支持多块 Terrain 并存时的资源汇聚与索引映射,以减少渲染状态切换。
核心逻辑不与 URP/HDRP/Built-in 绑定,相关差异收敛到独立的适配层。
1.2 设计范围约束
不替换 Unity Terrain 的 Authoring 工具链:保留 Unity 成熟的内容创作流程。
不强制依赖 GPU Culling 与 Indirect Draw:当前版本不要求 GPU Culling + Indirect Draw,这是后续的性能演进方向。
不提供无限 Layer 的实时混合:不承诺任意 Layer 组合都能自动正确渲染。
不默认支持任意 Transform:地形的旋转和非均匀缩放(non-uniform scaling)需要进行额外的适配工作,不作为默认支持的功能。
1.3 系统分层与职责划分
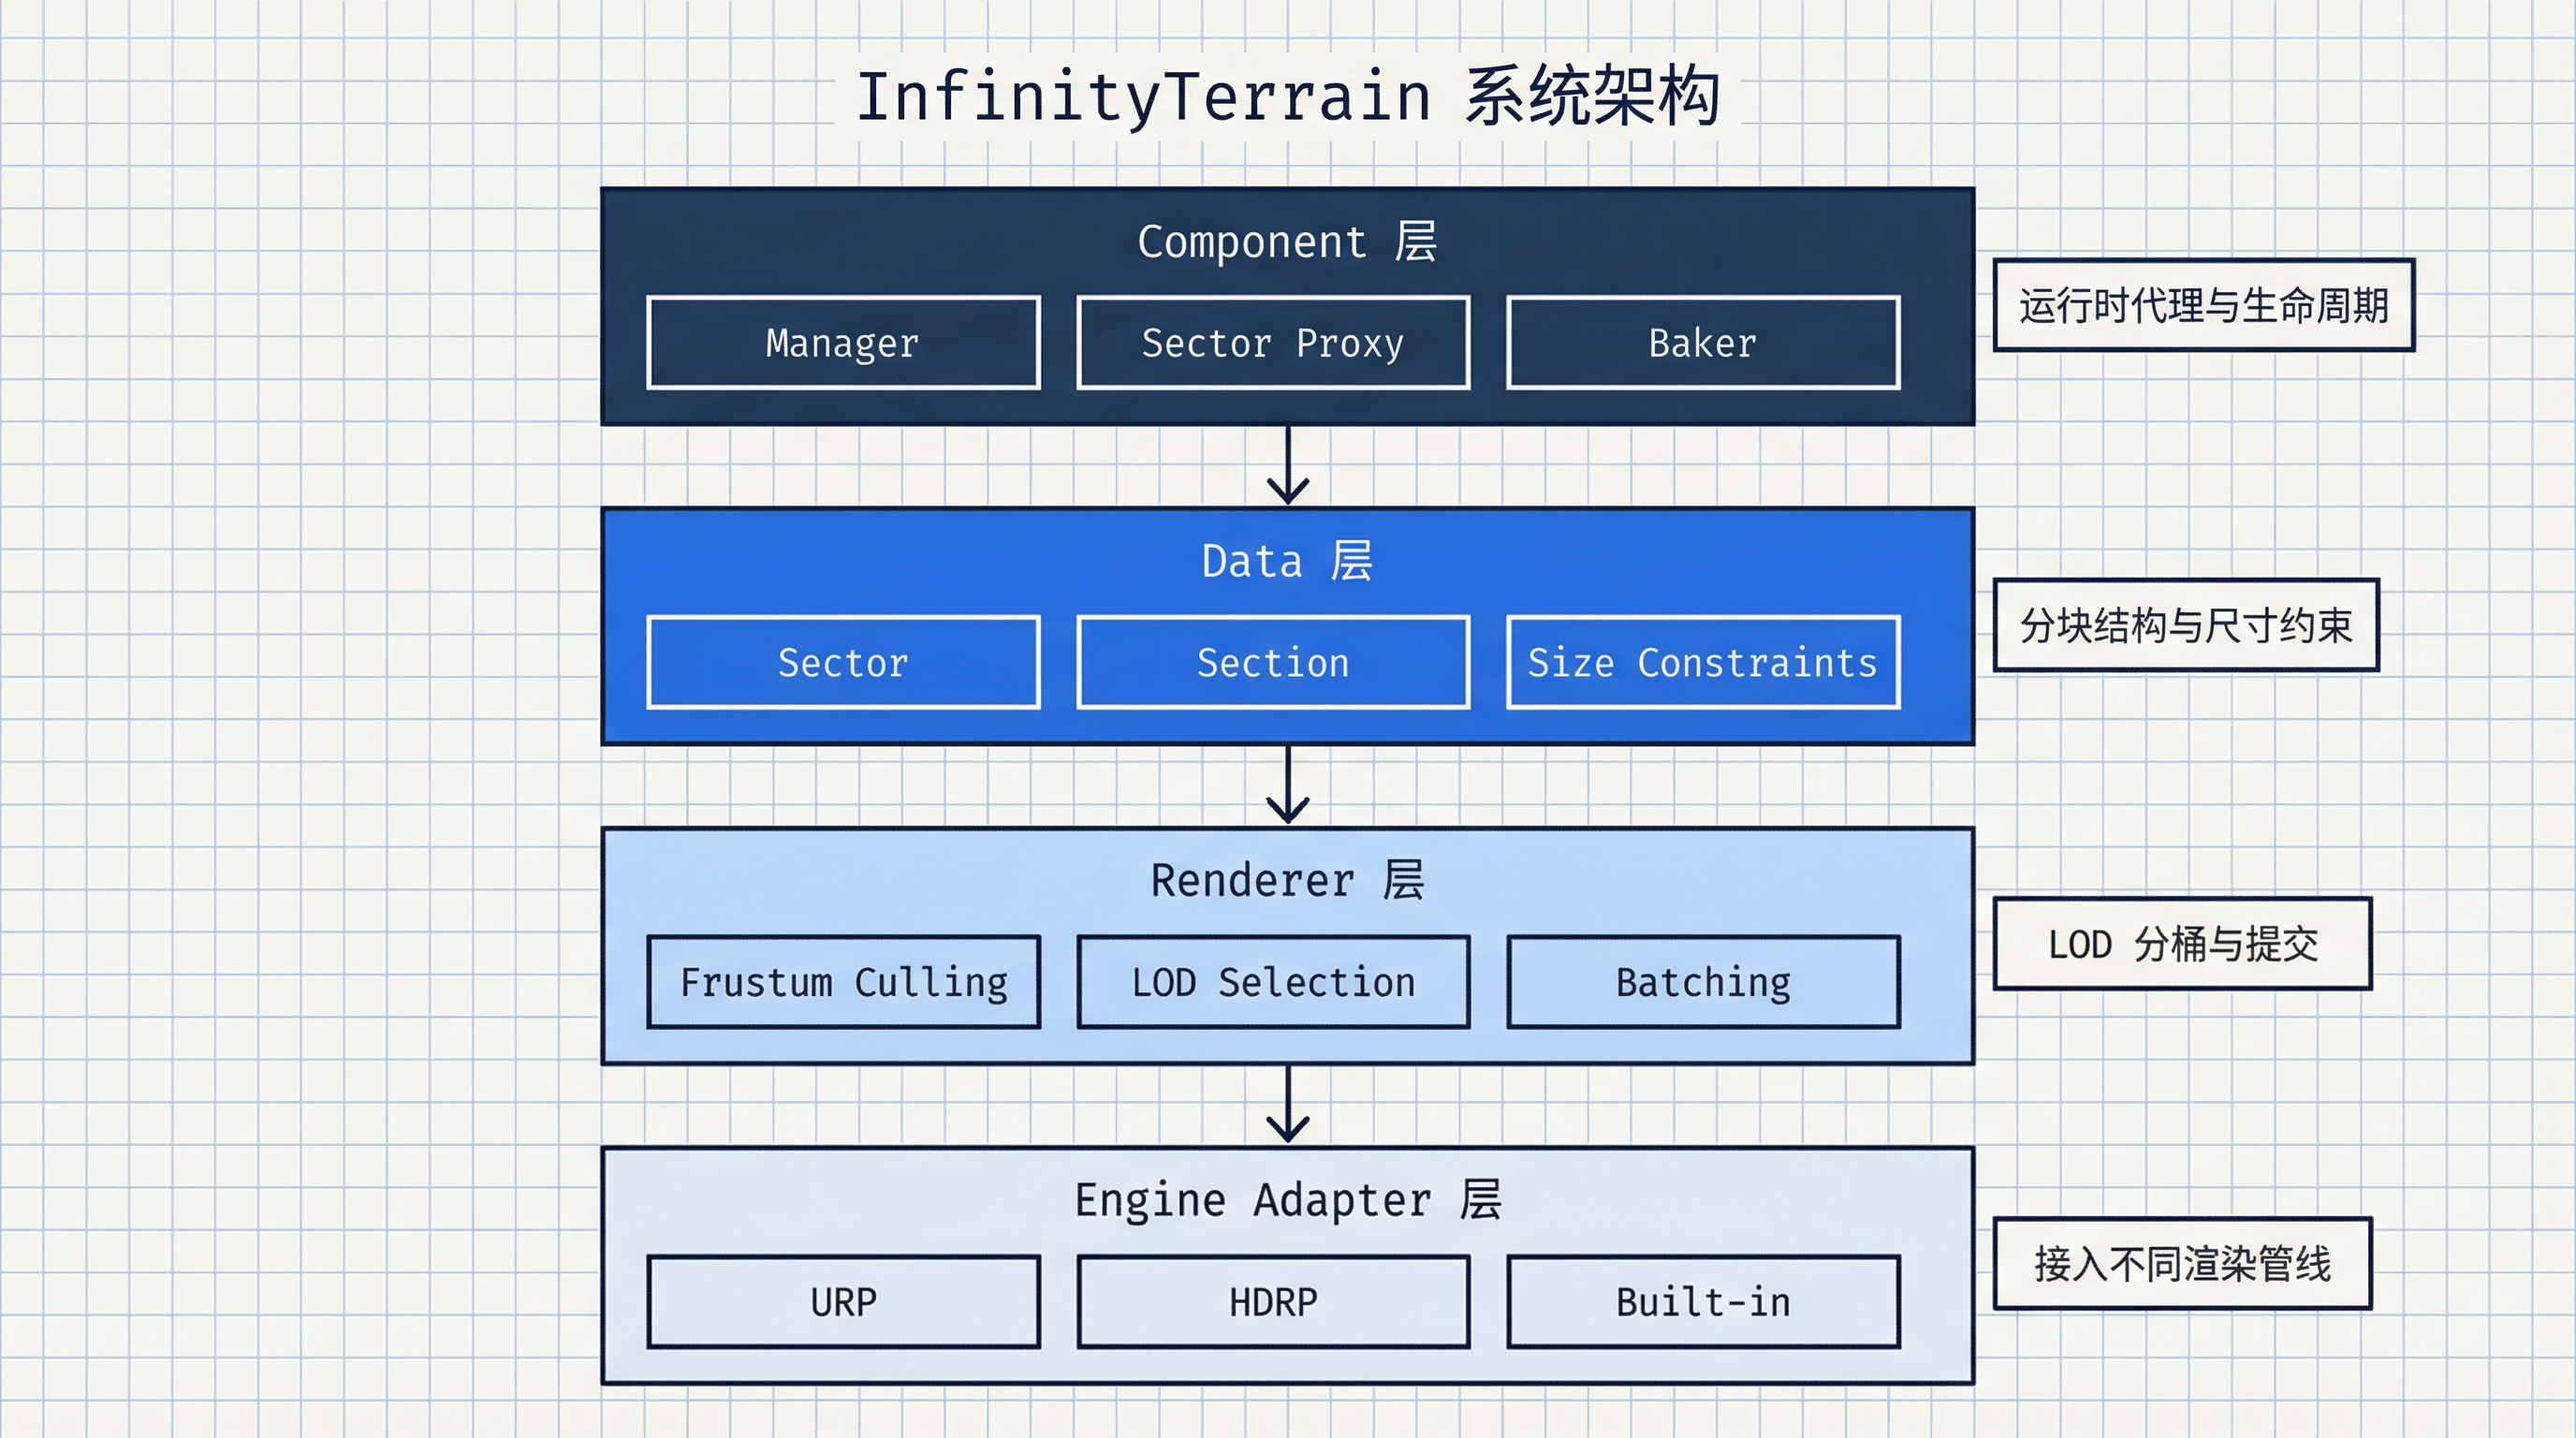
InfinityTerrain 的架构按职责拆分为四层:Component、Data、Renderer 和 Engine Adapter。
1.4 Component:运行时代理与生命周期
Component 层将 Unity Terrain 对象纳入 InfinityTerrain 的管理范围,提供可控的生命周期边界。
Manager:管理全局资源的生命周期,包括 Texture2DArray、ComputeBuffer、共享的 mesh template 和材质。同时,它维护着一系列关键的索引映射表,例如 TerrainLayer 的切片索引、Sector 的切片索引以及 Splatmap 的切片偏移量。
Sector Proxy:每个 Terrain 对象在运行时都对应一个 Sector Proxy 代理实例。该代理承载了地形分块结构的引用以及LOD参数、高度图缩放(Height scale)和资源索引范围等关键参数。Sector Proxy 的核心语义是作为 TerrainData 在运行时的实例入口。
Baker / Editor Utility:这部分工具集在编辑器环境下运行,负责生成可序列化的数据。其主要工作包括对 Terrain 进行 Section 切分、计算邻接关系以及修正 Bounds,从而避免在运行时执行高成本的计算或进行隐式的补偿操作。
1.5 Data:分块结构、邻接关系与尺寸约束
Data 层定义渲染系统的输入数据结构,并对尺寸关系施加硬性约束。
Sector:代表一个 TerrainData 在运行时的实例。
Section:Sector 的规则分块单元,是 culling、LOD 选择和 instancing 的最小粒度。
Size Constraints:一系列关于 TerrainSize、NumSection、SectionSize、LODCount 等参数的整数关系约束。这些约束用于保证 UV 坐标对齐与纹理采样的一致性。
尺寸关系的任何不一致都可能将错误传递并放大到渲染阶段,届时问题的定位成本会显著上升。因此这些约束是数据准备阶段必须满足的硬性前置条件。
1.6 Renderer:LOD 分桶、实例数据写入与提交
Renderer 层将"可见 Section 列表"转化为"按 LOD 分组的 instancing draw call"。
Section 粒度的 Frustum Culling:对每个 Section 执行视锥剔除。
LOD 选择:根据剔除结果和屏幕空间误差等因素,为每个可见 Section 计算输出 FractionLOD 与 LODIndex。
LOD 分桶:按 LODIndex 对可见 Section 进行分桶,生成实例数据列表并将其顺序写入一个 ComputeBuffer 中。
提交绘制:为每个 LOD 桶提交一次 instancing draw call。
当前版本采用直接实例化(DrawMeshInstancedProcedural)。GPU Culling 与 Indirect Draw 是后续演进方向,不影响当前版本的功能闭环。
1.7 Engine Adapter:接入不同 Render Pipeline
Engine Adapter 层封装不同渲染管线的接入差异,使核心逻辑保持管线无关。
SRP (URP/HDRP):在可编程渲染管线中,常用的接入点是 ScriptableRendererFeature 或 CustomPass。
Built-in:在内置渲染管线中,通常需要围绕 Camera 对象、CommandBuffer 以及渲染事件的执行顺序来组织渲染逻辑。
核心模块只暴露资源绑定、实例数据写入和 draw call 提交接口,不感知底层管线细节。
二、数据定义与执行路径
InfinityTerrain 的稳定性源于明确的数据定义,而非运行时推断。多块 Terrain 的纹理资源汇聚为数组资源,通过索引访问以降低状态切换压力,并为每个 Section 定义了清晰的实例数据布局。
2.1 资源组织:Texture2DArray 与索引映射
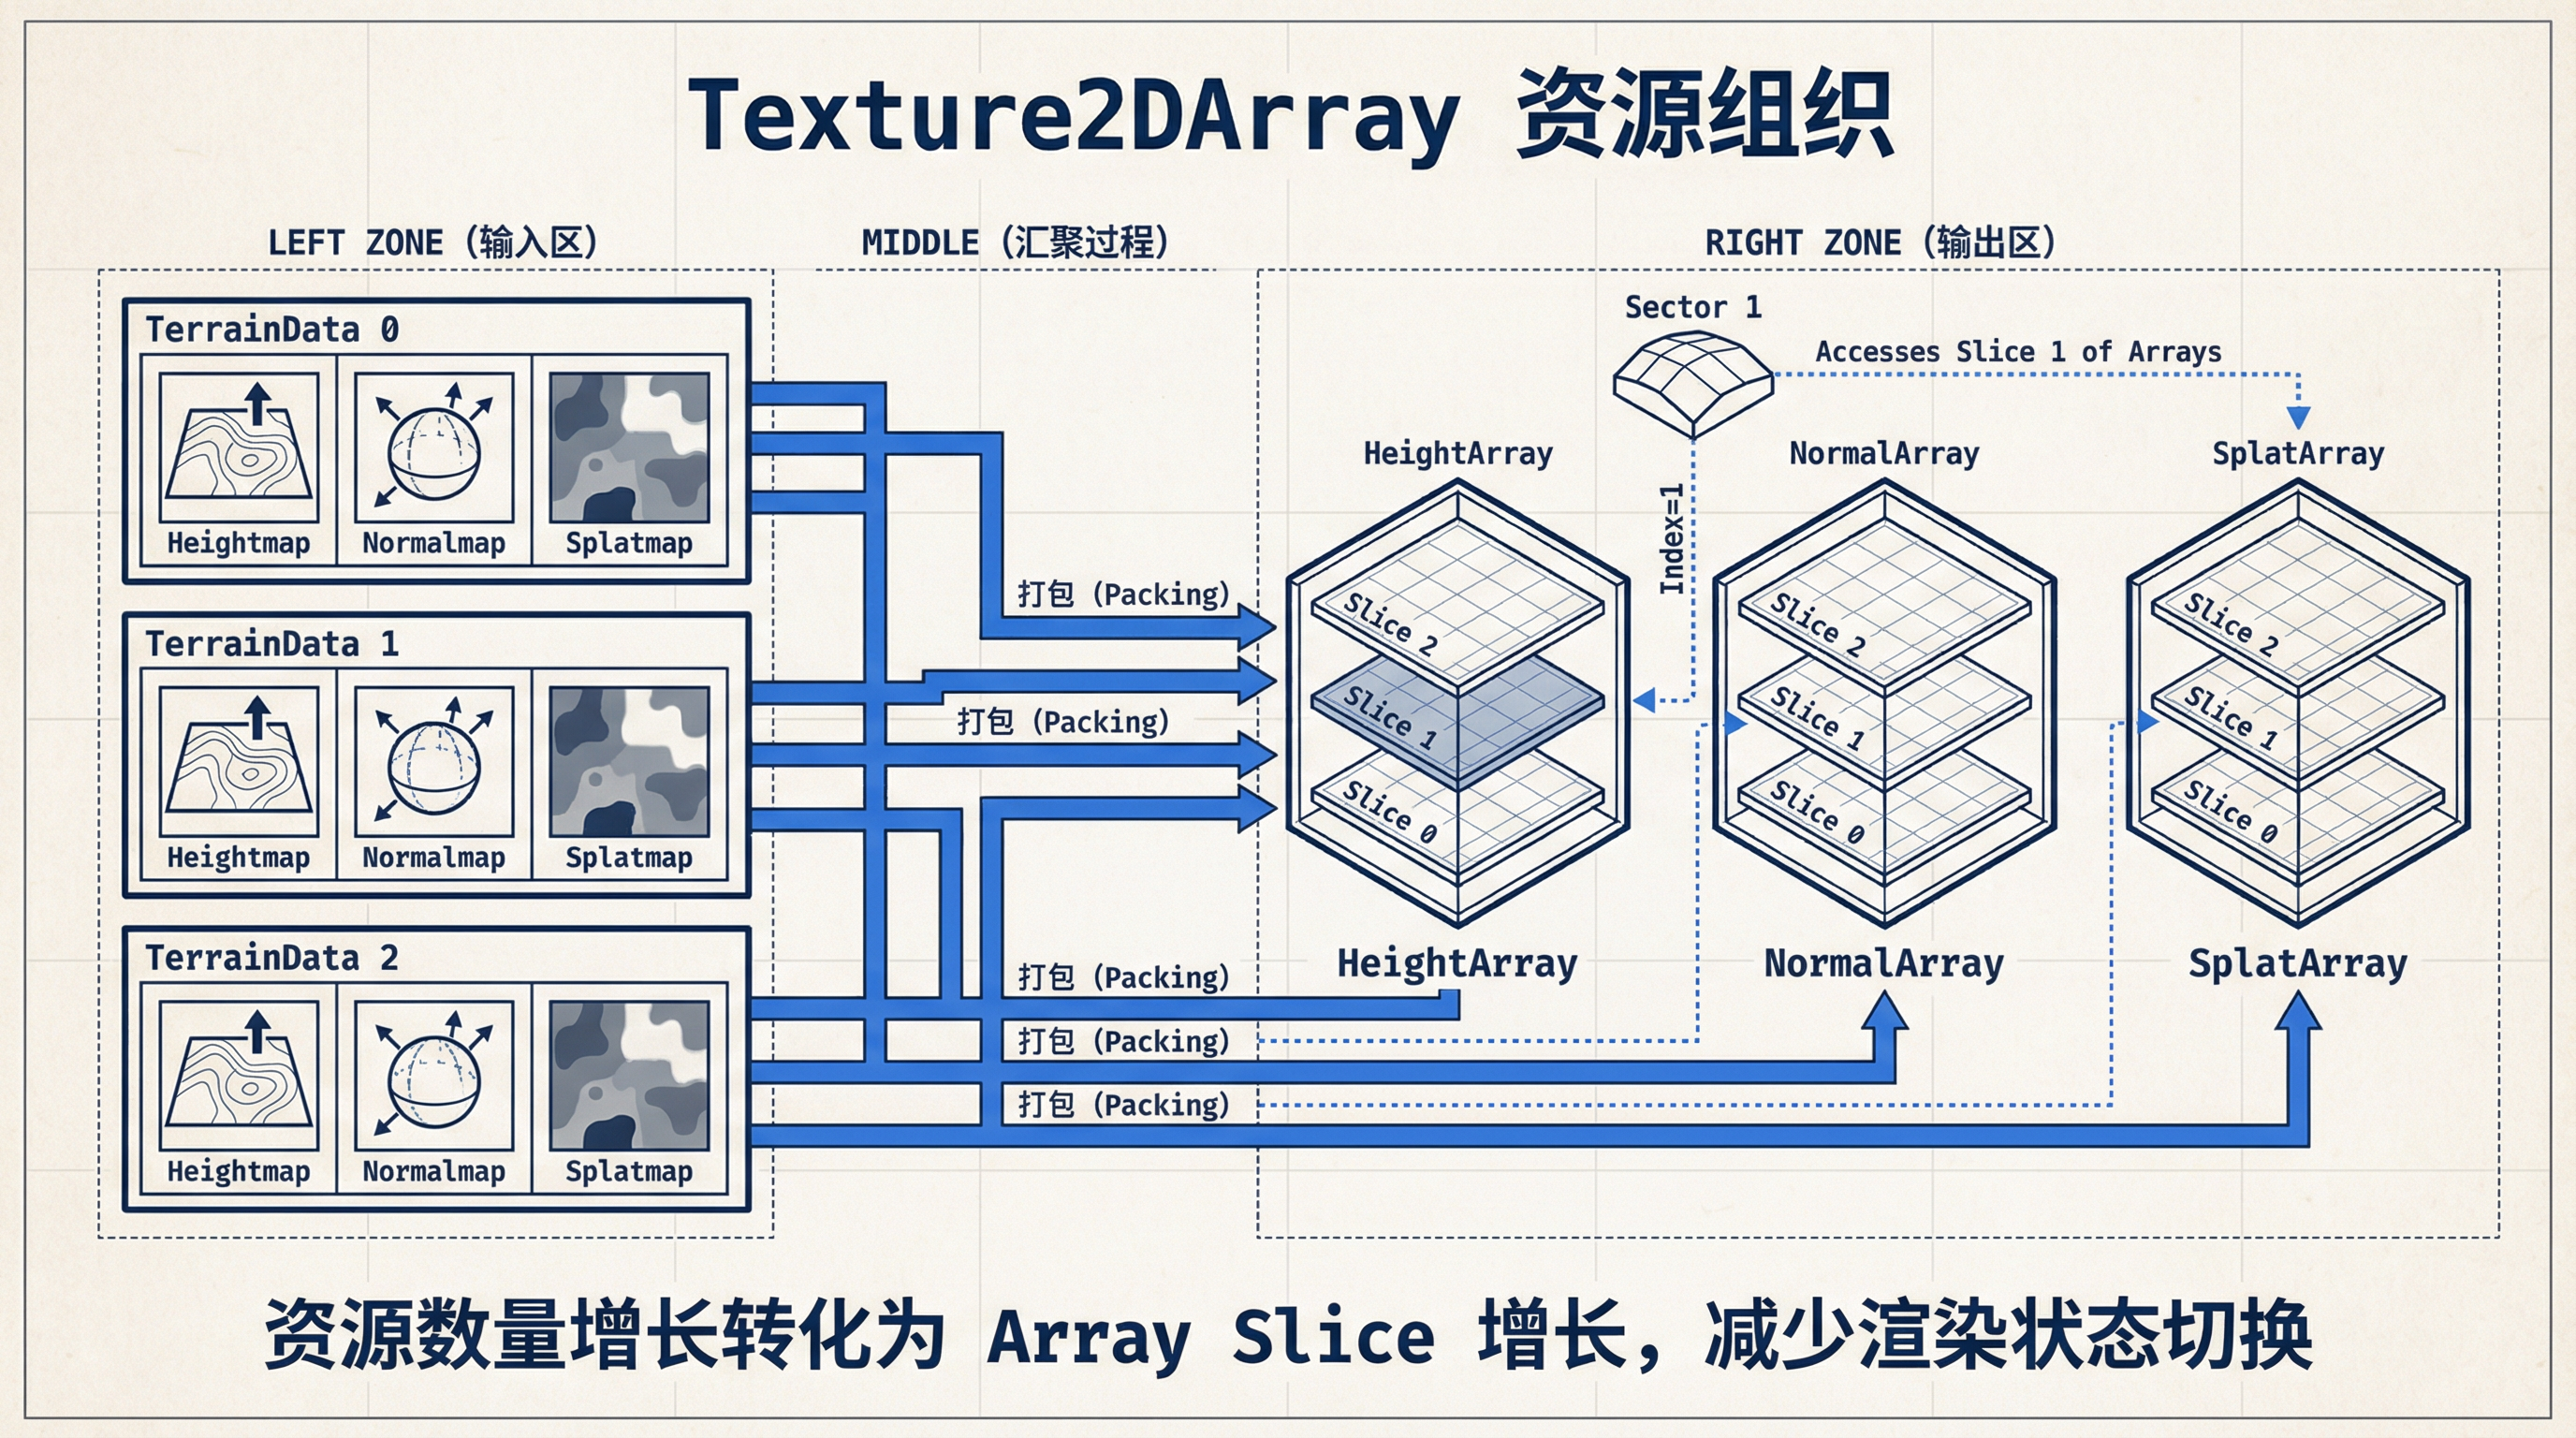
HeightArray:每个 Sector 对应一个 slice。
Normal/TangentArray:每个 Sector 对应一个 slice。
SplatArray:按照 alphamap 顺序打包;每个 Sector 持有 SplatmapIndex + SplatmapCount。
AlbedoArray / NormalArray:每个 TerrainLayer 对应一个 slice;维护 TerrainLayer → LayerSliceIndex 映射。
这种组织方式将资源数量的增长转化为 array slice 的增长。Shader 侧通过索引访问,Renderer 侧减少材质与纹理的绑定频率。
2.2 每个 Section 的实例数据布局
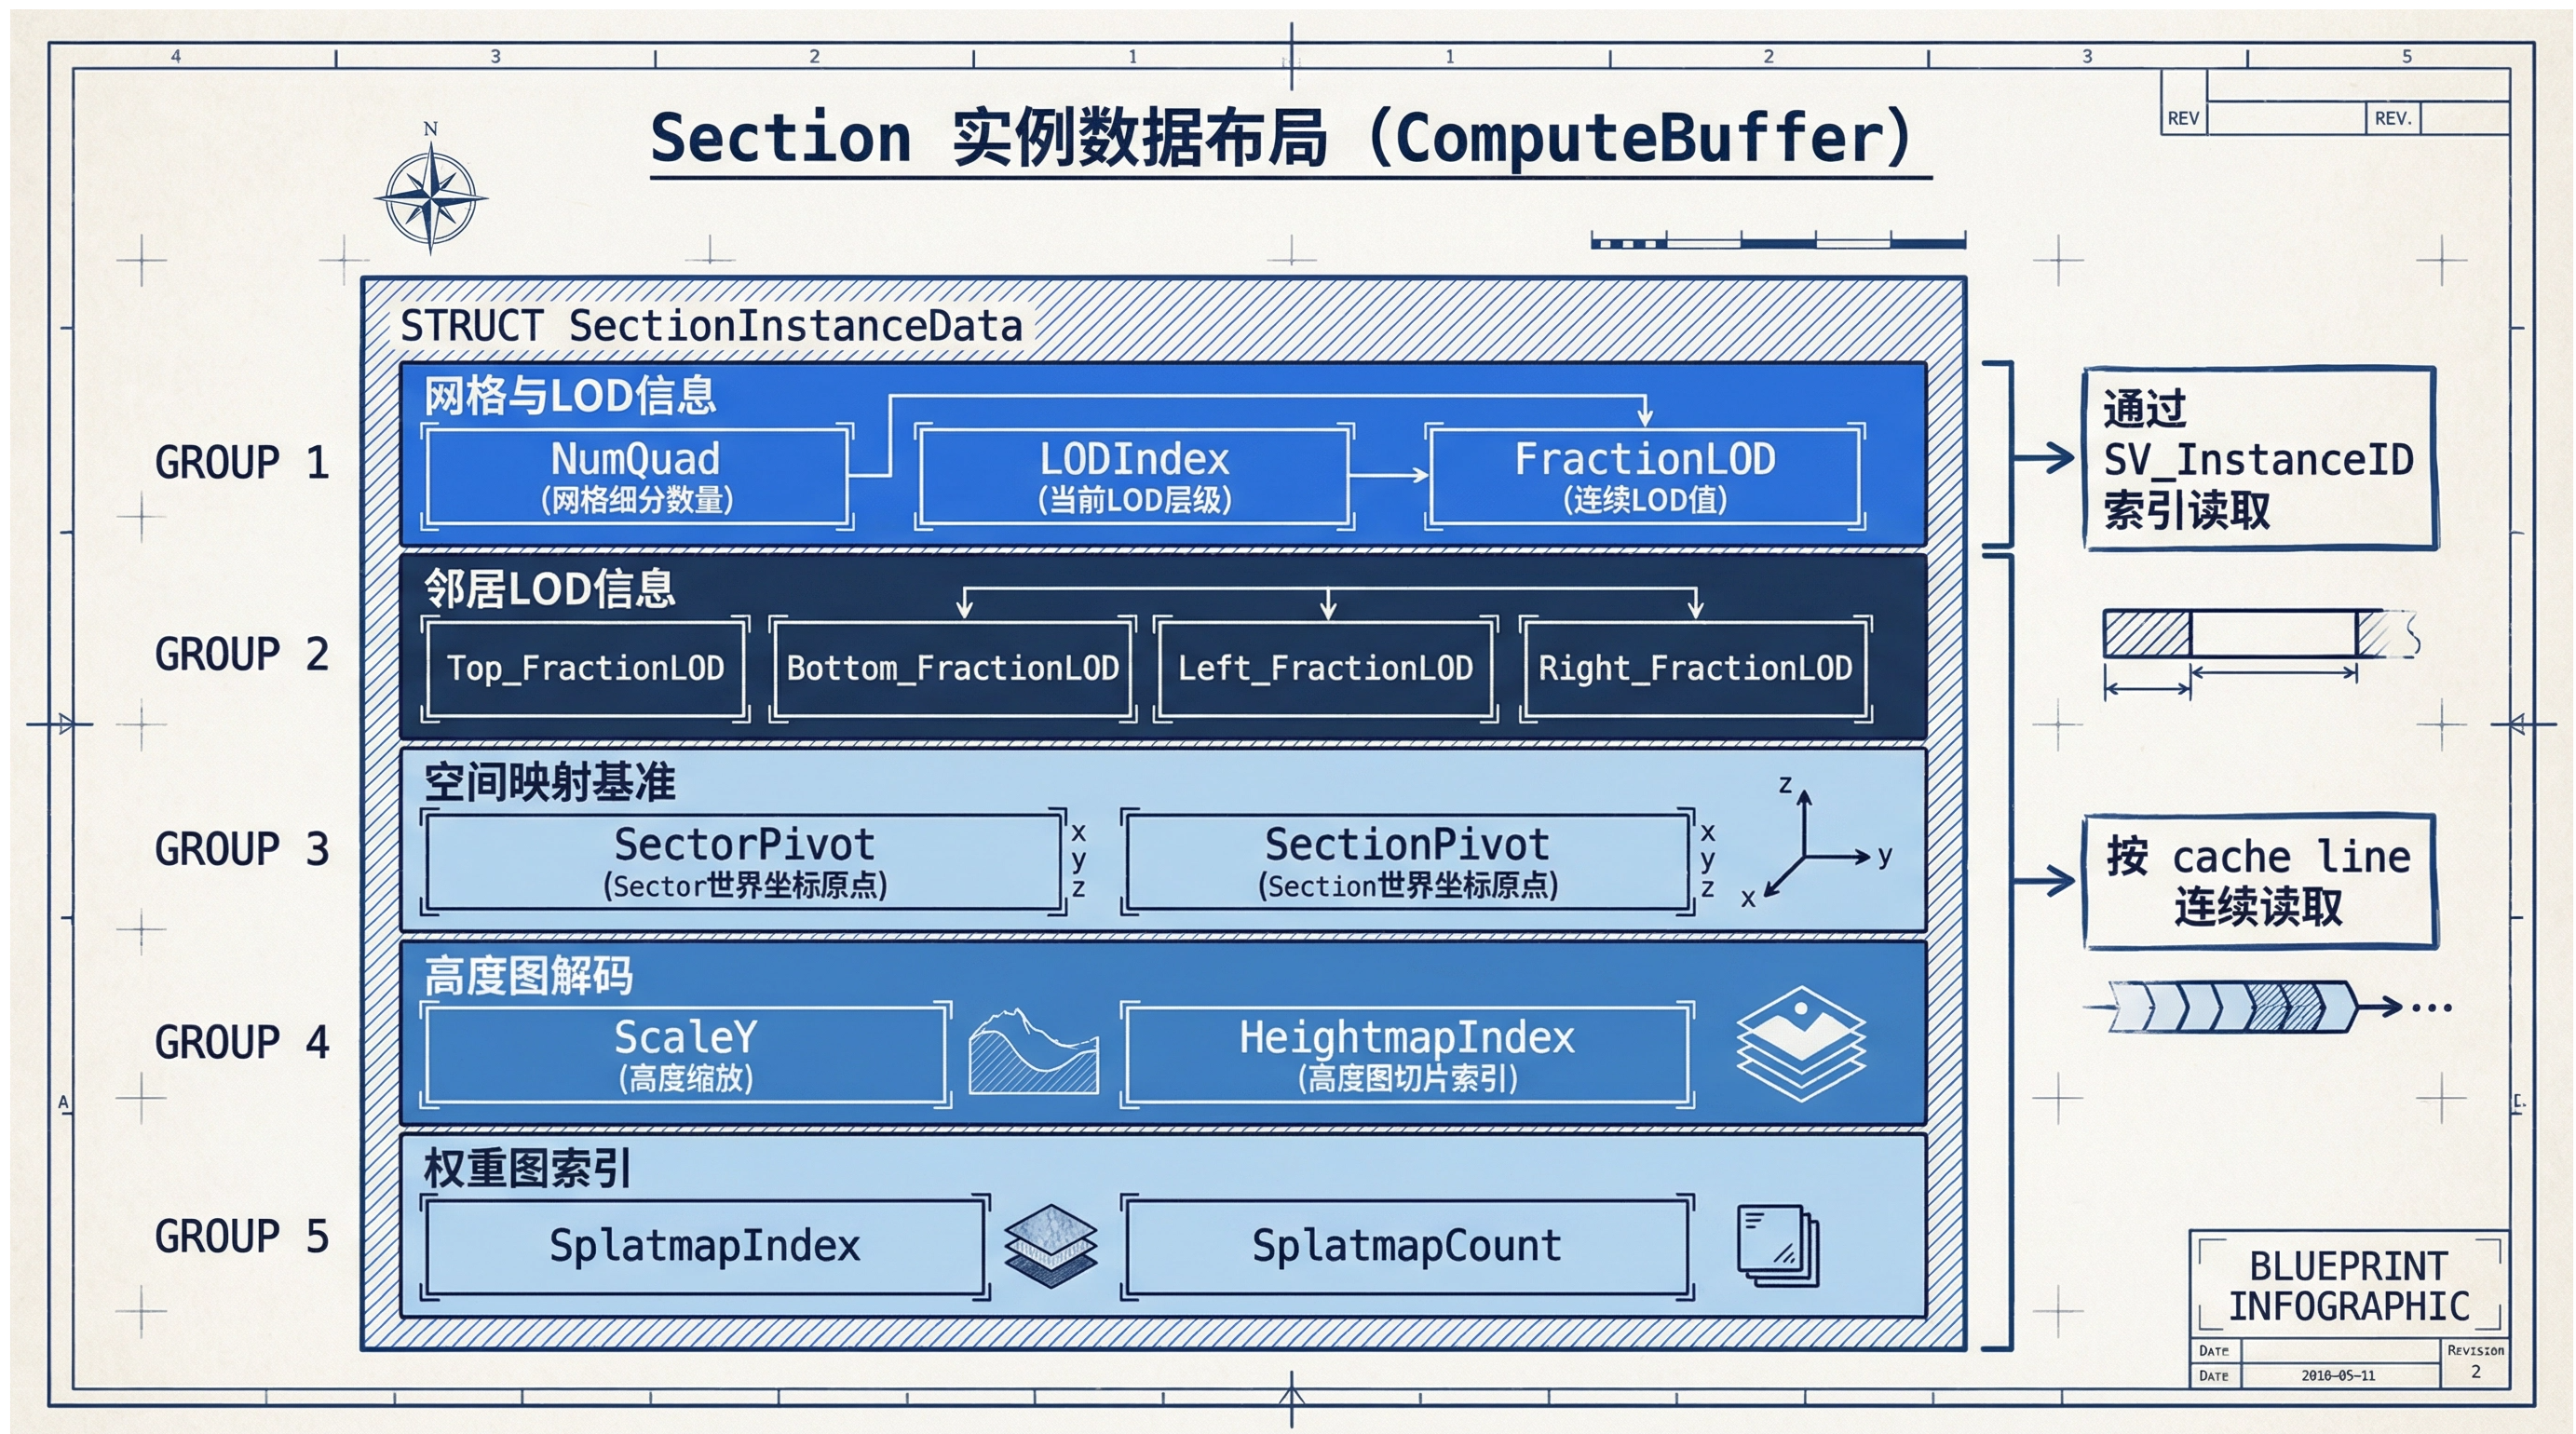
每个 Section 生成一条实例数据记录,写入 ComputeBuffer,通过 SV_InstanceID 索引读取。该结构满足两点约束:CPU 侧可以顺序写入,避免 per-instance 动态分支;GPU 侧按 cache line 连续读取,减少随机访存。
NumQuad / LODIndex / FractionLOD:定义使用的网格模板,以及当前 LOD 过渡的位置。
Top/Bottom/Left/Right_FractionLOD:邻居 LOD 信息,用于边界一致性计算。
SectorPivot / SectionPivot:模板网格空间到世界空间与 SectorUV 的映射基准。
ScaleY + HeightmapIndex:用于跨平台 height format 的解码一致性。
SplatmapIndex/SplatmapCount + SurfacemapIndices:权重纹理与表面纹理的索引组织。
2.2.1 尺寸关系作为渲染前置条件
每帧绑定的常量参数用于坐标换算与采样一致性,例如 _TerrainSize(通常为 heightmapResolution - 1,代表N个顶点构成的N-1个网格段)、_SectorSize、_SectionSize 等。尺寸关系不一致时,常见失效表现包括 UV 对齐偏移(边缘抖动、splat 边界不稳定)和邻接关系失效(边界插值错误导致 crack)。
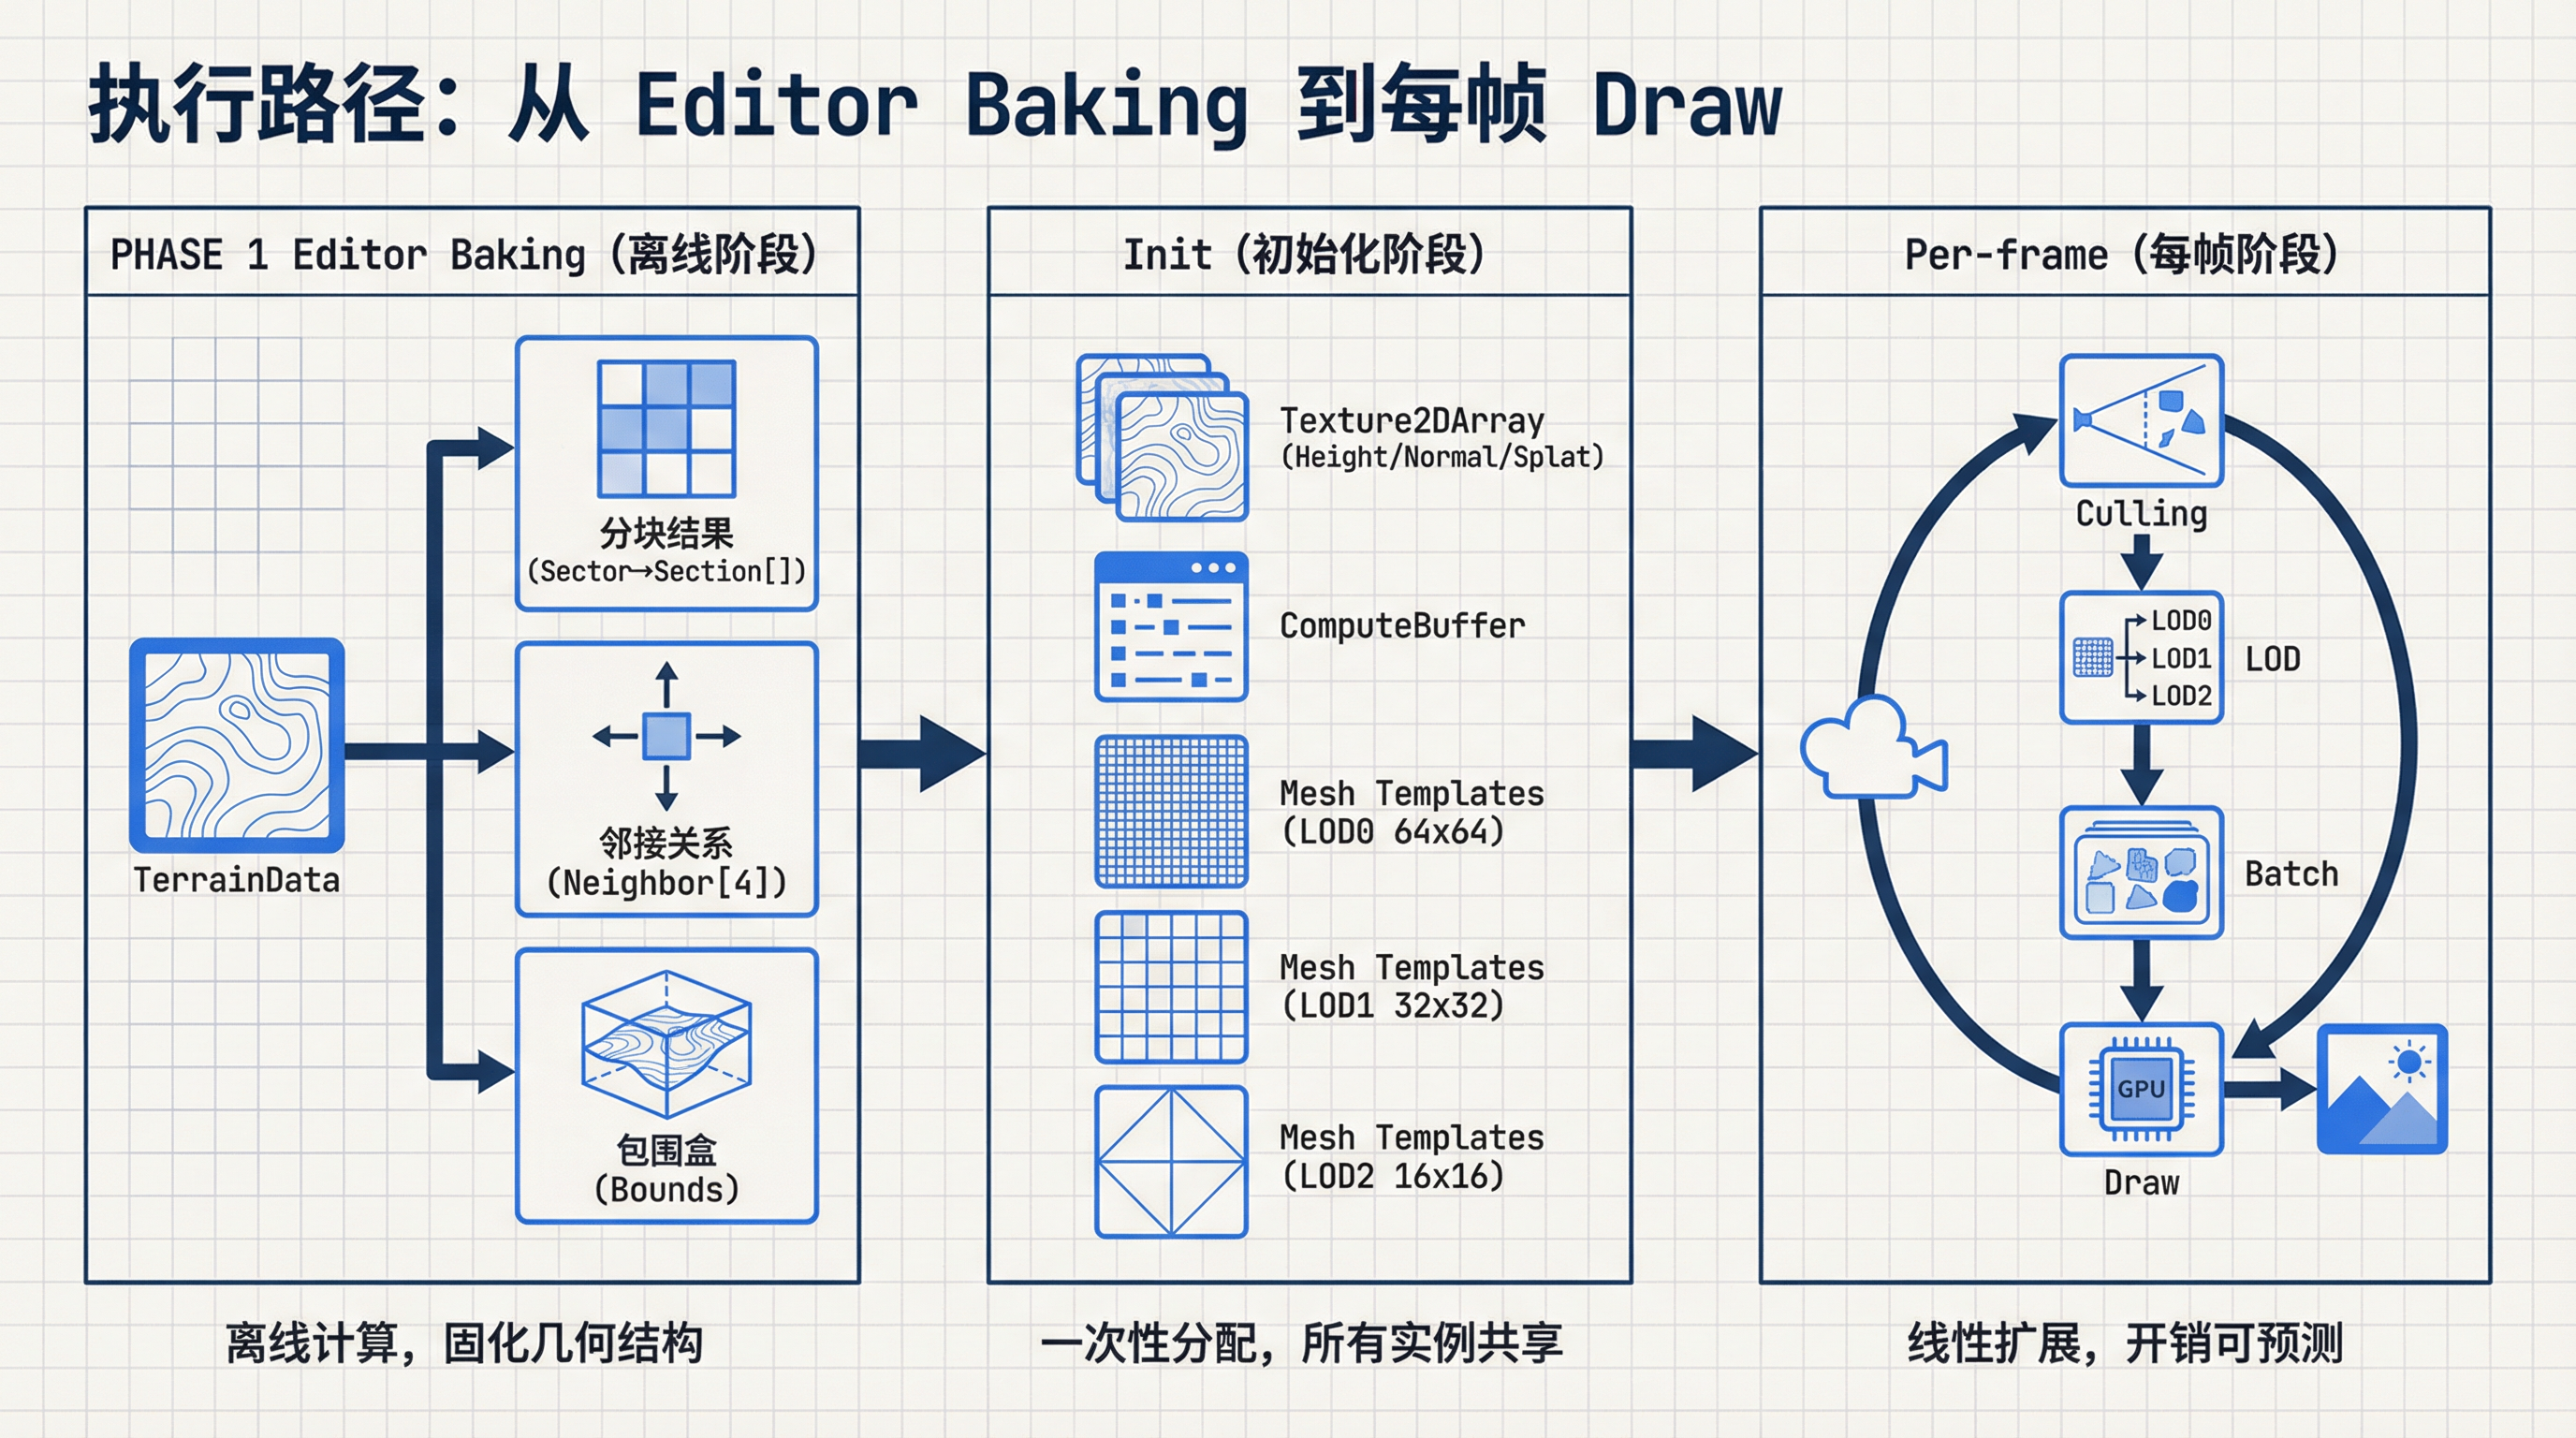
执行路径分为三个阶段:Editor Baking、Init 和 Per-frame。离线可计算的工作尽量前置,运行时只保留线性扩展逻辑。
2.3 Editor Baking:固化几何结构与邻接信息
Baking 阶段输出三类数据:规则分块结果(Sector → Section[])、邻接关系(Neighbor[4])和修正后的 Section Bounds。Baking 的价值在于将 Culling 与 LOD 的输入数据固化,避免运行时依赖隐式推断导致 Bounds 不可信及调试困难。
2.4 Init:分配全局资源与网格模板
Init 阶段完成全局 Texture2DArray、实例数据 ComputeBuffer 的创建,并为每个 LOD 生成固定的 mesh template(从 64×64 到 1×1)。Mesh Template 由所有实例共享,实例差异由实例数据驱动。
2.5 Per-frame:Culling、LOD、Batch、Draw
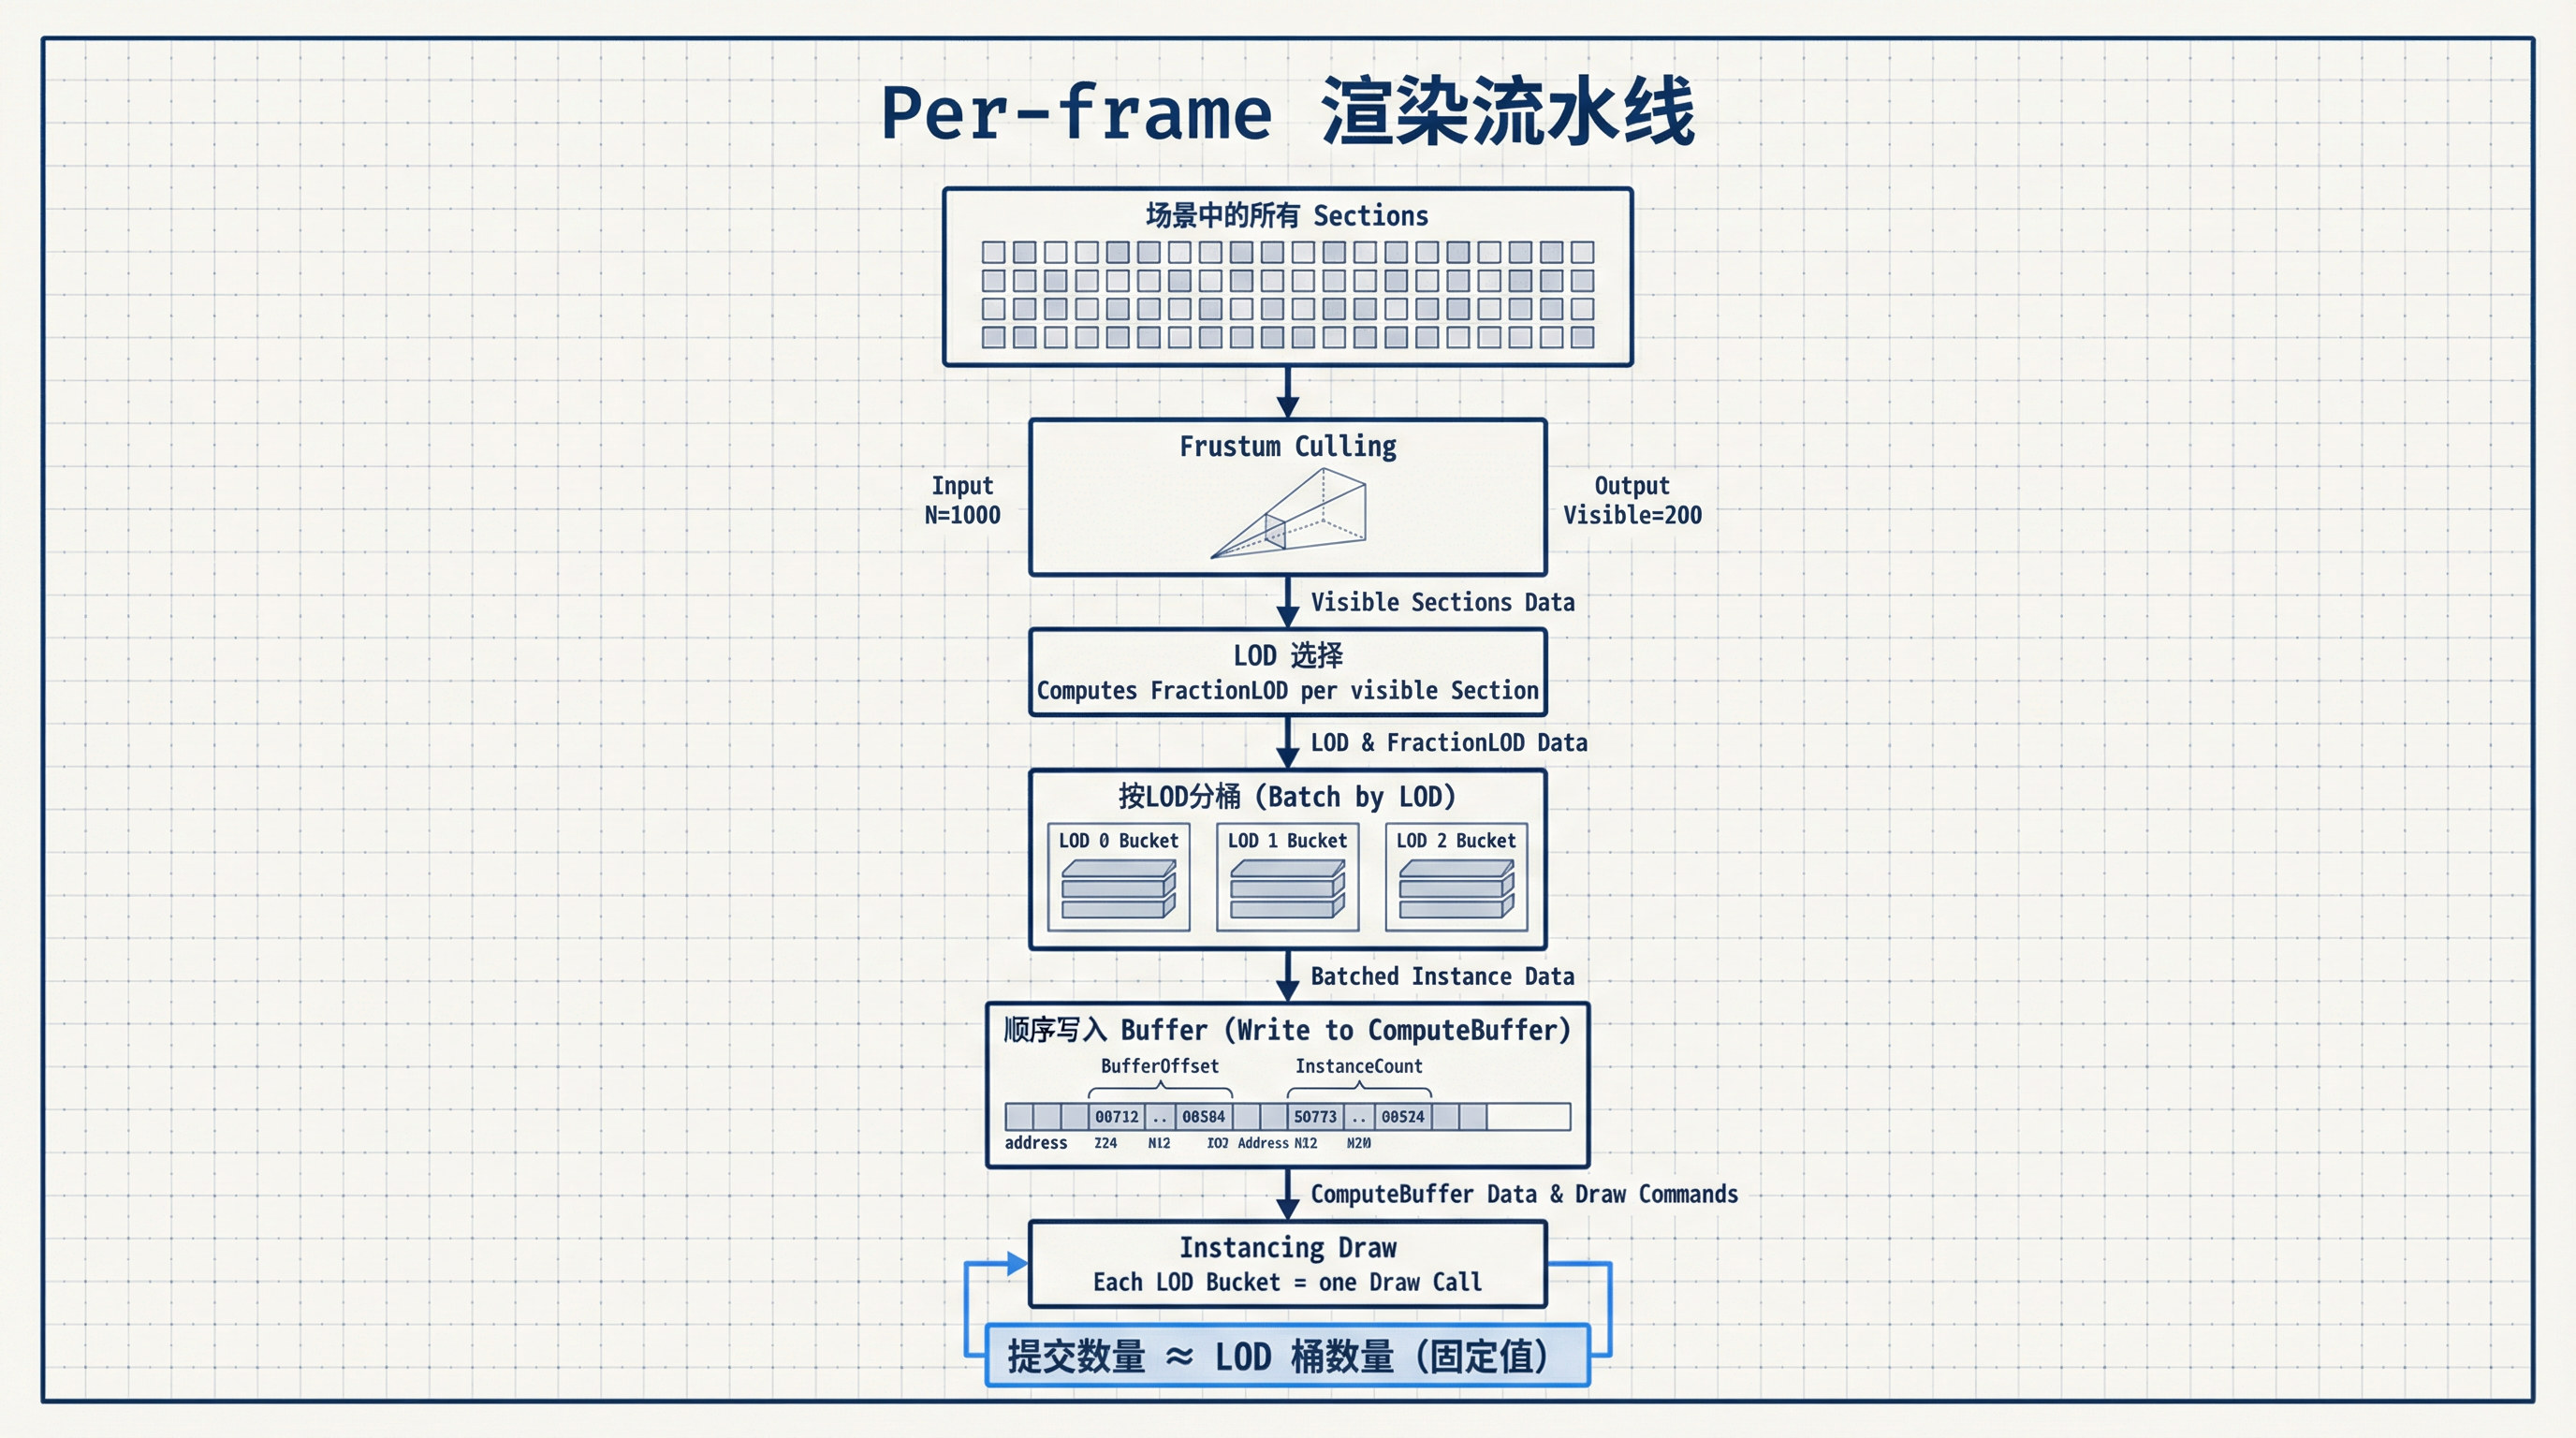
每帧执行流水线如下:
资源同步(按需):Terrain 数据变更或 Sector 增删时,将 Height/Normal/Splat 拷贝进 Array Slice,并更新映射表。同步由 dirty flag 驱动,避免每帧全量 CopyTexture。
Frustum Culling(Section 粒度):使用 Section Bounds 过滤不可见块。
LOD 选择(输出 FractionLOD):计算 FractionLOD,得到 LODIndex = floor(FractionLOD) 与 MorphAlpha = frac(FractionLOD)。
Batch 构建(按 LOD 分桶):将可见 Section 的实例数据按 LODIndex 分组,顺序写入 ComputeBuffer,记录每组的 InstanceCount 与 BufferOffset。
Instancing Draw:对每个 LOD 组提交一次 draw,使用共享的 mesh template 和材质。
该结构将提交数量从"可见 Section 数量"转化为"LOD 组数量",实现了性能开销与场景复杂度的解耦。
三、连续 LOD 过渡与边界一致性
为解决离散 LOD 带来的 popping 和 crack 问题,系统采用基于 screen-space error 的连续 LOD 过渡方案,并显式处理边界一致性。另一种常见做法是 stitch(边界拓扑拼接),但 stitch 的 CPU 侧维护成本高,且与 instancing 的提交模型不一致。morph 把复杂度放在 vertex stage,提交模型更稳定。规则分块是该方案的基础,它使 culling、instancing 和邻接关系构建变得简单高效。
3.1 从 Screen-space Error 到 FractionLOD
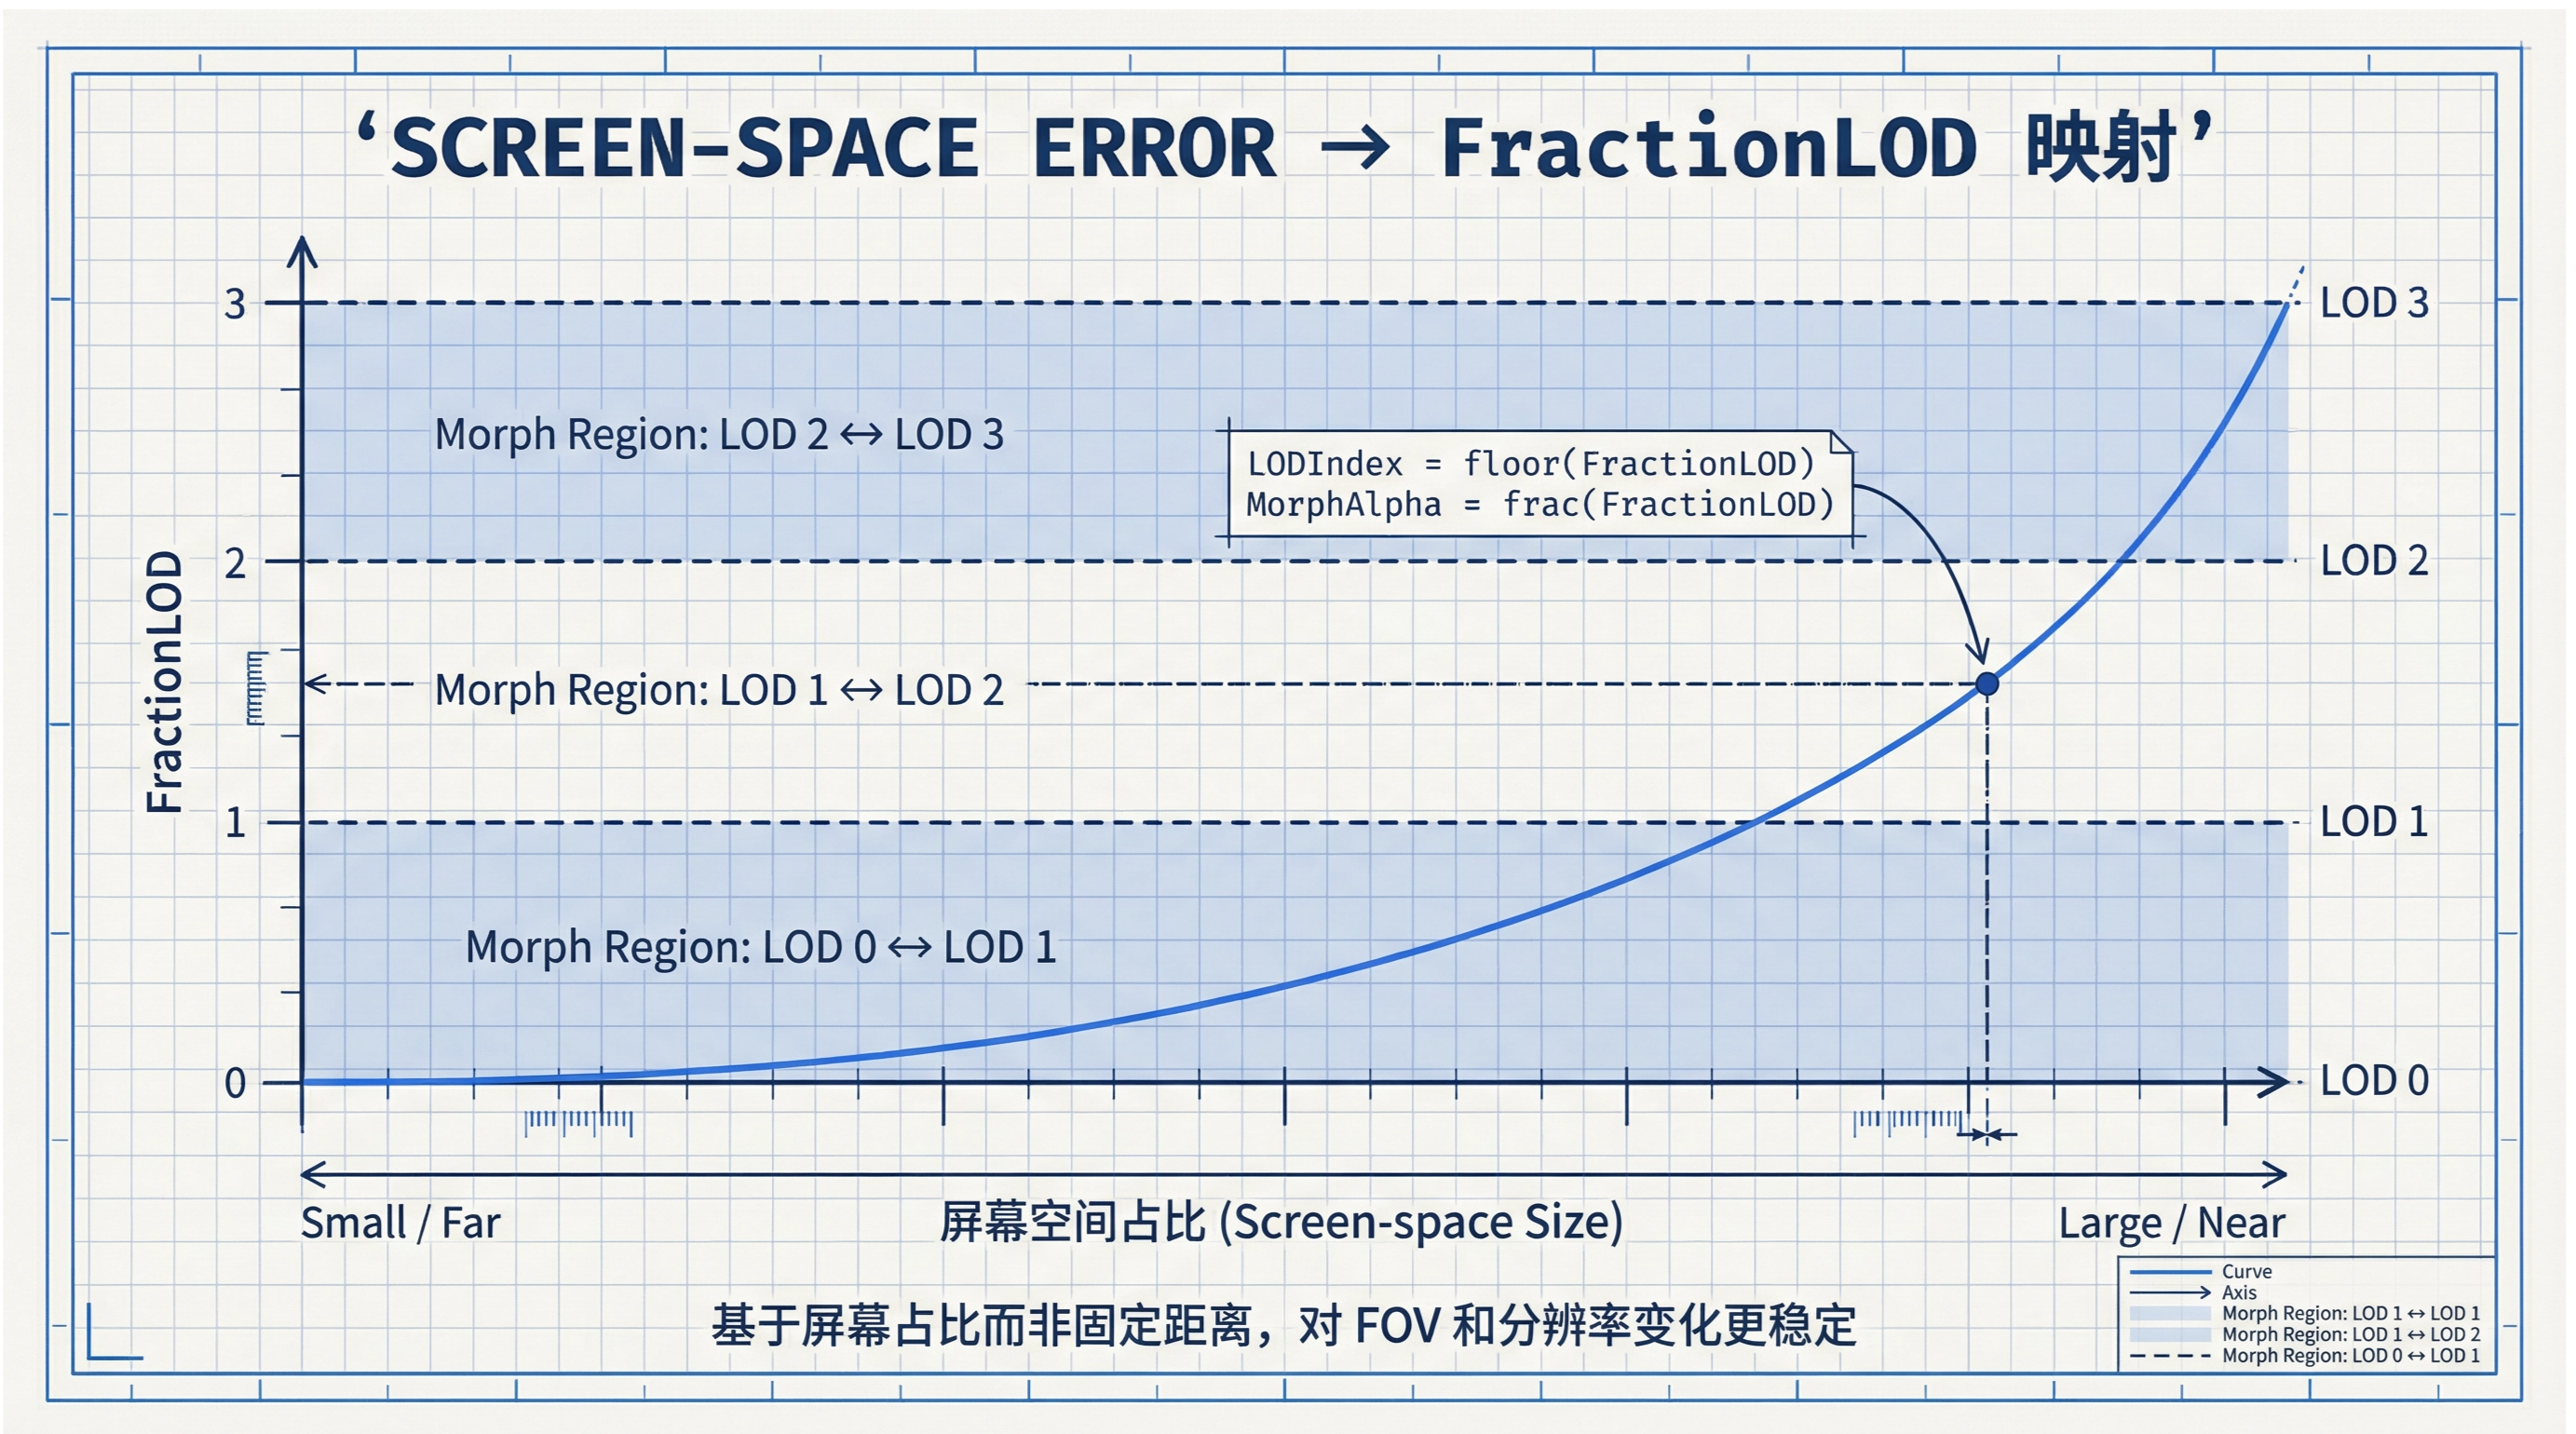
LOD 策略基于 screen-space error,通过屏幕占比而非固定距离阈值来评估几何细节需求,使 LOD 变化对 FOV、分辨率及相机运动表现出更高的稳定性。将 ScreenSizeSquared 映射至 FractionLOD,可以得到用于平滑过渡的 LODIndex 和 MorphAlpha。
3.2 边界一致性:基于邻接 LOD 的边界插值
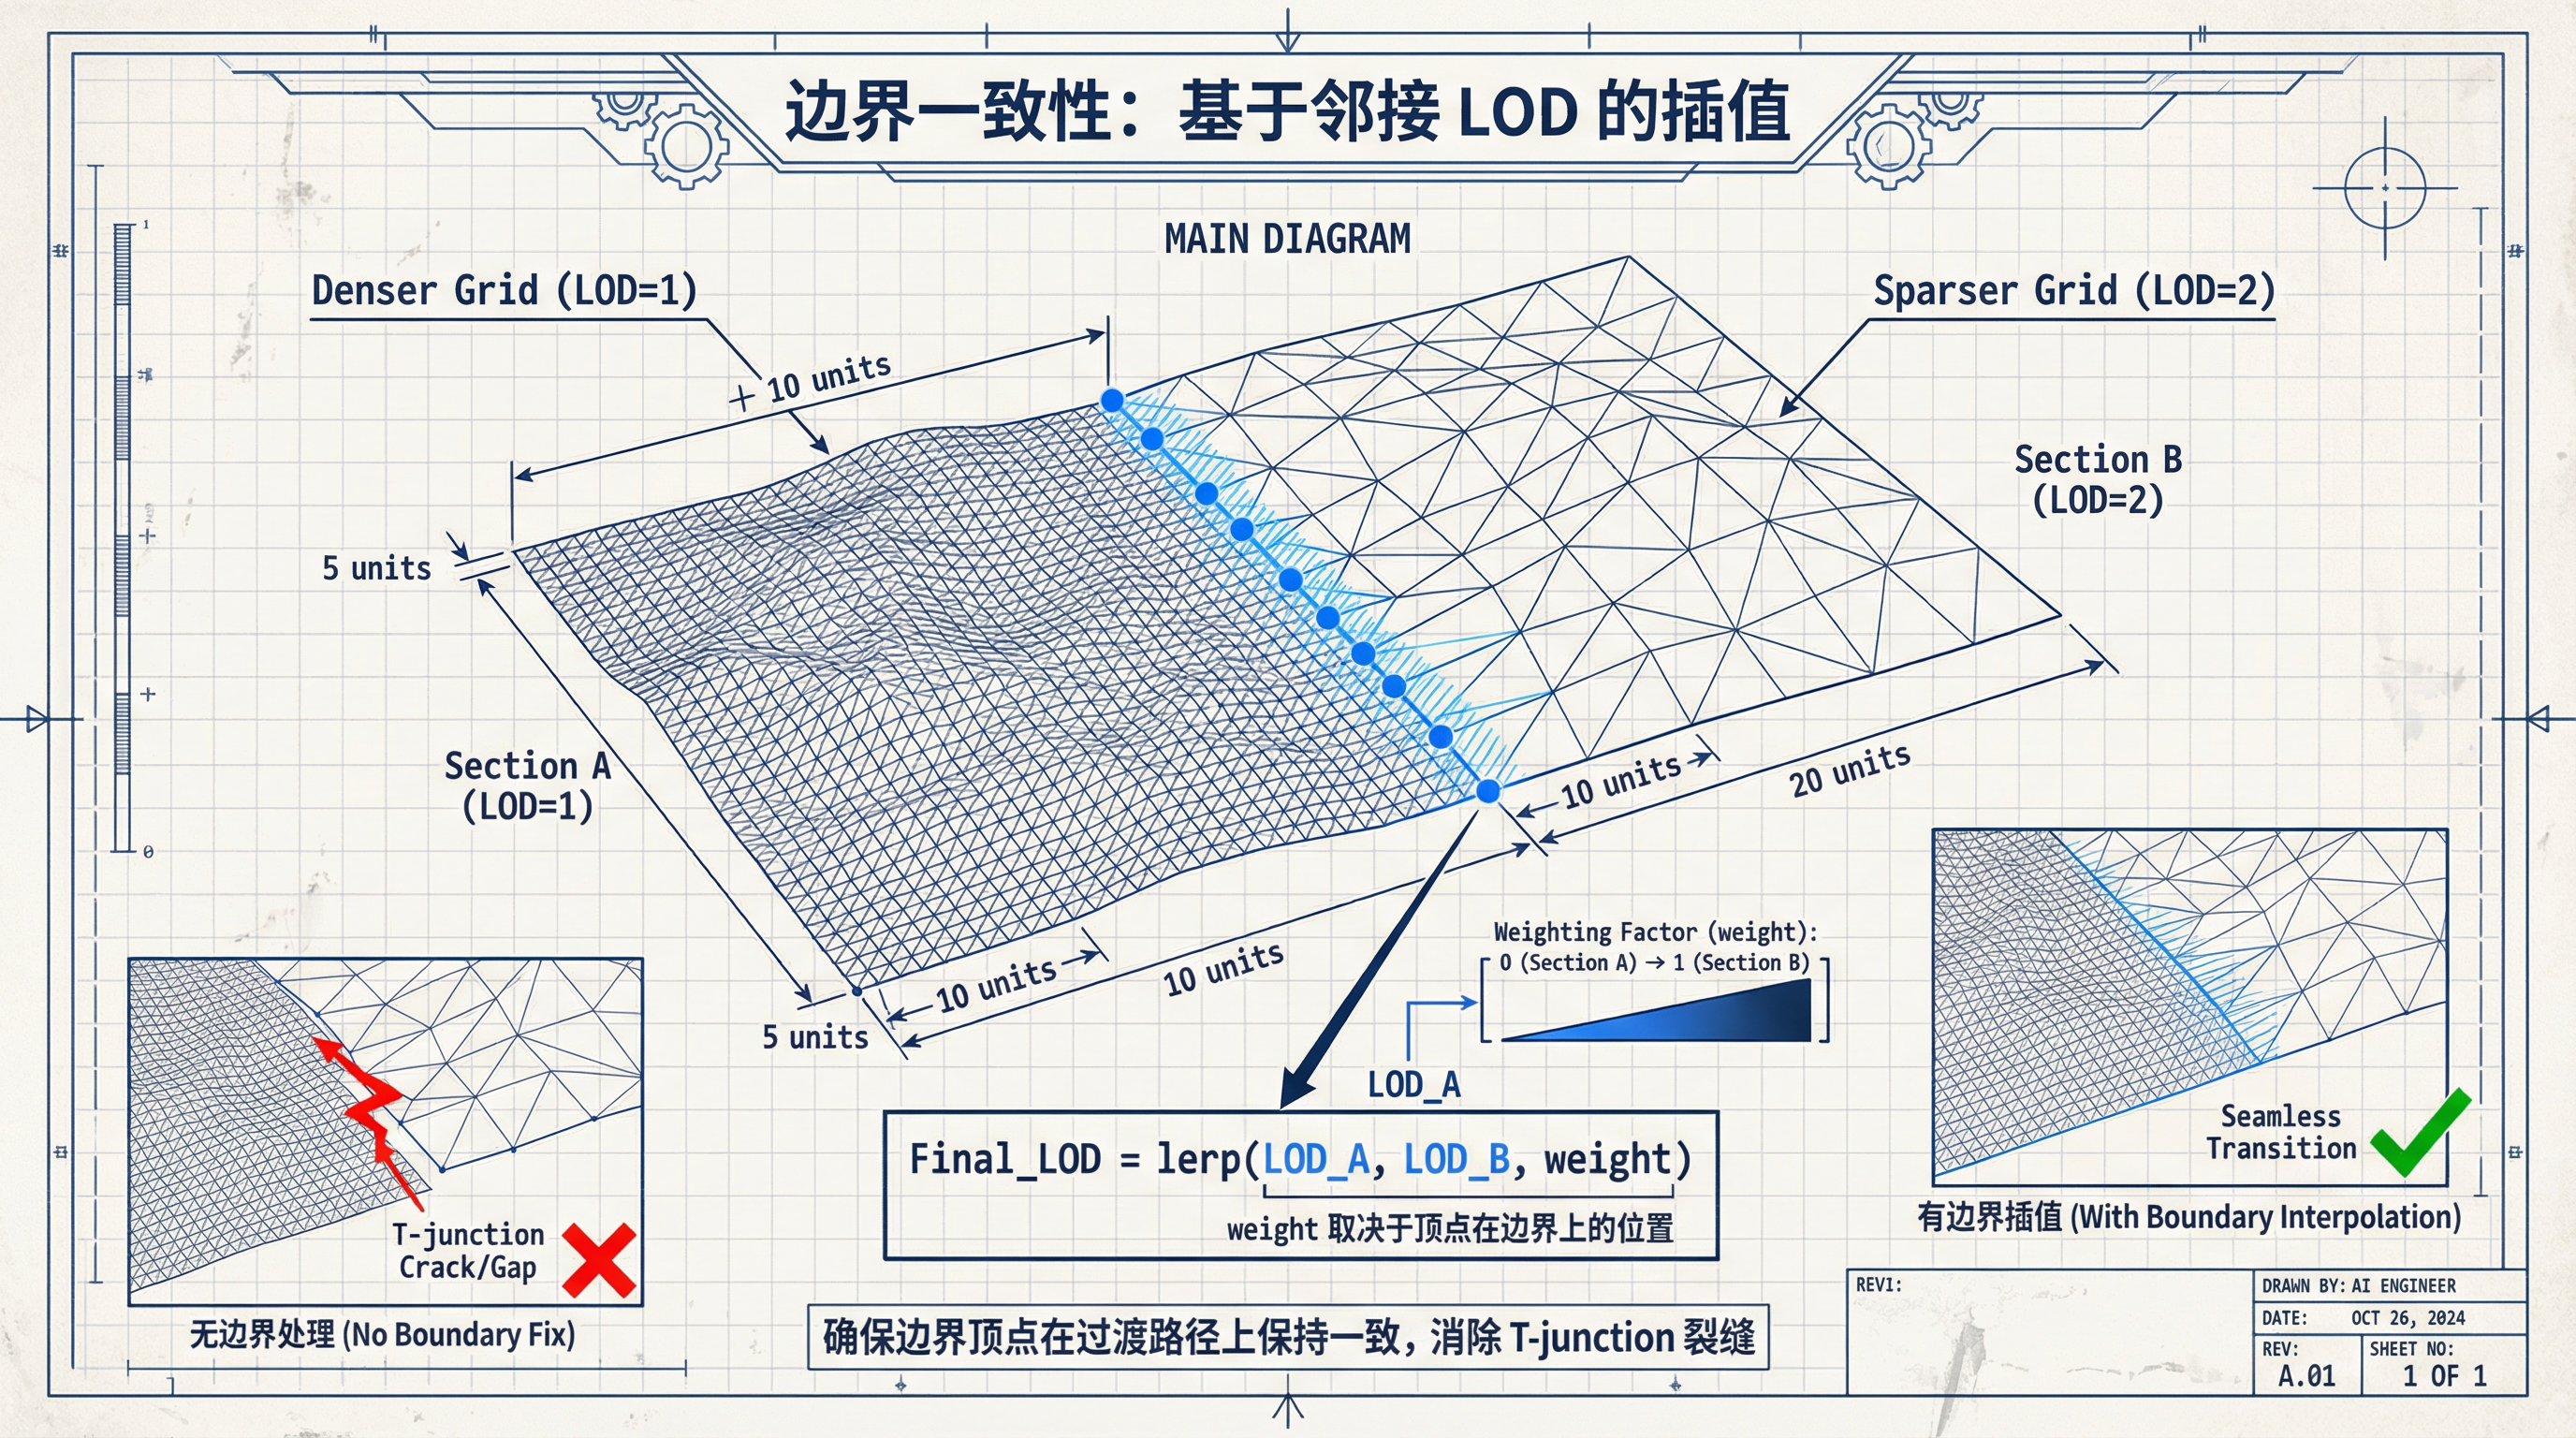
仅通过 geomorph 能够有效降低 popping 现象,但 crack 问题通常源于相邻块之间 LOD 不一致。为此,邻接信息显式写入实例数据,并在 vertex stage 执行边界一致性计算。
CPU 写入邻居 FractionLOD:每个 Section 的实例数据中均包含自身及其四个邻居的 FractionLOD 信息。
Vertex shader 计算用于边界的 LOD 值:Shader 根据顶点在 Section 内部的位置判断其靠近哪条边界,并在边界区域对"自身"与"邻居"的 LOD 值进行插值。此方法的目的并非强制邻居 LOD 统一,而是确保边界顶点在过渡路径上保持一致性。
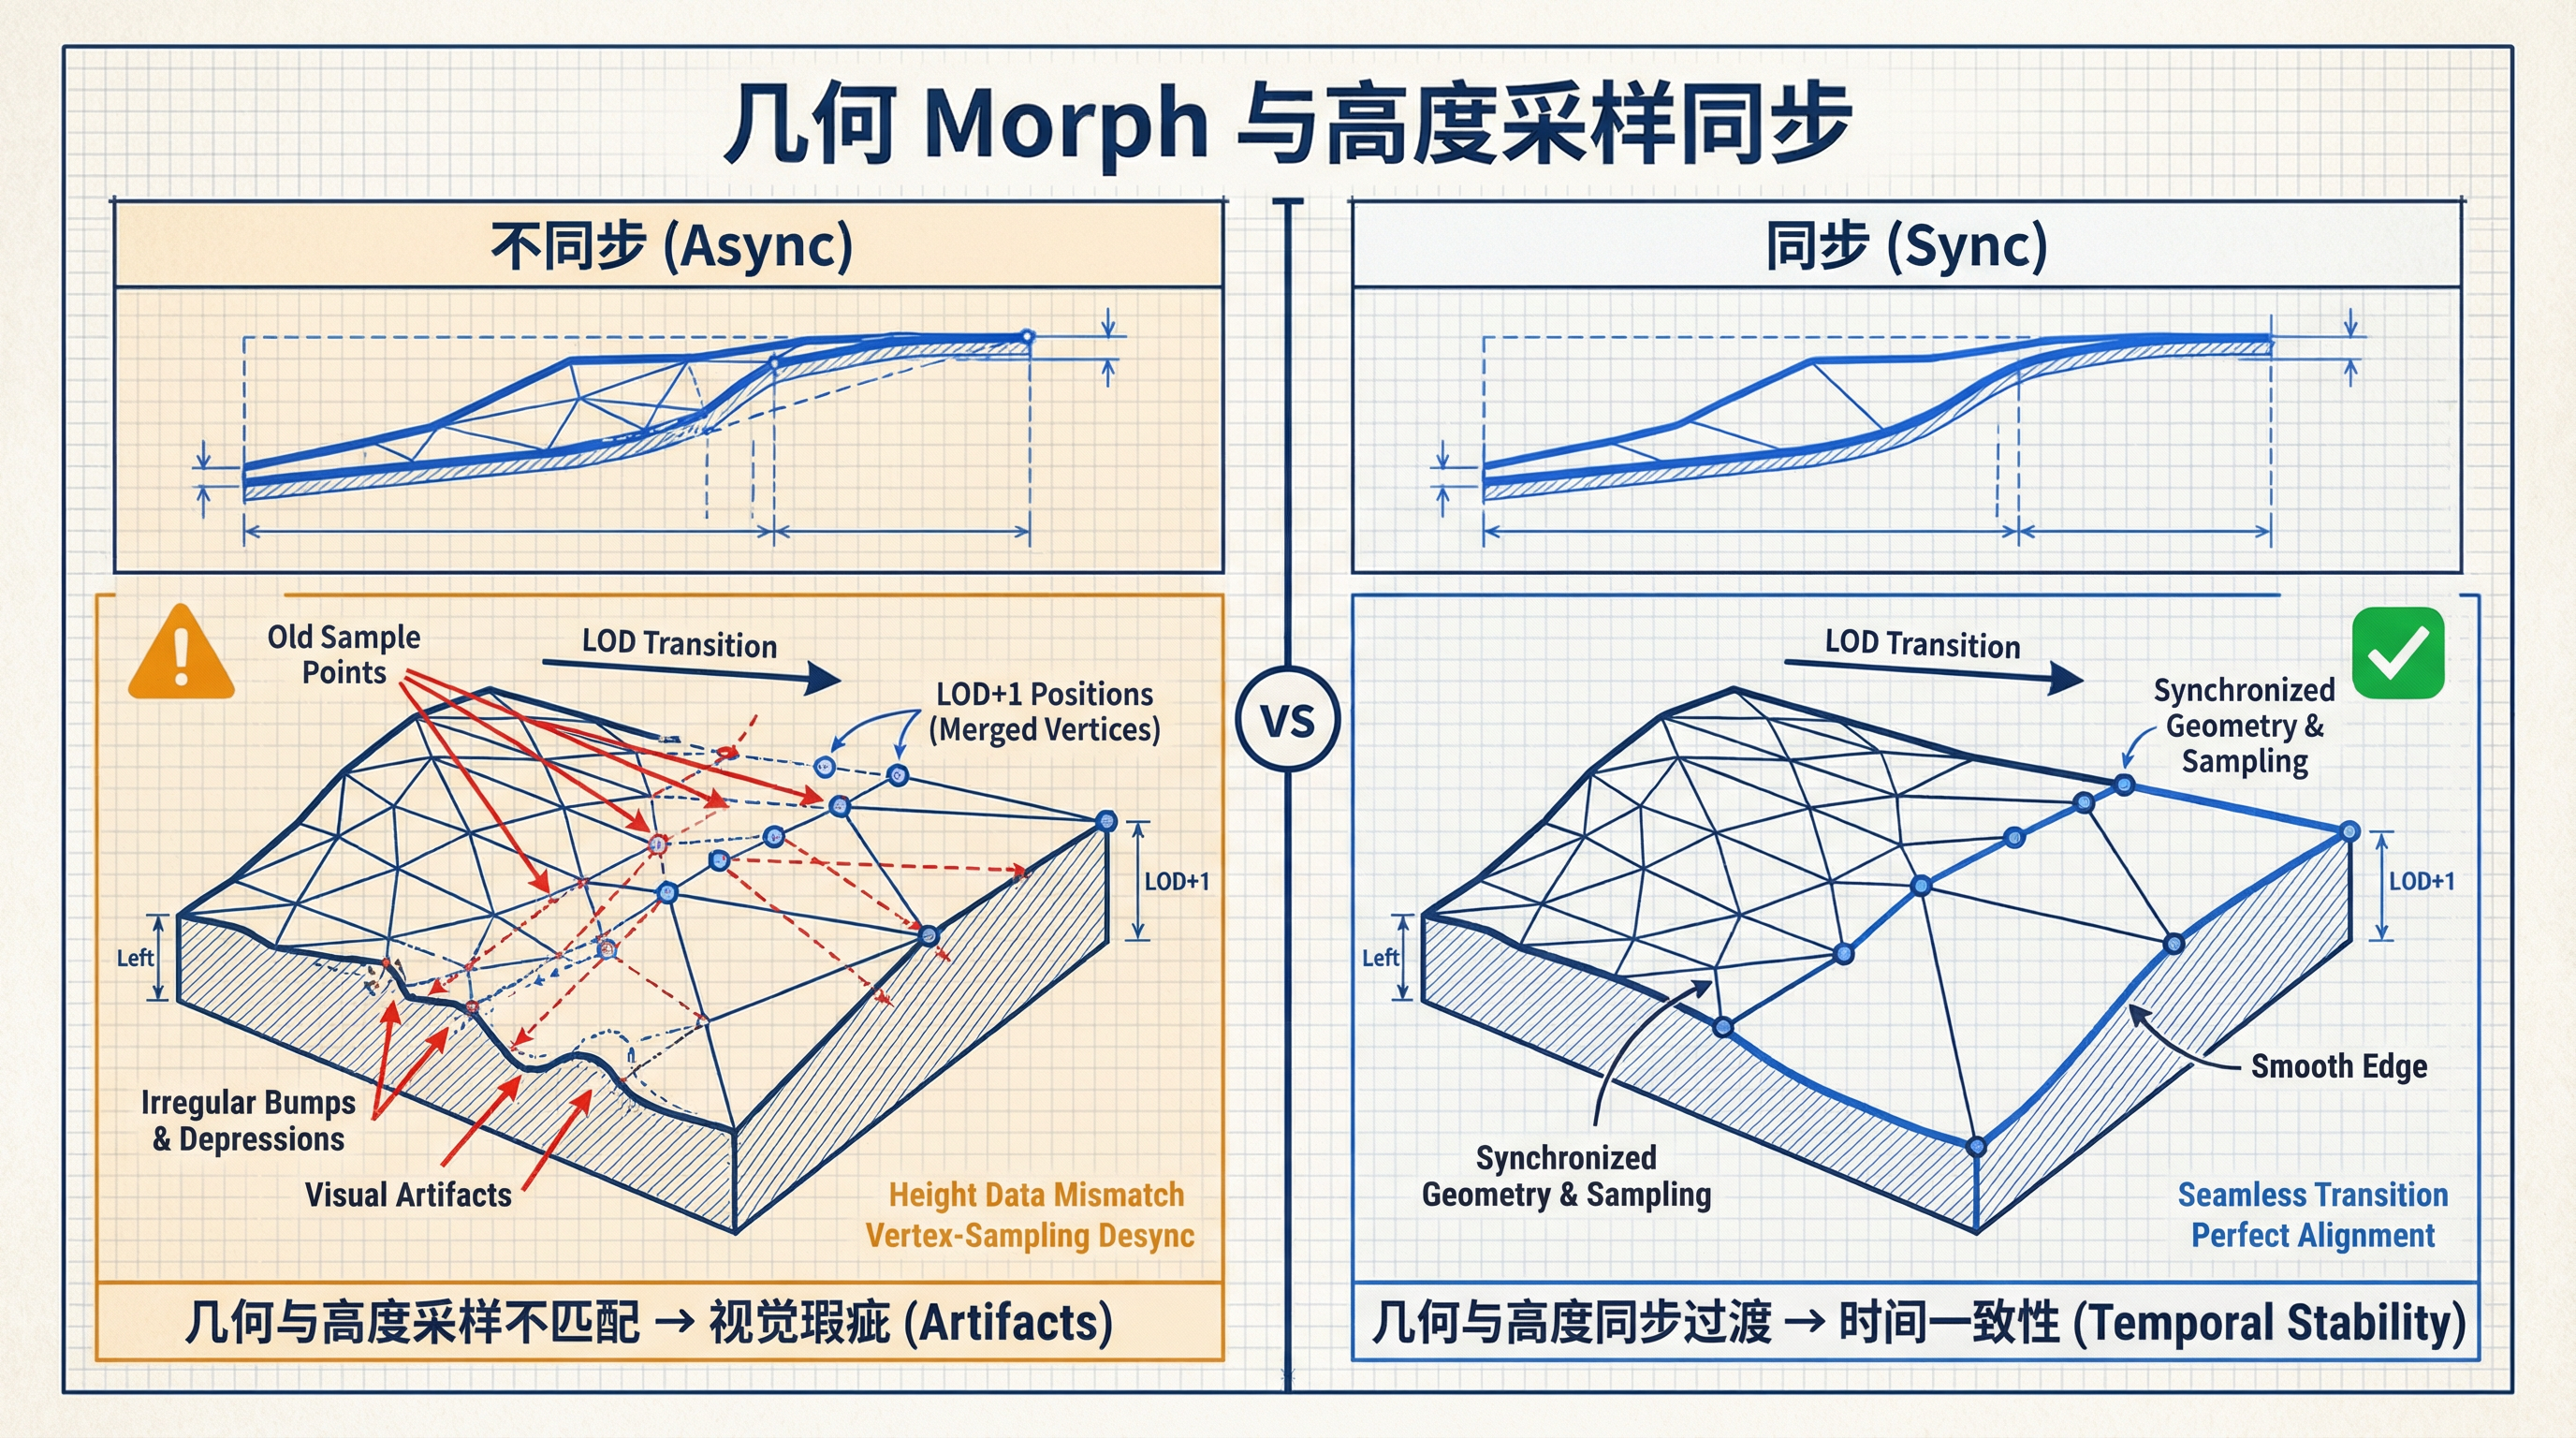
几何 Morph 与高度采样同步:在执行 morph 操作时,同步对高度采样进行插值处理,避免拓扑已过渡到下一 LOD 但高度仍沿用旧采样点时出现局部鼓包或塌陷。几何与高度在同一过渡轨迹上变化,时间一致性更好。
四、表面系统与采样稳定性
4.1 Splatmap 驱动的 TerrainLayer 混合
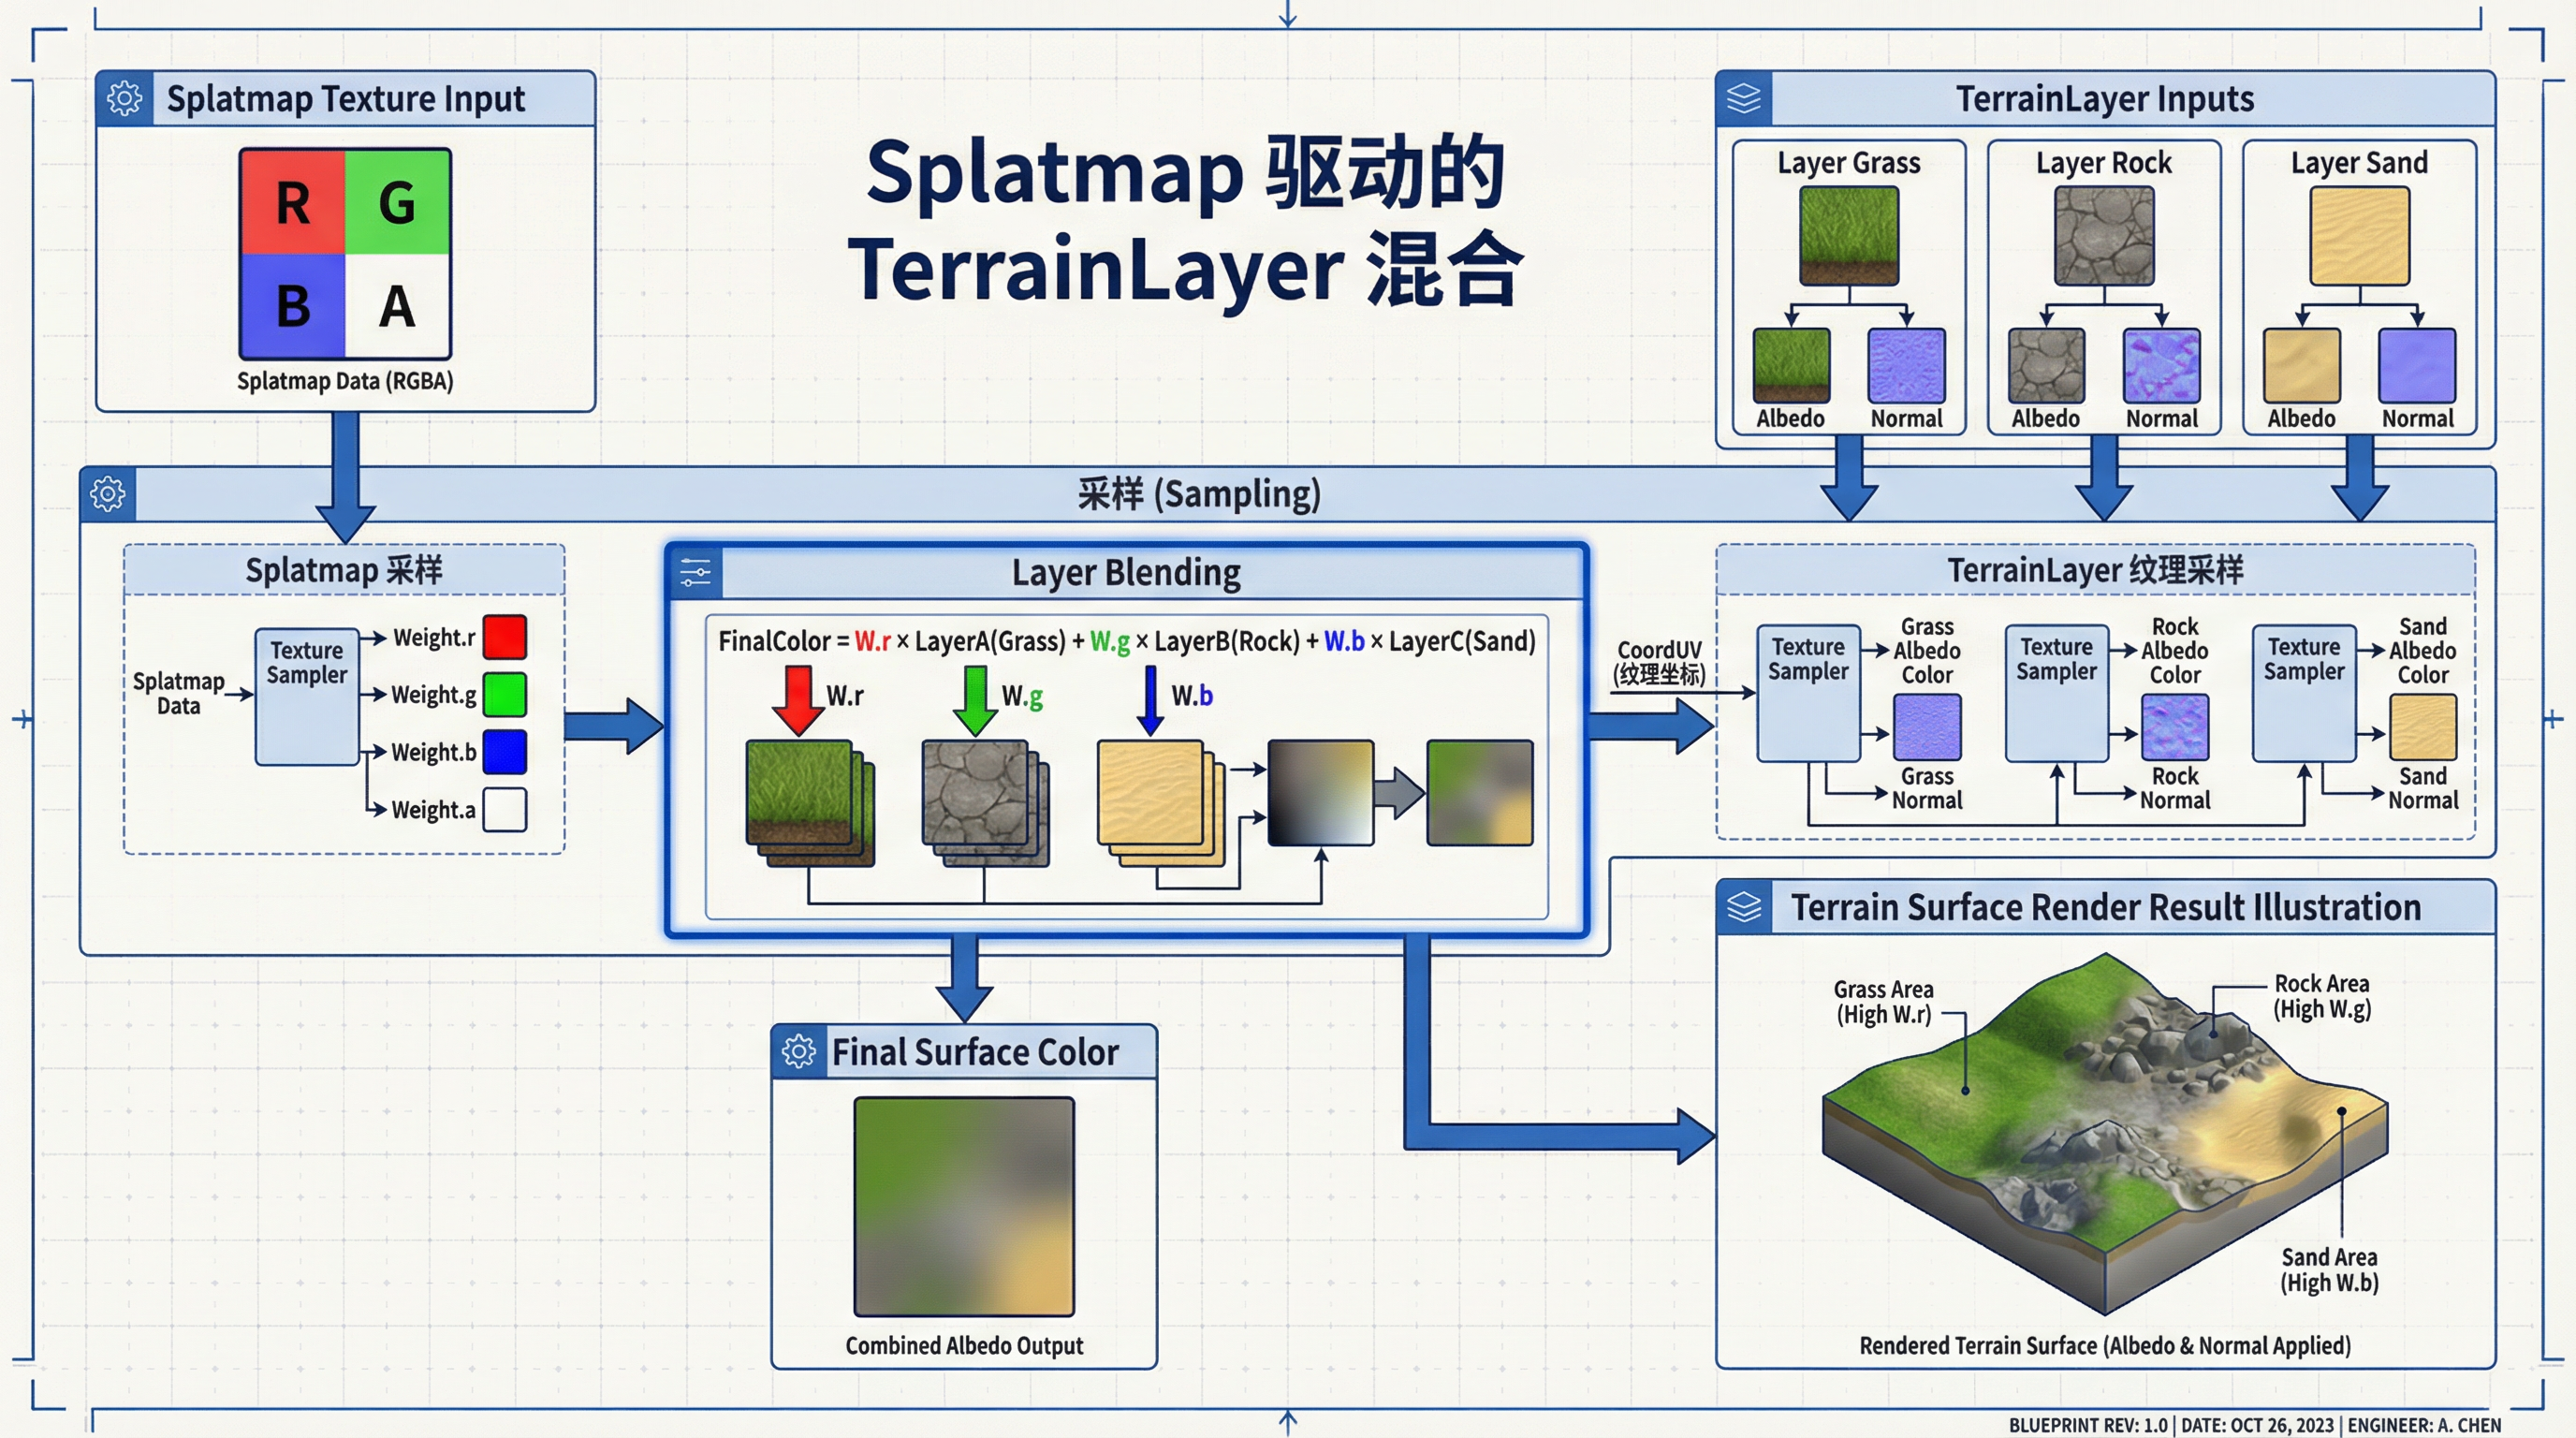
表面系统保留 Unity Terrain 的语义:Splatmap/Alphamap 提供权重,TerrainLayer 提供表面纹理与参数。Shader 侧通过计算 SectorUV(用于对齐 Height/Normal/Splat 采样)和 CoordUV(用于表面纹理 repeat),并基于 ddx/ddy 选择 mip,最终按权重混合各 Layer。
4.2 Layer 上限与 Pass 的现实约束
在 URP/Built-in 中,多 pass 的代价不可忽略;在 HDRP 中,超过 8 个 Layer 的部分会被忽略。系统不追求无限 Layer 的实时混合,渲染侧设定"每个 Section 的有效 Layer 上限"(例如 8)。超出硬件与管线限制的复杂度,迁移到 Virtual Texture/RVT 或烘焙路径,把层数压力交给 Page Table 与 Physical Cache 的按需更新来承担。
4.3 采样稳定性
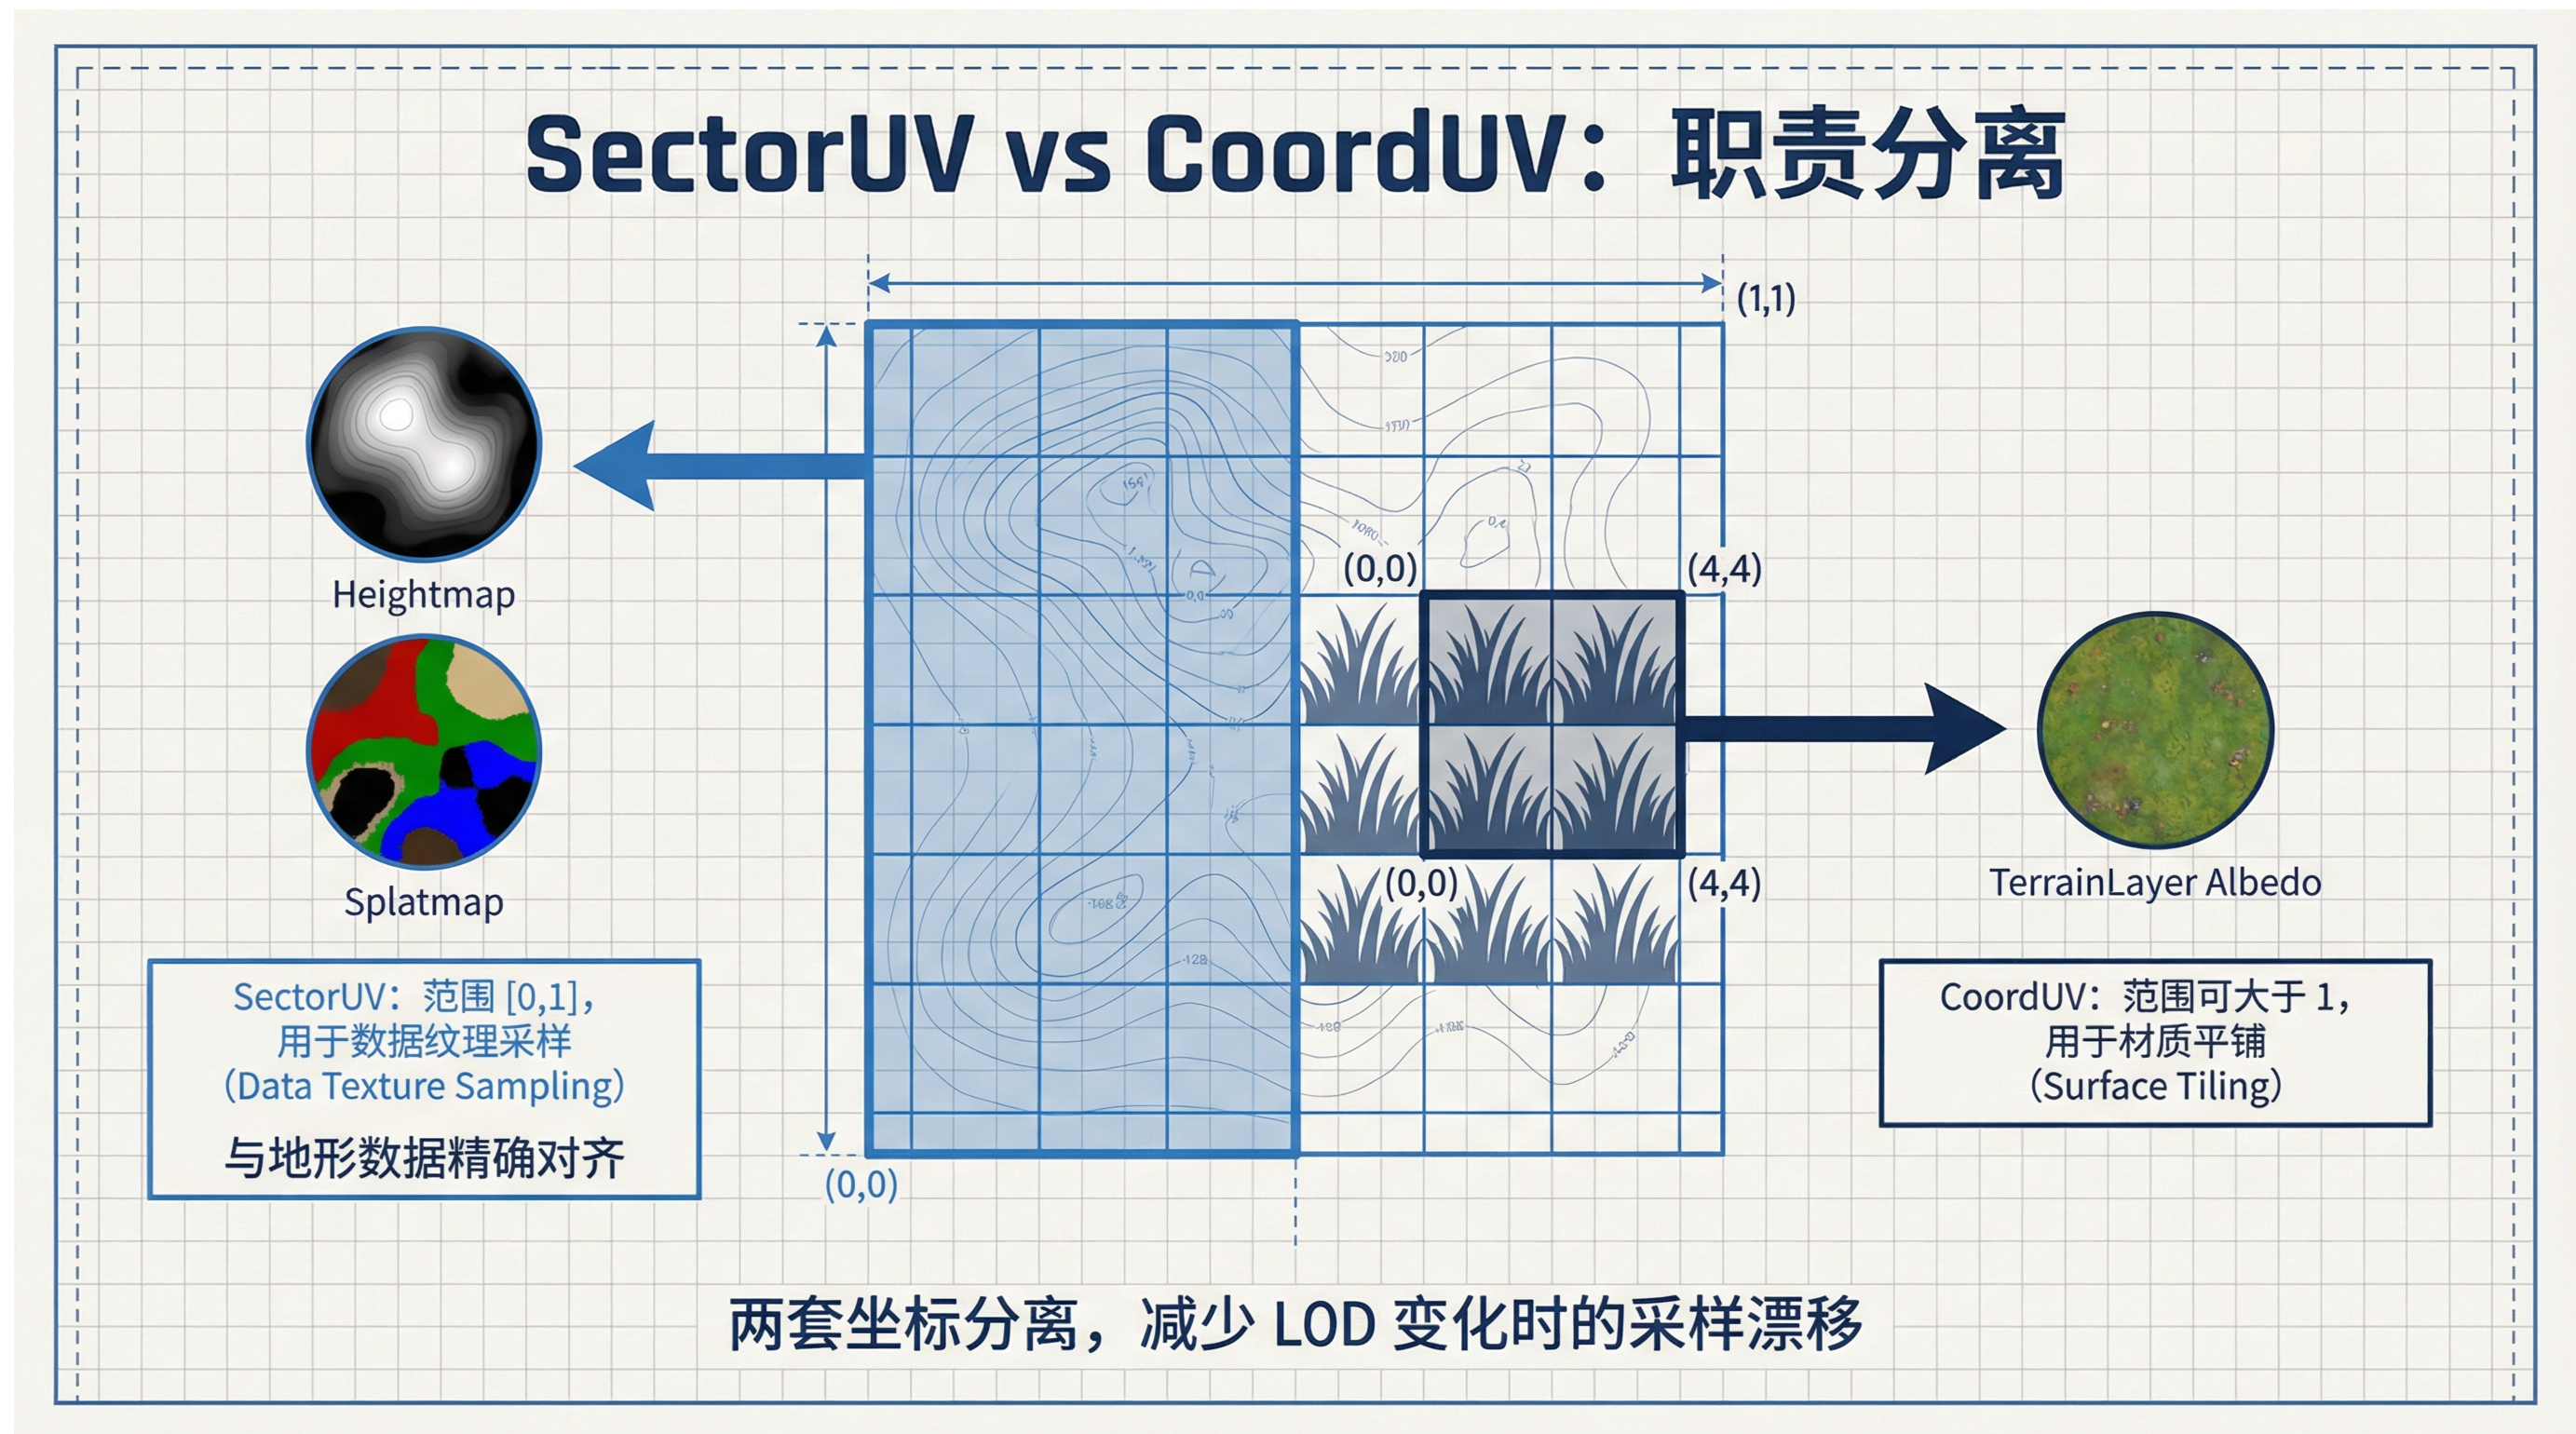
坐标体系分离:SectorUV(0..1 范围,对齐数据纹理)与 CoordUV(材质平铺坐标)的职责分离,可减少 LOD 变化时的采样漂移。
texel-center 对齐:Texture2DArray 采样时对 UV 做 texel-center 偏移,用于降低边缘抖动与平台差异导致的采样偏差,这对 Heightmap 与 Splatmap 的边界 seam 尤为重要。
格式与解码一致性:允许不同平台采用不同 GraphicsFormat 存储 Heightmap,但格式选择与解码方式需要在系统中明确固定,以保证高度尺度和法线编码的跨平台一致性。
五、工程约束与演进
InfinityTerrain 的 Component/Renderer 与 Engine Adapter 之间的划分已预留 Dots/Job/Burst 的接入边界,但线程模型与数据结构尚未确定,这条路径没有实现。
5.1 评估与调试
5.1.1 性能指标
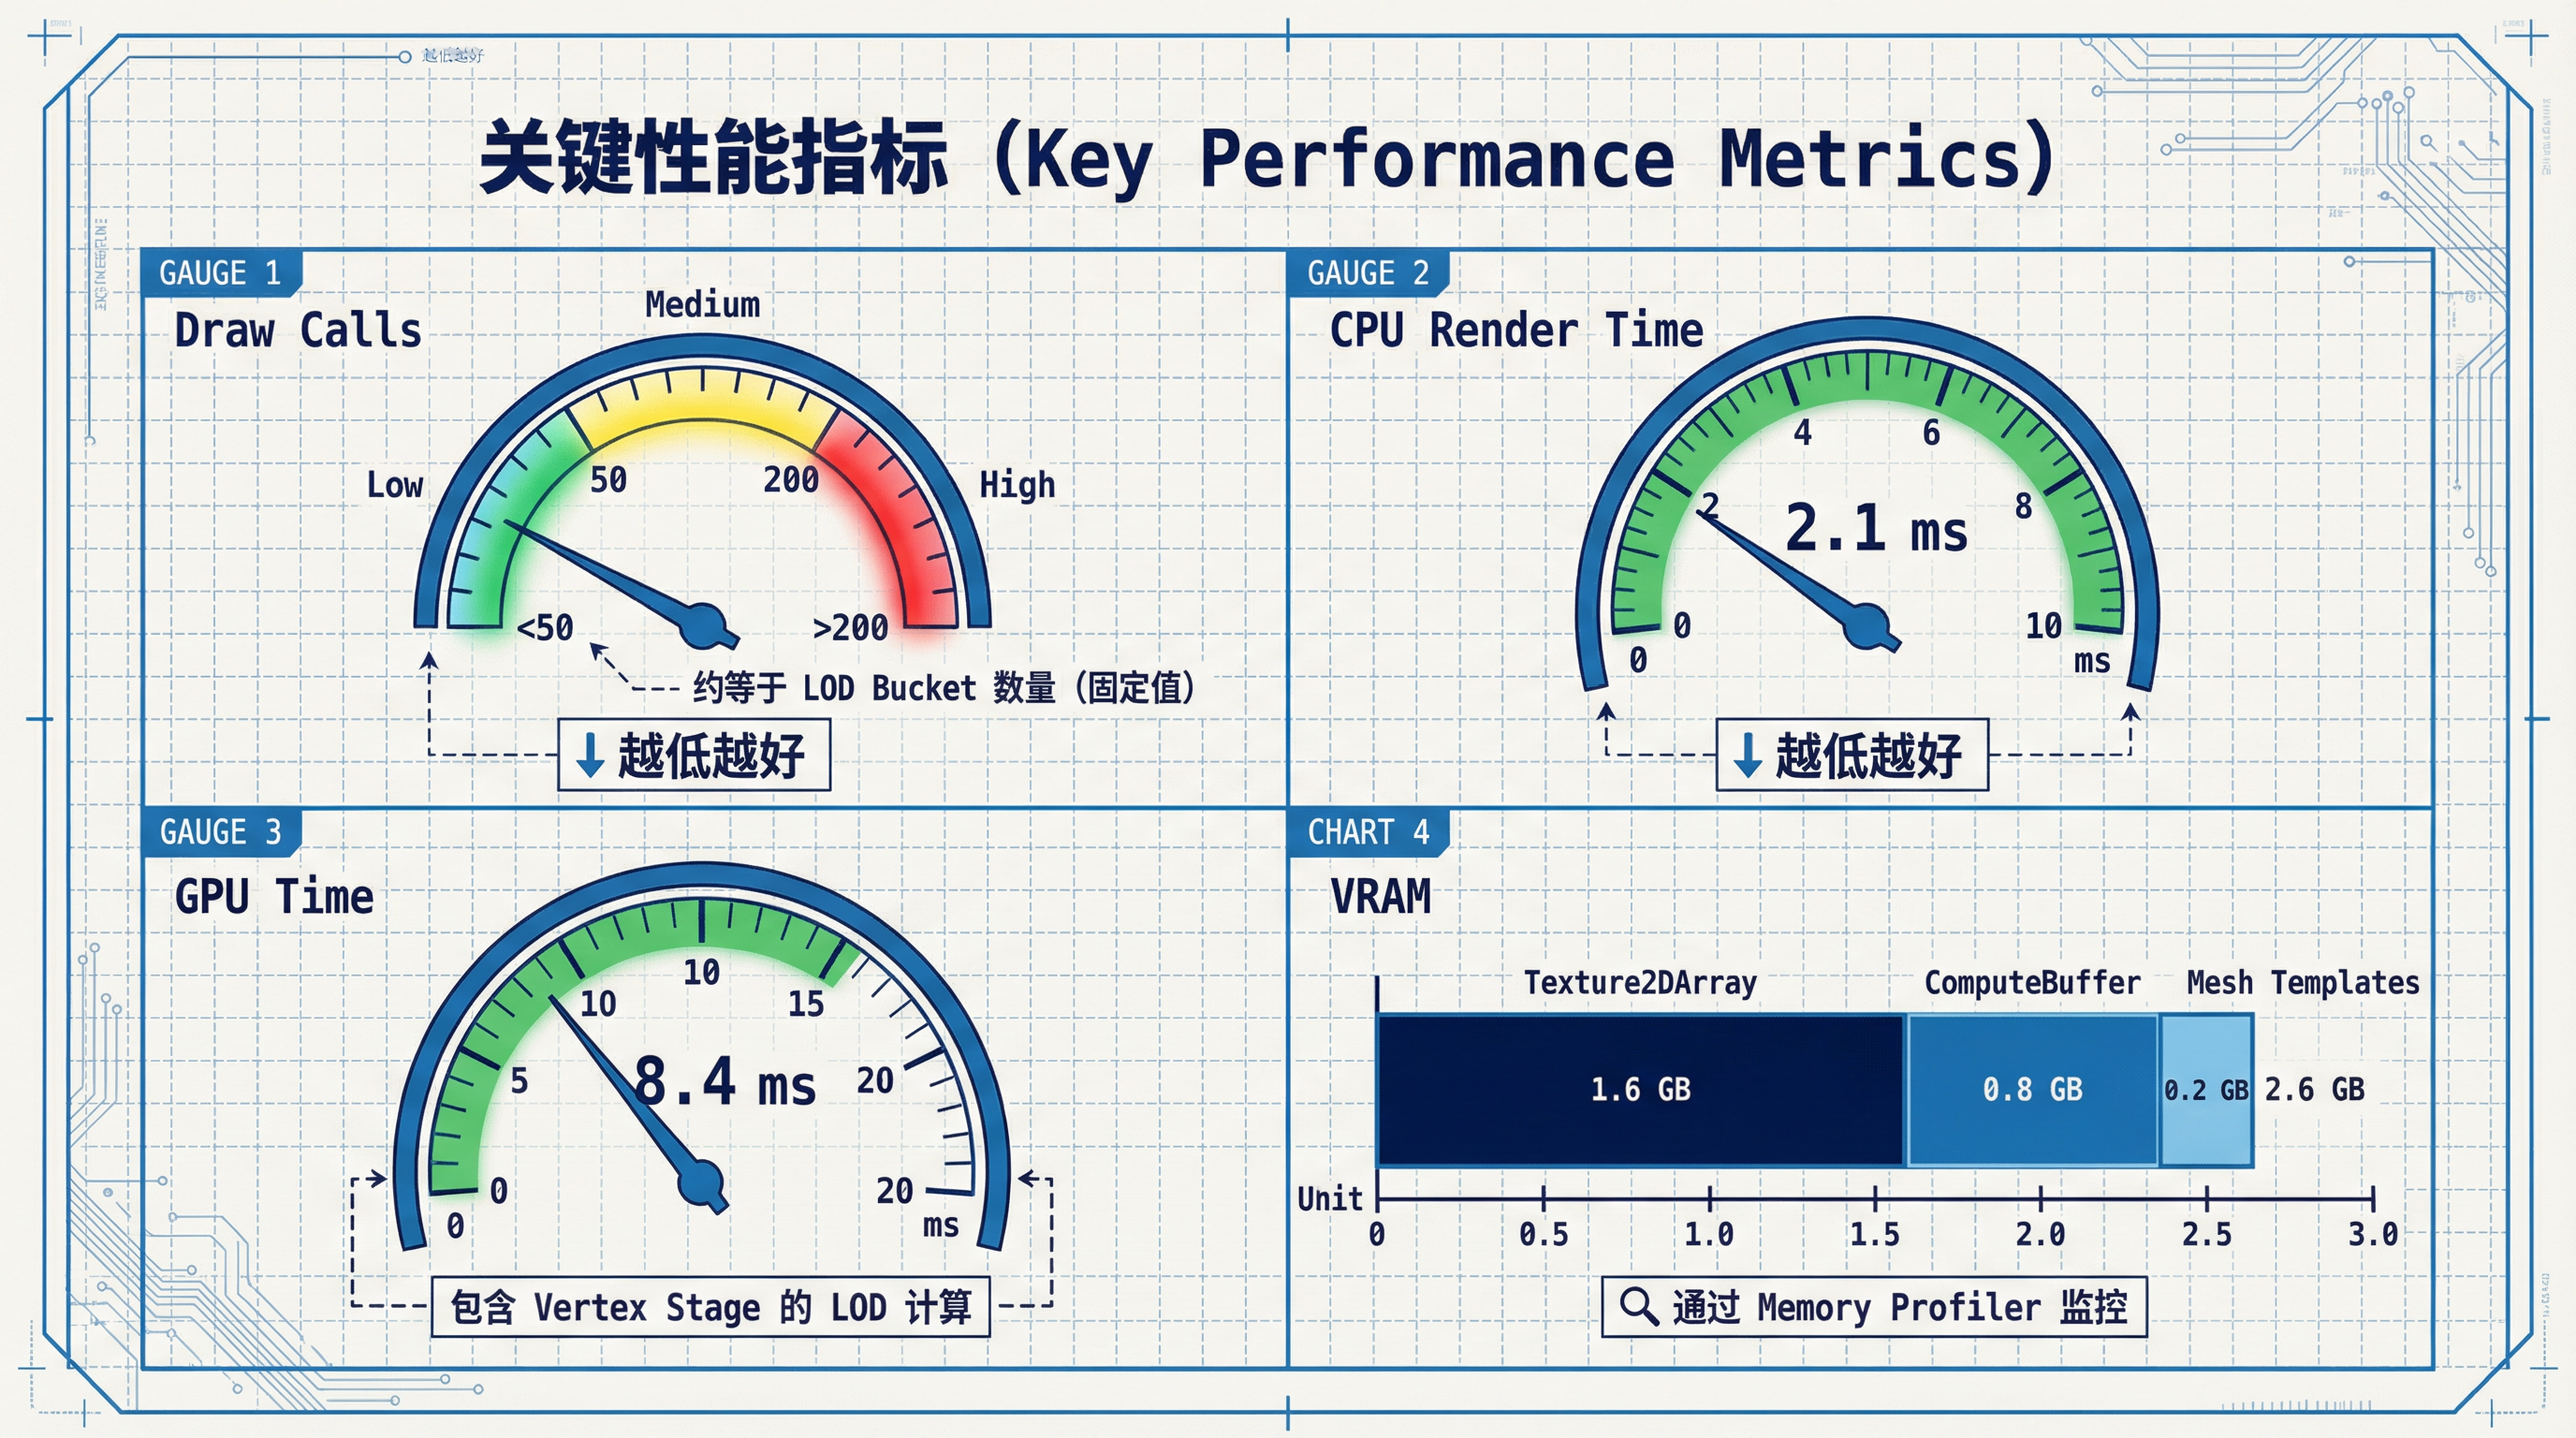
对比基线覆盖以下性能指标:
Draw Call / SetPass:通过 Frame Debugger 或 RenderDoc 进行分析。
CPU Render Thread time:利用 Profiler Timeline 监测。
Culling/LOD/Batch time:通过自定义 Profiler marker 监测。
GPU time:通过 GPU profiler 或 RenderDoc 分析。
VRAM:通过 Memory Profiler 与资源统计进行分析。
5.1.2 Debug 视图
系统必须保留以下调试能力:LOD 可视化(LODIndex)、Bounds 可视化(Sector/Section)、边界问题定位(边界顶点 LOD 值、邻接索引一致性)和 Profiler marker。
5.2 约束与失败模式
尺寸关系:TerrainSize / SectionSize / NumQuad 必须满足整数约束。
Transform:默认 axis-aligned;旋转或非一致缩放需要额外适配。
Array 容量:Texture2DArray slice 数受平台限制,超大世界需要分区与 paging。
Layer 上限:实时混合的 Layer 数量需要系统级上限。
动态编辑:运行时频繁修改 Heightmap/Splatmap 会引入同步与拷贝开销,需要低频或局部更新策略。
5.3 演进方向
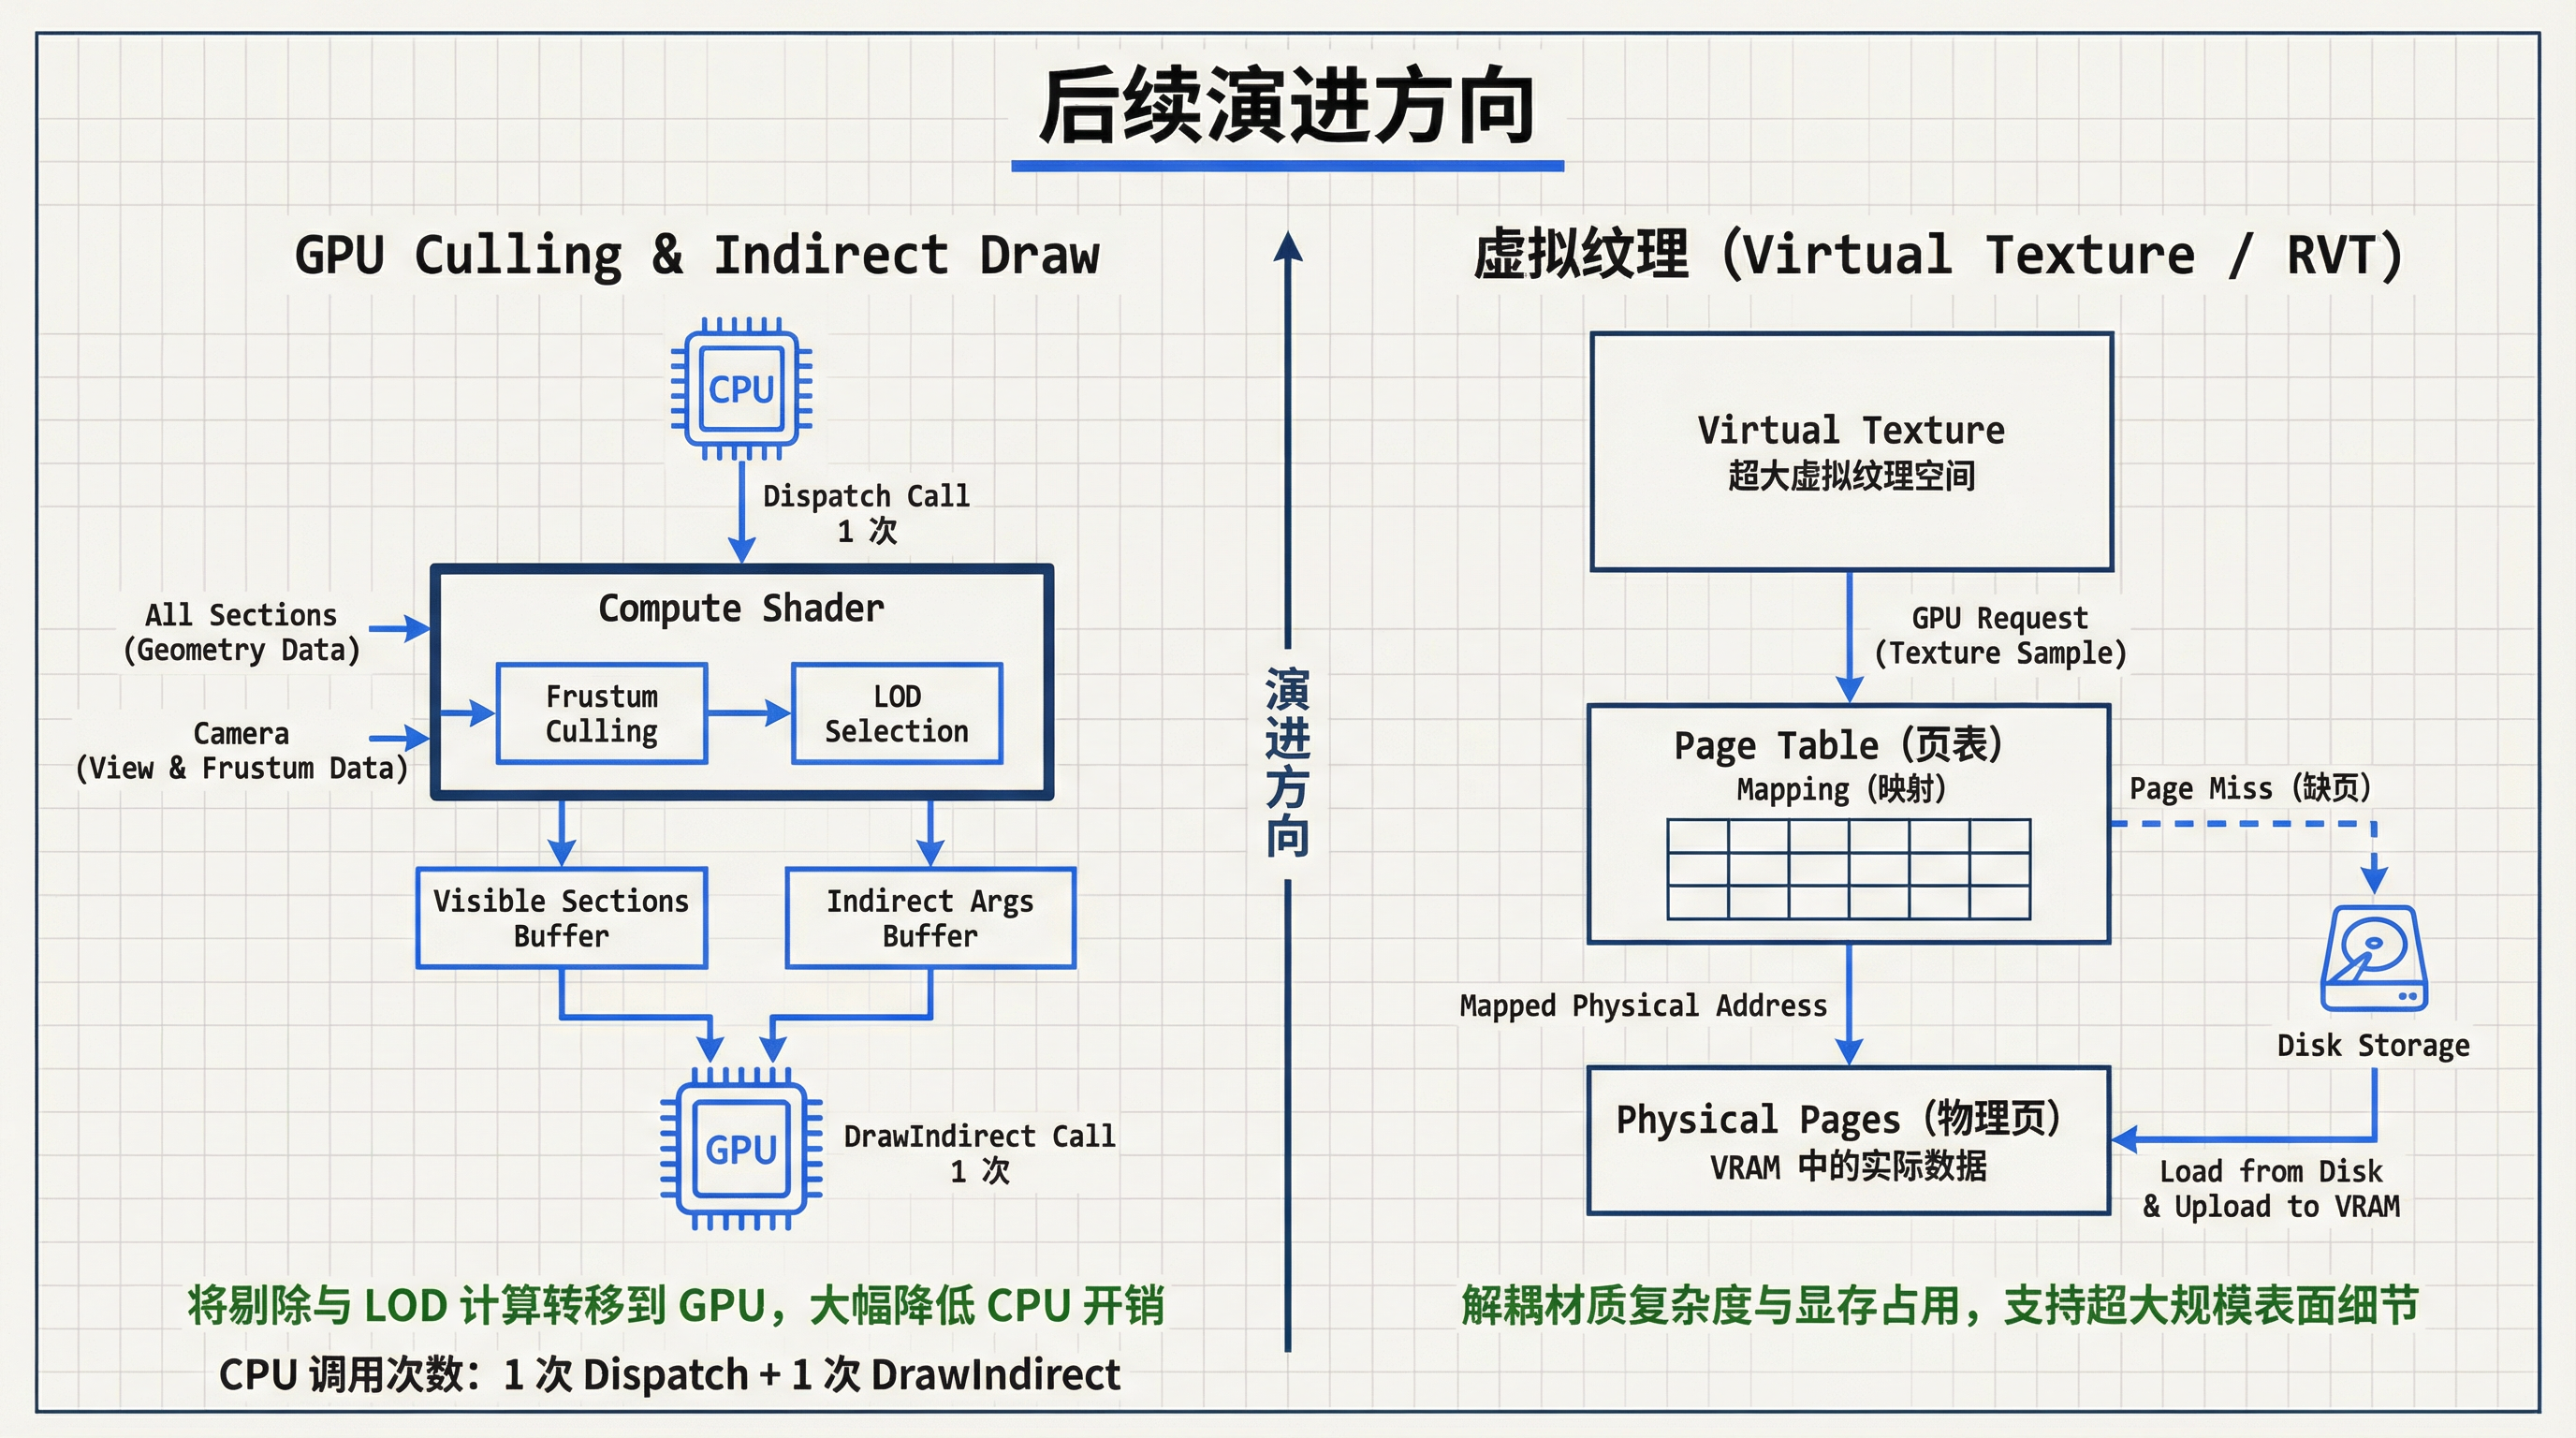
GPU Culling + Indirect Draw:演进路径可拆分为 Compute Frustum Culling、Compute LOD、GPU 构建 indirect args 和 Indirect Draw。每一步都应具备独立收益与可度量指标。
Virtual Texture / RVT:当 Layer 与表面逻辑规模上升时,优先将复杂度迁移到 VT/RVT,以降低实时采样数与带宽压力,并通过 paging 与 cache 机制控制成本。这条路径的核心是 Page Table、Physical Cache 与 Feedback 三件事,属于另一套按需缓存体系,这里不展开。