

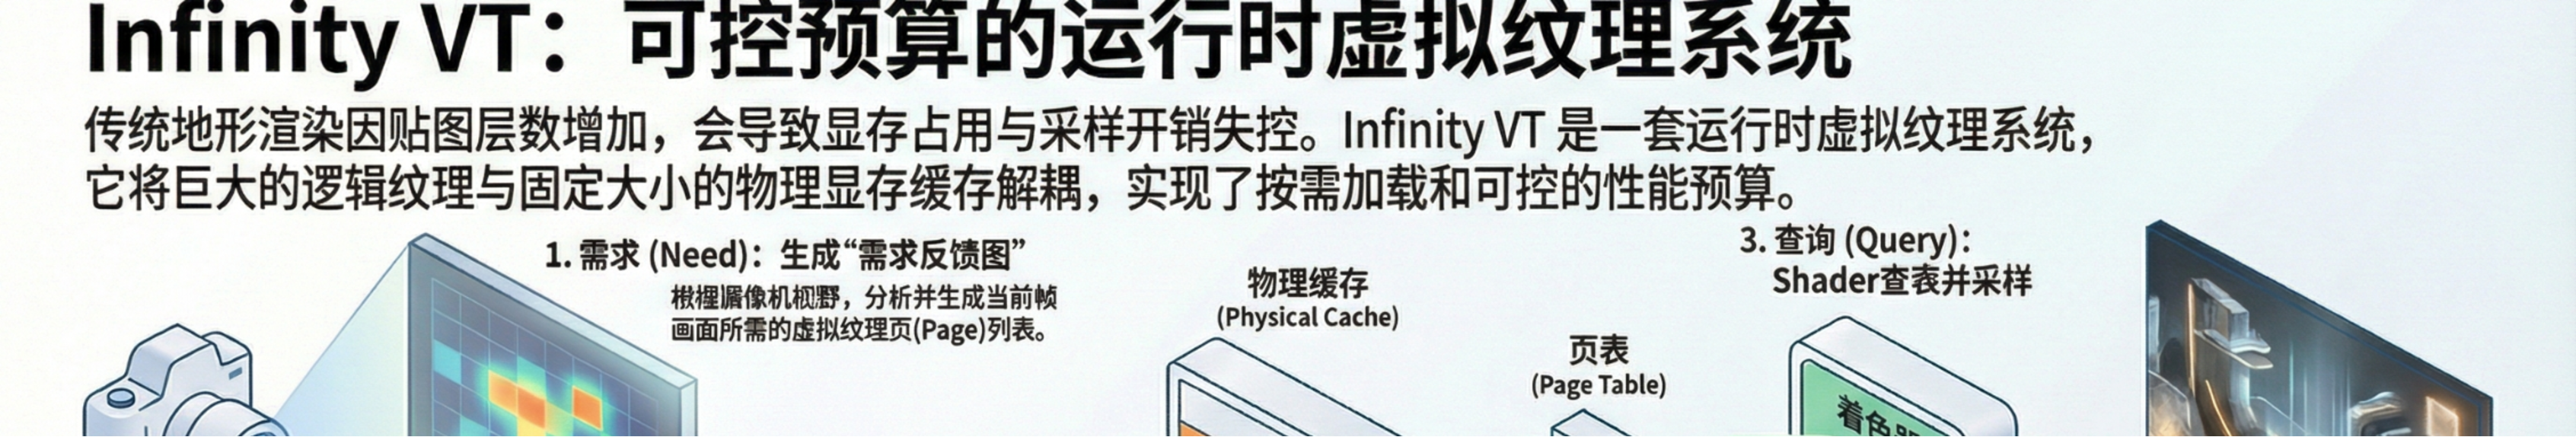
InfinityTerrain 的表面系统使用 Texture2DArray 存储 Splatmap 与 Layer Map(Albedo、Normal 等),通过索引访问减少状态切换。这套方案在中等 Layer 数量下工作正常,但 Layer 数量增长后会遇到两道硬墙:一是运行时采样数与贴图驻留的线性增长——URP/Built-in 下每增加 4 个 Layer 就多一个 pass,HDRP 单 pass 最多支持 8 个;二是为整张地形准备高分辨率 Layer 贴图所引发的 VRAM 膨胀,地形面积越大、Layer 越多,全量常驻的显存代价越不可控。
我实现了一套 Runtime Virtual Texturing(RVT)系统来解决这个问题,内部命名 Infinity Virtual Texture。它的核心目标不是把地表渲染变成"一张更大的贴图",而是把"地表感知分辨率"与"GPU 实际驻留的像素数据"解耦:通过 Page Table + Physical Cache 的按需填充机制,每帧渲染成本收敛到一组明确可控的预算参数,不再随地形面积或 Layer 数量线性增长。
一、VT 基础与设计边界
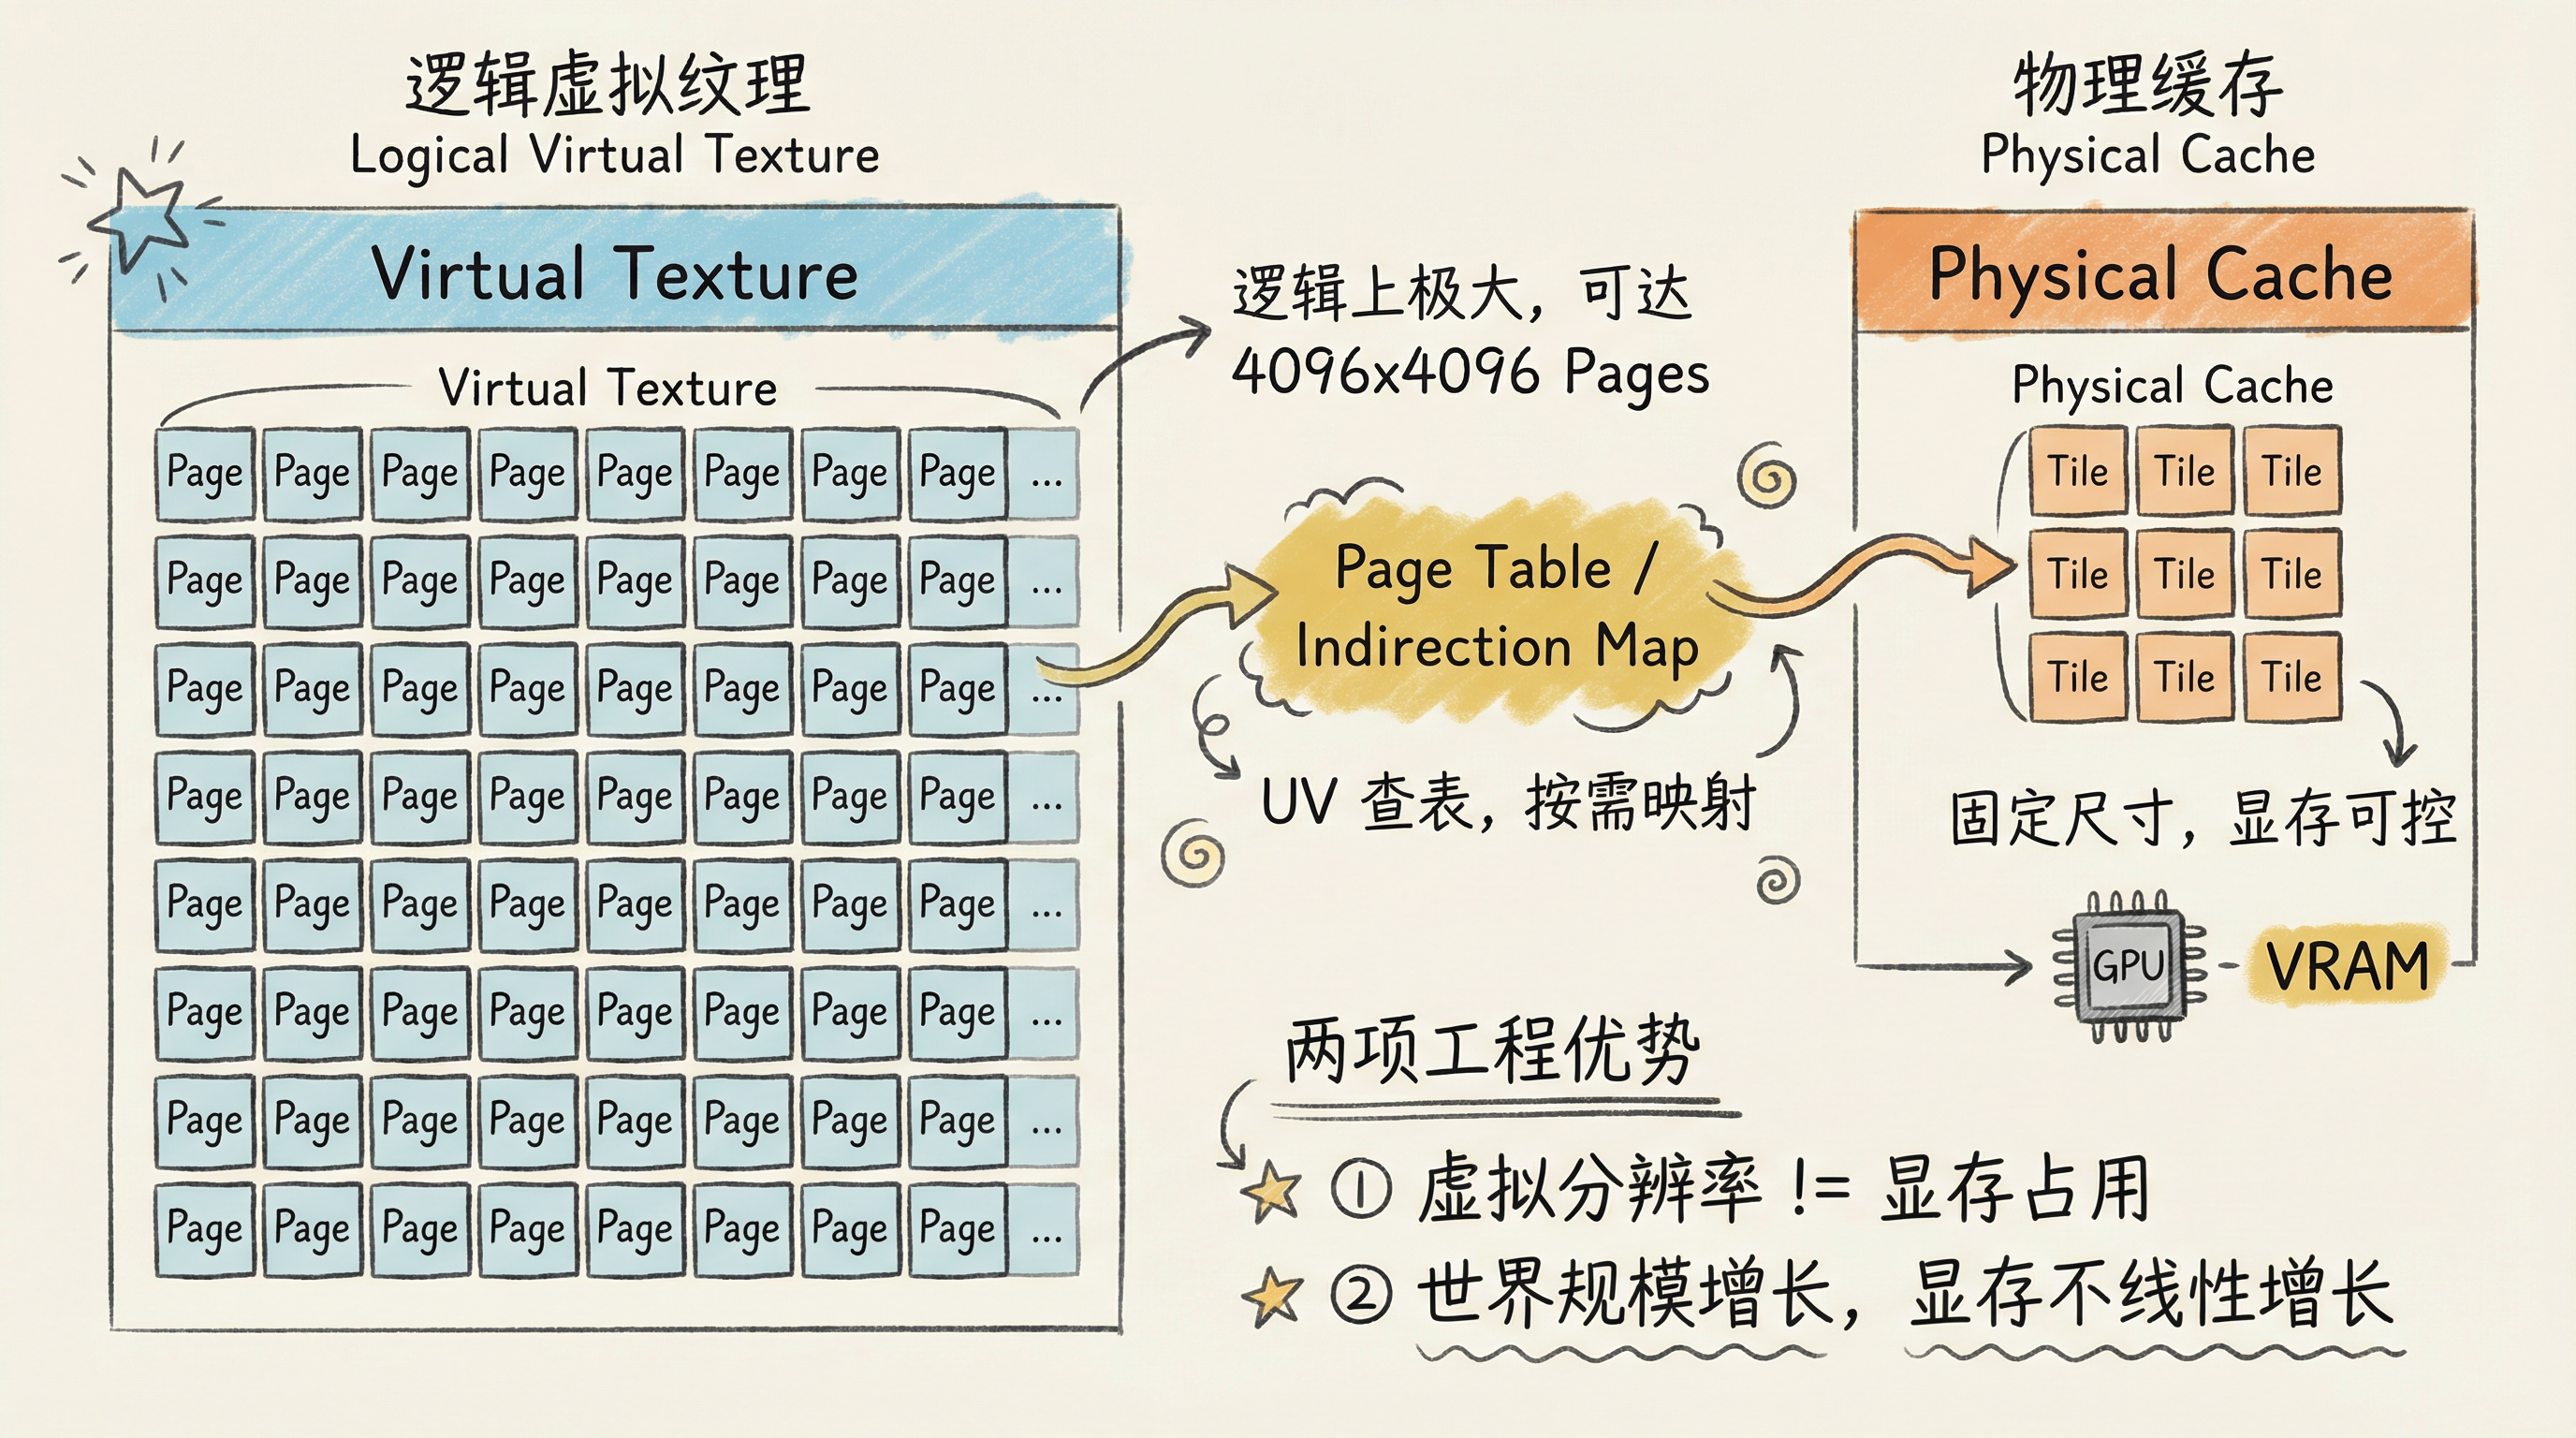
Virtual Texture (VT) 的工程定义是:将一张逻辑上极大的纹理作为按需填充的缓存系统。典型实现是将纹理划分为等尺寸的 Page,并维护一个 Page Table(也称 Indirection Map)。一个固定大小的 Physical Cache 用于存储当前驻留的 Tile 数据。在纹理采样过程中,原始 UV 不直接访问虚拟纹理,而是首先查询 Page Table 以获取 Tile 在 Physical Cache 中的位置,随后进行采样。
这带来两个直接好处:
虚拟分辨率的上限由 Page Table 的规模与编码精度决定,不受 Physical Cache 大小的限制。
显存占用由 Physical Cache 的容量决定,纹理和世界规模的增长不会导致显存需求的线性增加。
1.1 Border/Padding 的必要性
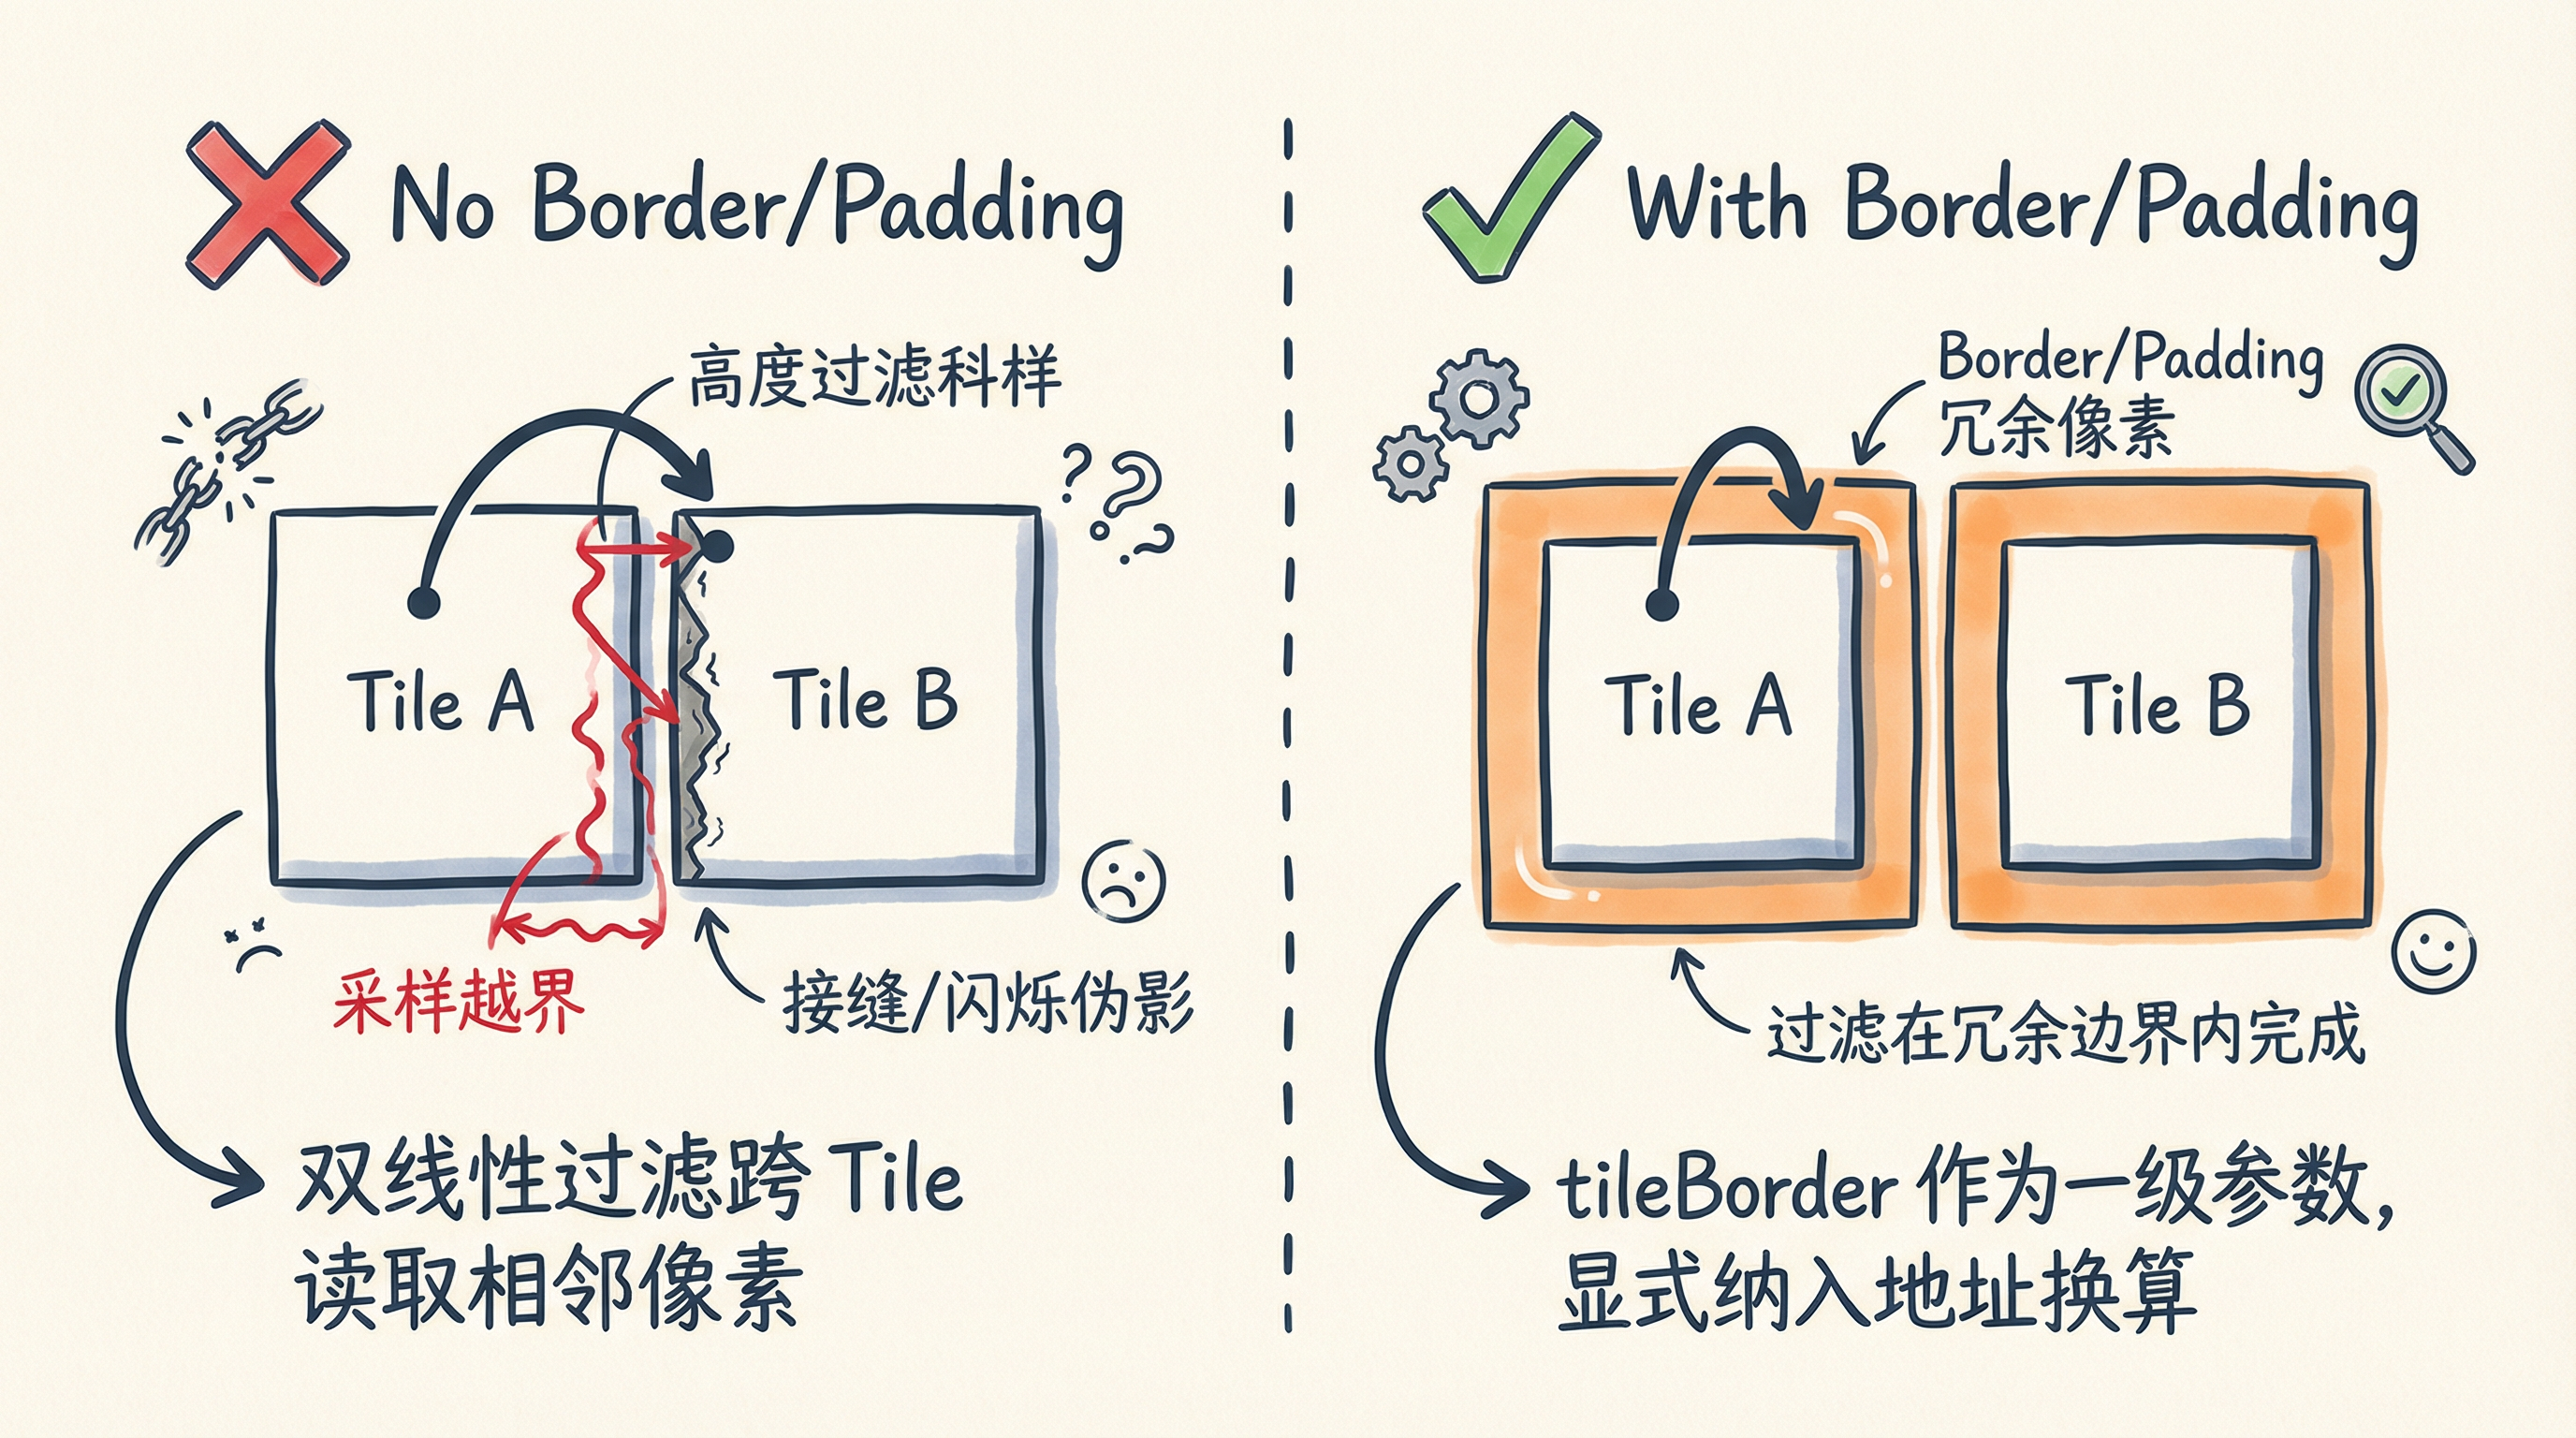
VT 采样面临 Tile 边界过滤问题。硬件执行双线性或各向异性过滤时会跨越 Tile 边界读取相邻 Tile 的像素,可能导致视觉伪影,如接缝或闪烁。常见做法是为每个 Tile 增加 Border/Padding,确保过滤操作在冗余边界内完成。
Border 定义为一级参数,并将其显式纳入地址换算公式与缓存布局。这消除了"存在 Border 但 UV 未偏移"的隐性错误。
1.2 Runtime Virtual Texturing 与 Streaming Virtual Texturing 的区别
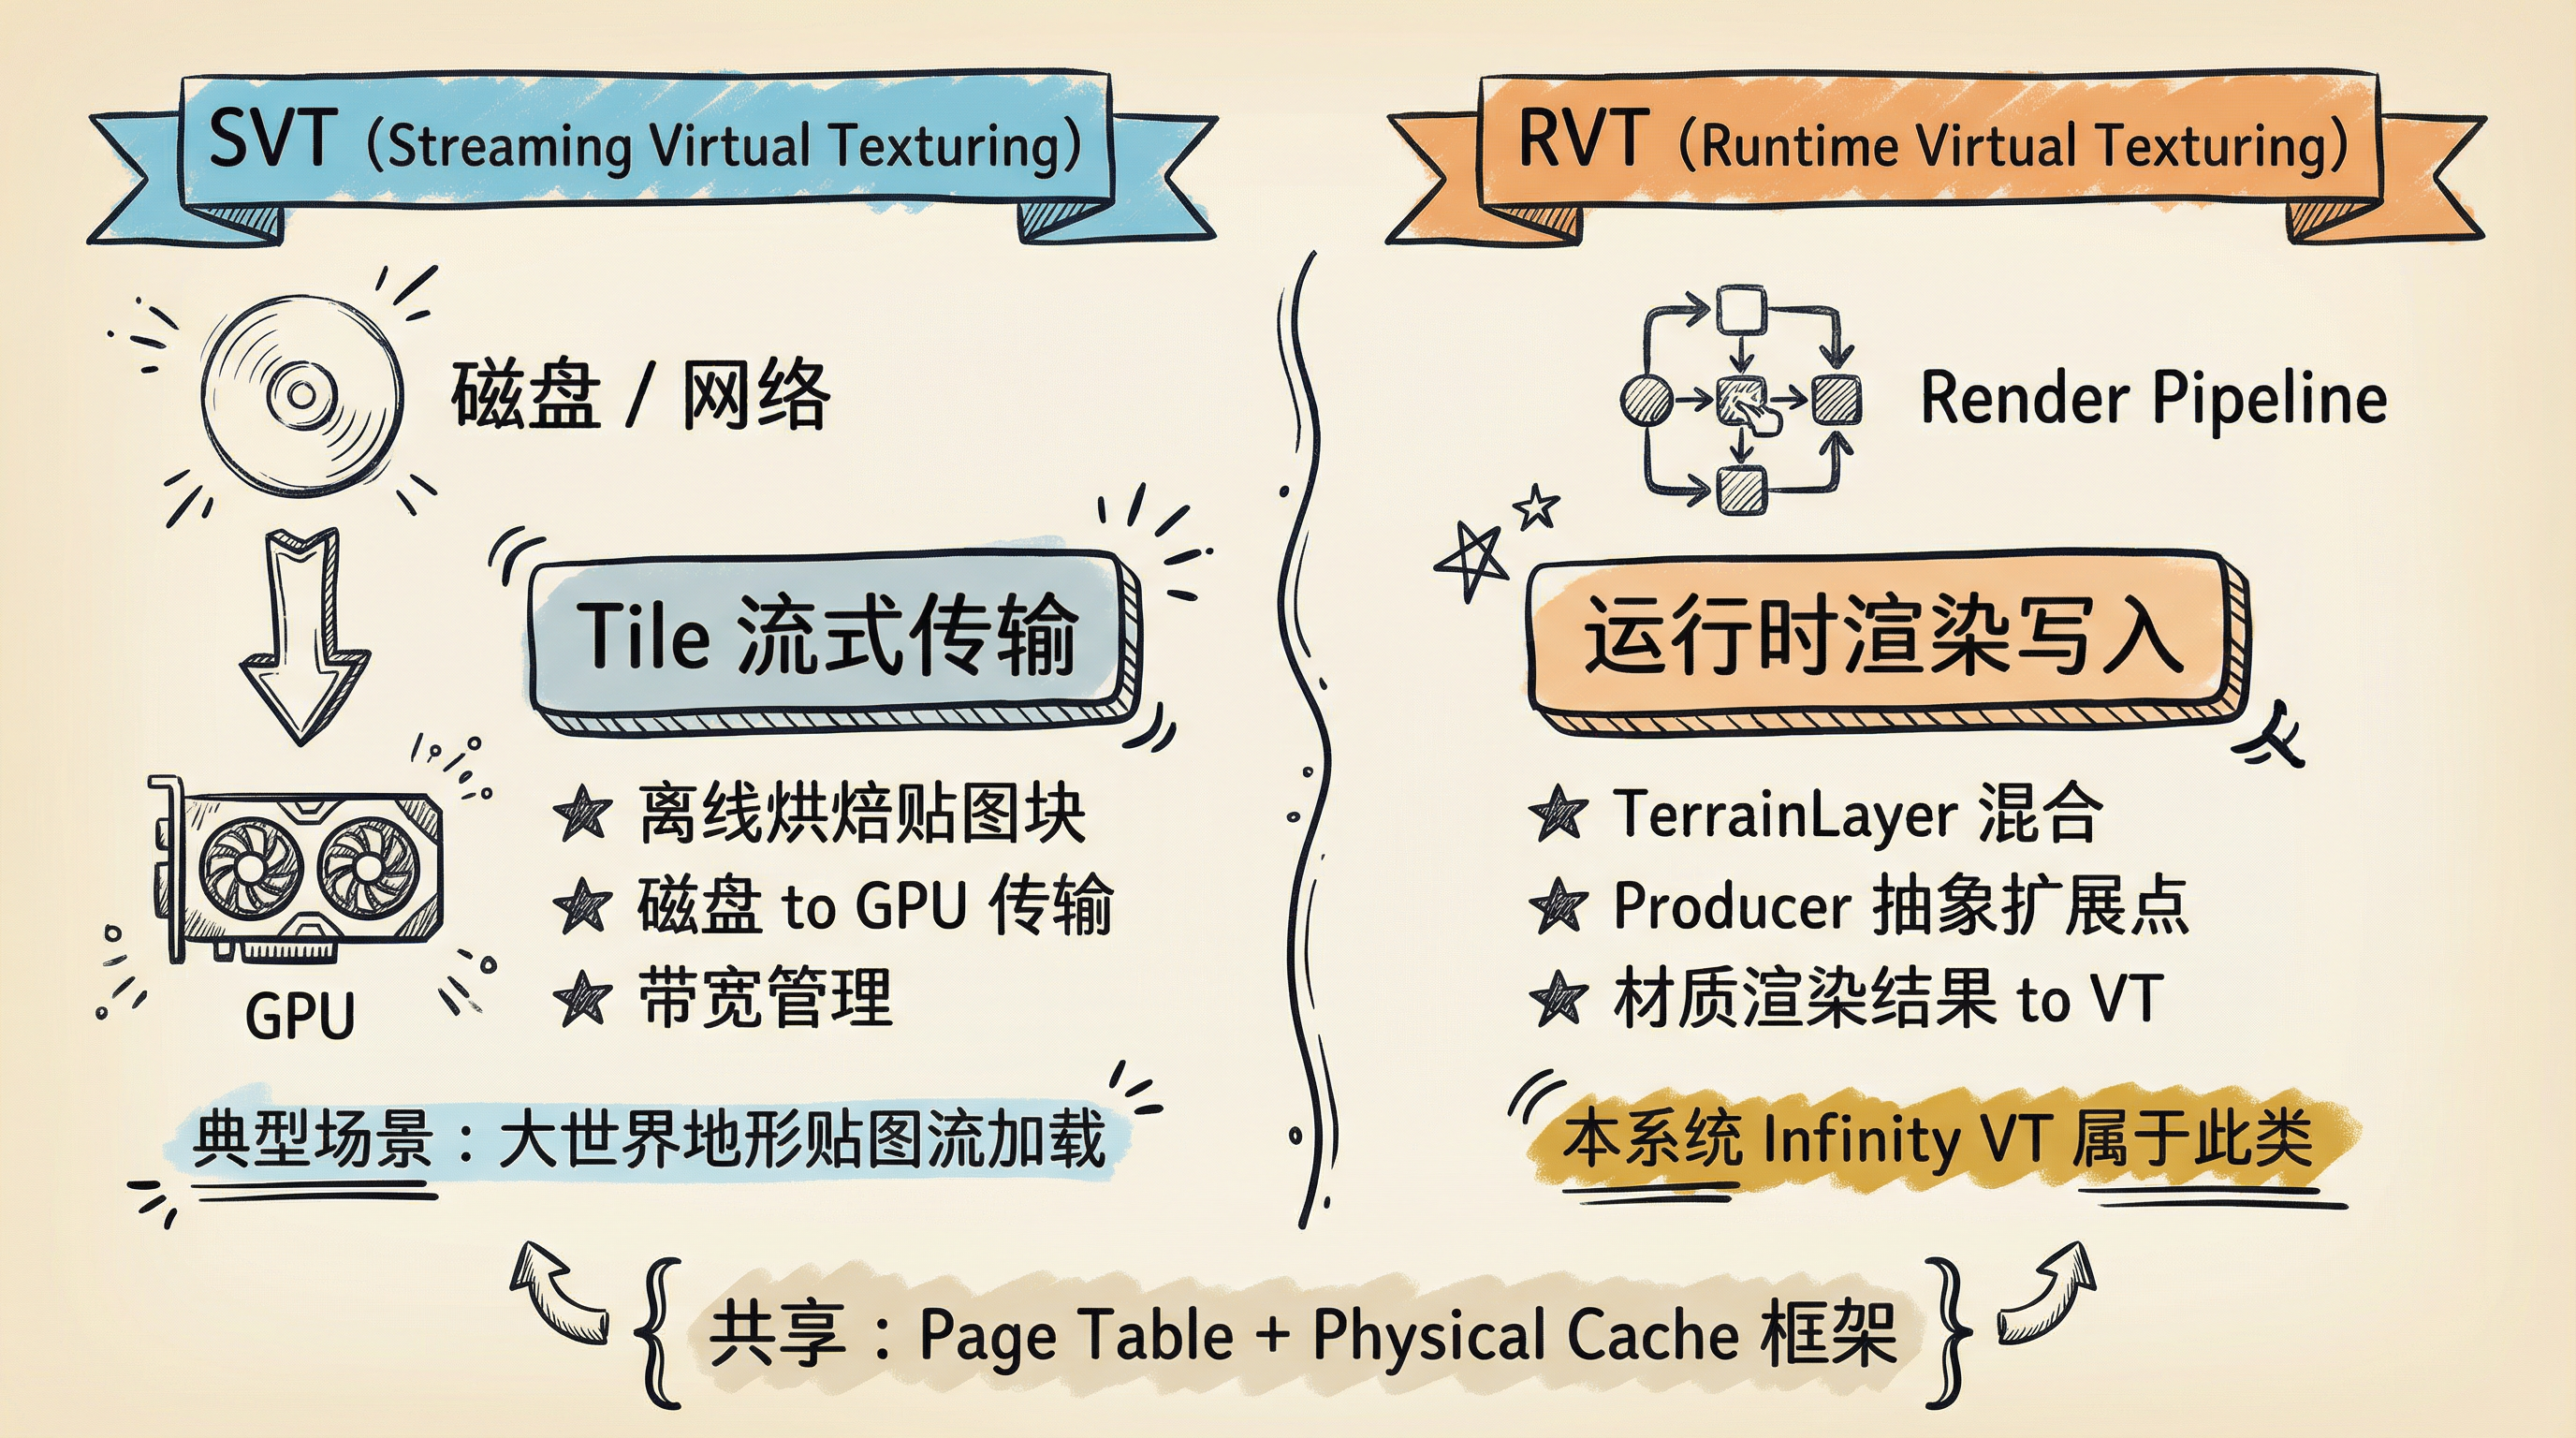
Streaming Virtual Texturing (SVT) 的核心职能是处理"磁盘/网络到 GPU"的 Tile 流式传输。Runtime Virtual Texturing (RVT) 则侧重于"运行时将特定材质或几何体的渲染结果写入虚拟纹理"。在 Unreal Engine 的 RVT 工作流中,典型步骤包括创建 Runtime Virtual Texture Asset、放置 RVT Volume,并配置场景组件将材质结果写入并从中采样。
系统属于 RVT 语义范畴:Tile 内容来源于运行时的渲染组合(例如地表层混合),而非从磁盘读取离线烘焙的贴图块。"Producer 抽象"作为扩展点保留,允许未来将离线资源或其他来源接入同一套 Page Table 与缓存框架。
1.3 核心目标
显存预算可控:Physical Cache 采用固定尺寸设计,从而实现对显存成本的上限控制。
按需更新:仅对当前视野(以及可控的预取区域)所需的 Page 进行更新。
质量连续性:确保画面质量的连续性,避免在视角快速转动或移动时出现明显的清晰度或模糊度跳变。
模块解耦:Producer 模块与缓存机制应保持解耦,以支持后续集成离线资产、网络/磁盘流式传输,或更复杂的 Page 生成路径。
管线无关:设计不依赖于特定的 Render Pipeline 组织方式,核心机制被抽象为 Render Pass、Shader Pass、GPU Readback、Cache 和 Page Table 等组件。
1.4 非目标
Shader 的组织形式不受限于任何特定框架;系统仅要求实现 Feedback 输出和 VT 采样函数这两部分核心契约。
1.5 术语与数据结构
系统涉及以下核心概念。Virtual Texture (VT) 指逻辑层面的巨型纹理,其基本组成单元为 Page,每个 Page 与特定 Mip 级别关联。Physical Cache 是存储实际像素数据的固定尺寸物理纹理缓存,Page Table 则维护 Virtual Page 到 Physical Tile 的映射关系。运行时,Feedback 机制(产物为 Feedback RT)编码当前帧采样所需的 Page ID 及 Mip 级别信息,驱动按需加载;Physical Cache 通过 LRU (Least Recently Used) 策略执行页面置换;每个 Tile 边界保留一圈 Border/Padding 冗余像素,用于消除采样伪影。
典型的 VT 系统需求处理流程为:渲染阶段输出 Page 请求数据,随后在 CPU 或 GPU 端进行分析,并触发纹理加载与更新操作。例如,GDC Trials Rising 的技术分享中提出了一种实现方案:使用独立的渲染 Pass 生成 Page Request Render Target (RT),其中存储 (x, y, mip) 信息,并由 CPU 对该 RT 进行分析以生成加载请求。Infinity VT 将上述流程解耦为 Need、Supply 和 Query 三个独立的子系统。
二、Need / Supply / Query 链路设计
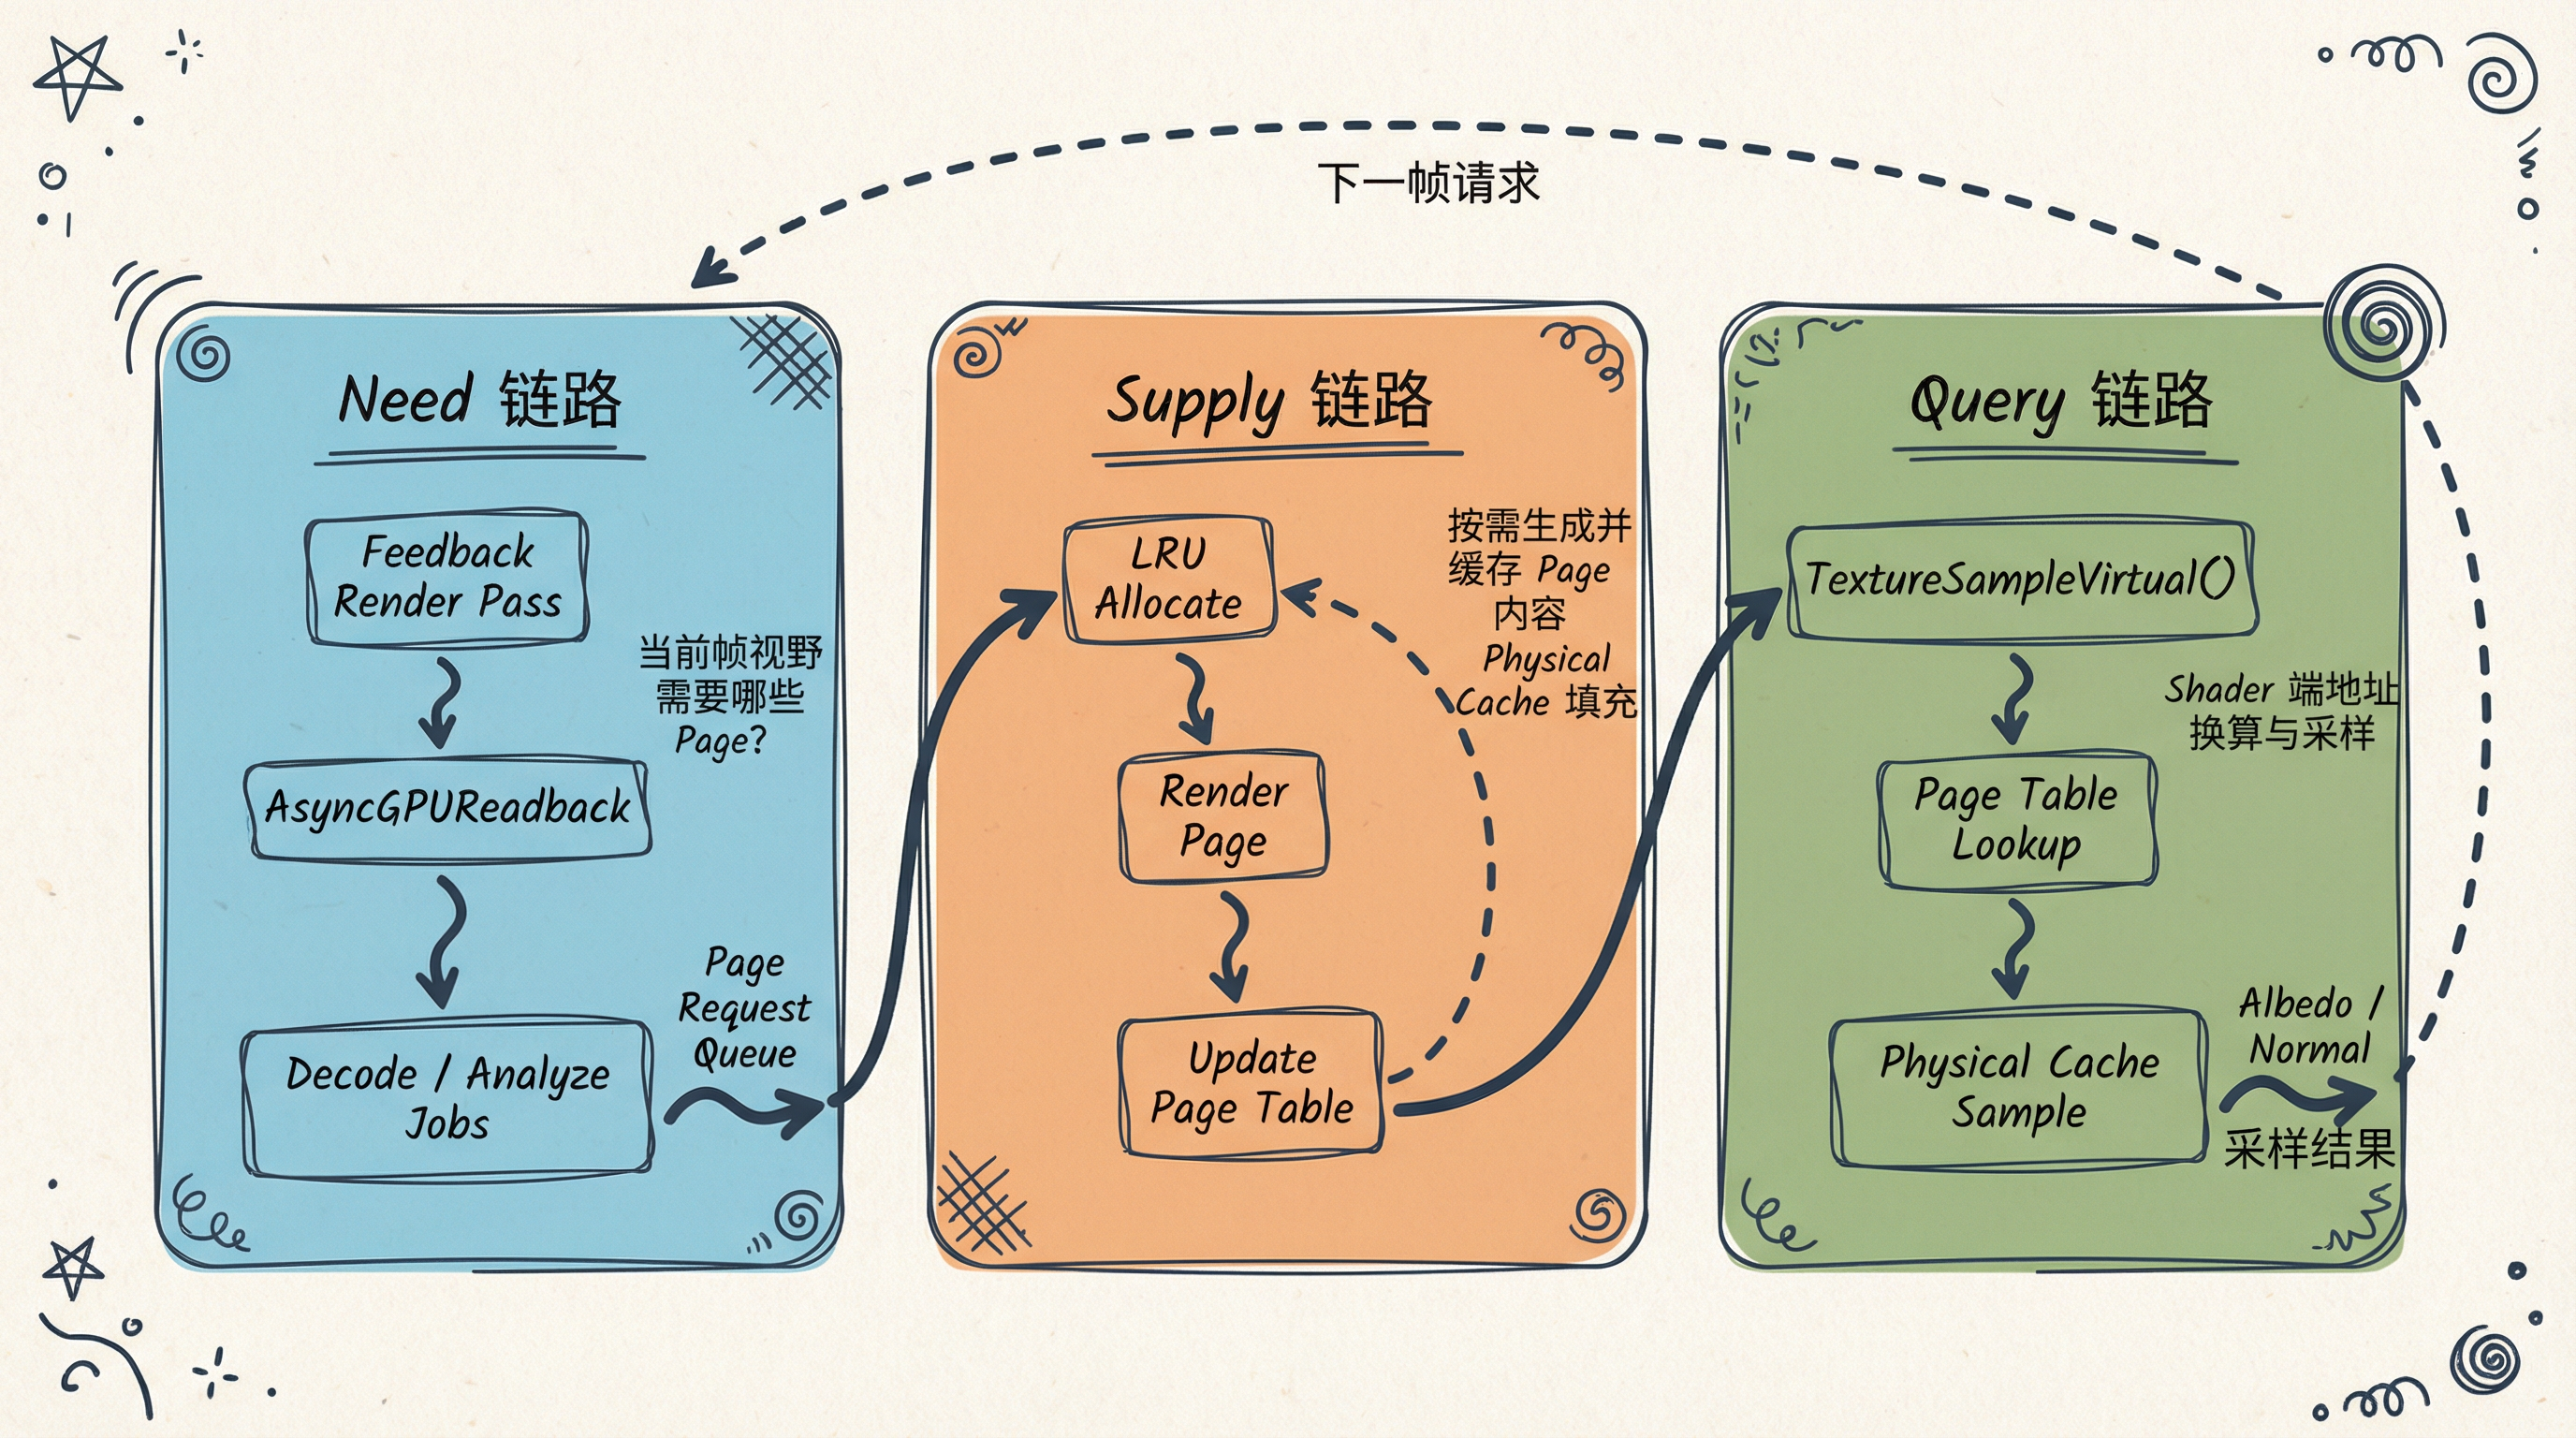
系统的核心数据流围绕 Page Table、Physical Cache 与 Feedback 机制构建,将虚拟纹理的"需求生成(Need)" -> "内容供给(Supply)" -> "数据查询(Query)" 三个环节清晰地解耦。
Page Table Texture 负责将 Virtual Coordinate 映射至 Physical Tile。
Physical Cache 用于存储 Tile 的像素结果,例如当前实现中的 Albedo 和 Normal RenderTexture。
Feedback、AsyncGPUReadback 和 LRU 机制共同驱动 Page Request 和缓存置换。
Tile 内容在运行时通过渲染生成,并写入 Physical Cache。
三、运行时对象与数据契约
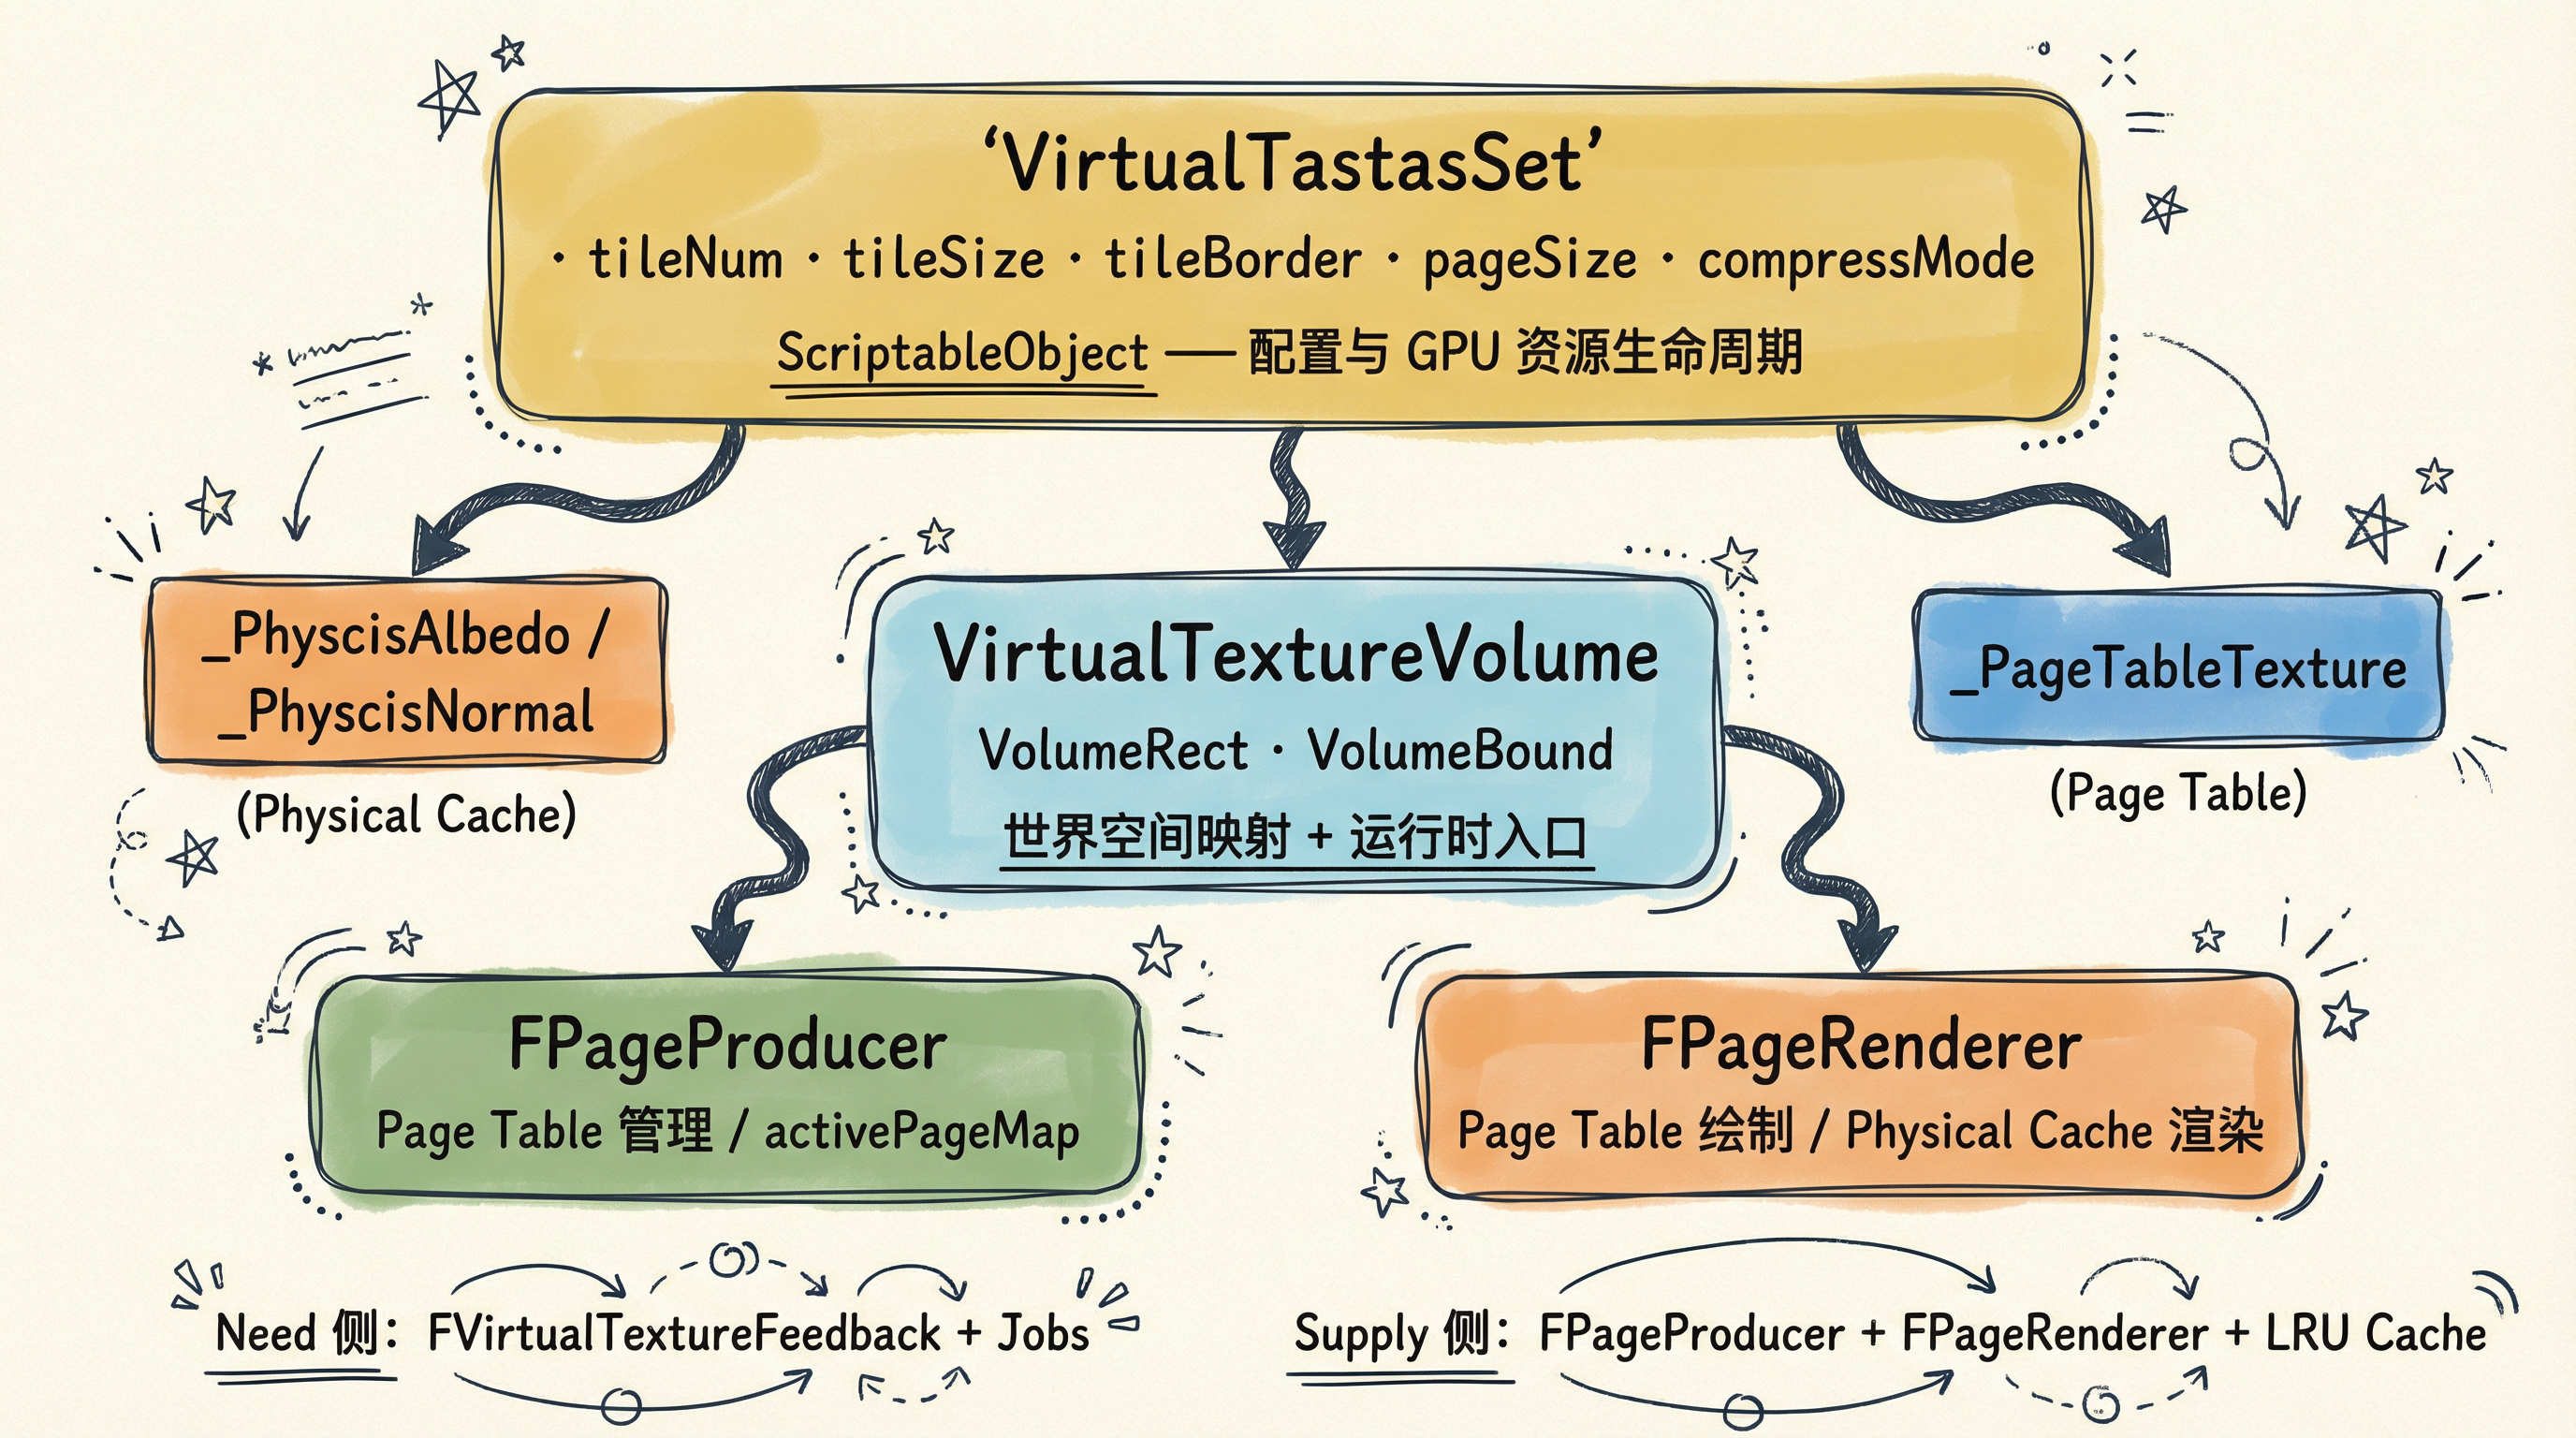
运行时对象划分为配置资源、空间入口、需求侧与供给侧四类。
3.1 VirtualTextureAsset:配置与 GPU 资源生命周期
VirtualTextureAsset 采用 ScriptableObject 统一管理核心参数与 GPU 资源创建。核心参数是:
tileNum:物理缓存 Tile grid 的边长,决定槽位总数为 tileNum * tileNum。
tileSize:Tile 的有效像素边长。
tileBorder:Tile 周围的 padding 像素。
pageSize:Page Table 分辨率(以 Page 为单位的边长)。
compressMode:压缩模式抽象开关,当前作为扩展点预留。
它创建并维护这些 GPU 资源:
Physical Cache:例如 _PhyscisAlbedo、_PhyscisNormal。
Page Table:例如 _PageTableTexture,格式为 RGBA8,采用 Point 采样。
全局参数:_VTPageParams、_VTPageTileParams 等,用于 Shader 地址换算。
3.2 VirtualTextureVolume:空间映射与运行时入口
VirtualTextureVolume 定义 RVT 覆盖的世界空间范围,并将世界坐标映射至虚拟 UV。关键参数为:
VolumeRect = (xMin, yMin, width, height):世界空间投影矩形,用于计算 [0,1] 范围内的虚拟 UV。
VolumeBound = (centerX, centerY, centerZ, size):用于 Shader 侧进行范围 mask,以避免越界采样。
它持有两个运行时核心组件:
FPageProducer:负责 Page Table 结构与活跃页映射管理。
FPageRenderer:负责 Page Table 绘制与页面渲染至 Physical Cache。
3.3 FVirtualTextureFeedback + Jobs:需求侧链路
需求侧根据当前帧画面推导出所需的页集合。链路步骤为:
Feedback Render Pass:专用的 Shader Pass,将 pageUV 与 requestMip 输出至 Feedback RT。
AsyncGPUReadback:异步回读低分辨率反馈图。
Decode/Analyze Jobs:使用 Burst Job 对回读数据进行解码、去重、过滤非法值,生成请求队列,并同步更新 LRU 活跃状态。
3.4 FPageProducer + FPageRenderer + LRU Cache:供给侧链路
供给侧根据请求队列,将页填充至有限的 Physical Cache,并同步更新 Page Table。具体操作为:
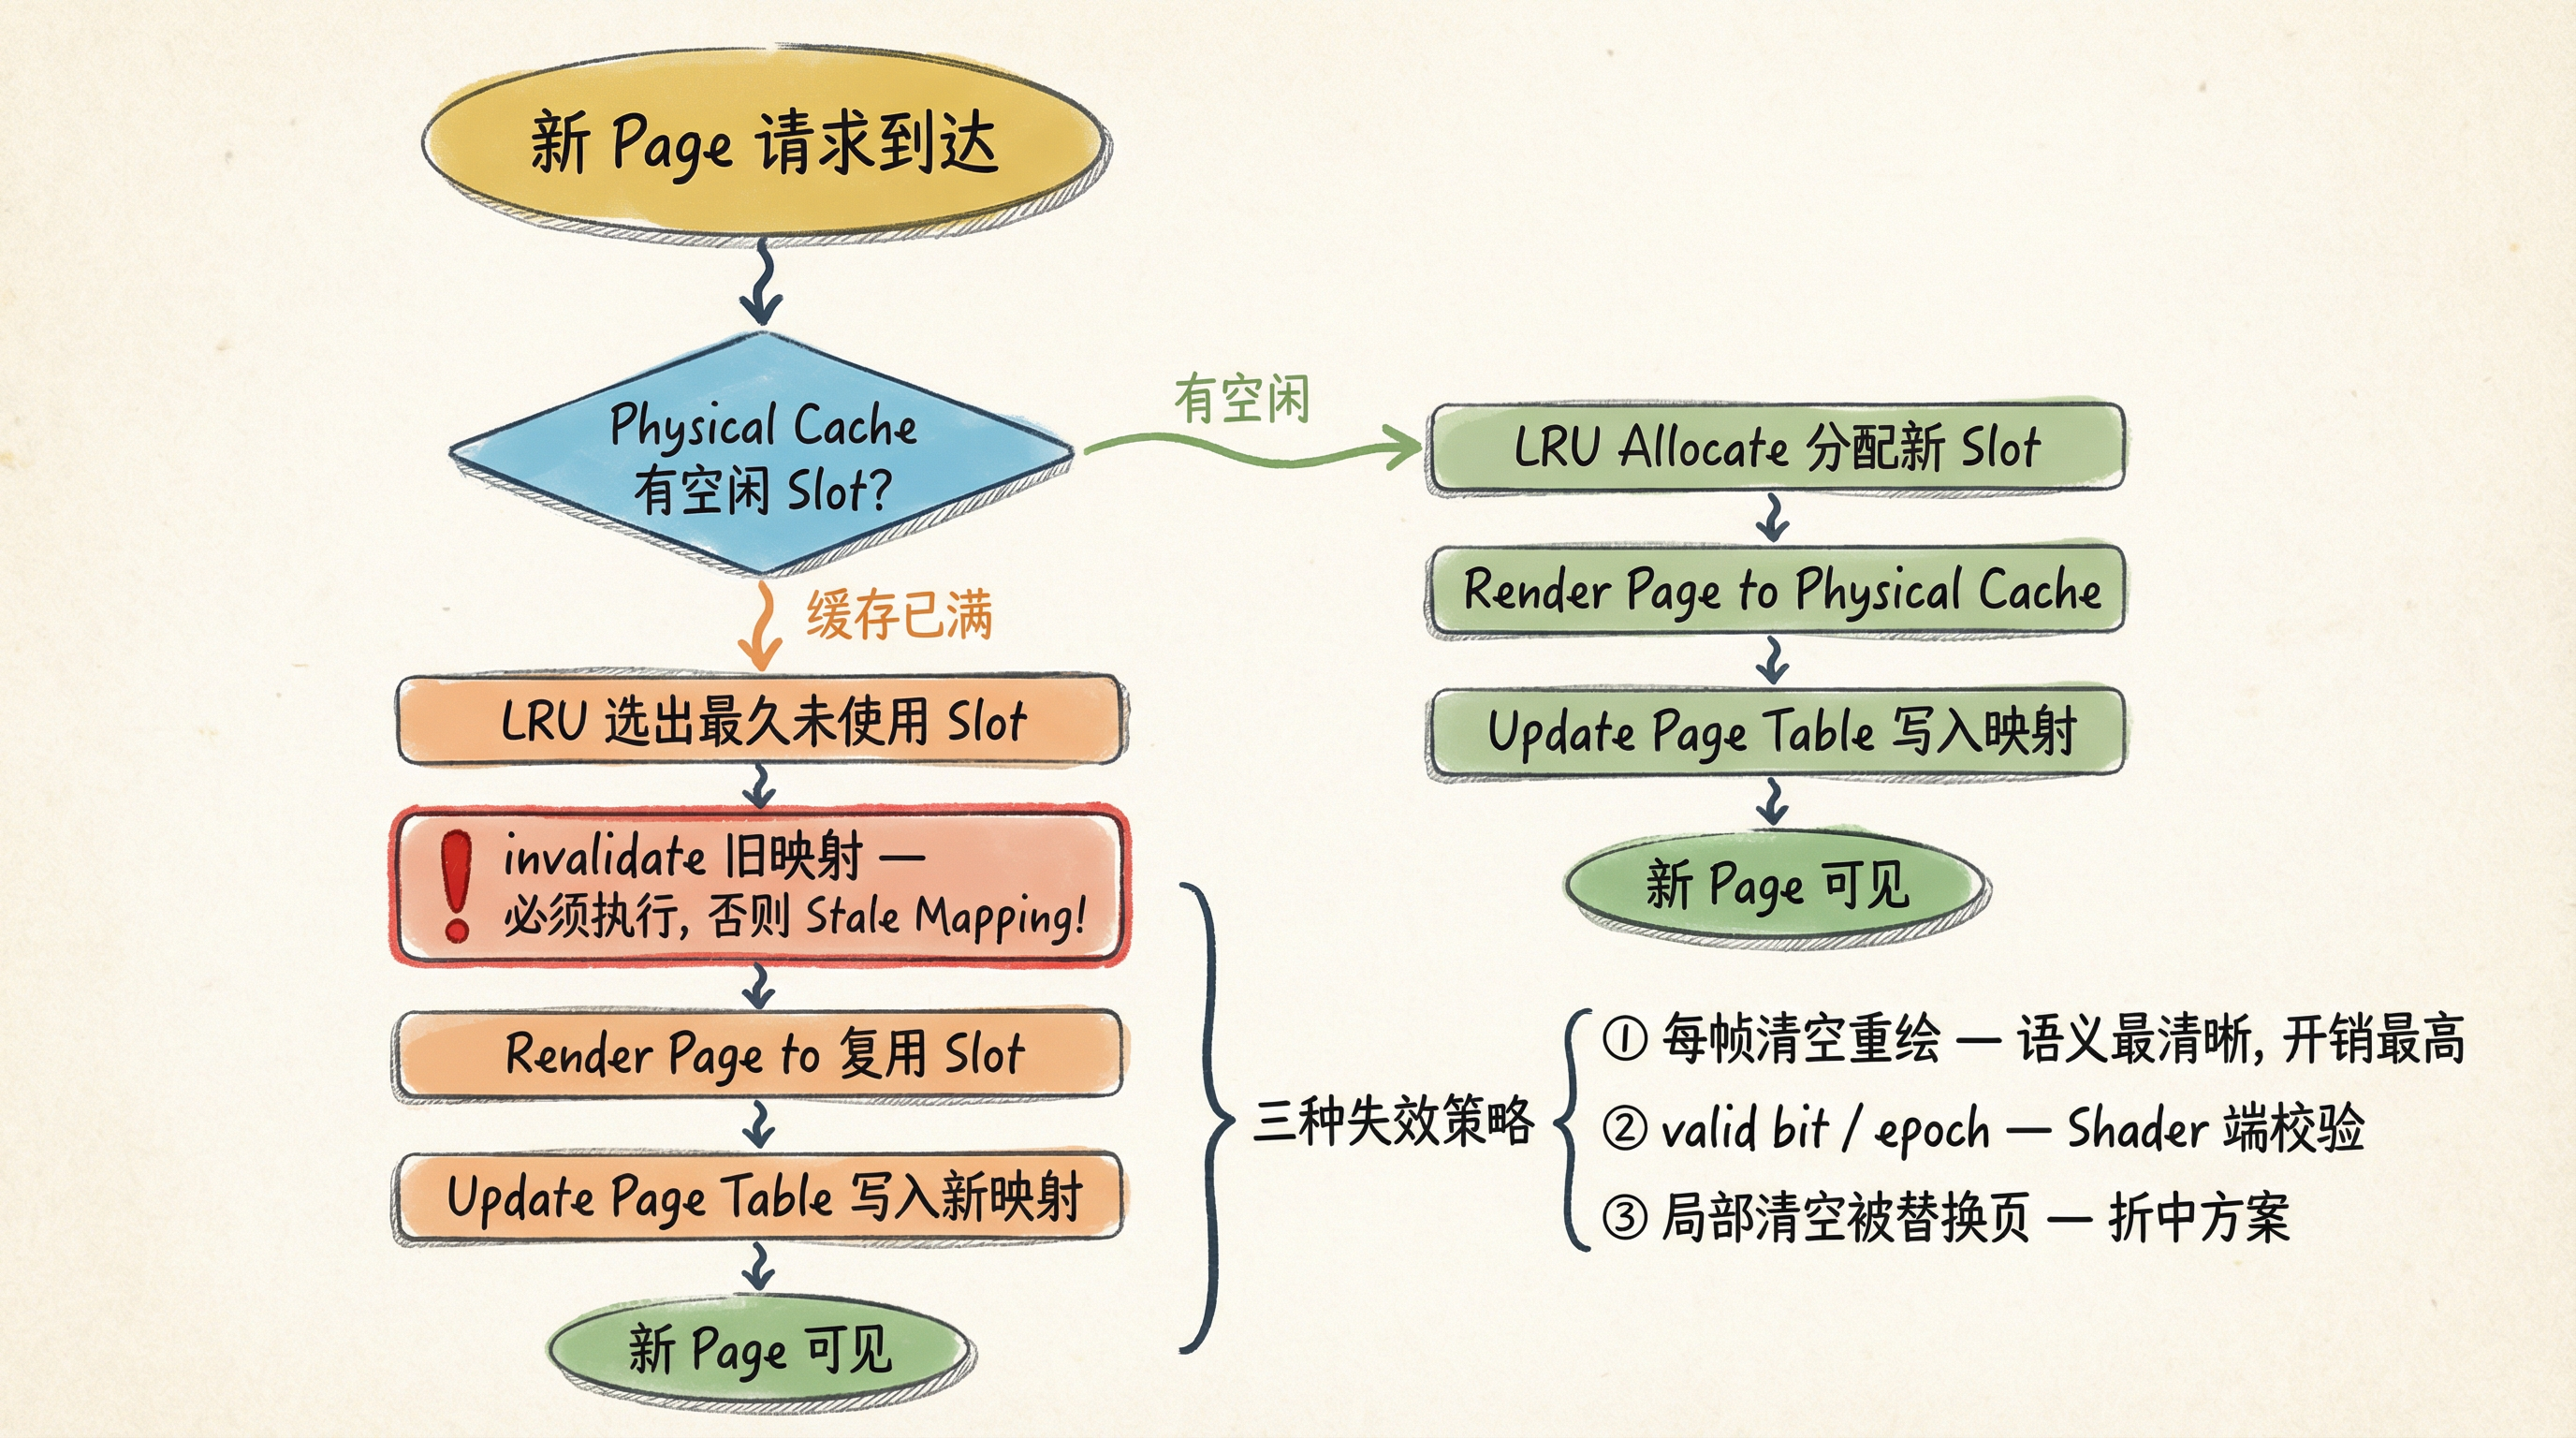
LRU Allocate:从缓存中分配一个 Tile slot 承载新页。若发生复用,旧页映射需执行 invalidate 操作。
Render Page:将页对应的世界空间区域渲染至 Physical Cache 的指定 Tile 矩形。
Update Page Table:将 virtual page 到 Tile 的映射关系写入 Page Table Texture,供 Shader 查表。
3.5 Shader Contract:CPU 与 GPU 间的数据契约
Shader Contract 定义 CPU 与 GPU 之间的数据接口,避免工程后期因非正式约定引入兼容性问题。
3.5.1 全局资源与参数
全局纹理列表
_PageTableTexture: 存储 Page Table 或 Indirection Map,采样方式为 Point。
_PhyscisAlbedo、_PhyscisNormal: Physical Cache 的输出纹理。
全局参数列表
_VTVolumeRect: 用于将世界空间坐标映射至虚拟 UV 坐标。
_VTVolumeBound: 用于定义范围 Mask。
_VTMipCount: 定义最大 Mip 级别数。
_VTPageParams: 页参数集合。
_VTPageTileParams: 页 Tile 参数集合。
_VTFeedbackParams: Feedback 参数集合。
3.5.2 编码上限约束
Shader Contract 规定了两个关键的编码上限:
Tile 坐标编码上限:Page Table 使用 8-bit 编码 Tile 坐标,这约束了 Tile 总数上限为 256 * 256。
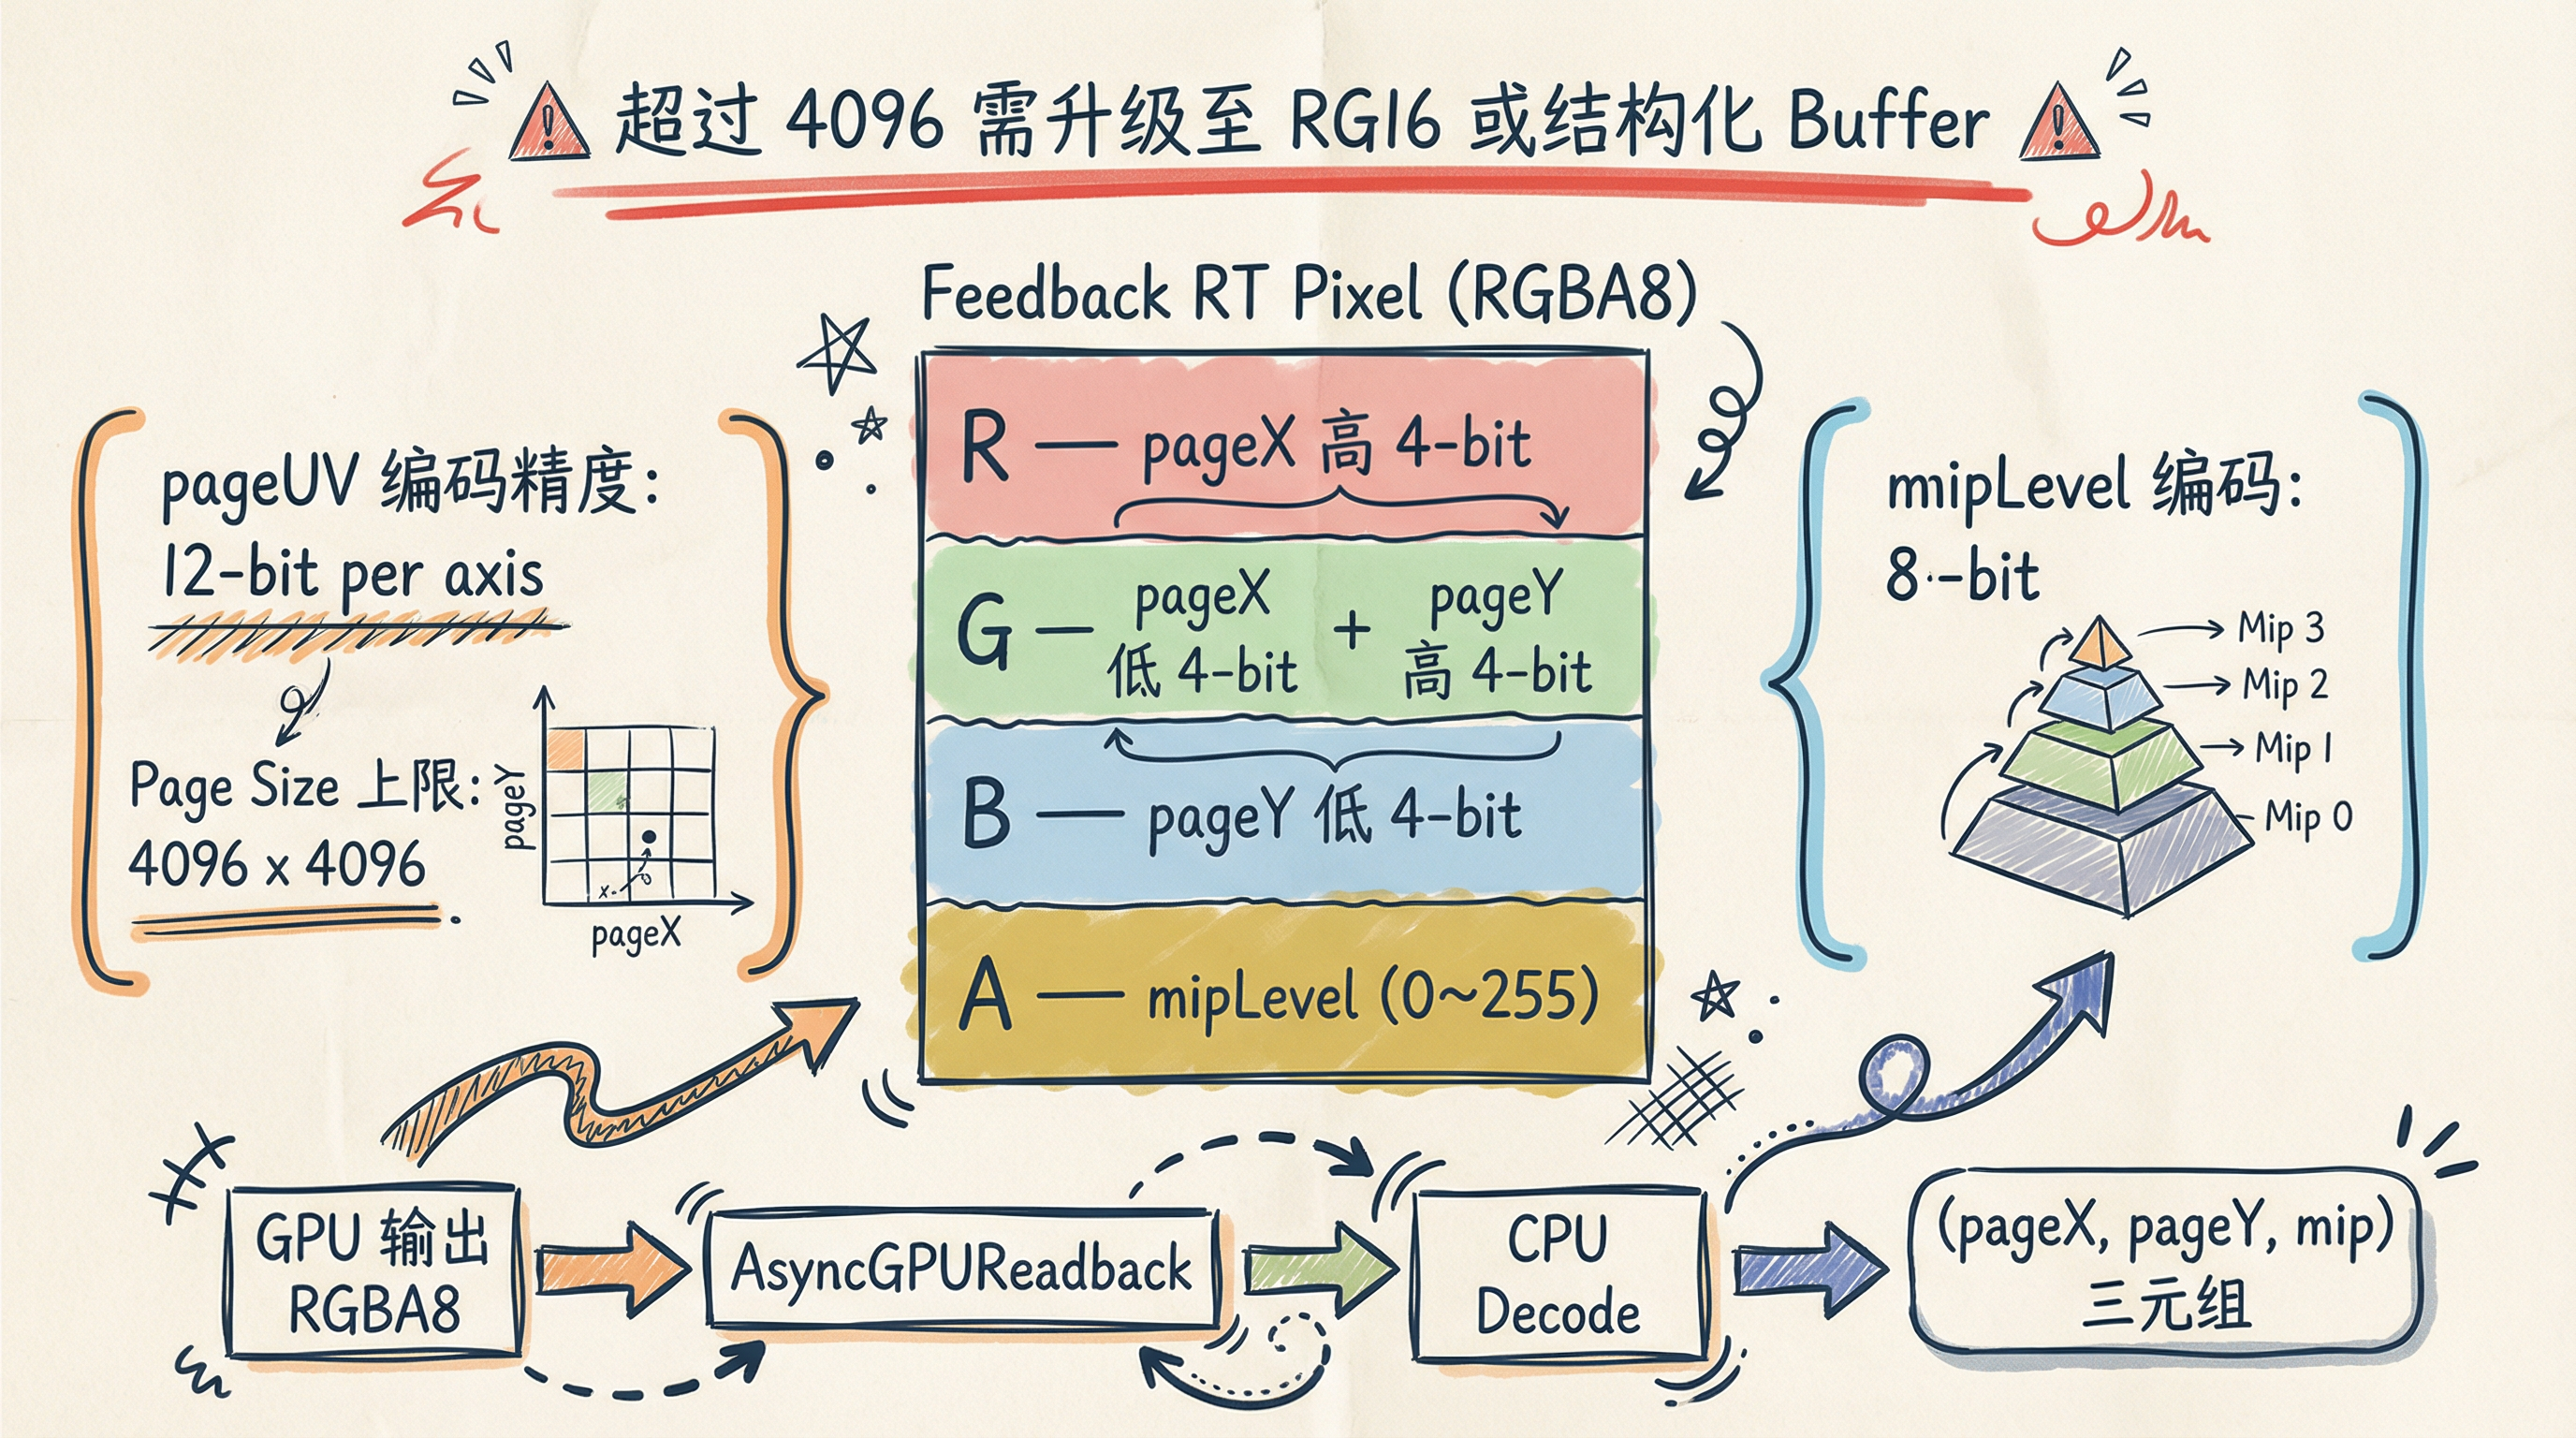
虚拟页坐标编码上限:Feedback 机制采用 12-bit 编码 Page UV 坐标,这约束了 Page Size 上限为 4096 * 4096。若需支持更大的 Page Table,则必须采用更高精度的编码或载体,例如 RG16 或结构化 Buffer。
四、Need 链路:Feedback 生成、编码与 CPU 处理
Need 链路的核心职责是根据当前视锥,生成需要被加载或保持活跃的 Page 集合。
4.1 Feedback Pass 输出内容
Feedback Render Pass 针对纳入 RVT 的地表对象执行专用 Shader Pass,输出像素级数据:
pageUV:离散化的页表坐标。
mipLevel:基于屏幕空间 footprint 推导的请求 Mip 级别。
业界实践中,通常采用较小尺寸的 Page Request RT(例如 1/4 分辨率并结合 jittering),以降低带宽和数据读回开销。Page Request 通常以 (x, y, mip) 三元组形式表达。Infinity VT 采用低分辨率 Feedback RT 方案,将数据吞吐量和系统稳定性控制在预设性能预算内。
4.2 ddx/ddy 推导 Request Mip 级别
Request Mip 级别的推导基于 ddx/ddy 指令对屏幕像素 UV footprint 的估计。先计算连续 Mip 值,随后进行 clamp 操作和 mipBias 微调,最终写入 Feedback RT。这是 VT 业界实现中的常见做法。
4.3 12-bit pageUV 与 8-bit mipLevel 的编码格式
为将 Feedback 数据封装至 RGBA8 格式的 RT,编码方案为:
RGB 通道:承载 pageUV,每轴精度为 12-bit。
A 通道:承载 mipLevel,范围为 0 至 255。
编码目标在于确保 CPU 端解码后能够稳定恢复离散的 pageXY 和 mipLevel,并有效过滤无效请求值。
4.4 请求生成的工程策略
请求生成阶段执行三类操作:
去重 (Deduplication):消除同一帧 Feedback 中重复的请求,以防止请求队列过度膨胀。
过滤 (Filtering):排除非法值和越界值,避免写入未定义的页表项。
LRU 触碰 (LRU Touch):对于已加载页的重复请求,不将其重新加入队列,但更新其在 LRU 机制中的最近使用状态。
系统稳定性通过三个控制点实现:
Feedback 对齐策略偏向保守(例如采用 ceil),以减少临界像素的漏报。
扩大 Feedback 覆盖区域,以减轻摄像机转动时的突兀感。
pageRenderLimit 限制每帧可生成的页数,以避免 GPU 成本出现尖峰。
4.5 CPU 侧反馈处理:Jobs/Burst 的数据路径
CPU 端把 Feedback RT 转换为可用的 Page Request Queue,同时控制处理开销。流程分为两个 Job:
Decode Job:负责将 RGBA8 格式的 Feedback 数据解码为 (pageId, mip) 结构。
Analyze Job:执行去重、过滤、检查页面加载状态,并将有效的 Page Request 写入请求队列,同时更新 LRU 状态。
计算开销主要取决于 Feedback RT 的像素数量与去重结构的设计。实现上,避免临时分配是硬约束:处理容器用 NativeArray / NativeList,消除热点循环中的 GC 压力。
五、Supply 链路: LRU 置换、页面生成与页表更新
Supply 链路的核心操作包含三个步骤:分配 Tile slot、将像素数据写入 Physical Cache,以及更新 Page Table 映射。
5.1 LRU 分配与失效
当请求队列中出现一个未加载的虚拟页时,LRU Replacement 流程为:
从 LRU Cache 中获取一个可用的 Tile slot。
若该 slot 先前承载其他虚拟页,则必须在 activePageMap 中使旧映射失效(invalidate)。
建立新虚拟页到该 Tile slot 的映射关系,随后进入"渲染填充"阶段。
5.2 页面渲染:将地表层渲染至物理缓存
页面内容通过运行时对地表层(TerrainLayer、Alphamap)的渲染组合生成。Supply 链路接收到页面请求参数后,确定该页对应的世界空间区域,并将该区域渲染到 Physical Cache 的目标 Tile 矩形内。
Physical Cache 的 Tile 矩形定义如下:
有效内容尺寸为 tileSize x tileSize。
周围环绕一圈 Border,形成 (tileSize + tileBorder * 2) x (tileSize + tileBorder * 2) 的实际占用尺寸。
渲染写入时,Tile 的目标区域为 tilePadding 对齐的矩形(rect)。这确保了地址换算与纹理过滤策略的一致性。
5.3 页表更新:通过 Instanced Draw 更新映射
Page Table Texture 维护着 virtual page 到 physical tile 的映射关系。更新策略为:
遍历 activePageMap,为所有活跃页生成 instance 数据。
使用 instanced draw 指令,将映射信息绘制到 Page Table Texture 对应的 cell rect 区域。
Page Table 当前使用 RGBA8 格式编码映射信息:
R 通道:存储 tileX 坐标(0..255),量化为 tileX / (tileNum - 1)。
G 通道:存储 tileY 坐标(0..255),量化为 tileY / (tileNum - 1)。
B 通道:存储 mipLevel(0..255),量化为 mipLevel / (mipCount - 1)。
A 通道:保留,可用于存储 valid bit 或 epoch/版本号。
5.4 页表失效语义:三种实现策略
当 Tile slot 被复用时,若旧映射未及时失效,Shader 可能读取到 Stale Mapping,导致采样到错误内容。明确的"失效语义"是这个设计的关键点,有三种策略:
每帧清空:每帧清空 Page Table,随后重绘所有活跃映射。语义清晰,但计算开销较高。
Shader 端校验:在 Page Table 中写入 valid bit 或 epoch 信息,并在采样时由 Shader 端显式校验。避免了全量清空,但要求 Shader 具备 fallback 机制。
局部清空:维护一个"被替换页列表",并对列表中页对应的 rect 进行局部清空。开销介于前两者之间。
六、Query 链路:Shader 地址换算与采样
VT 采样在 Shader 端通过固定入口函数(例如 TextureSampleVirtual())实现,包含地址转换与纹理采样两个核心步骤。
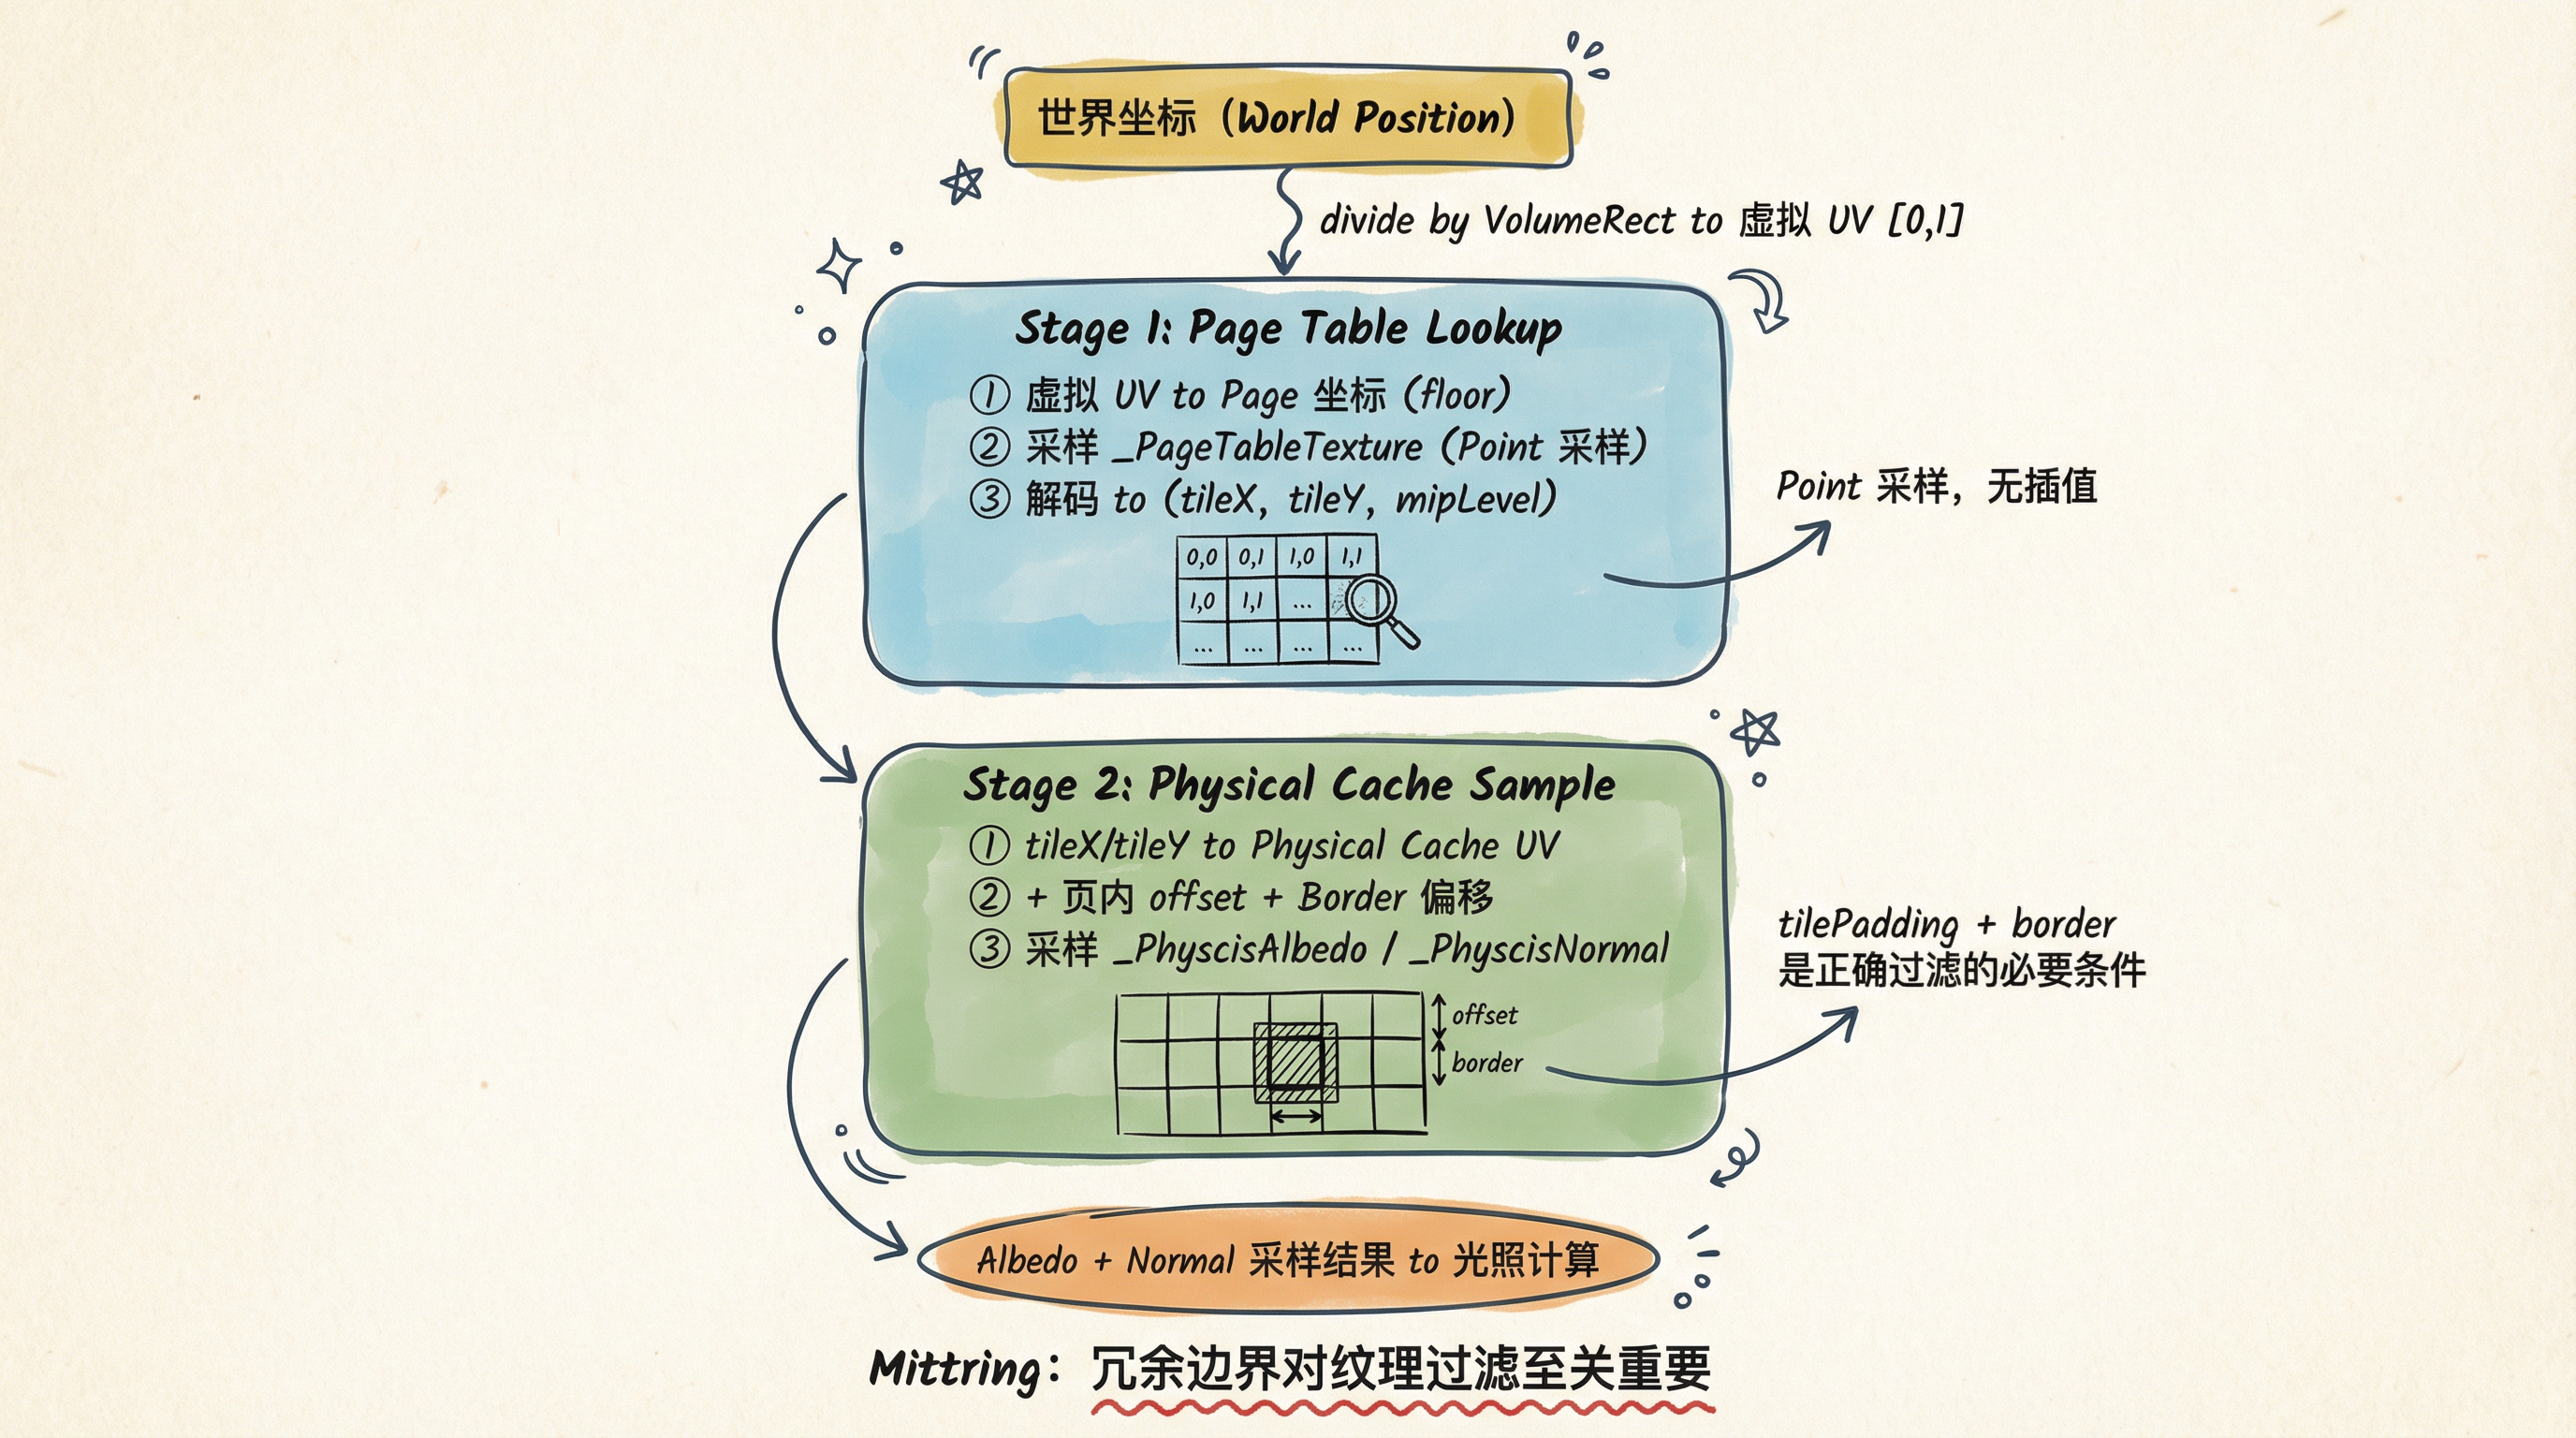
Lookup (查表):通过世界坐标计算虚拟 UV,进而确定 Page Table 中的页表 cell,读取 Page Table 以获取 Tile 坐标和 mip 级别。
Sample (采样):利用 Tile 坐标、页内 offset 和 Border 偏移量,计算 Physical Cache UV,最终对 Physical Cache 进行采样。
tilePadding 和 border 的引入是实现正确过滤的必要条件。Mittring 在 VT 相关的技术文档中明确指出,冗余边界对于纹理过滤至关重要。
七、帧内时序:Readback 延迟与新页可见性
Feedback 与 Readback 机制会引入一帧或多帧的固有延迟。为确保逻辑一致性,系统需固定每帧的操作序列,以避免在不同平台或渲染时序中产生逻辑分叉。
当前稳定的帧序列分四步:
消耗 Readback:若上一帧的 Readback 数据已就绪,系统将执行 Decode 和 Analyze 操作,生成新的页面请求并更新 LRU 状态。
更新 Page Table:写入可用的页面映射,并处理失效的映射条目。
渲染 Feedback RT:渲染本帧的 Feedback Render Target,并启动新的 AsyncGPUReadback 操作。
按预算生成页面:从请求队列中取出有限数量的页面,渲染至 Physical Cache,并更新映射结构。
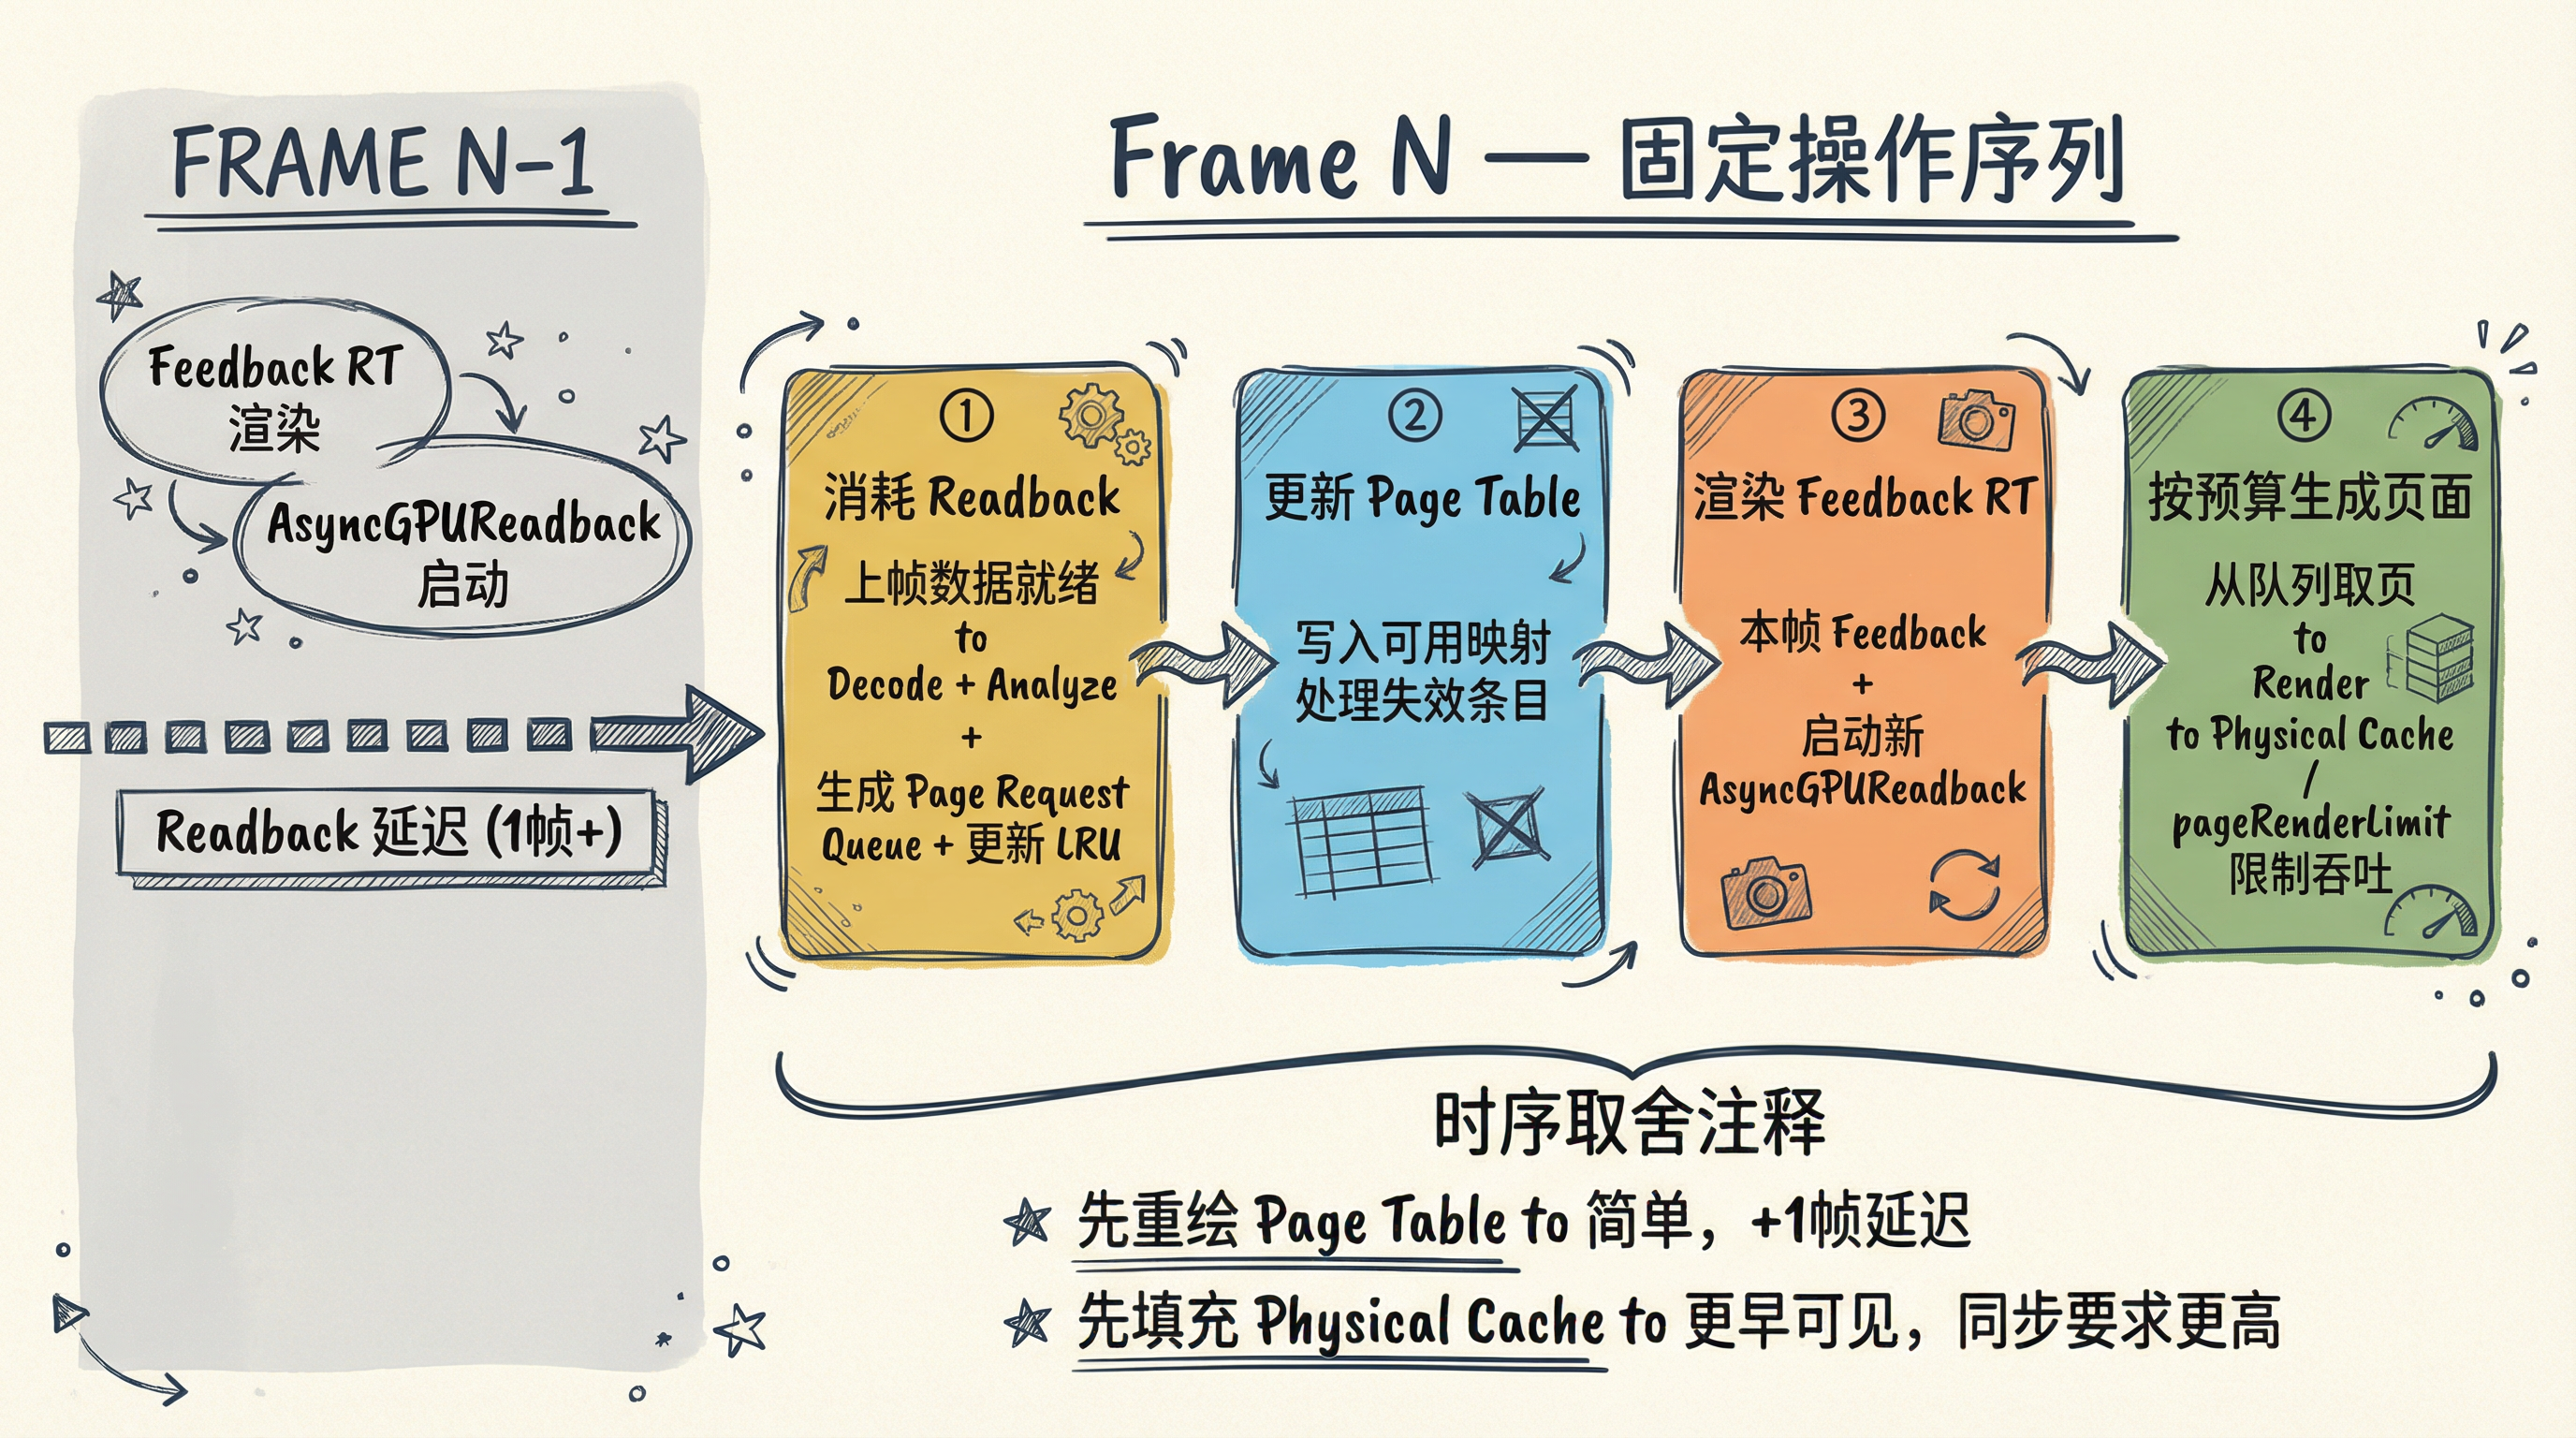
Page Table 重绘与 Physical Cache 填充的相对执行顺序,直接影响新页面的可见时间:
先重绘 Page Table 再填充 Physical Cache:新页通常需等待下一次 Page Table 重绘才能生效,这会引入额外的 1 帧延迟,但依赖关系更为简单。
先填充 Physical Cache 再重绘 Page Table:新页可更早生效,但对资源状态、依赖管理和同步机制的要求更为严格。
核心系统仅暴露明确的时序点与资源接口,将时序取舍的决策权留给具体管线的接入层。
八、参数调优与调试
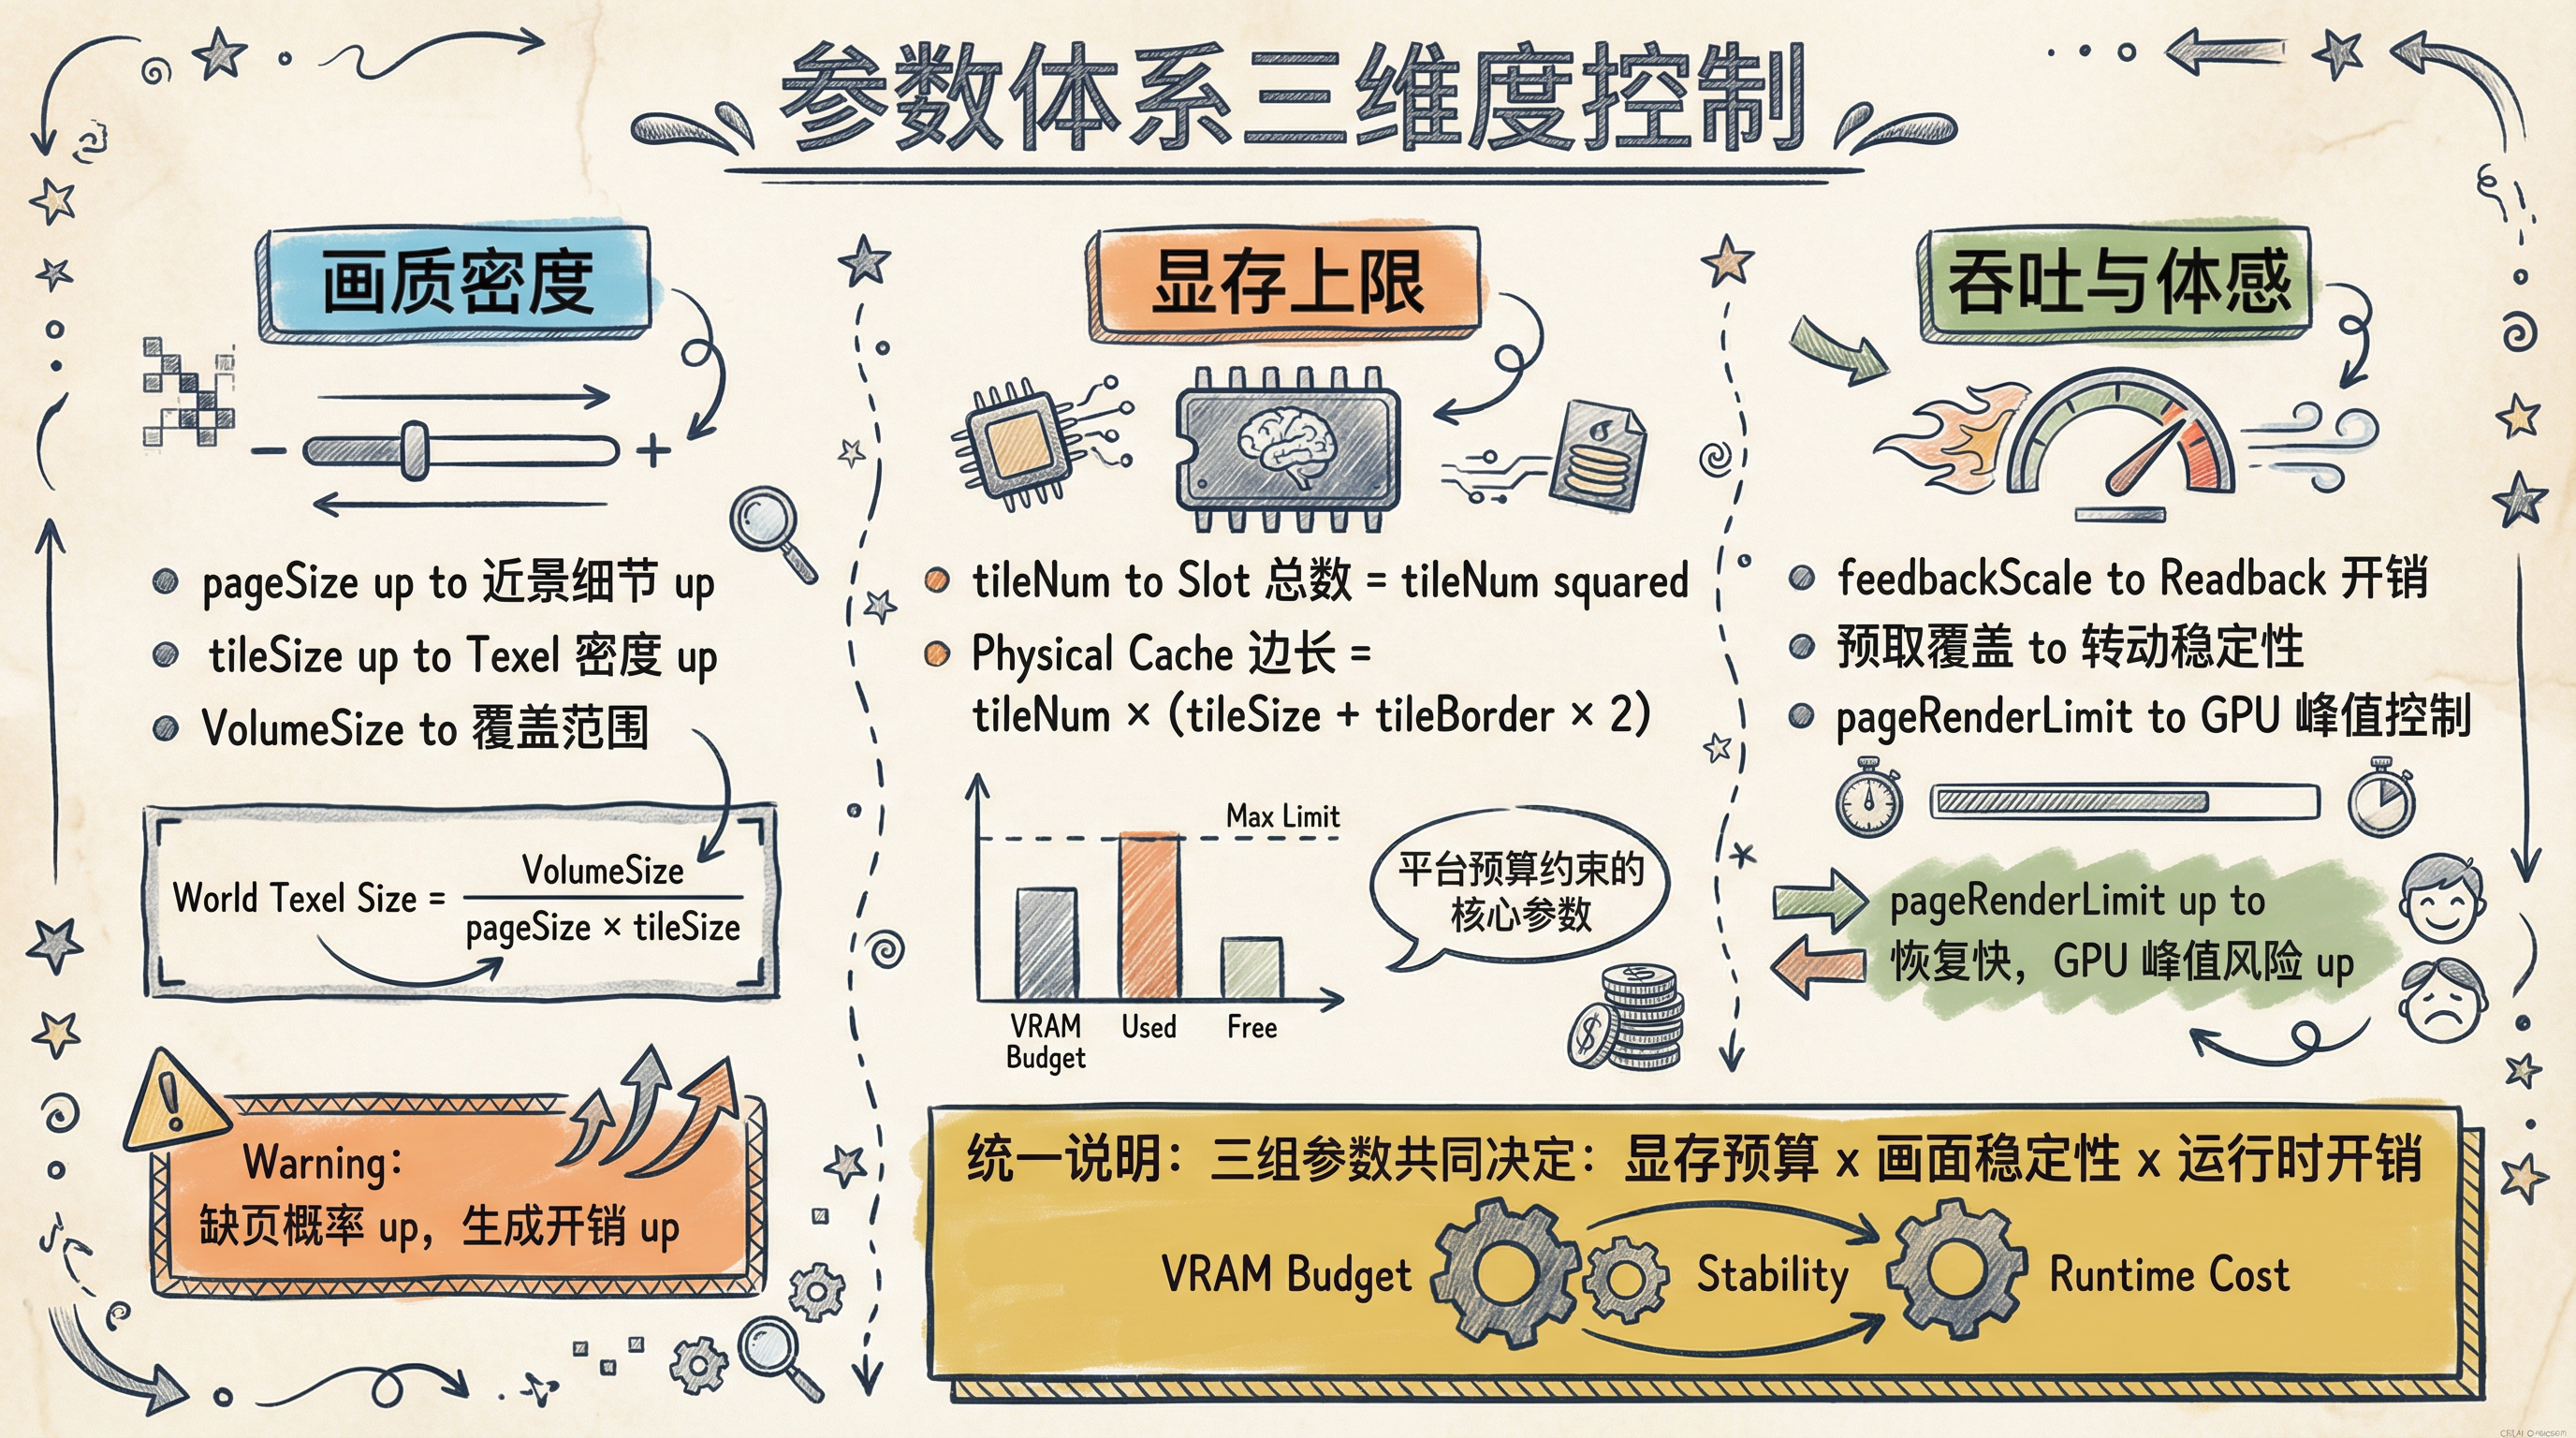
8.1 世界分辨率:World Texel Size
Mip0 的理论 Texel 密度近似公式为:
[公式待补充]
增大 pageSize 或 tileSize 可提高近景细节,但同时会提高缺页概率与页面生成开销。
8.2 显存上限:Physical Cache 尺寸
Physical Cache 的边长(像素)由这些参数决定:
[公式待补充]
显存占用近似值(以两张 Physical Cache 为例):
[公式待补充]
在工程实践中,tileNum 更易受平台预算约束。它直接决定了槽位总数与缺页概率,也直接限定了显存上限。
8.3 缺页体感与吞吐:三个控制变量
Feedback RT 分辨率(或 feedbackScale):分辨率降低可节省开销,但会增加漏报风险与粒度误差;分辨率提高可增强稳定性,但会增加 Readback 开销。
预取覆盖:Feedback 覆盖范围略大于主视锥,用于降低快速视角转动时的突兀感。
pageRenderLimit:限制每帧最大页面生成数量,用于避免 GPU 性能尖峰。其代价是恢复清晰的速度将变慢。
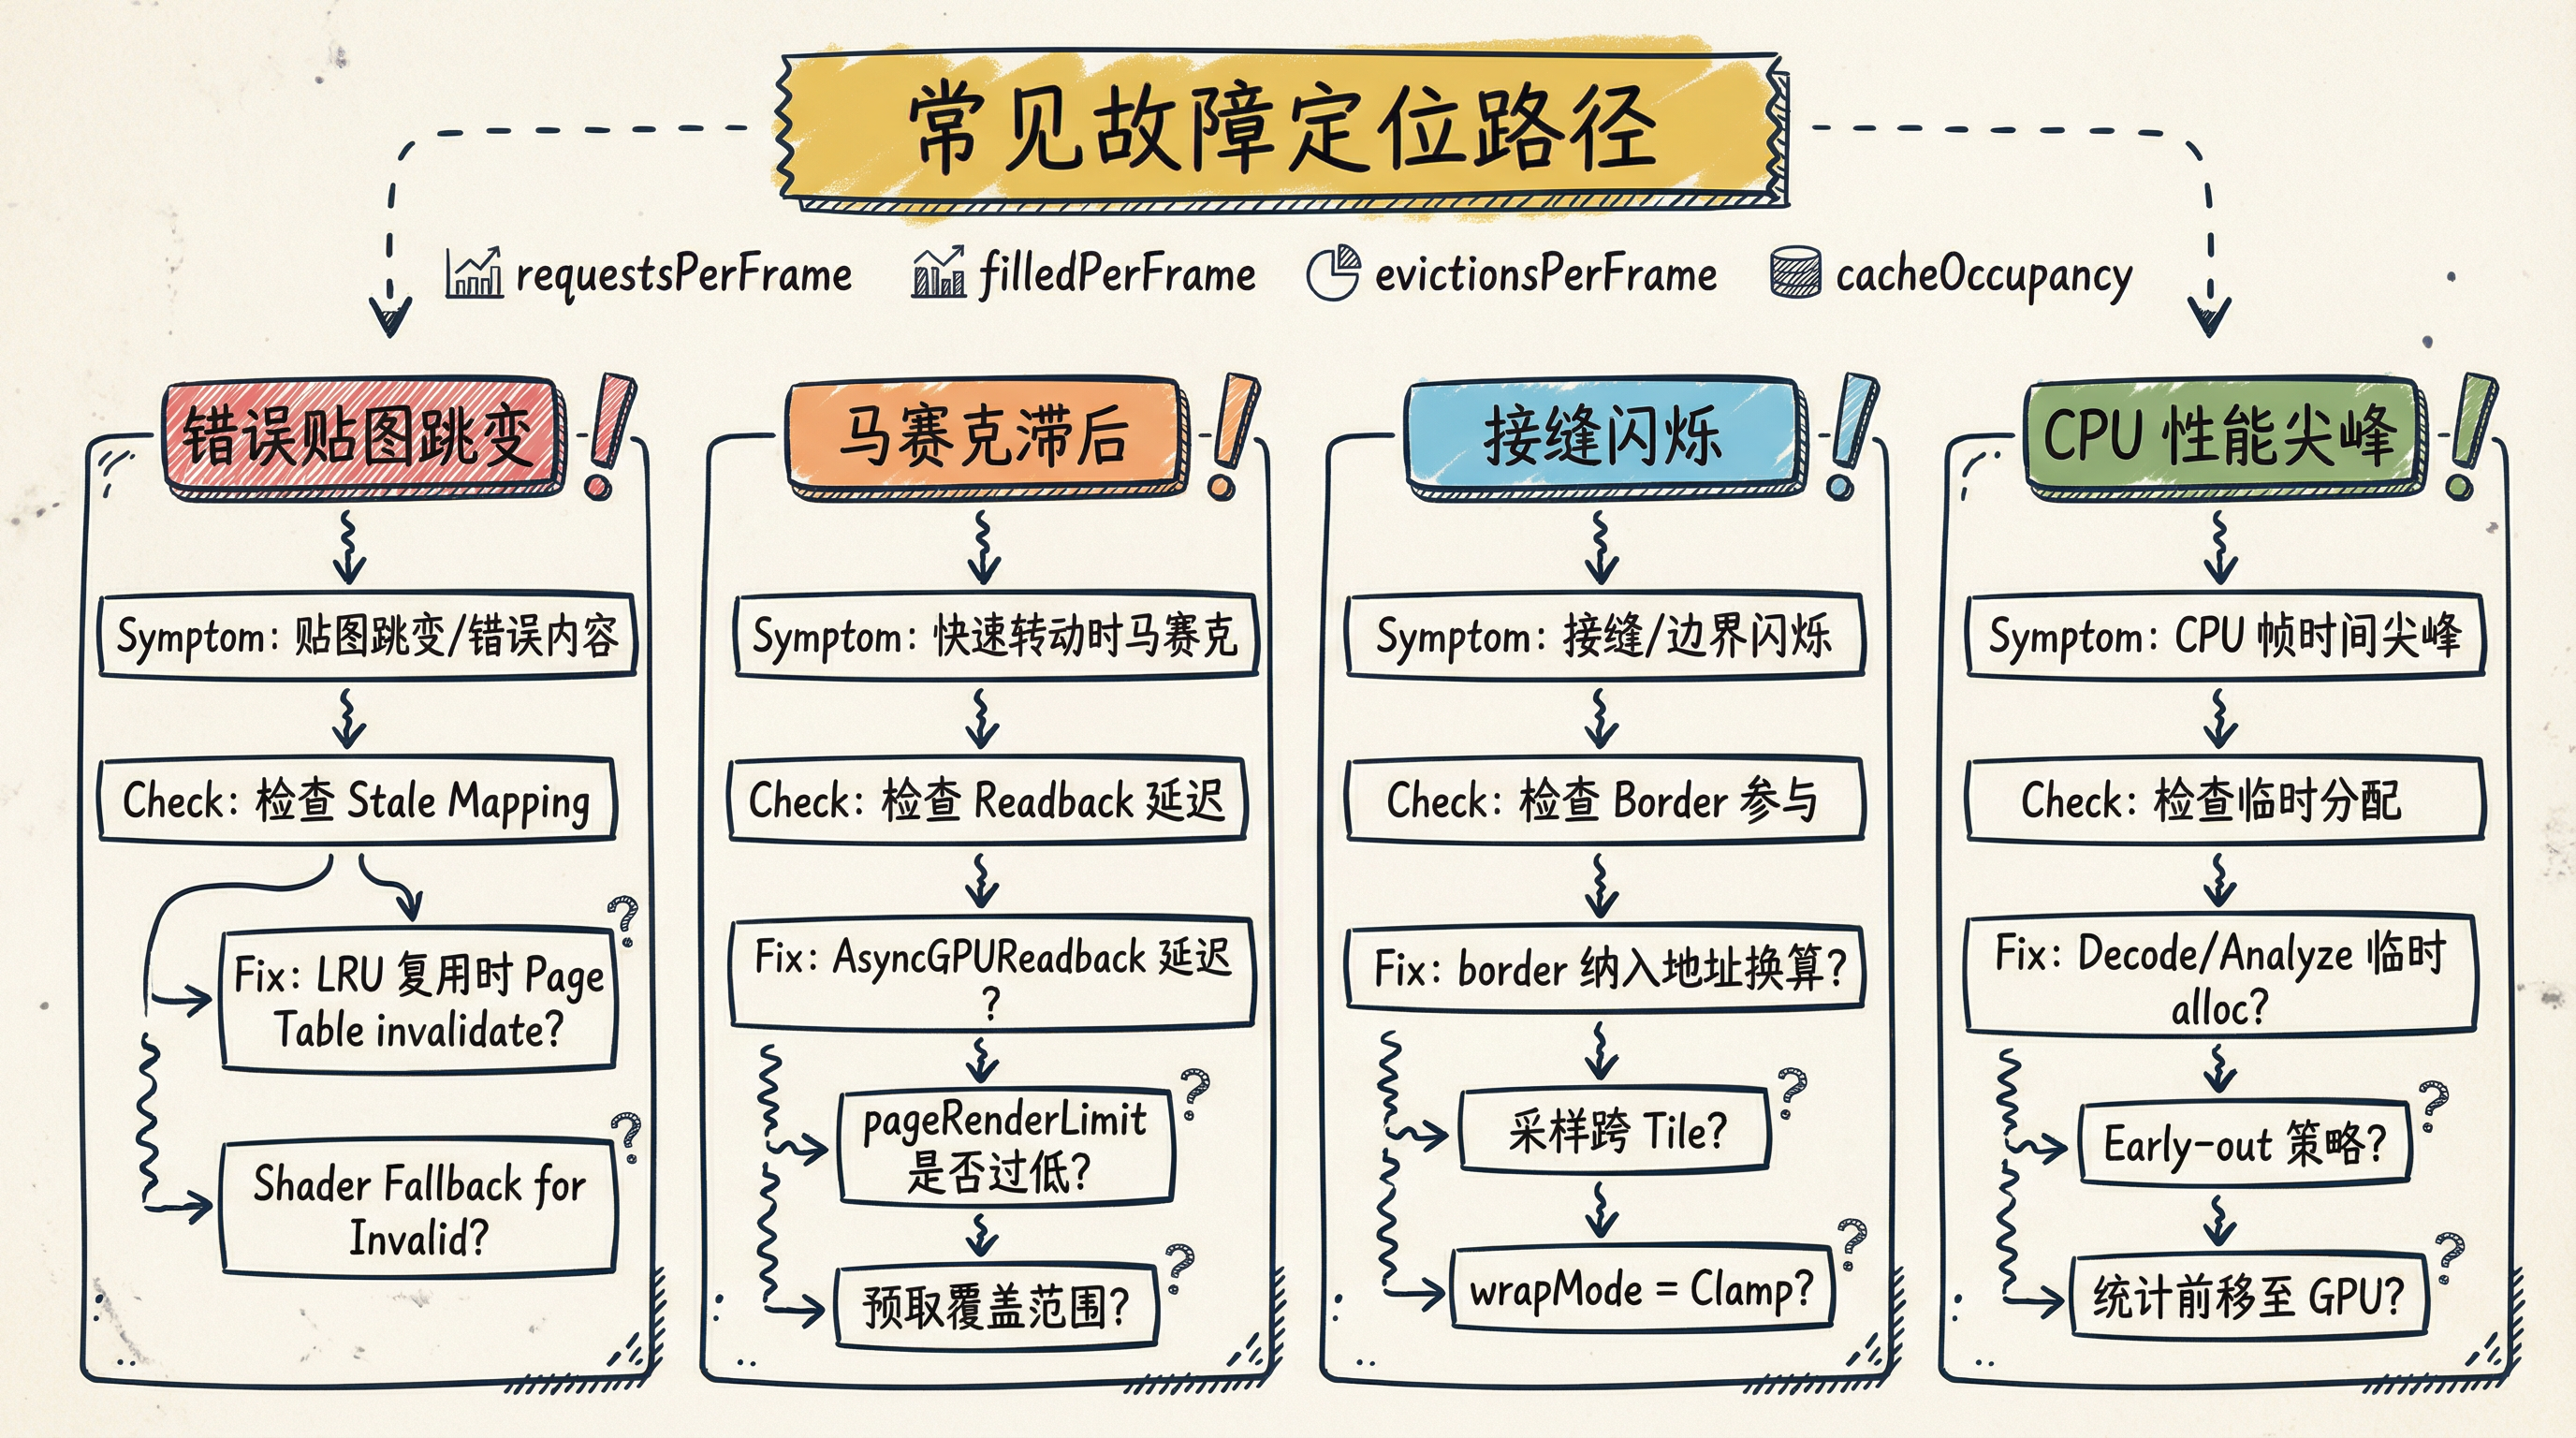
调试和性能分析(Profiling)是核心组件,默认提供一系列可视化工具与性能计数器支持问题定位,为 Stale Mapping、渲染卡顿等常见问题提供确定性的定位路径。
8.4 可视化工具
Feedback RT 可视化:直接显示 GPU 输出或解码后的 pageXY / mipHeatmap,用于分析系统请求的页面分布与 Mip-level 需求。
Page Table 可视化:通过不同颜色通道展示页表状态,其中 RG 通道可用于显示 Tile 坐标,B 通道显示 Mip-level。
Physical Cache 可视化:在物理缓存上叠加 Tile 网格、Tile ID 或 LRU 顺序,用于检视缓存的实时占用与替换情况。
8.5 核心性能计数器
requestsPerFrame:每帧请求的页面总数。
filledPerFrame:每帧成功填充到缓存的页面数。
evictionsPerFrame:每帧因缓存空间不足而被淘汰的页面数。
cacheOccupancy:物理缓存的当前占用率。
8.6 常见故障定位
错误贴图跳变:优先检查 Stale Mapping 问题。需验证在使用 LRU 策略复用缓存时,对应的 Page Table 条目是否被正确失效,以及着色器(Shader)是否具备针对无效(Invalid)状态的降级(Fallback)处理逻辑。
快速转动时的马赛克滞后:优先检查 AsyncGPUReadback 延迟与 pageRenderLimit 设置是否合理。其次,需要评估预取(Prefetching)覆盖范围与粗 Mip-level 的保底策略是否有效。
接缝闪烁:检查 border 或 padding 是否参与了地址换算。同时,确认纹理采样是否跨越了 Tile 边界,以及 wrapMode 是否设置为 Clamp。
CPU 性能尖峰:检查 Decode 或 Analyze 阶段是否存在临时的内存分配。审查去重与过滤逻辑中是否存在可以提前退出的(Early-out)策略,并评估是否需要将统计任务前移至 GPU 执行。
九、已知限制
Physical Cache 尺寸固定、作为显式参数传入,显存占用不随地形面积线性增长。pageRenderLimit 把每帧页面生成的吞吐量卡住,大量缺页时 GPU 不会出性能尖峰。Feedback RT 的分辨率决定了请求生成带宽和 AsyncGPUReadback 的数据量。CPU 侧的 Decode 与 Analyze 是高度数据并行的密集循环,可通过 Unity Jobs 拆分任务、Burst 生成 SIMD 友好的代码路径,工作量稳定为按 Feedback RT 像素数线性增长的固定开销。页面内容来自运行时对 TerrainLayer、Alphamap 的渲染组合,地表着色器只需把 Albedo 与 Normal 的采样来源替换为 TextureSampleVirtual(),其余光照与合成逻辑不用改。
在这个基础上,系统当前明确接受这些限制:
AsyncGPUReadback 引入的反馈延迟是固有开销,需要通过预取机制与吞吐预算来平衡体感。
页面生成开销与地表渲染层数(Layer)正相关。层数越多,单页渲染开销越高,必须受 pageRenderLimit 约束。
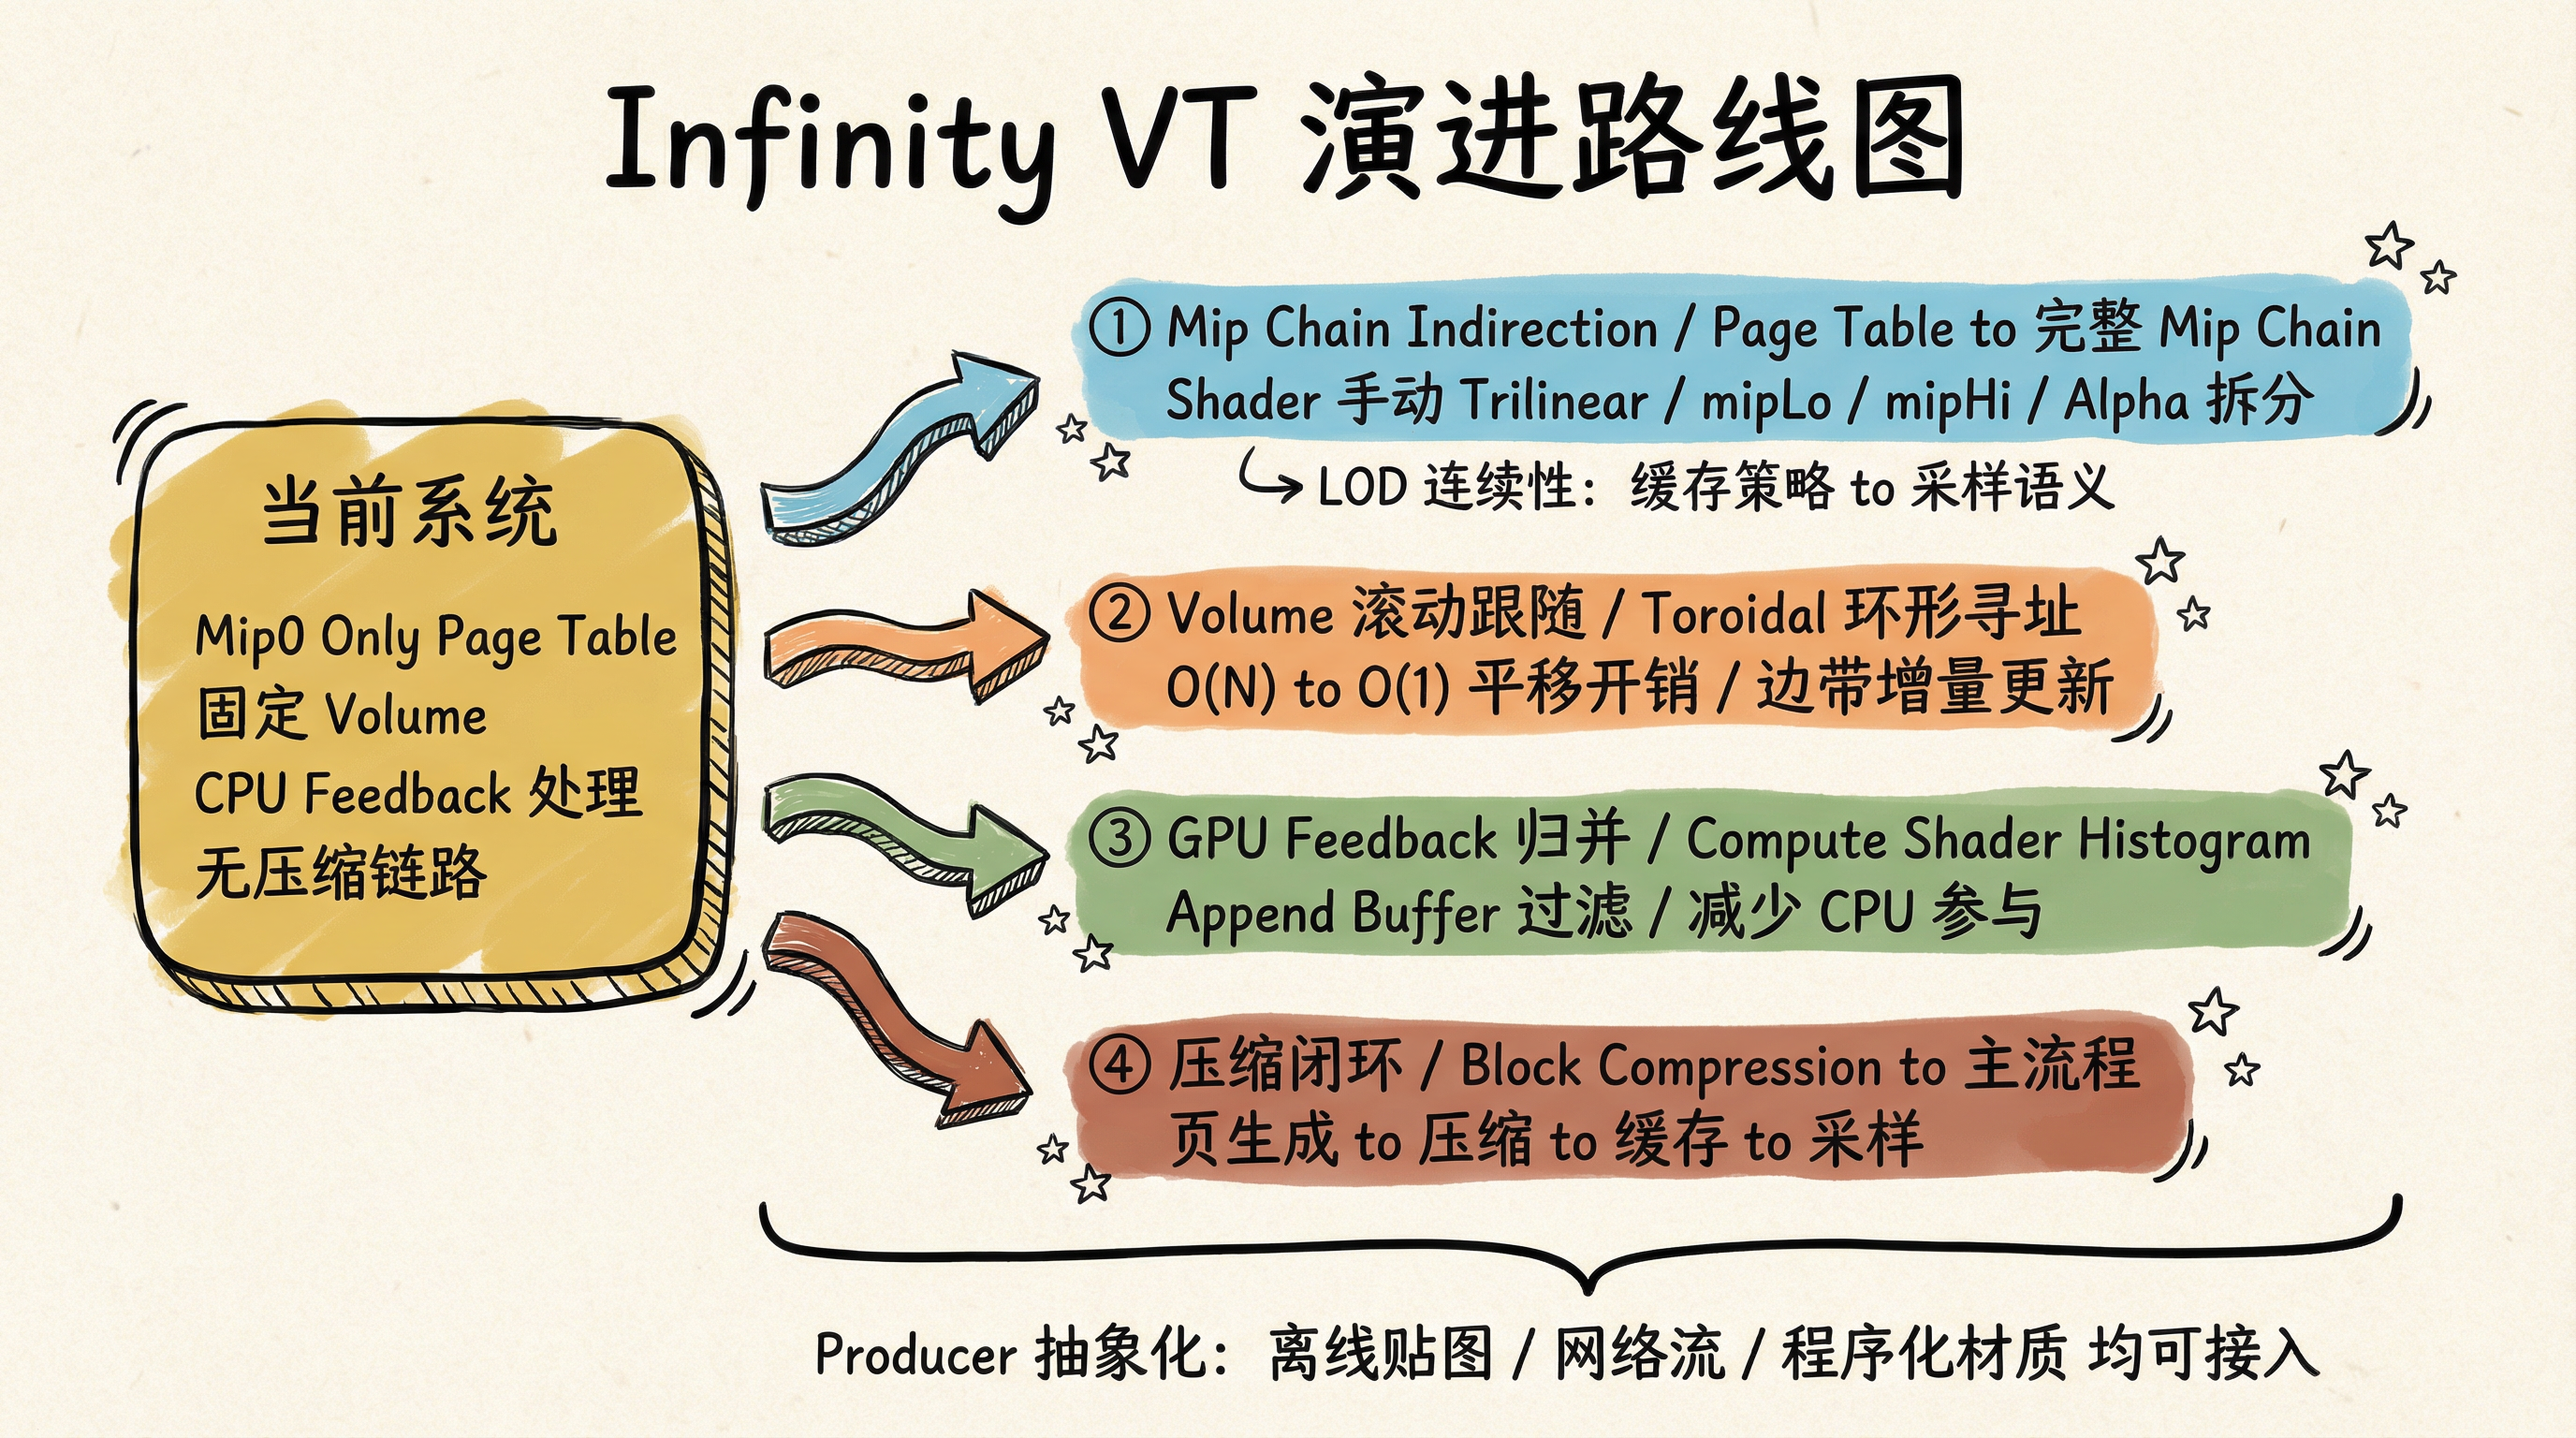
Page Table 当前仅包含 Mip0,页级别 LOD 切换在快速移动时会产生突兀感。解决思路是把 Page Table 升级为带完整 Mip Chain 的查找表,同一空间位置在不同 Mip 指向不同的 Physical Tile,Shader 侧显式混合相邻 Mip 做连续过渡——Feedback 继续输出 pageXY 和 requestMip,CPU 将 requestMip 拆为 mipLo、mipHi 和 Alpha,向 Page Table 的不同 Mip 写入映射,Shader 执行两次 Lookup + 两次采样 + Lerp。这个方案与 Mittring 讲义中关于 Indirection 和 LOD 表达的讨论相符,核心在于将 LOD 连续性从缓存更新策略转移至采样语义。
单一 Volume 只覆盖有限的世界区域,不适用于无限延伸世界。Volume 跟随相机滚动需要将移动开销从 O(N) 降至 O(1):平移步长对齐至页网格以减少抖动和无效失效,Page Table 采用环形寻址(Toroidal)通过维护 Offset 实现平移而非整体搬运数据,每次平移仅更新进入和移出区域的边带。
Page Table 的失效语义必须完整实现,否则会出现 Stale Mapping。
压缩链路仍为扩展点,尚未形成"页生成 → 压缩 → 缓存 → 采样"的完整闭环。