

一、背景
基于 Unity 2019.1 的 Scriptable Render Pipeline(SRP),从零搭建一个包含 Pre-Z 和 GBuffer 绘制的延迟渲染管线。
SRP 把 Unity 的全部渲染细节以脚本形式暴露给开发者。配合 CommandBuffer(类似 DirectX 的 Command List),可以完全控制每一帧的绘制流程,引擎内部不再有黑盒行为。相比直接啃 DX12 那套底层接口,Unity 的封装让管线开发的工程复杂度低了很多。
SRP 的抽象层级介于引擎预制管线(Built-in Pipeline)和原生图形 API 之间。它把 Descriptor Set、Root Signature 或 Pipeline State Object 这类底层概念收拢在 ShaderPassName、DrawingSettings、FilteringSettings 等高层结构中。开发者关注的粒度是"画哪些对象、用哪个 Pass、输出到哪个 RT",不需要关心"绑定哪个 Descriptor Heap、设置哪个 Barrier"。这个抽象粒度对原型迭代非常友好:一个完整的 Deferred Pipeline 原型可以在数百行 C# 内完成。
二、创建 RenderPipeline
SRP 的入口是 RenderPipeline 类。开发者需要继承该类并重写两个虚函数:
Render()— 每帧渲染循环的入口Dispose()— 管线销毁时的清理逻辑
Render() 接收一个 ScriptableRenderContext 和 Camera[] 数组。在该函数内对每个 Camera 执行 foreach 循环:先设置渲染参数,再执行 Culling,最后通过 CommandBuffer 完成绘制命令录制。
2.1 ScriptableRenderContext 的 API 设计
ScriptableRenderContext 是 SRP 与引擎 Graphics Backend 之间的唯一通道。它采用延迟提交(Deferred Submission)模式:所有通过 context.ExecuteCommandBuffer(cmd) 录制的命令和通过 context.DrawRenderers() 发起的绘制调用都会先暂存在内部队列中,调用时并不立即提交给 GPU。只有调用 context.Submit() 时,队列中的全部命令才会被一次性序列化为底层图形 API 调用并提交给驱动。
这个设计有两个关键收益:
- 命令重排:Context 在 Submit 前可以对命令序列做有限的重排和合并优化(如 Barrier 合并、连续 SetRenderTarget 去重),减少冗余的 GPU 状态切换。
- 验证窗口:在 Submit 之前,Unity 的验证层可以检查资源绑定完整性、RT 格式兼容性等问题,并在 Editor 下给出诊断信息,而非等到 GPU Fault 后才报错。
CommandBuffer 与 ScriptableRenderContext 的关系是"录制器"与"提交器"。CommandBuffer 负责录制 GPU 命令(SetRenderTarget、DrawMesh、Dispatch 等),录制完成后通过 context.ExecuteCommandBuffer(cmd) 将其内容追加到 Context 的内部队列。一个 CommandBuffer 可以多次 Execute,每次 Execute 将当前 buffer 中的命令拷贝到 Context 队列,之后 buffer 可以 Clear 并复用。一帧内可以用同一个 CommandBuffer 实例分段录制不同 Pass 的命令:
// Pre-Z Pass
CommandBuffer cmdPrePass = CommandBufferPool.Get(InfinityPassIDs.PreDepthPass.name);
cmdPrePass.GetTemporaryRT(InfinityShaderIDs.RT_DepthBuffer,
    camera.pixelWidth, camera.pixelHeight, 24, FilterMode.Point, RenderTextureFormat.Depth);
cmdPrePass.SetRenderTarget(InfinityShaderIDs.ID_SceneDepth);
cmdPrePass.ClearRenderTarget(true, true, camera.backgroundColor);
context.ExecuteCommandBuffer(cmdPrePass);
CommandBufferPool.Release(cmdPrePass);
context.DrawRenderers(cullingData, ref drawSettings_PrePass, ref filterSettings_PrePass);

// GBuffer Pass
CommandBuffer cmdGBuffer = CommandBufferPool.Get(InfinityPassIDs.GBufferPass.name);
cmdGBuffer.SetRenderTarget(InfinityShaderIDs.ID_GBuffer, InfinityShaderIDs.ID_SceneDepth);
cmdGBuffer.ClearRenderTarget(false, true, camera.backgroundColor);
context.ExecuteCommandBuffer(cmdGBuffer);
CommandBufferPool.Release(cmdGBuffer);
context.DrawRenderers(cullingData, ref drawSettings_GBuffer, ref filterSettings_GBuffer);

context.Submit();  // 两个 Pass 的命令一起提交
context.DrawRenderers() 是独立于 CommandBuffer 的另一条绘制路径。它直接接收 CullingResults 和各种 Settings 结构,由引擎内部生成 Draw Command。这条路径的好处是引擎可以在内部应用 SRP Batcher 的合批逻辑;如果改用 CommandBuffer 手动录制 cmd.DrawMesh(),就绕过了 Batcher,无法享受合批优化。因此实际工程中,对场景物体的绘制应优先使用 context.DrawRenderers(),只有 Full Screen Pass、Compute Dispatch 等非场景绘制才使用 CommandBuffer 直接录制。
基本框架的伪代码:
public class MyRenderPipeline : RenderPipeline
{
    protected override void Render(ScriptableRenderContext context, Camera[] cameras)
    {
        foreach (var camera in cameras)
        {
            context.SetupCameraProperties(camera);
            var cullingResult = context.Cull(ref cullParams);
            RenderContent(context, camera, cullingResult);
            context.Submit();
        }
    }

    protected override void Dispose(bool disposing) { /* cleanup */ }
}
context.SetupCameraProperties(camera) 在内部完成 View/Projection/VP Matrix 的设置,以及摄像机相关的全局 Shader 属性(_WorldSpaceCameraPos、unity_CameraProjection 等)的绑定。这一步必须在任何 DrawRenderers 调用之前执行,否则 Shader 中读到的矩阵是上一帧的残留值。
三、RenderContent 实现
核心绘制逻辑封装在 RenderContent() 函数中,该函数接收当前循环的 Camera、CullingResults 和 RenderContext。绘制通过几个 SRP API 的配合完成:FilteringSettings 从场景对象中过滤出当前 Pass 需要的对象(如仅 Opaque),DrawingSettings 根据 Shader Pass 名称确定使用哪个 Pass 绘制,并指定绘制排序以减少 Overdraw;具体的 GPU 命令由 CommandBuffer 录制,最终经 DrawRenderers() 执行实际绘制。
CommandBuffer 不使用 new 创建,改从 CommandBufferPool.Get() 获取池中的可用实例,避免频繁创建销毁带来的 GC 开销。
3.1 Shader Pass 的 LightMode Tag 机制
DrawingSettings 通过 ShaderPassName 指定当前 Draw Call 使用 Shader 中的哪个 Pass。而 Shader 端通过 Pass 内的 Tags { "LightMode" = "xxx" } 声明自己的身份标识。两端通过字符串匹配完成绑定:
Pass
{
    Tags { "LightMode" = "DepthOnly" }
    // ...
}
// 工程中通过 InfinityPassIDs 集中管理 Pass 名称
var drawSettings = new DrawingSettings(
    InfinityPassIDs.PreDepthPass,  // 匹配 LightMode = "My_PrePass" 的 Pass
    new SortingSettings(camera) { criteria = SortingCriteria.RenderQueue | SortingCriteria.OptimizeStateChanges }
)
{
    enableInstancing = true,
    enableDynamicBatching = true,
    perObjectData = PerObjectData.Lightmaps
};
LightMode Tag 的匹配规则:
- 每个 Shader 的 SubShader 内可以有多个 Pass,每个 Pass 通过 LightMode 标记其用途
- DrawRenderers 调用时指定的 ShaderPassName 会遍历物体 Shader 的所有 Pass,选中第一个 LightMode 匹配的 Pass 执行
- 如果没有匹配的 Pass,该物体在此 DrawCall 中被跳过(不绘制)
- 可以通过
DrawingSettings.SetShaderPassName(index, name)指定多个候选 Pass Name,按 index 顺序尝试匹配
这个机制使得同一个 Shader 可以服务于管线中的多个阶段。例如一个标准 PBR Shader 可以同时包含 DepthOnly、GBuffer、ShadowCaster、Meta 等多个 Pass,管线的不同阶段各取所需。Material 无需为不同的管线阶段配置不同的 Shader:单个 Shader 文件内组织所有 Pass 即可。
SortingSettings 控制 Draw Call 的提交顺序。对于 Pre-Z Pass,设置 SortingCriteria.CommonOpaque(由近到远排序)可以最大化 Early-Z 的剔除率。对于透明物体,则使用 SortingCriteria.CommonTransparent(由远到近排序)保证混合正确性。
四、Shader 结构
Shader 包含两个 Pass:
// Pass 0: Depth Only
Pass
{
    Name "DepthOnly"
    Tags { "LightMode" = "DepthOnly" }
    ColorMask 0
    ZWrite On
    ZTest LEqual

    HLSLPROGRAM
    #pragma vertex DepthOnlyVert
    #pragma fragment DepthOnlyFrag
    // Vertex Shader 仅做 MVP 变换,Fragment Shader 为空(ColorMask 0 下不写入颜色)
    ENDHLSL
}

// Pass 1: GBuffer
Pass
{
    Name "GBuffer"
    Tags { "LightMode" = "GBuffer" }
    ZWrite Off
    ZTest Equal   // 利用 Pre-Z 结果,仅对 Equal 的像素着色

    HLSLPROGRAM
    #pragma vertex GBufferVert
    #pragma fragment GBufferFrag
    // 输出 Albedo / Normal / Roughness-Metallic 等 GBuffer 数据
    ENDHLSL
}
4.1 Pre-Z Pass 的 Overdraw 消除原理
Pre-Z(也称 Z-Prepass 或 Depth Prepass)的目标是提前建立深度缓冲,使后续 GBuffer Pass 能利用 ZTest Equal 精确跳过被遮挡像素的 Fragment Shader 执行。
具体流程:
- Pre-Z Pass:以
ZWrite On+ZTest LEqual+ColorMask 0绘制所有 Opaque 物体。此 Pass 只执行 Vertex Shader 和深度写入,Fragment Shader 基本为空(不输出颜色),开销极低。完成后 Depth Buffer 中存有每个像素距摄像机最近的深度值。 - GBuffer Pass:以
ZWrite Off+ZTest Equal绘制。只有深度与 Depth Buffer 中已有值精确相等的像素才能通过深度测试,进入 Fragment Shader 执行。所有被遮挡像素在 Early-Z 阶段即被硬件剔除。
Early-Z 是 GPU 硬件层面的优化:在 Fragment Shader 执行之前,硬件先比较当前片元的深度与 Depth Buffer 中的值。如果深度测试失败,该片元被直接丢弃,不进入 Fragment Shader。这避免了昂贵的纹理采样和光照计算。
Hi-Z(Hierarchical Z-Buffer)是 Early-Z 的加速结构。GPU 维护 Depth Buffer 的 Mipmap 金字塔,高层 Mip 存储对应区域的最近/最远深度。光栅化阶段在将 Triangle 拆分为片元前,先用 Triangle 的 Bounding Box 在 Hi-Z 金字塔的粗粒度层级做快速剔除:如果 Triangle 的最远深度已经大于该区域的最近深度,则整个 Triangle 可以被跳过。Pre-Z 后 Depth Buffer 已经是完整的,Hi-Z 金字塔精度最高,后续 GBuffer Pass 的 Hi-Z 剔除率最大化。
Pre-Z 的代价:
- 全场景多执行一次 Vertex Shader(无 Fragment 开销)
- 额外的 Draw Call 提交(但通过 SRP Batcher 合批后开销很小)
- Depth Buffer 写入的带宽
在 Overdraw 严重的场景(大量前后遮挡、复杂 GBuffer Fragment Shader)中,Pre-Z 的收益远大于代价。对于简单场景(Overdraw 低、Fragment Shader 轻量),Pre-Z 反而可能是净负收益,需要根据实际 Profiling 决定是否启用。
4.2 GBuffer 通道规格设计
延迟渲染的 GBuffer Layout 决定了管线能支持的材质复杂度和带宽开销。4 张 RT 的布局如下:
| RT 索引 | 格式 | 内容 | 说明 |
|---|---|---|---|
| RT0 | ARGB32 (sRGB) | RGB: Albedo, A: 保留 | sRGB 存储,采样时硬件自动做 Gamma→Linear |
| RT1 | ARGB2101010 | RG: Octahedral Normal XY, B: 保留, A: 2bit ShadingModelID | 10bit 精度的法线编码,避免 8bit 的 Banding |
| RT2 | ARGB32 (Linear) | R: Roughness, G: Metallic, B: AO, A: 保留 | PBR 参数打包在一张 RT 内 |
| RT3 (Depth) | D32_SFloat | Depth | 32bit 浮点深度,Pre-Z 和 GBuffer 共用 |
设计要点:
法线编码:使用 Octahedral Mapping 将单位法线压缩为 2 个分量存储在 10bit 通道中。相比 Spheremap Transform 和 Stereographic Projection,Octahedral 在精度/解码复杂度/边界连续性上取得最佳平衡。10bit 精度(1024 级)在法线变化平缓的区域足够,但对镜面反射的法线精度敏感场景可能出现 Specular Aliasing,此时可考虑升级到 RGB10A2 的三分量存储。
ShadingModelID:用 2bit(4 种模型)存储当前像素使用的着色模型。Lighting Pass 根据此 ID 分支到不同的 BRDF 评估路径(如 Standard PBR / Skin / Hair / Eye)。4 种够覆盖多数情况,如需更多可挤占其他通道的保留位。
带宽开销:4 张 RT × 1080p 分辨率 × 4Byte/pixel = 约 33MB/帧的写入带宽。加上 Depth Buffer 的 4Byte 开销,总计约 41MB。Mobile 平台需格外关注这个数字:如果带宽预算紧张,可考虑压缩到 3 张 RT(Roughness/Metallic 各 4bit 打包)或使用 RGBA16F 的半精度方案。
// GBuffer Fragment Shader 输出结构
struct GBufferOutput
{
    half4 RT0 : SV_Target0;  // Albedo.rgb + reserved
    half4 RT1 : SV_Target1;  // OctNormal.xy + reserved + ShadingModelID
    half4 RT2 : SV_Target2;  // Roughness + Metallic + AO + reserved
};

GBufferOutput GBufferFrag(Varyings input)
{
    GBufferOutput output;

    half3 albedo = tex2D(_MainTex, input.uv).rgb;
    half3 normal = normalize(input.worldNormal);
    half2 octNormal = OctahedralEncode(normal);
    half roughness = tex2D(_RoughnessTex, input.uv).r;
    half metallic = _Metallic;

    output.RT0 = half4(albedo, 0);
    output.RT1 = half4(octNormal, 0, _ShadingModelID / 3.0);
    output.RT2 = half4(roughness, metallic, input.ao, 0);

    return output;
}
SRP Batcher 要求矩阵参数必须包裹在固定名称的 CBuffer 中:
CBUFFER_START(UnityPerMaterial)
    float4 _BaseColor;
    float4 _MainTex_ST;
    half _Metallic;
    half _Roughness;
    half _ShadingModelID;
CBUFFER_END

CBUFFER_START(UnityPerDraw)
    float4x4 unity_ObjectToWorld;
    float4x4 unity_WorldToObject;
    float4 unity_LODFade;
    real4 unity_WorldTransformParams;
CBUFFER_END
SRP Batcher 通过固定 CBuffer 布局消除材质属性上传开销,Shader 端和逻辑端必须配合使用。
五、Full Screen Blit 的 Y 轴翻转
DrawFullScreen() 函数用于将 RT 内容 Blit 到最终输出。由于 DirectX 平台下 Game View 和 Scene View 的 Y 轴方向相反,需要进行矫正:判断当前 Camera Target 是否为 null(null 表示 Game View),若是则在 DrawMesh 时翻转 UV 的 Y 坐标。
实际工程中通过构建两套 FullScreen Mesh 来处理翻转:Game View 和 Scene View 各对应一套 UV,DrawFullScreen 根据当前 View 选择对应 Mesh:
public static Mesh FullScreenMeshOrigin_Game;
public static Mesh FullScreenMeshOrigin_Scene;

public static Mesh FullScreenMesh_Game
{
    get
    {
        if (FullScreenMeshOrigin_Game != null) return FullScreenMeshOrigin_Game;

        FullScreenMeshOrigin_Game = new Mesh { name = "FullScreen Mesh" };
        FullScreenMeshOrigin_Game.vertices = new Vector3[] {
            new Vector3(-1, -1, 0),
            new Vector3(-1,  1, 0),
            new Vector3( 1,  1, 0),
            new Vector3( 1, -1, 0)
        };
        // Game View: UV.y 从 0→1(底→顶),正常映射
        FullScreenMeshOrigin_Game.uv = new Vector2[] {
            new Vector2(0, 0),
            new Vector2(0, 1),
            new Vector2(1, 1),
            new Vector2(1, 0)
        };
        FullScreenMeshOrigin_Game.SetIndices(new int[] { 0, 1, 2, 3 }, MeshTopology.Quads, 0, false);
        FullScreenMeshOrigin_Game.UploadMeshData(false);
        return FullScreenMeshOrigin_Game;
    }
}

public static Mesh FullScreenMesh_Scene
{
    get
    {
        if (FullScreenMeshOrigin_Scene != null) return FullScreenMeshOrigin_Scene;

        FullScreenMeshOrigin_Scene = new Mesh { name = "FullScreen Mesh" };
        FullScreenMeshOrigin_Scene.vertices = new Vector3[] {
            new Vector3(-1, -1, 0),
            new Vector3(-1,  1, 0),
            new Vector3( 1,  1, 0),
            new Vector3( 1, -1, 0)
        };
        // Scene View: UV.y 翻转(1→0),补偿 Unity 内部的 Scene View 翻转
        FullScreenMeshOrigin_Scene.uv = new Vector2[] {
            new Vector2(0, 1),
            new Vector2(0, 0),
            new Vector2(1, 0),
            new Vector2(1, 1)
        };
        FullScreenMeshOrigin_Scene.SetIndices(new int[] { 0, 1, 2, 3 }, MeshTopology.Quads, 0, false);
        FullScreenMeshOrigin_Scene.UploadMeshData(false);
        return FullScreenMeshOrigin_Scene;
    }
}

public static void DrawFullScreen(this CommandBuffer cmd, bool isGameView,
    RenderTargetIdentifier source, RenderTargetIdentifier dest)
{
    cmd.SetRenderTarget(dest);
    cmd.SetGlobalTexture(InfinityShaderIDs.RT_MainTexture, source);
    cmd.DrawMesh(isGameView ? FullScreenMesh_Game : FullScreenMesh_Scene,
        Matrix4x4.identity, BlitMaterial, 0, 0);
}
两套 Mesh 的顶点位置完全相同(NDC 空间的全屏 Quad),区别仅在 UV.y 方向:Game View 的 UV 是标准映射 (0,0)→(1,1);Scene View 的 UV 在 Y 轴做了翻转 (0,1)→(1,0)。通过 Mesh 级别的 UV 翻转代替 Shader 内的动态判断,可以避免分支指令开销。
这个问题的根源是 DirectX 的 RenderTarget 坐标系与 OpenGL 系相反:DX 的纹理原点在左上角,GL 在左下角。Unity 在 Scene View 中已经做了翻转处理,但 Game View 保持了 DX 的原始行为。
具体来说,当渲染到中间 RT 再 Blit 到屏幕时,DX 后端的 RT 内容相对最终屏幕是 Y 轴翻转的。Unity 对 Scene View 内部做了一次翻转补偿,而 Game View 不做这个补偿,所以自定义管线必须自行处理。OpenGL/Vulkan 后端则不存在此问题,因为它们的纹理原点与屏幕坐标系一致。可以通过 SystemInfo.graphicsUVStartsAtTop 查询当前后端是否需要翻转。
六、RenderPipelineAsset
RenderPipeline 类本身不会自动实例化,需要通过 RenderPipelineAsset 的 CreatePipeline() 方法来创建实例。在该 Asset 中同时启用 SRP Batcher 设置。
创建流程:在 Project 窗口右键 Create → MyRenderPipeline 生成 Asset 文件,将其拖入 Graphics Settings 的 SRP Asset 引用位置即可激活自定义管线。
[CreateAssetMenu(menuName = "Rendering/MyRenderPipeline")]
public class MyRenderPipelineAsset : RenderPipelineAsset
{
    public bool enableSRPBatcher = true;

    protected override RenderPipeline CreatePipeline()
    {
        GraphicsSettings.useScriptableRenderPipelineBatching = enableSRPBatcher;
        return new MyRenderPipeline();
    }
}
通过 CreateAssetMenu 属性声明后,可以在 Project 窗口右键创建。Asset 持有管线配置参数,每次进入 Play Mode 或编辑器加载时调用 CreatePipeline() 实例化管线对象。
Asset 的另一个作用是作为 Serialized 数据的容器:管线的可配置参数(如 GBuffer 格式、Shadow Map 分辨率,或 Pre-Z 的开关)可以声明为 Asset 的 public 字段,通过 Inspector 暴露给用户调整。管线对象在构造时读取这些参数。修改 Asset 参数后 Unity 会自动销毁当前管线实例并重新调用 CreatePipeline(),无需手动重启。
七、SRP Batcher 性能测试
对场景进行 Batching 性能测试,对比三种配置:
| 配置 | Batch 数 | Draw Call 数 |
|---|---|---|
| 纯 SRP Batcher | 较低 | 中等 |
| 无 SRP Batcher | 最高 | 最高 |
| SRP Batcher + Static Batching 混合 | 最低 | 最低 |
7.1 SRP Batcher 的 CBuffer 持久化机制
SRP Batcher 的核心机制是持久化 CBuffer 绑定。传统模式下每次 DrawCall 都需要重新上传材质 CBuffer 数据到 GPU;SRP Batcher 识别到相同 CBuffer Layout 的材质后,将数据持久化在 GPU 侧,仅更新发生变化的 Per-Draw 数据(如 ObjectToWorld 矩阵)。
GPU 侧的具体机制:
-
CBuffer 分配:SRP Batcher 在 GPU 内存中为每个 Material 实例分配一块持久化的 Constant Buffer 空间。这块空间在 Material 首次使用时分配,Material 销毁时释放,中间不会每帧重新分配。
-
数据更新策略:每帧开始时,引擎遍历所有 Material,检查其属性是否发生变化(通过 dirty flag)。只有 dirty 的 Material 才需要将数据从 CPU 上传到 GPU 的持久 CBuffer 中。未变化的 Material 直接复用 GPU 侧已有数据。
-
Per-Draw CBuffer:ObjectToWorld 等逐对象数据存储在另一块 CBuffer 中。SRP Batcher 将场景中所有 Renderer 的 Per-Draw 数据打包到一个大的 GPU Buffer 中,以 offset 区分不同对象。Draw Call 执行时只需设置 offset 而非重新上传整块数据。
-
绑定流程优化:传统流程是
SetCBuffer → Draw → SetCBuffer → Draw → ...,每个 Draw 前都有一次完整的 CBuffer 绑定。SRP Batcher 将其优化为:对于 CBuffer Layout 相同的连续 Draw Call,只在序列起始处绑定一次 Material CBuffer,后续 Draw 只更新 Per-Draw offset。
// 传统模式(无 SRP Batcher)
SetMaterialCBuffer(matA)    // 上传 matA 的属性
SetPerDrawCBuffer(obj1)     // 上传 obj1 的矩阵
Draw(obj1)
SetMaterialCBuffer(matA)    // 再次上传 matA(即使相同)
SetPerDrawCBuffer(obj2)     // 上传 obj2 的矩阵
Draw(obj2)

// SRP Batcher 模式
BindPersistentMaterialCBuffer(matA)  // 绑定一次,GPU 侧已有数据
SetPerDrawOffset(obj1)               // 仅设置 offset
Draw(obj1)
SetPerDrawOffset(obj2)               // 仅设置 offset
Draw(obj2)
节省的开销主要在两处:(a) CPU→GPU 的数据传输带宽(Material 属性不再每帧重传);(b) Driver 层面的 CBuffer 绑定指令数量。在材质种类有限但实例数量大的场景(如城市建筑、植被)中,这两项开销的消除非常可观。
生效条件:
- Shader 必须使用固定名称的 CBUFFER(UnityPerMaterial / UnityPerDraw)
- 材质的 CBuffer Layout 必须相同(属性数量、类型、顺序一致)
- 不同材质的属性值可以不同,只要 Layout 一致就可以合批
- Shader 不能使用
MaterialPropertyBlock(MPB 会打断 SRP Batcher)
即把"上传材质数据"的开销从 per-draw 摊销为 per-material-change,在材质种类有限的场景下效果尤为突出。
7.2 Static Batching 与 SRP Batcher 的混合机制
混合配置在 Batch 和 Draw Call 两项指标上均优于单独使用任一方案。两者的优化层级不同,因此可以叠加:
- Static Batching 把共享相同 Material 的静态物体的 Mesh 合并为一个大 Mesh,以单次 Draw Call 绘制,压低 Draw Call 总量。代价是增加内存占用(合并后的 Mesh 数据是各子 Mesh 的拷贝之和)和构建时的预处理时间。
- SRP Batcher 降低的是 Draw Call 之间的状态切换开销:即使 Draw Call 数量不变,每个 Draw Call 的 CPU 开销也会下降。
两者混合时的内部行为:
- Unity 先执行 Static Batching 的 Mesh 合并,将可合批的物体组合为 Combined Mesh
- SRP Batcher 在 Combined Mesh 基础上进一步消除状态切换:如果多个 Combined Mesh 使用相同 CBuffer Layout 的 Material,它们之间的 Draw Call 切换开销依然会被优化掉
冲突点:
- Static Batching 要求物体使用完全相同的 Material Instance(同一个引用),而 SRP Batcher 允许不同 Material Instance(只要 Layout 相同)
- 如果物体已经被 Static Batching 合并,SRP Batcher 看到的是 Combined Mesh 的 Material,不再需要逐对象分析
- GPU Instancing 与 SRP Batcher 互斥:启用 SRP Batcher 时,GPU Instancing 的 Keyword(
INSTANCING_ON)不生效
此外在 Splatoon 风格的简单场景测试中,SRP Batcher 可以将全场景合并为单个 Batch,体现了其在材质属性一致场景下的极端效率。
纯 SRP Batcher:
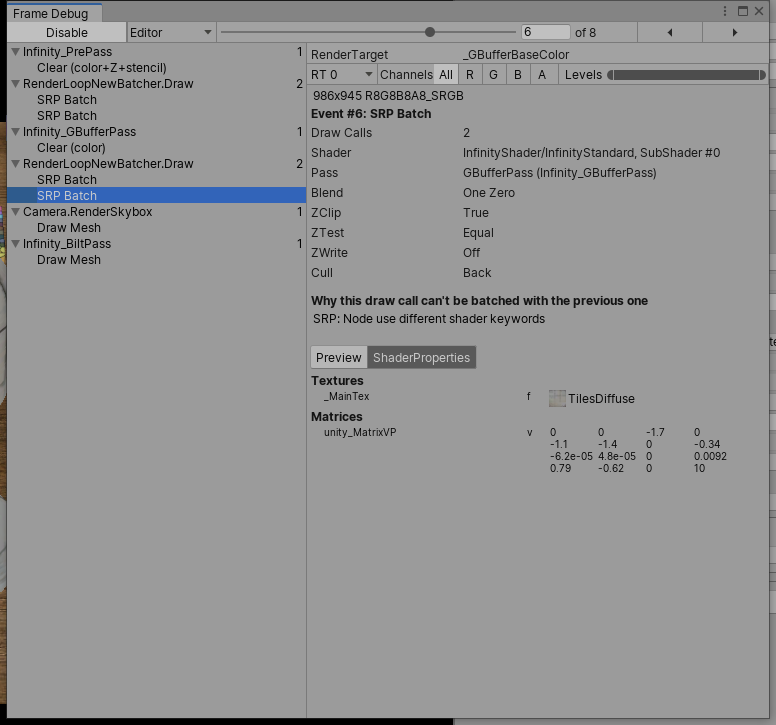
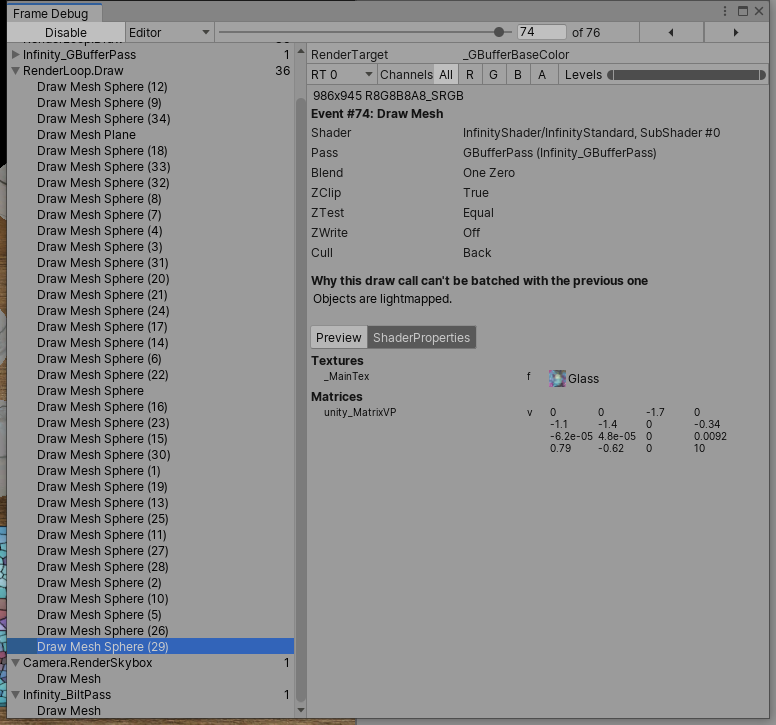
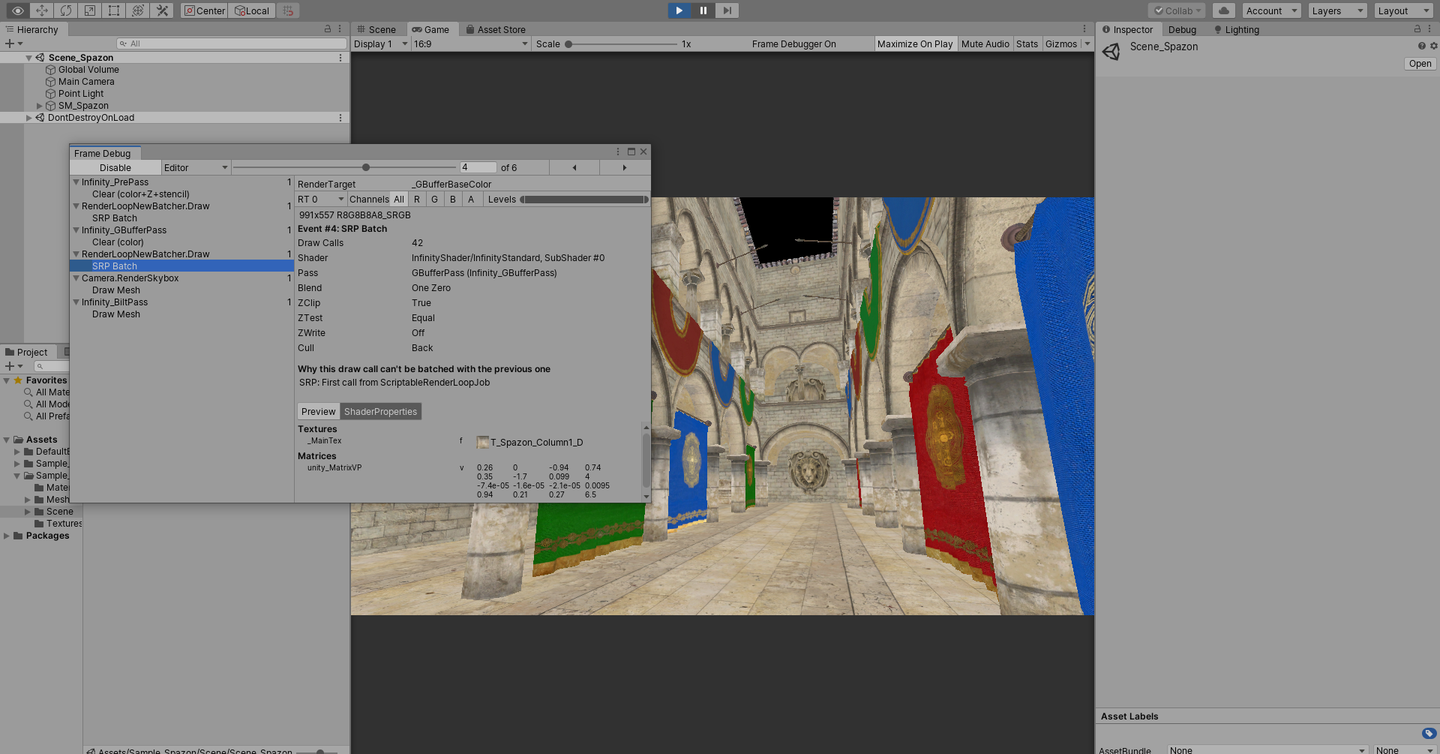
无 SRP Batcher:
SRP Batcher + Static Batching 混合:
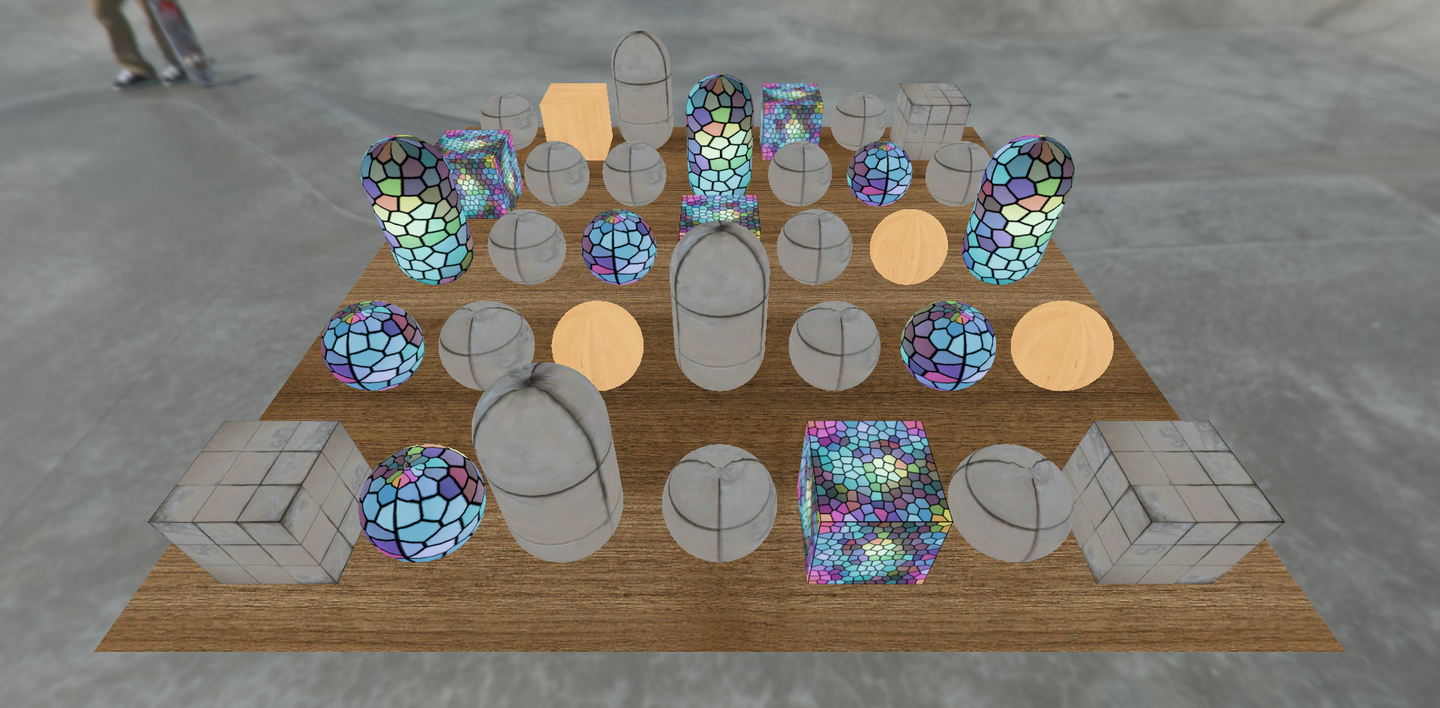
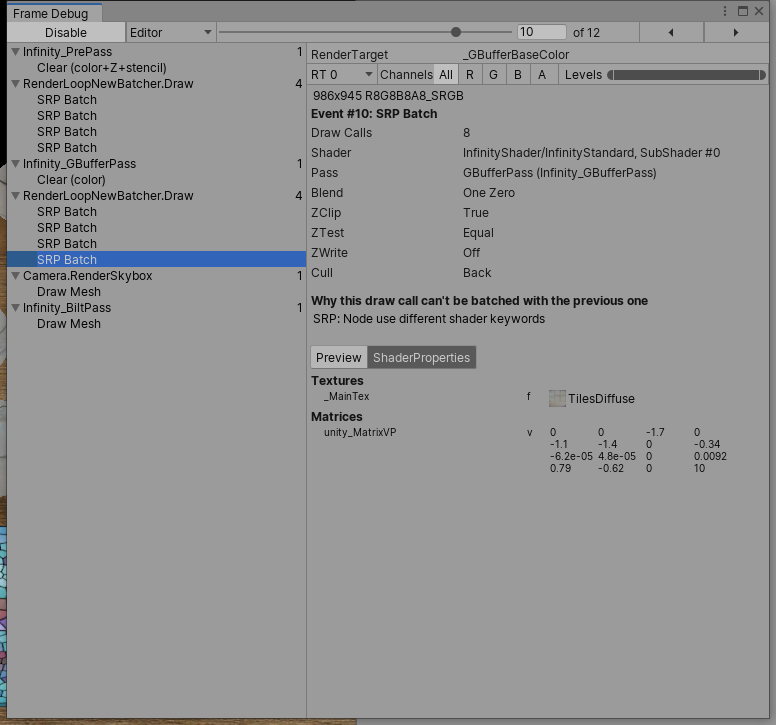
7.3 性能对比参考
实测环境为 Unity 2019.1,场景包含约 500 个 Opaque 物体,3 种 Material(CBuffer Layout 相同):
| 指标 | 无优化 | 仅 SRP Batcher | 仅 Static Batching | 混合 |
|---|---|---|---|---|
| SetPass Calls | ~500 | ~3 | ~50 | ~3 |
| Draw Calls | ~500 | ~500 | ~50 | ~50 |
| CPU 渲染耗时 | 基准 | 约 -40% | 约 -60% | 约 -70% |
SRP Batcher 作用于单个 Draw Call 的 CPU 代价(SetPass 次数锐减),Static Batching 则压缩 Draw Call 总量。两者叠加时,CPU 侧渲染开销的削减最为显著。GPU 侧的变化相对有限:Draw Call 合并减少了少量的 GPU Command Processor 开销,但 Pixel Shader 的工作量不变。