推荐语: 在实时图形渲染中,水体的渲染一直是一个技术挑战。其中如何精确模拟水的光学性质,如吸收和散射,是关键难点。此外为了确保水面的真实观感,需要对水面反射进行细致的模拟。从更广泛的视角看,水体的渲染可以分为三大部分:Meshing(网格化)、Shape(形状)、Shading(着色)。本文将重点探讨Farlight中的Water Shading的内容,这是一个为多平台优化而设计的水体着色解决方案。为了确保高效的性能,该方案特别利用了移动端的一些独特功能。对于在这个领域有兴趣或需求的读者,此方案将是一个启发式的参考。
| 字段 | 内容 |
|---|---|
| 提交人(作者) | 谷士浩(皮皮牛) |
| 案例规模级别 | 解决方案级 |
| 产出来源 | Farlight84 |
| 提交形式 | 源代码+资源 |
| 运行平台 | UnrealEngine(iOS/Android/Switch/Windows) |
一、Introduction
- 关于水体渲染的Shading部分,首先要提到的是,目前游戏业界的主流方案都不是基于物理的。到达水面的光除了在水表面发生反射之外,还有部分会进入水体内,经过吸收和散射后再次从水体表面反射出去。

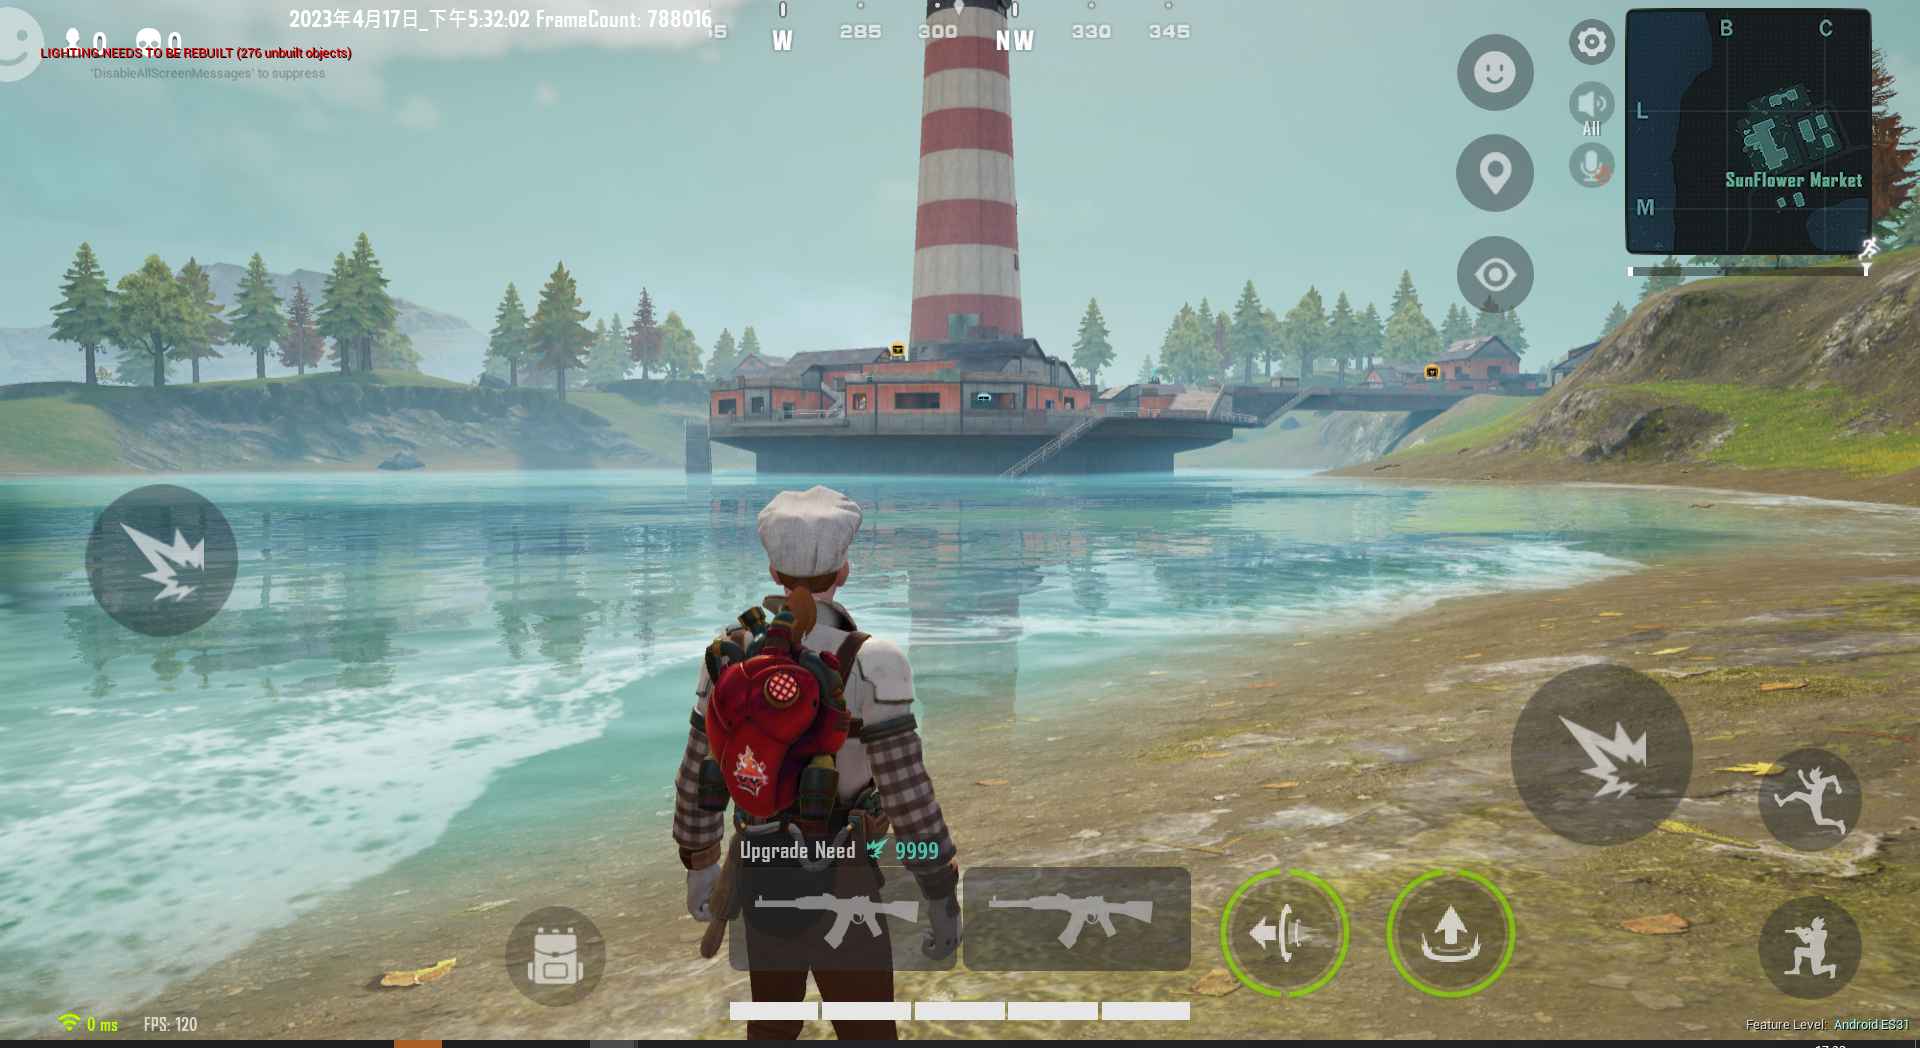
- 但实时渲染中,求解BSSRDF需要很大的计算量,所以实时渲染大多数依旧是非基于物理的经验型渲染方法,当然也不是说完全不尊重物理现象,只是实时渲染需要适当的Trick。基于这个思想将水体要点总结出以下类别 : Diffuse,Specular,Reflection,Translucency,Foam/WhiteCap,FlowMap,Underwater Haze。
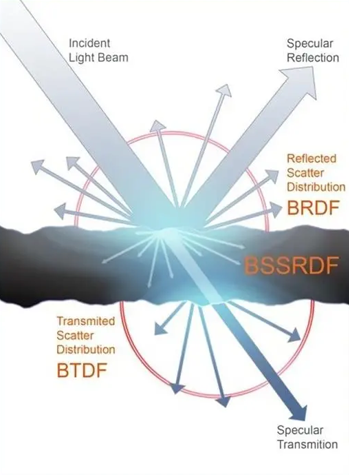
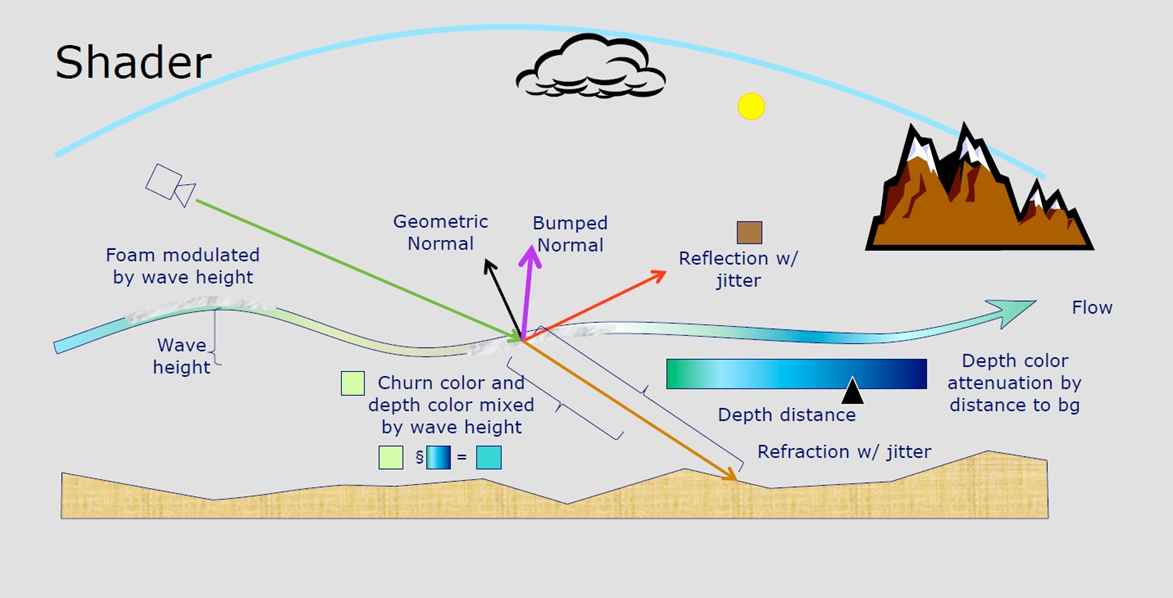
- 下面将深入探索移动端图形渲染中的水面着色与水下雾着色。重点关注如何针对不同的硬件水平进行分级渲染优化,尤其是在着色器层面和管线层面的策略,比如利用移动端的TBDR架构优势,探索如何在OnChip缓存上实现中间数据暂存以降低IO带宽开销。文章还会讨论如何利用ROB Unit和OnChip MSAA策略进一步提高渲染效率。最后,我们也将展望未来的发展方向和可能的技术扩展。
二、Shading
- 其中对水面影响最大的就是Diffuse与Translucency,物理意义上体现为Scattering(散射)与Absorption(吸收)两个变量,前者描述清澈度,后者描述看到的颜色。本文重点关注的也是这两个内容。
2.1 Absorption
- 吸收的着色伪代码表示为 :
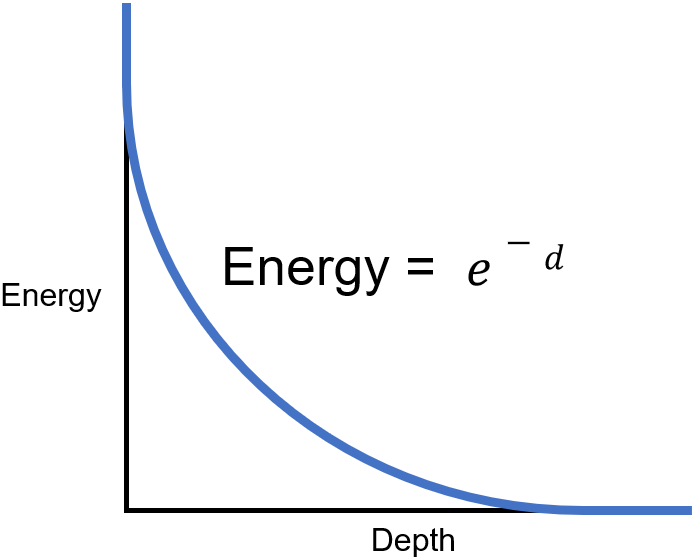
SceneColor * exp(-AbsorptionColor * (SceneDepth - PixelDepth))。核心思想为利用深度差去算BeerLaw的密度分布,如下图。
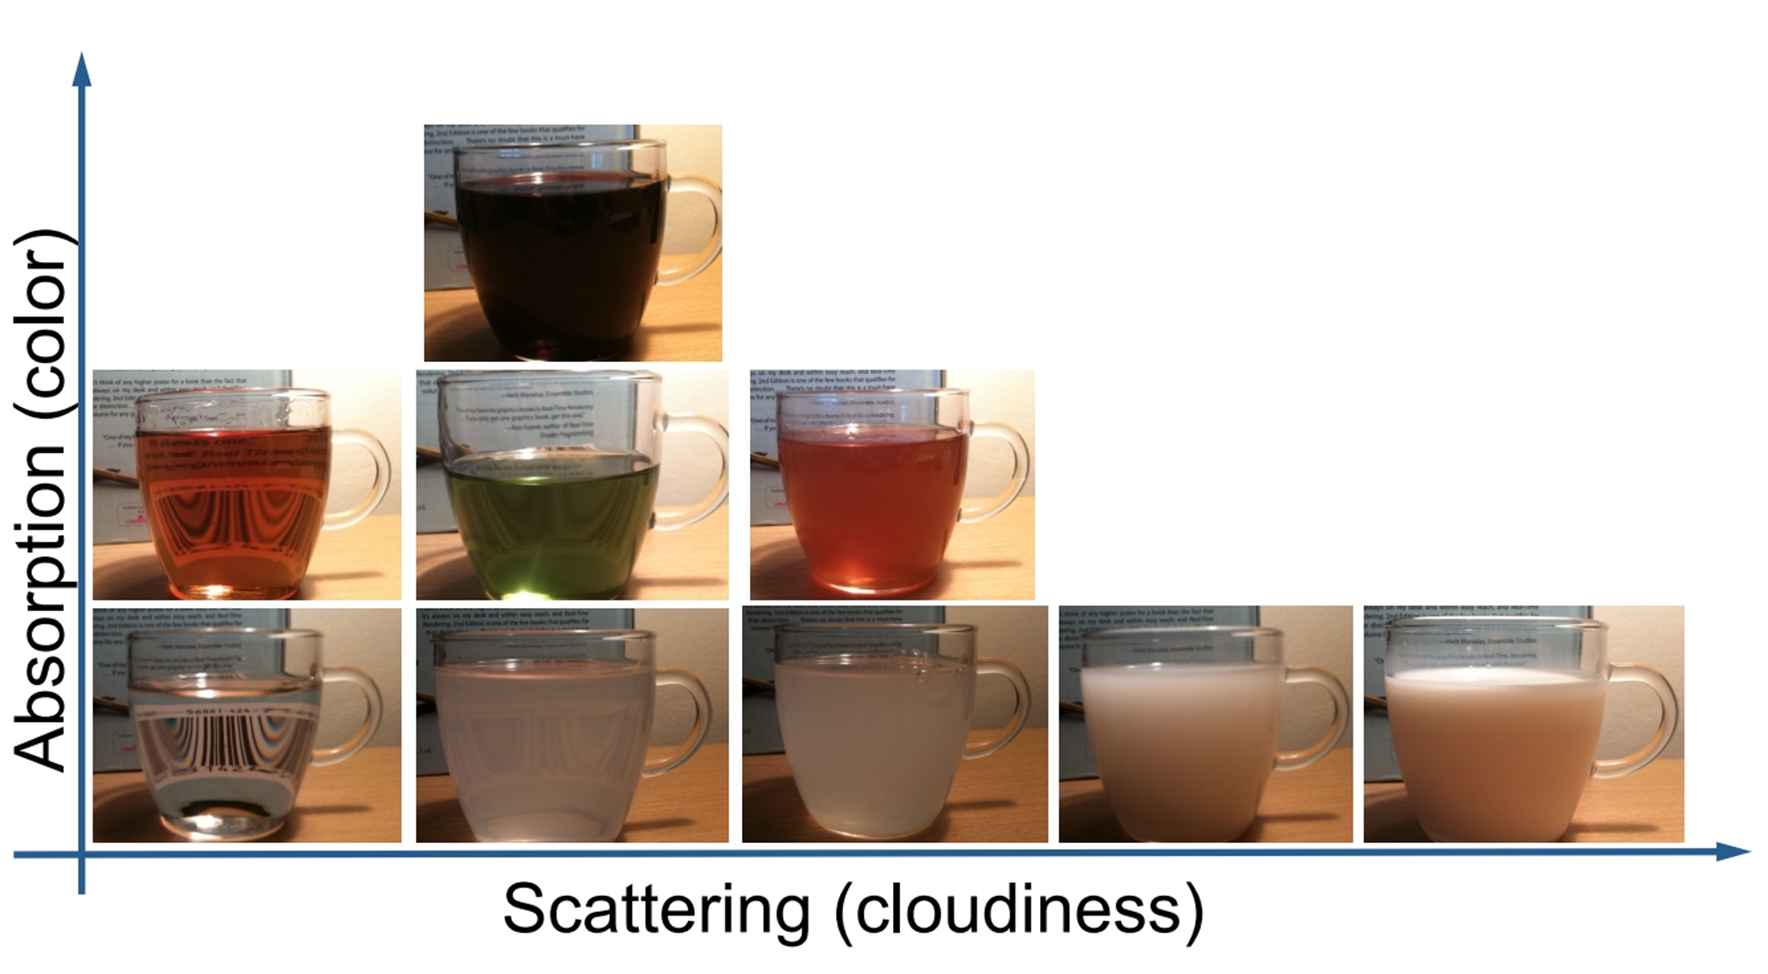
2.1.1 Common
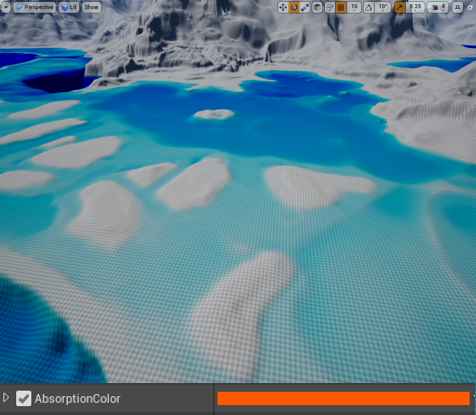
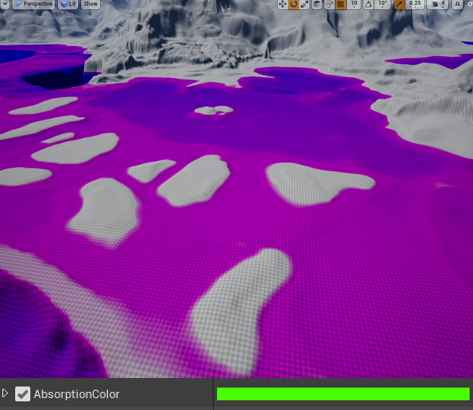
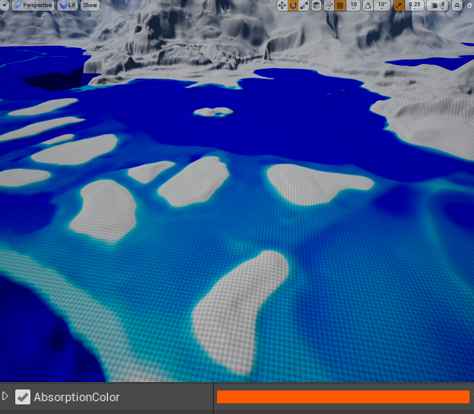
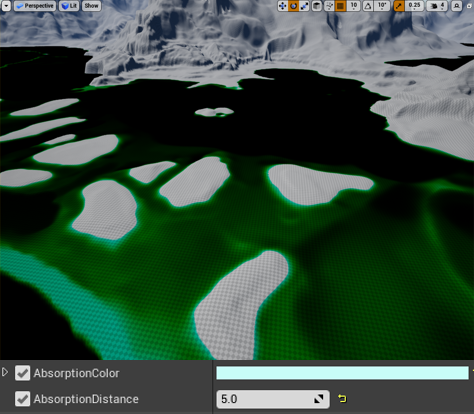
- 从不严谨的描述上来讲,物理现象上如果一个光谱的红色被吸收了,那么观察者是只能观察到蓝色。且吸收颜色越亮会导致吸收的距离越小。如下图所示。
吸收橙色看见蓝绿色 / 吸收绿色看见紫色 :
吸收亮度×1 / 吸收亮度×10 :
2.1.2 Art Friendly
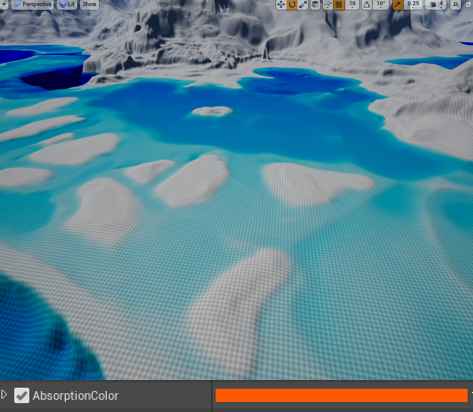
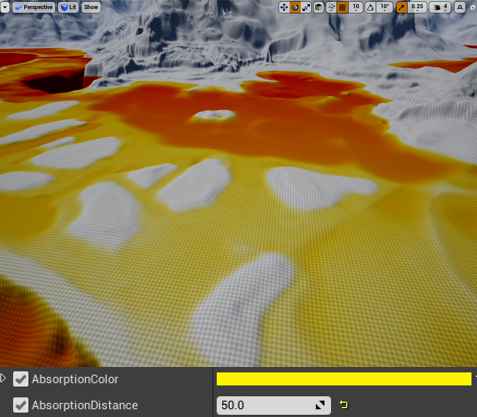
- 从美术的角度来分析这两个参数,其实不那么直观,甚至很反直觉。因此做了一个Trick,将逻辑运算直接反过来。这样从美术的角度来解释就是 : 吸收颜色就是看到的颜色,吸收的距离越大越透明。
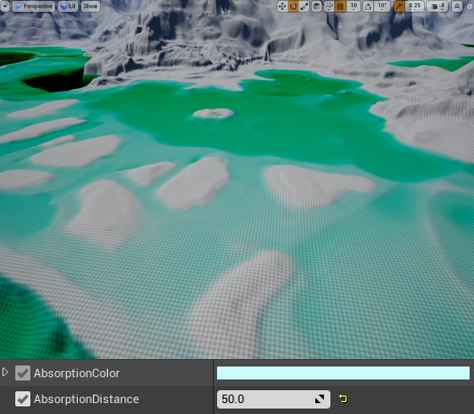
2.1.3 More Art Friendly
-
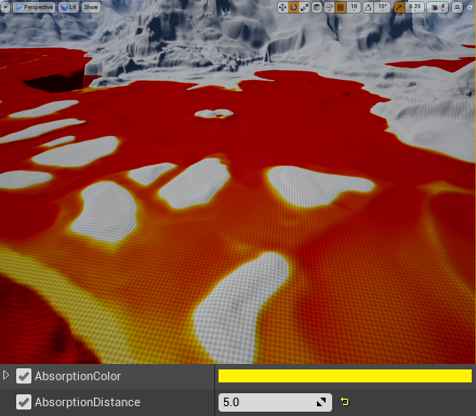
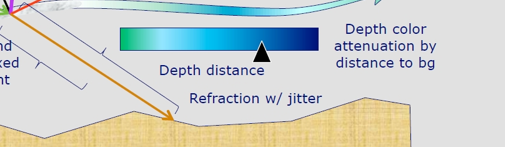
有时候美术方面会想做一些完全不可描述的吸收颜色,以上物理吸收算法就会很难达到要求的视觉效果。因此引入了LUT来模拟吸收的颜色与透明度,核心思想为使用深度差去查询LUT的颜色与透明度。
-
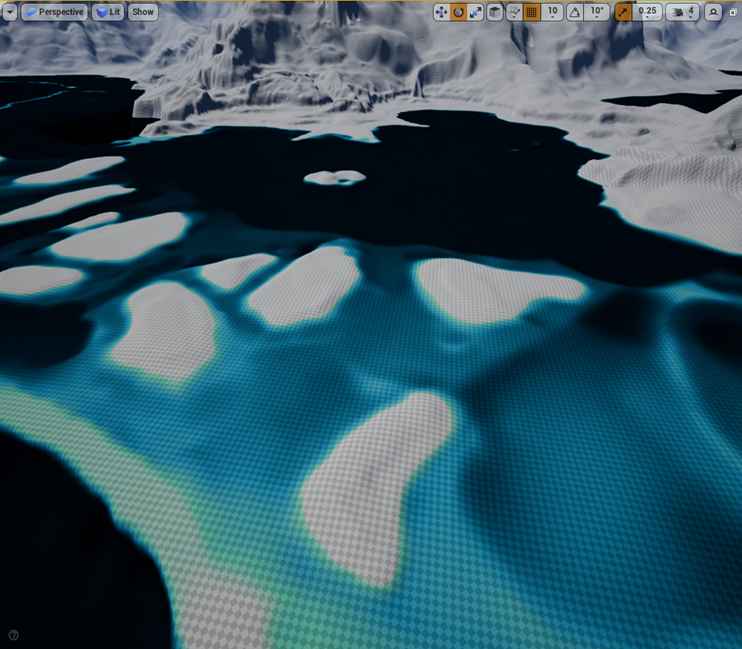
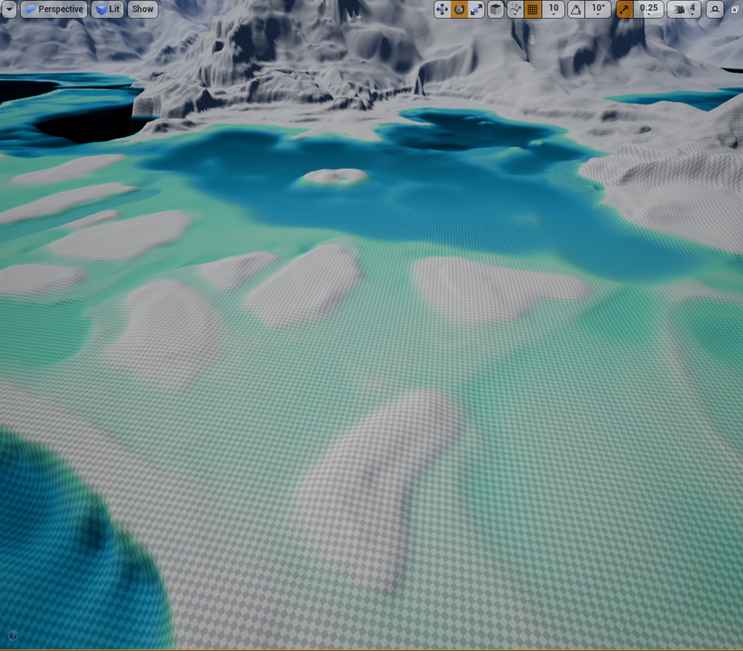
不同RGBA数值分布的LUT可以得到千奇百怪的吸收颜色效果,如下图就是两个不同颜色与透明度分布LUT采样后得到的效果。

2.1.4 Calculating Space
-
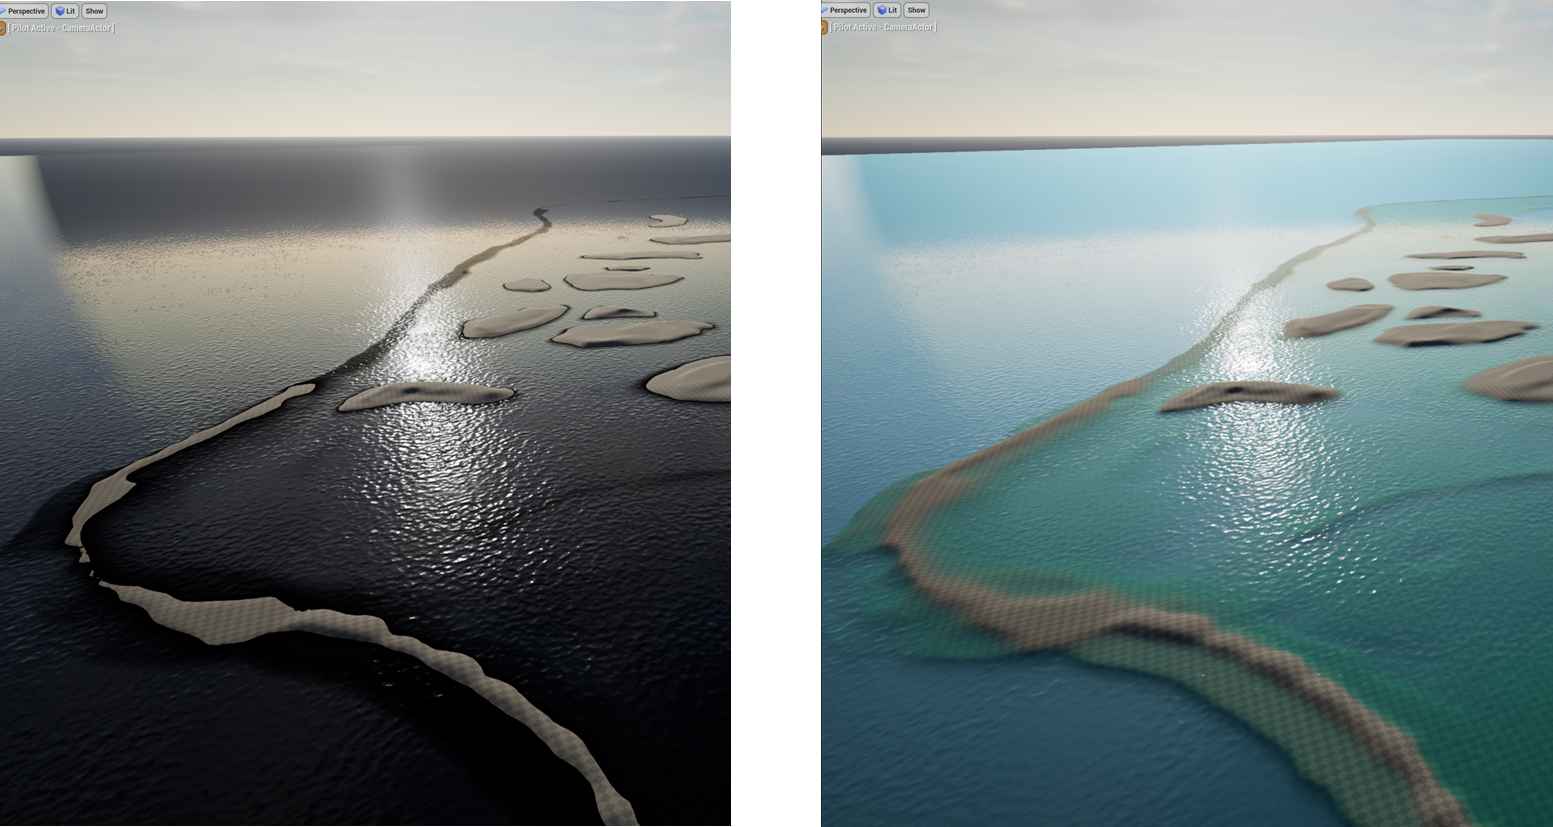
通常计算这种深度差常见的方法是屏幕空间背景深度与屏幕空间表面深度的差,于是会得到一个随视角剧烈变化的视觉效果(下左)。
-
为了缓解就需要换一种更稳定的空间去计算深度差。使用世界空间下的背景深度与表面深度来计算,便可以得到一个稳定的变化效果(下右)。
2.2 Scattering
- 从上面吸收的结果可以看到如果吸收率不够那么该区域会呈现黑色,而这部分就需要退化为散射的效果。视觉上表现其实就是水的Fog效果。
2.2.1 Common
- 散射的着色伪代码 :
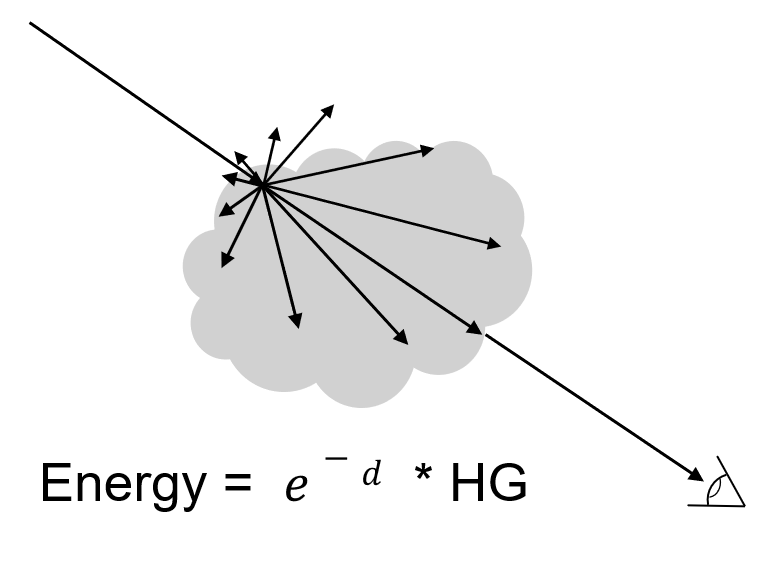
lerp(FogColor, AbortColor, exp(-Density * DepthDifference))。与吸收同理,根据深度差去计算BeerLaw的能量分布。
散射密度低 / 散射密度高 :
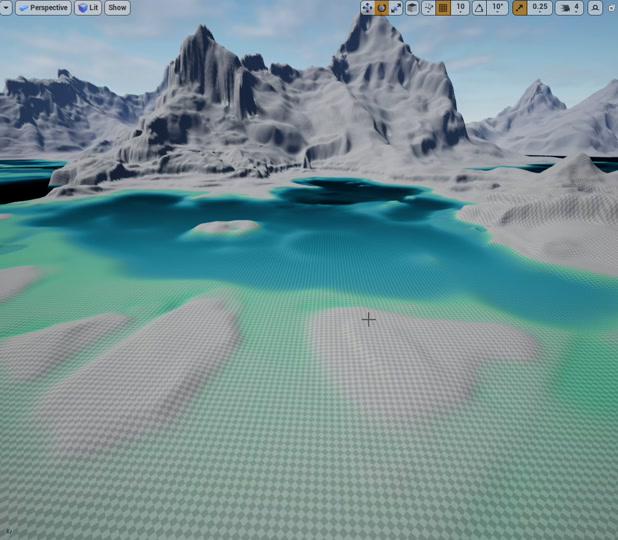
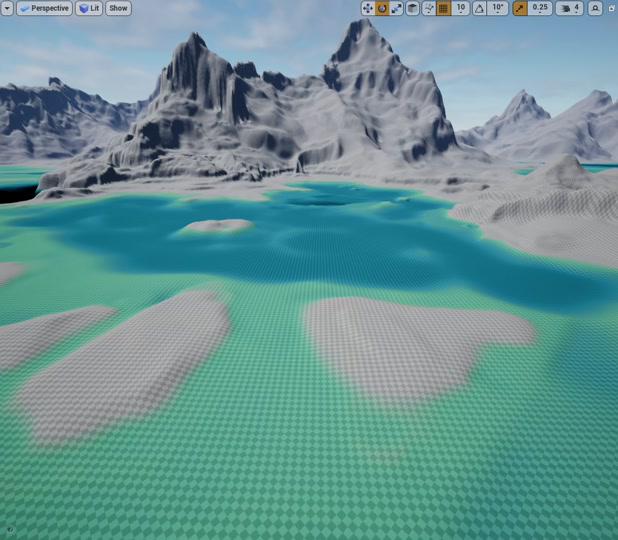
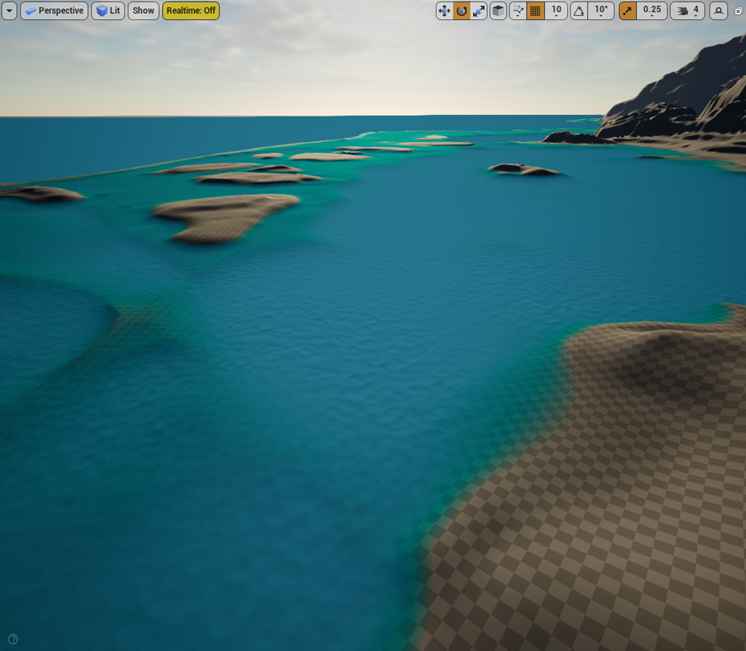
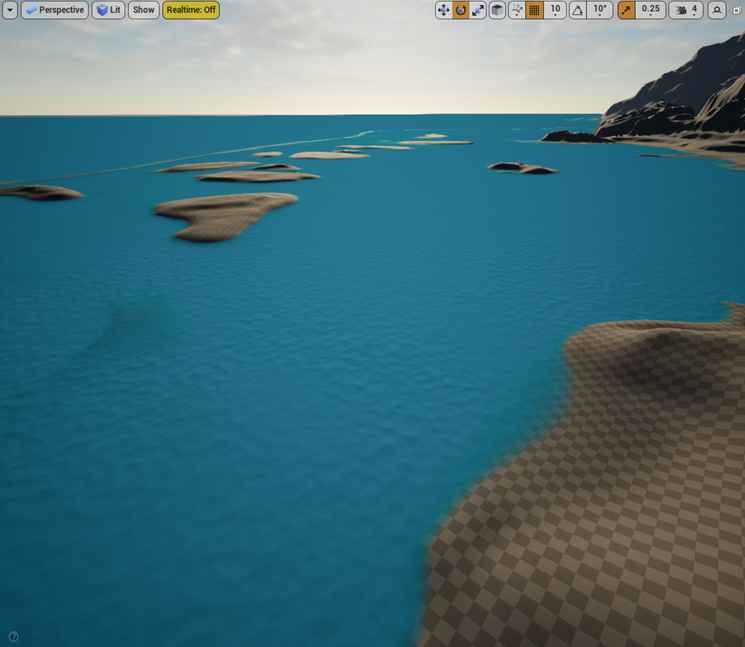
2.2.2 Phase Function
-
相位函数,描述一束光进入传输介质后会散射与射出到观察视角的比例的值。g表示比例的强弱,cos theta表示view与light的夹角。
-
算法上在原先的深度差上加入HG的衰减得到带有各项异性的散射效果。设置g为0.8,得到更有体积密度的质感,看起来不那么平。
g = 0.1 / g = 0.8
2.3 Normal
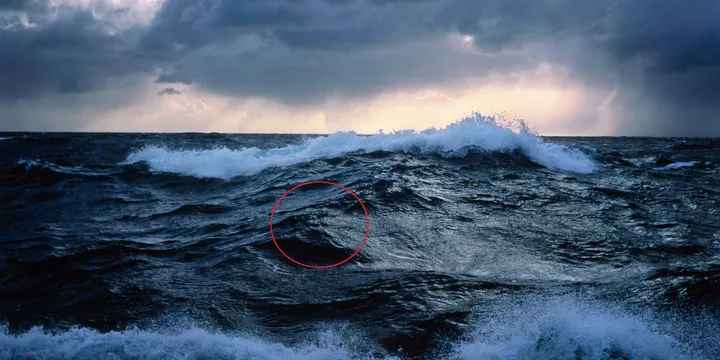
- 真实海洋中的波浪形状其实是比较尖锐的一种波形,如下图所示。波涛的还有在波浪尖部位会呈现出非常锐利的视觉效果。
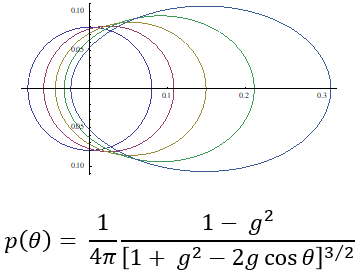
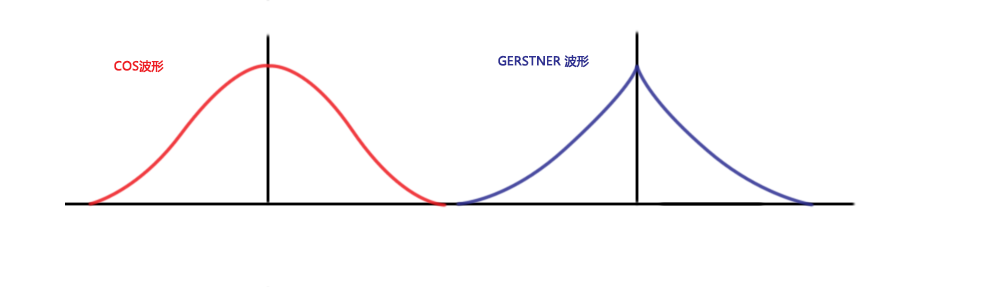
- 波形通常分为正弦和余弦两种,但水体为了表现的更尖锐会使用一种称之为Gerstner的特殊波形。下图与红色的余弦波相比Gerstner波在两侧有收紧的趋势,和上图真实海洋表面更加接近。
-
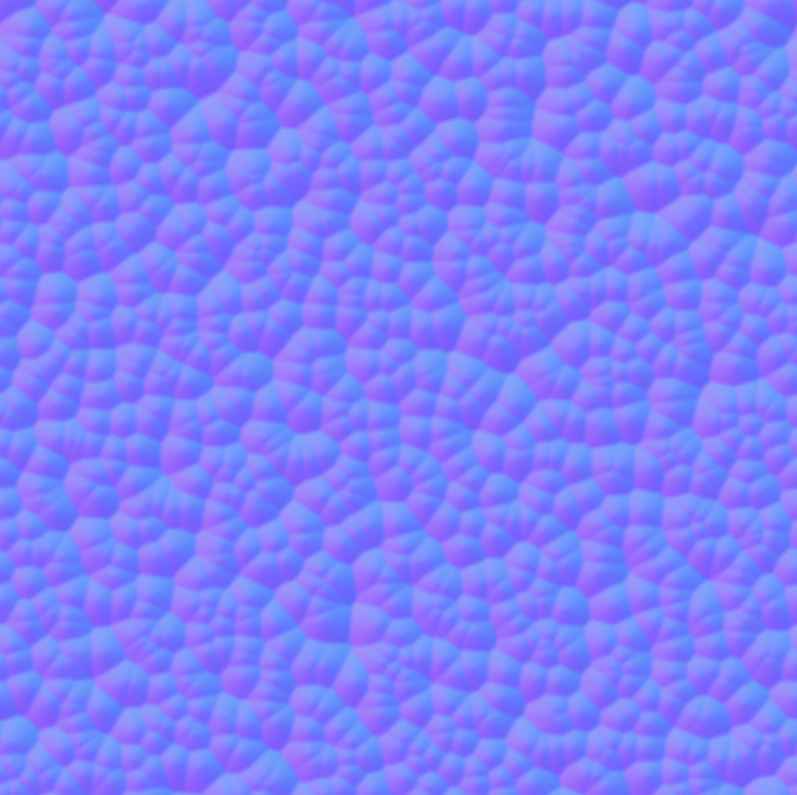
为了缓解Vertex的计算压力,并没有使用上述波形去做VertexMotion。只是基于上述内容使用了一种尖锐的波形的法线来Trick出类似的效果(下左)。
-
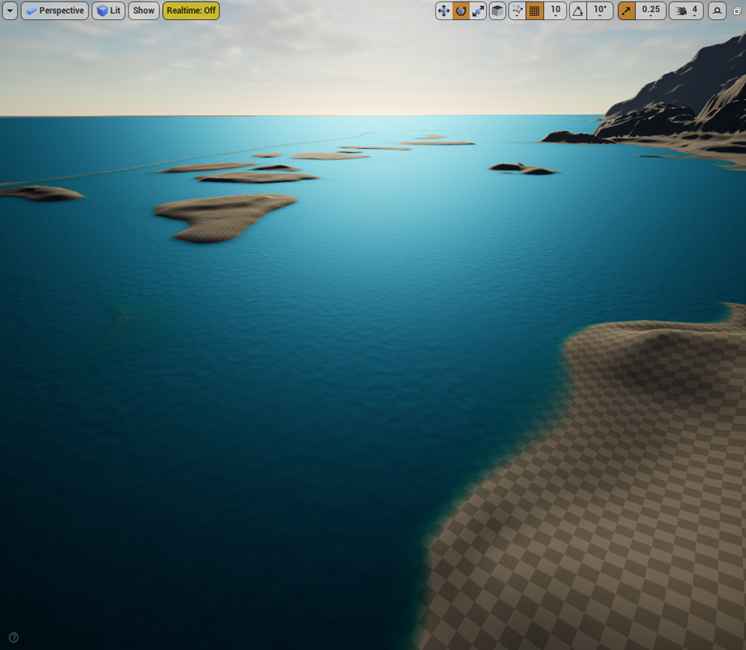
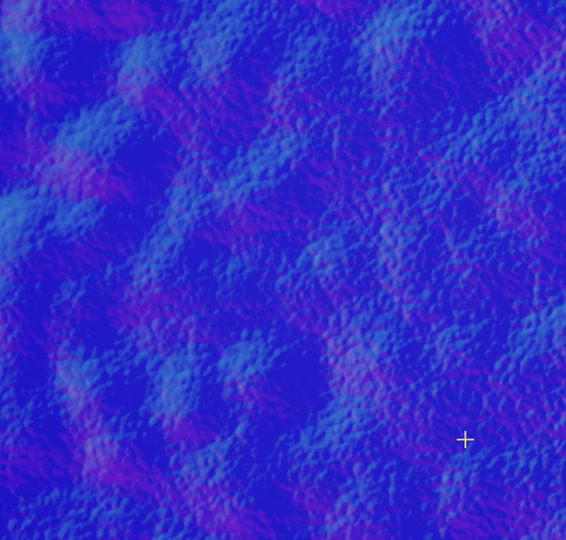
使用上述Normal叠加4层不同UV方向Panner流动,结合不同UV Scaling的效果,即可得到水面波浪滚滚的法线描述信息(下左)。
- 利用这个法线还可以去对Absorption的SceneColor采样的UV做扭曲,实现对背景的假折射扰动的效果。
2.4 Specular
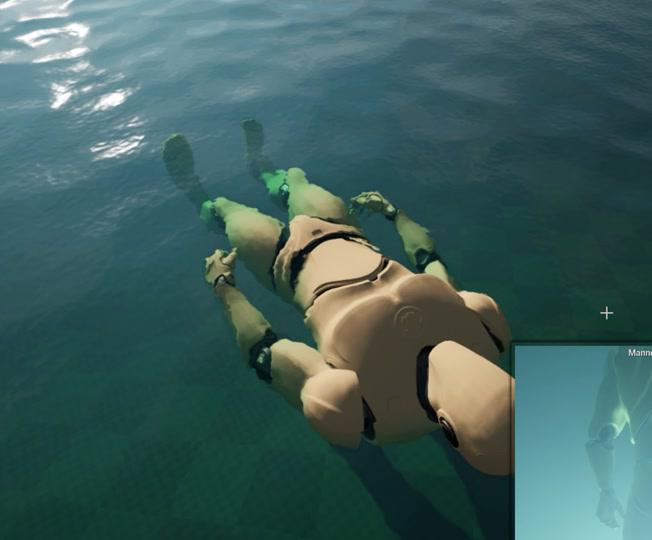
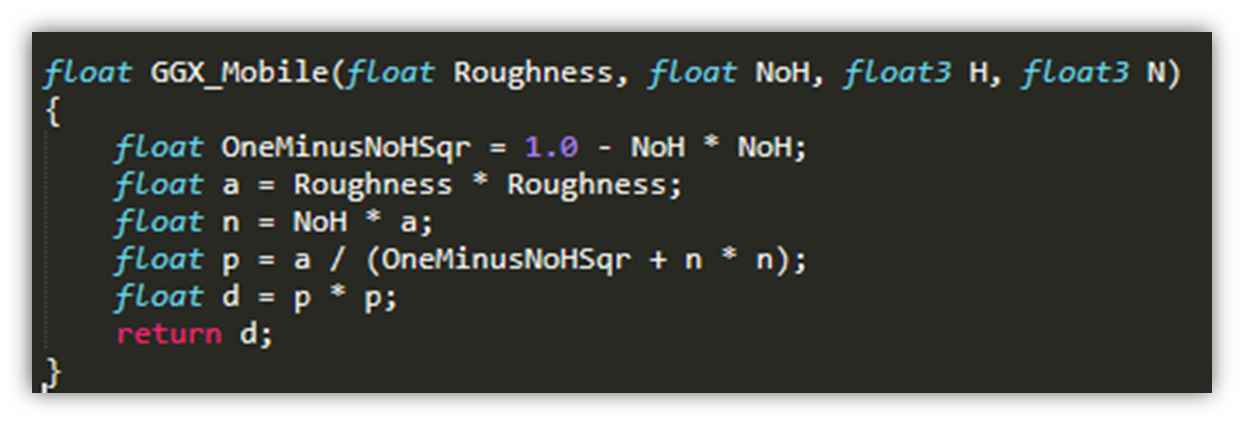
- 使用标准的GGX的法线分布去结合上述几何信息带入光源信息即可。
2.5 Reflection
2.5.1 Previous Works
- 常见的反射方法有平面反射,屏幕空间反射,HiZ屏幕空间反射,屏幕空间平面反射。但这些方法要么DrawCall/State太多,要么循环采样带宽开销大,对于移动端GPU来讲都是很致命的。
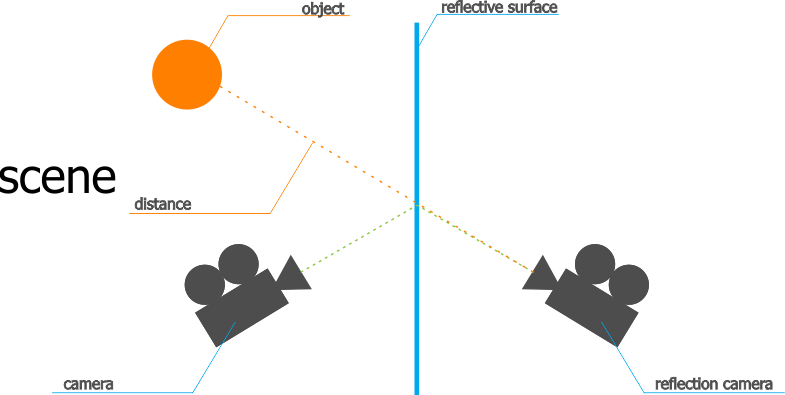
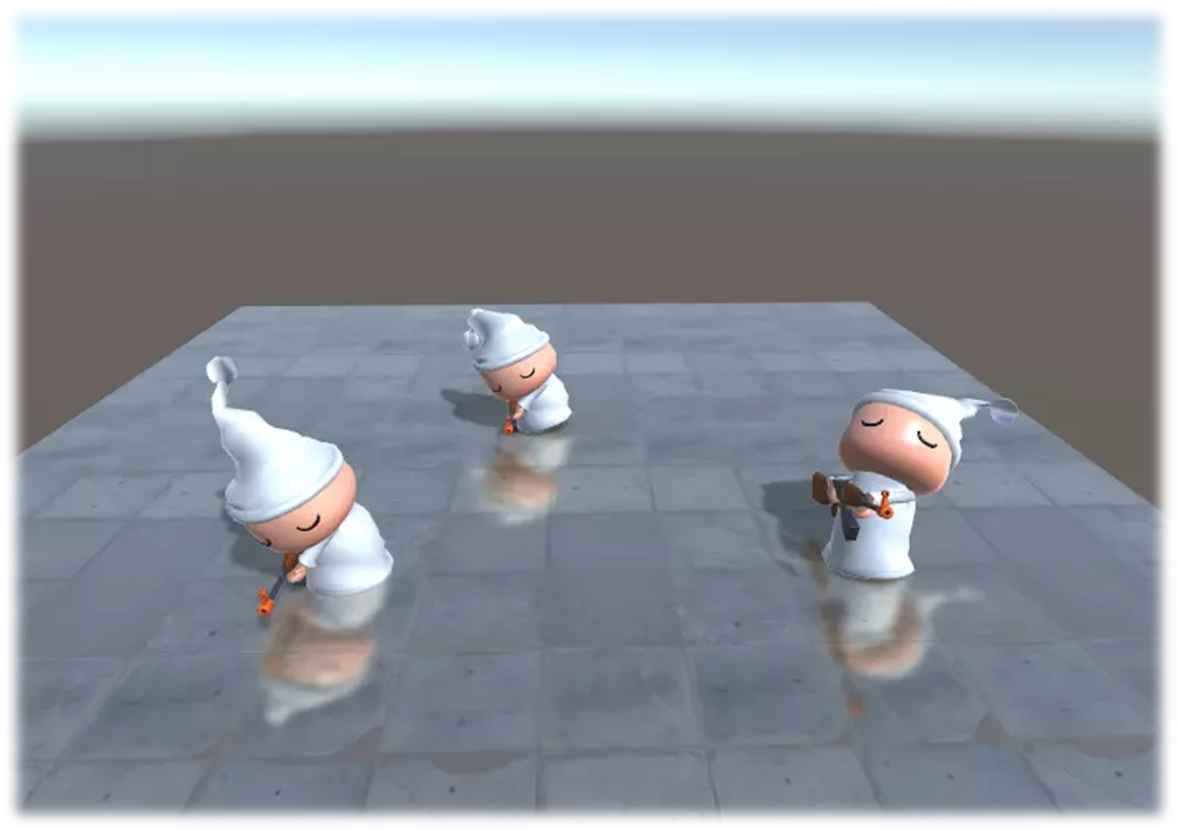
a. 平面反射 : 需要根据PlayerCamera计算反射矩阵变换,重新渲染一次场景得到反射贴图并传递给Shader结合矩阵换算UV采样。代价是2倍的图形管线任务计算量。
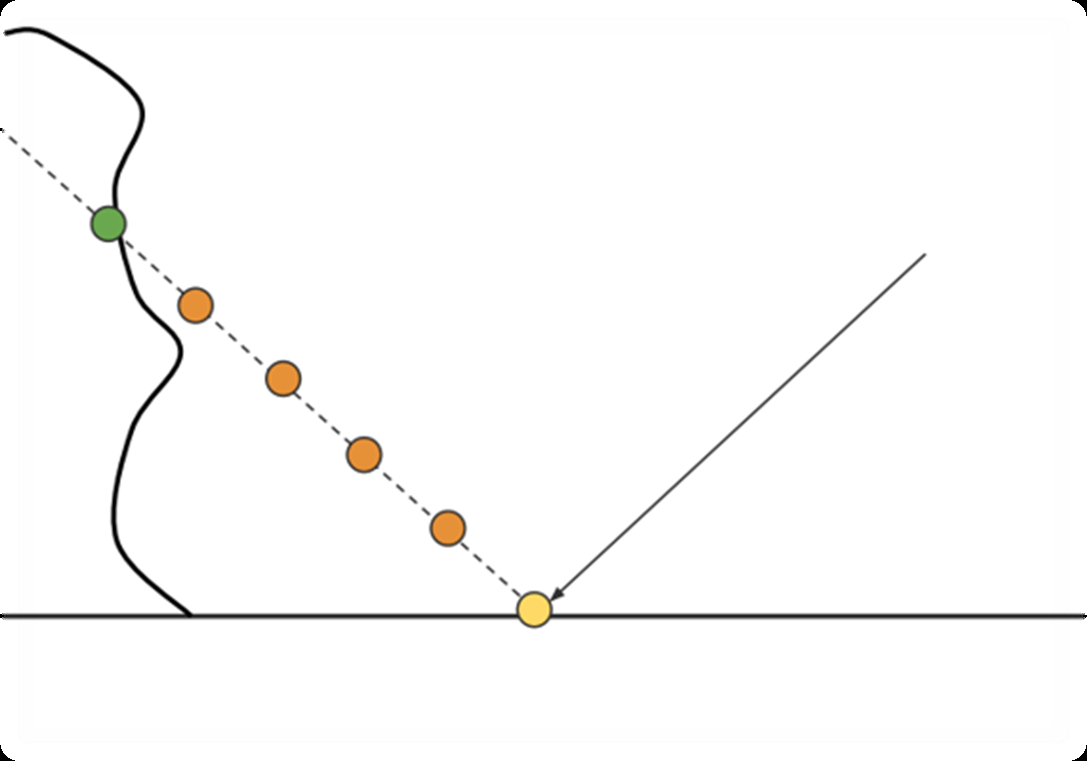
b. 屏幕空间反射 : 根据屏幕空间输出的几何信息(Normal,Depth),还原世界位置并计算反射向量,沿着反射向量步进,步进的新位置投影到屏幕空间采样深度并与投影后的Z对比,以此来检测与场景的碰撞情况。代价是N倍的带宽IO访存步进几何信息的采样。
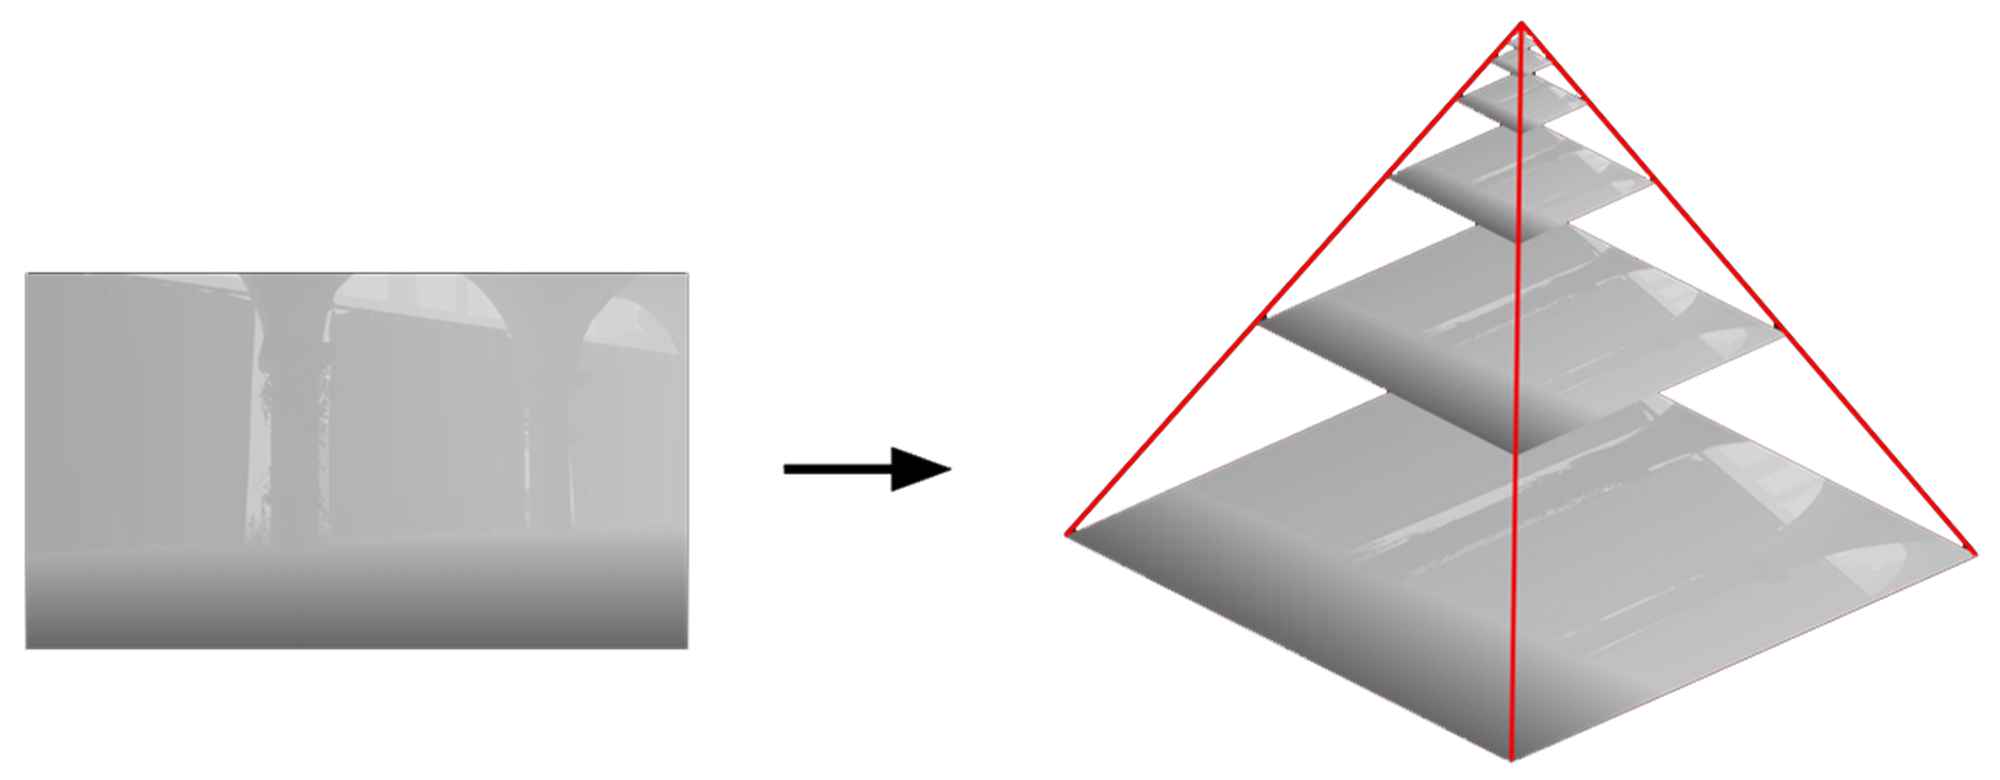
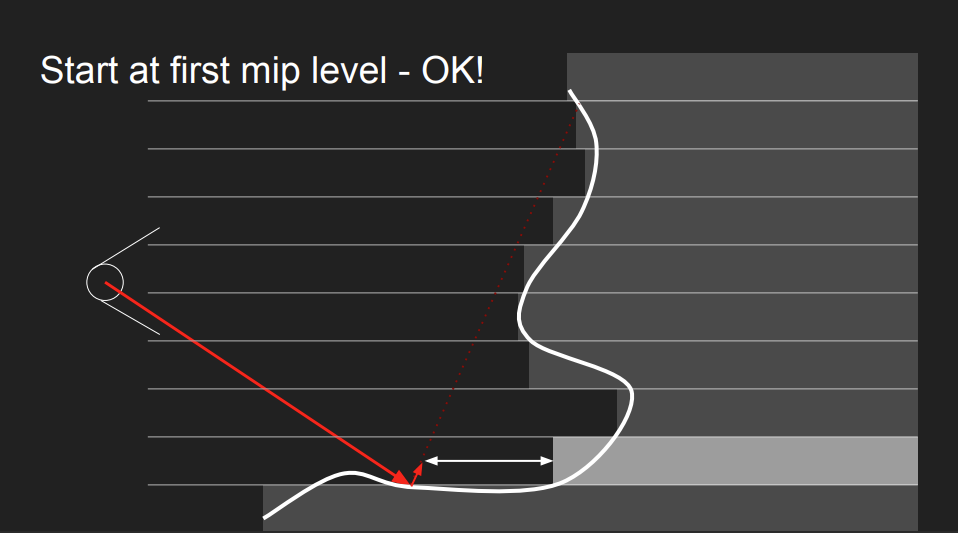
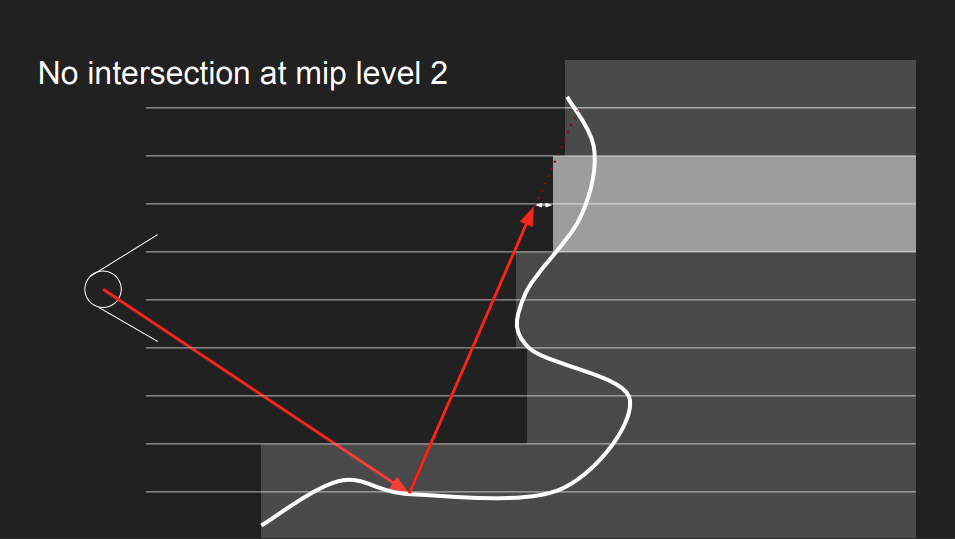
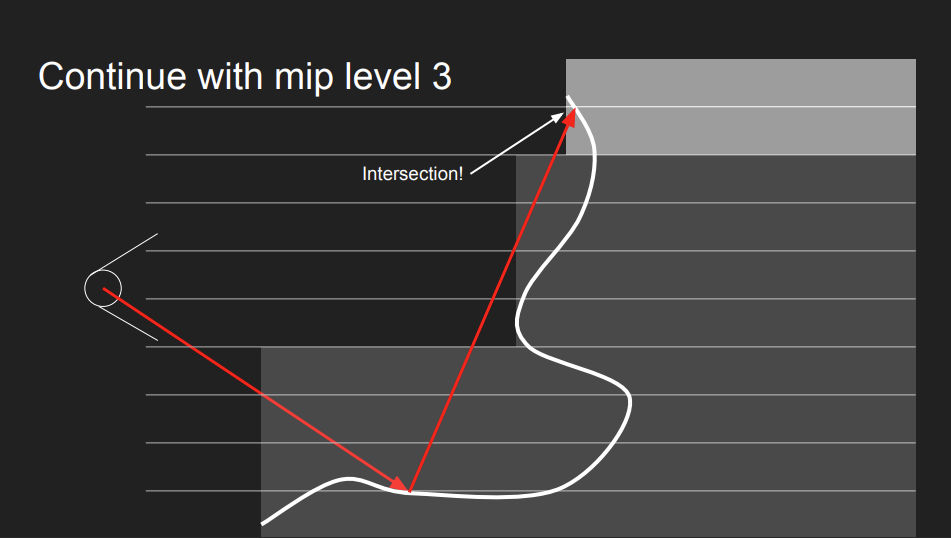
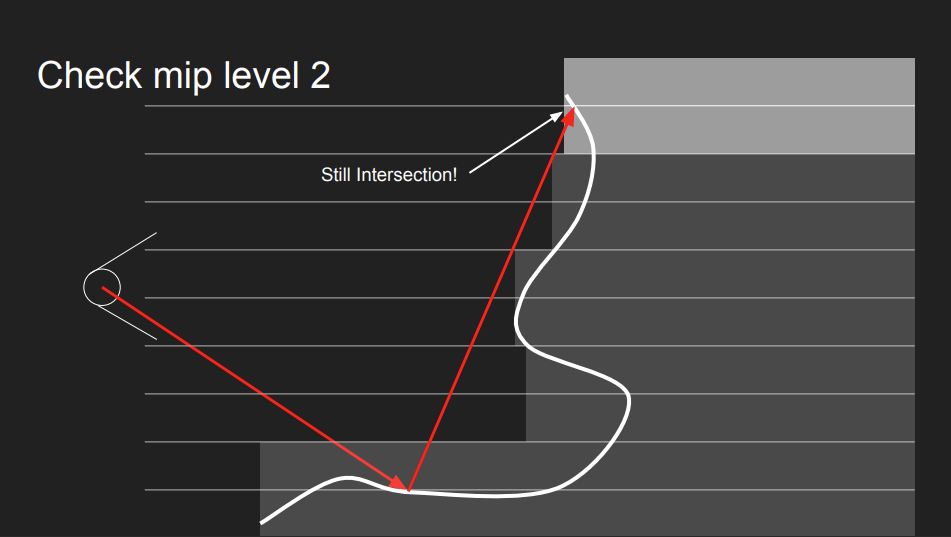
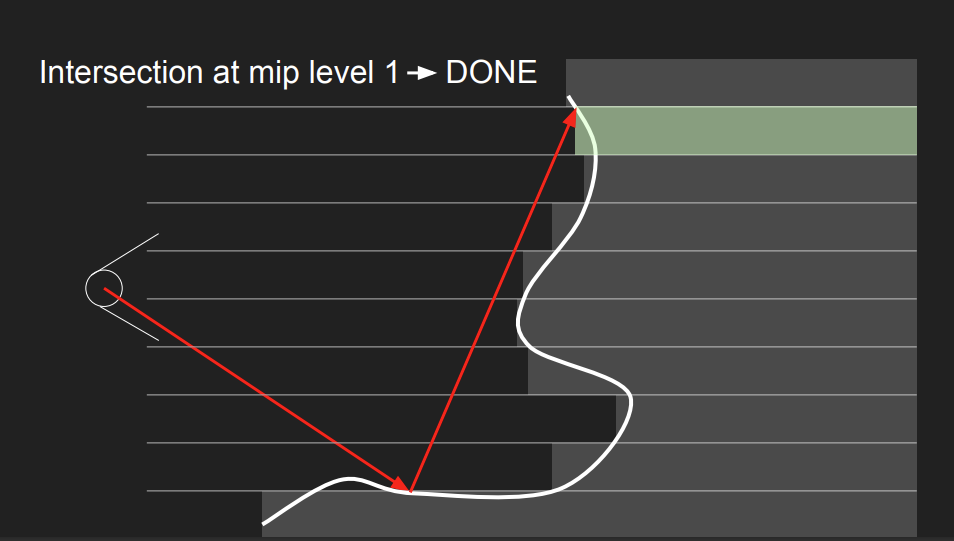
c. 分层深度的屏幕空间反射 : 为了缓解普通屏幕空间追踪浪费的采样点(上图右),需要使用分层次的加速结构。如下图生成一个带MipChain的深度图。
d. 追踪的时候用这个带层级信息的深度图,去动态调整追踪的步长,以此跳过无效区域,将原本需要32甚至64次常规步进减少到几次内完成。代价是消耗更多带宽去生成带层次的深度信息。
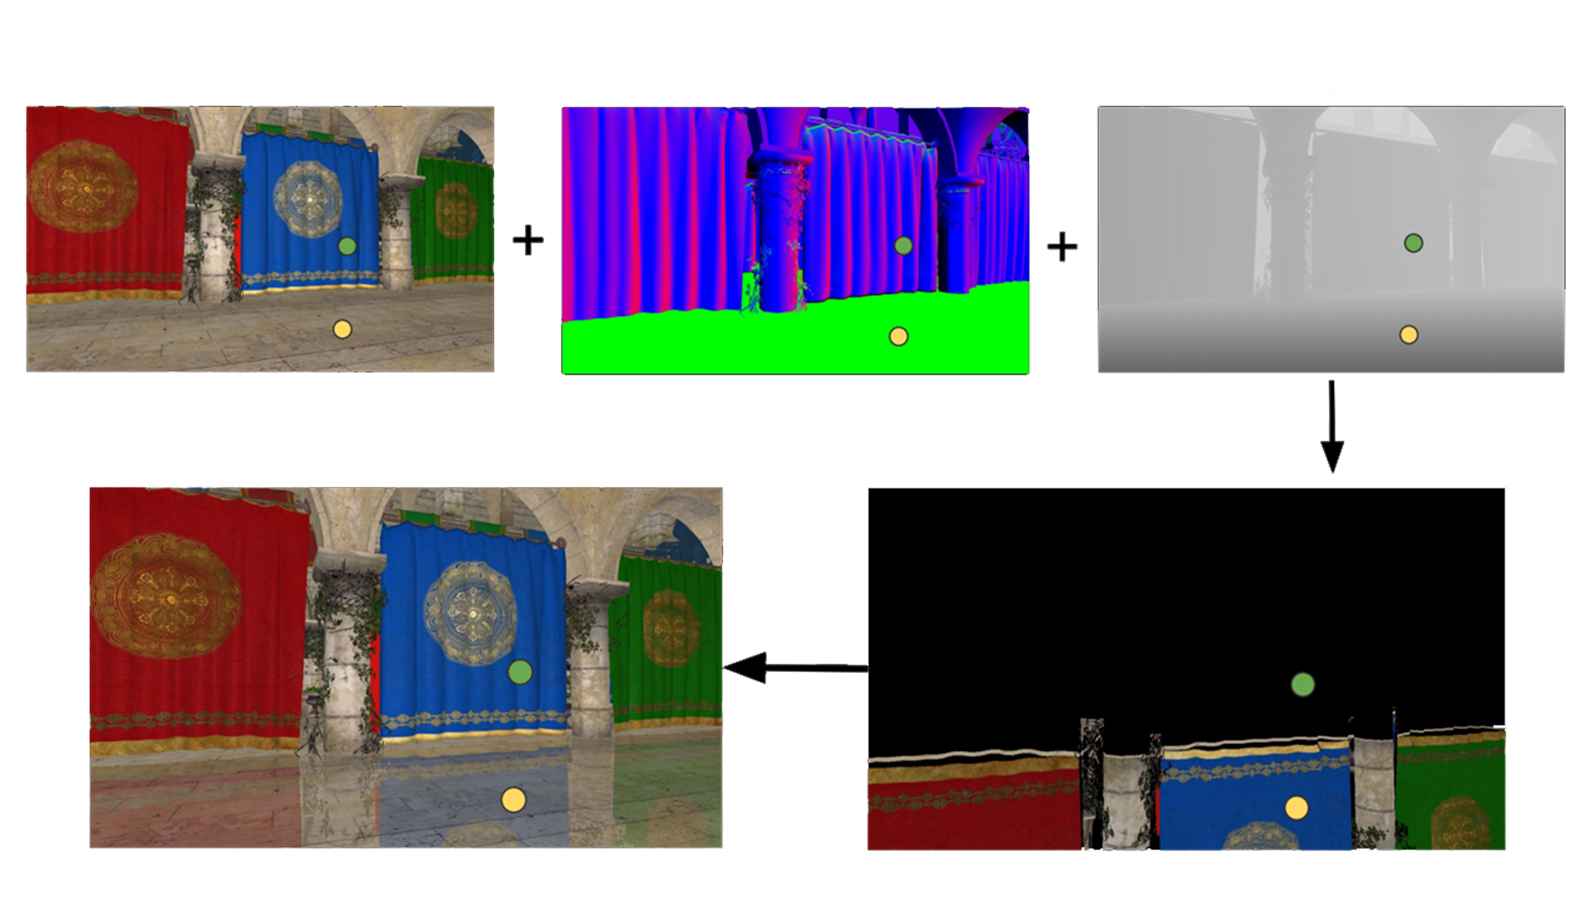
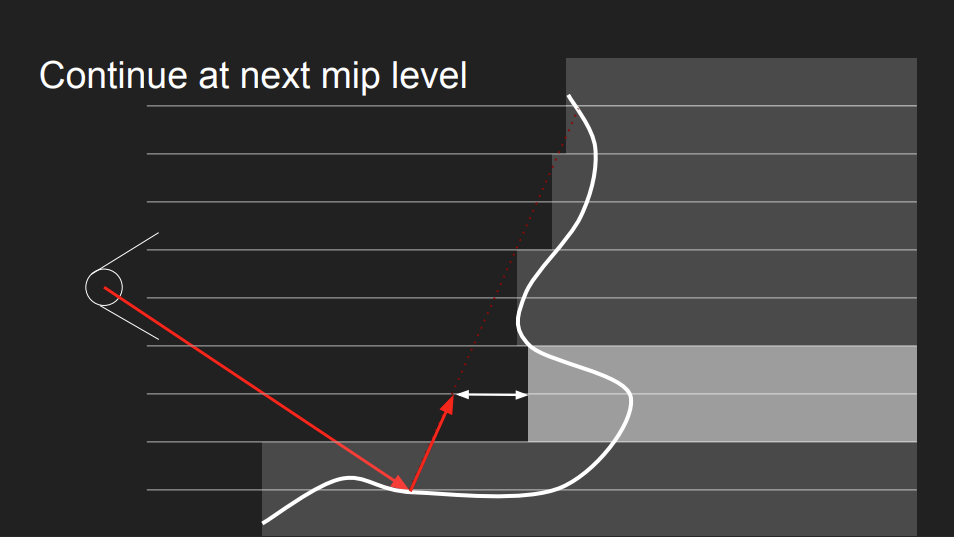
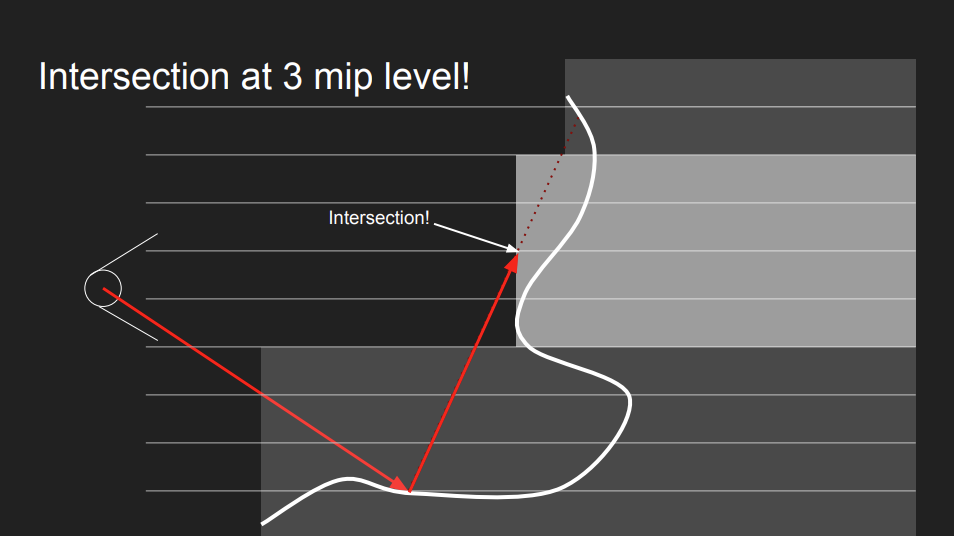
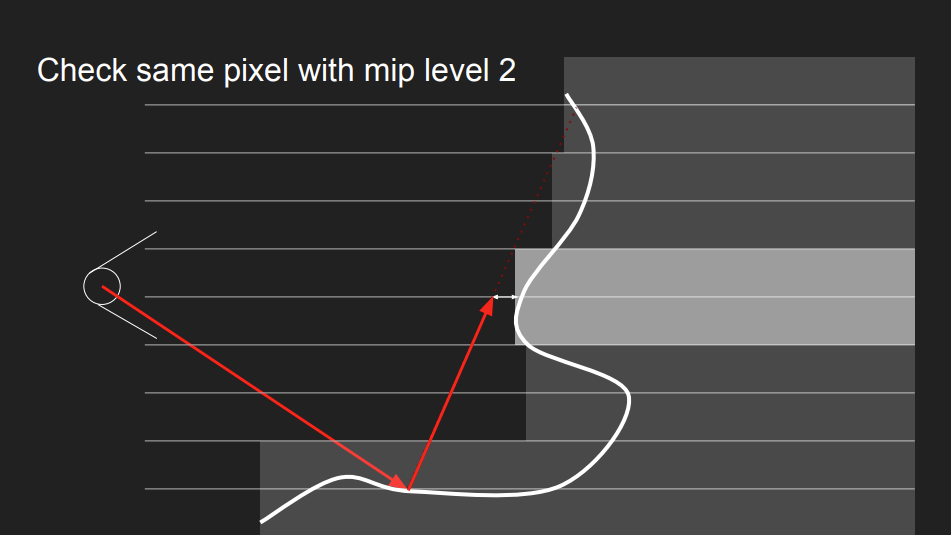
e. 屏幕空间平面反射 : 假设只有平面,利用水平面结合DepthBuffer直接翻转WorldPos,重投影后利用CS的原子操作实现深度测试。代价是需要支持ComputeShader才行。
2.5.2 Our Solution
- 移动端受限于带宽速度,采样的图不能过多,使用的图不能太大,需要避免频繁的切换RenderPass。尽量减少与主存的交互,减少管线重新配置导致的寄存器状态的刷新。
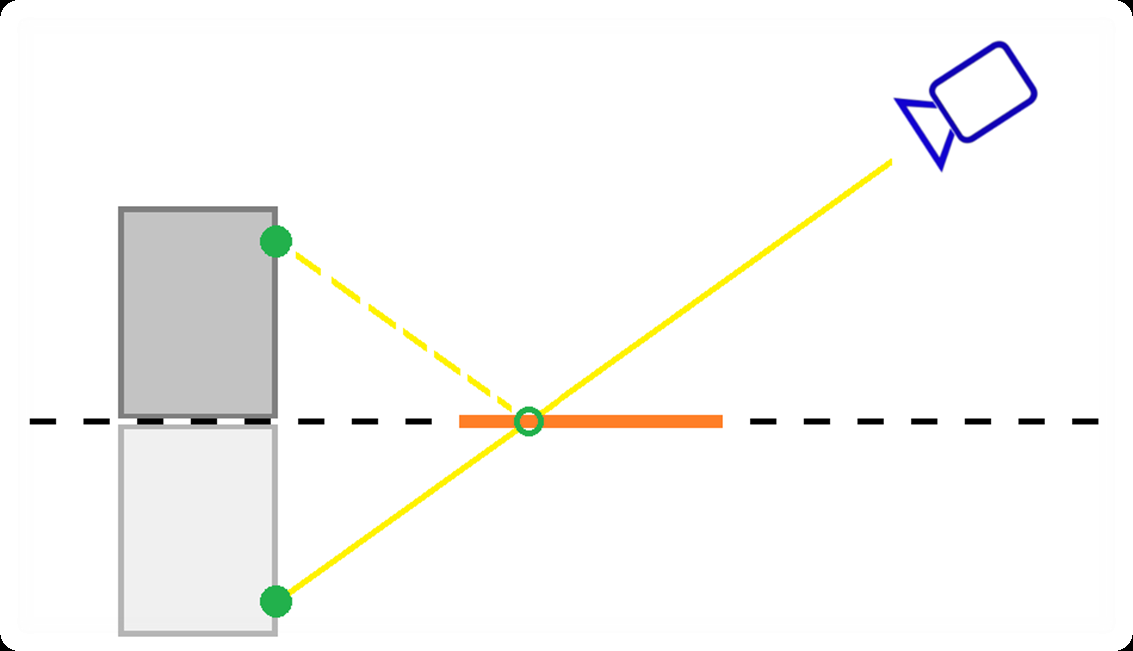
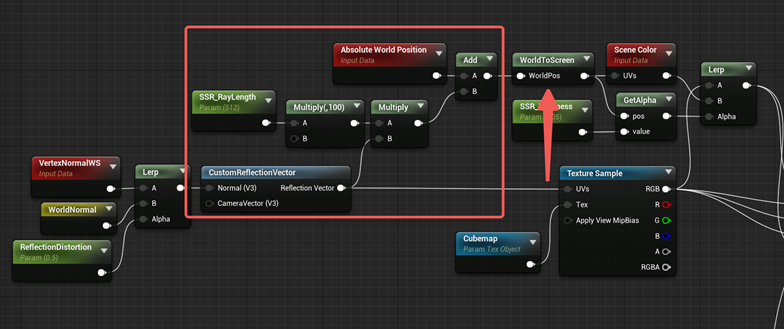
a. 上述的几个方案或多或少都有提到的这些缺陷,考虑到实际游戏中(Farlight84),都是远距离且空旷的水面,结合上述限制条件,思考了一种只能在距离远且空旷的水面使用的1 Step的SSR。
b. 核心思想就是直接将WorldPos沿着反射方向拉长,然后投影到屏幕空间,得到的UV去采样背景颜色,拿到精确的反射效果。因为只有1个Step所以性能在移动端非常可控。
c. 但代价是不能用在复杂的反射平面上,比如室内的地板。不过好在水面不存在这种情况。
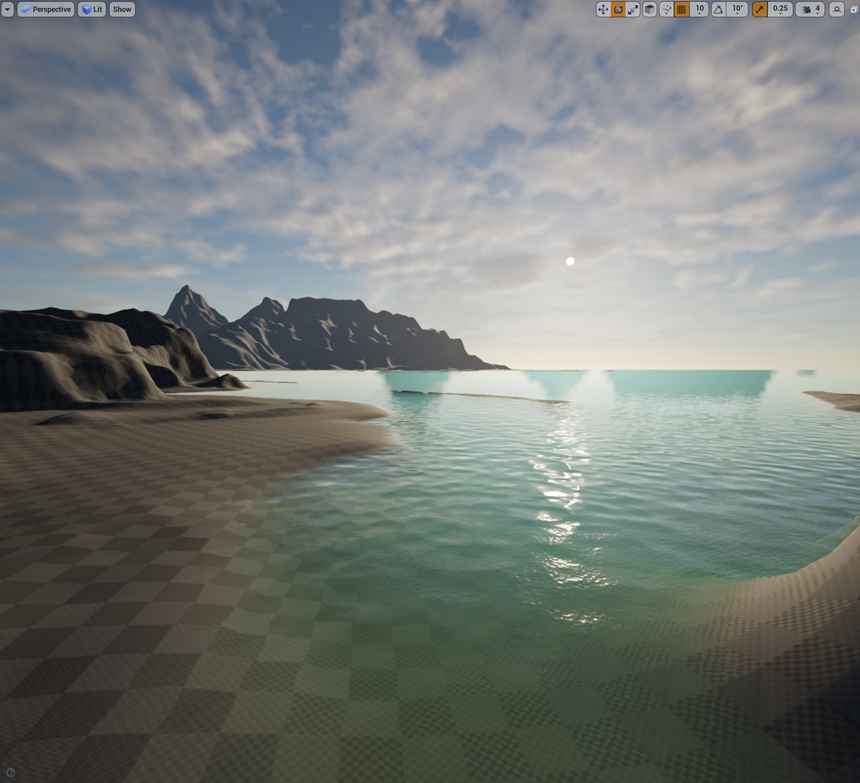
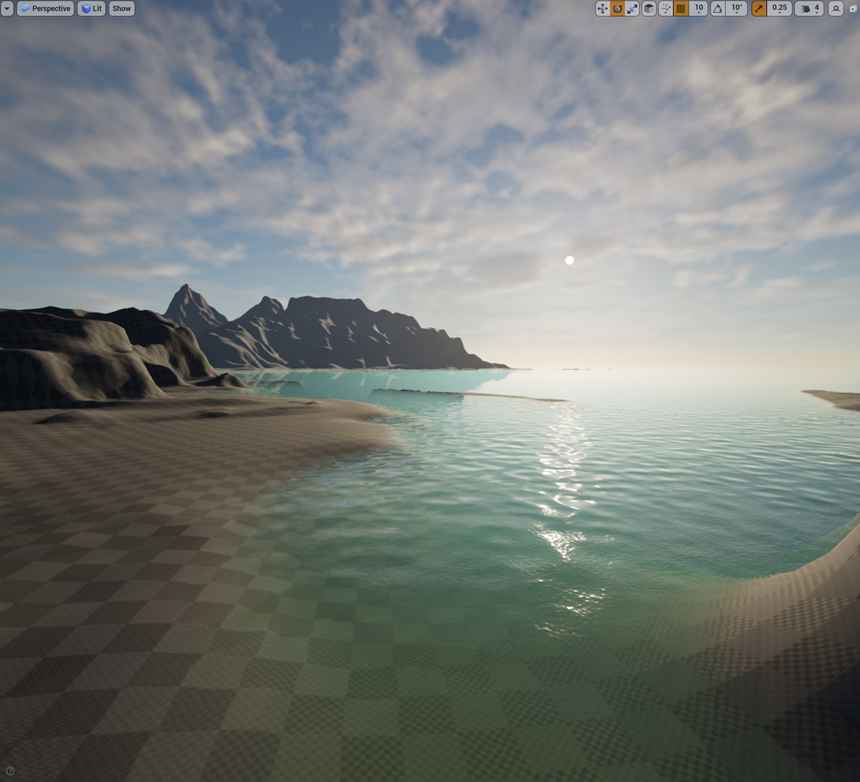
无SSR / 有SSR :
2.6 Final
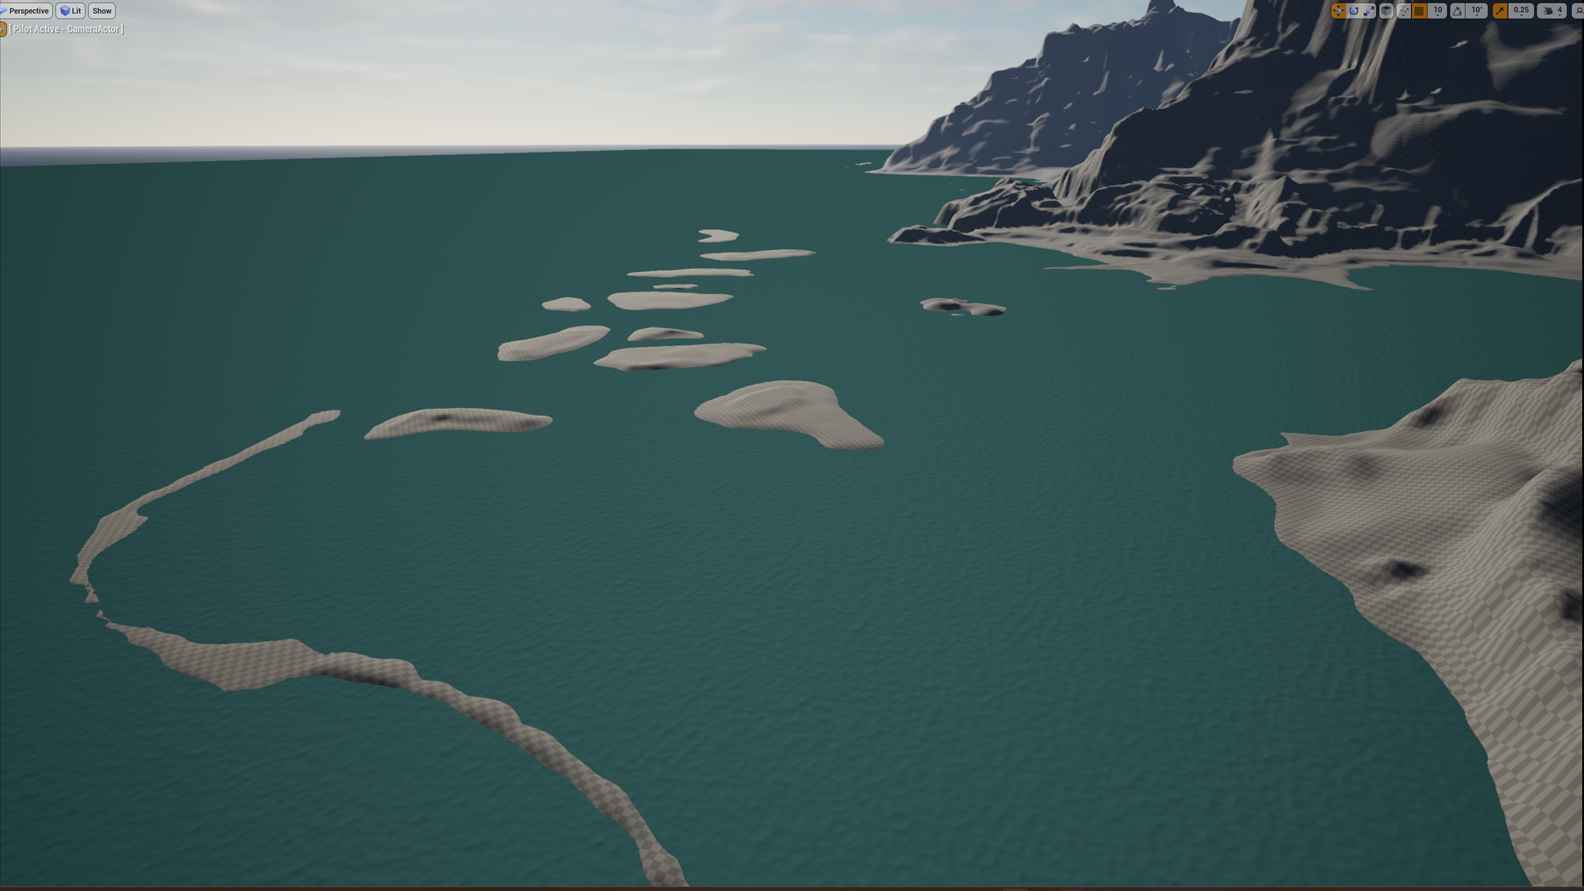
2.6.1 Only Scattering
2.6.2 Add PhaseFunction
2.6.3 Add Specular
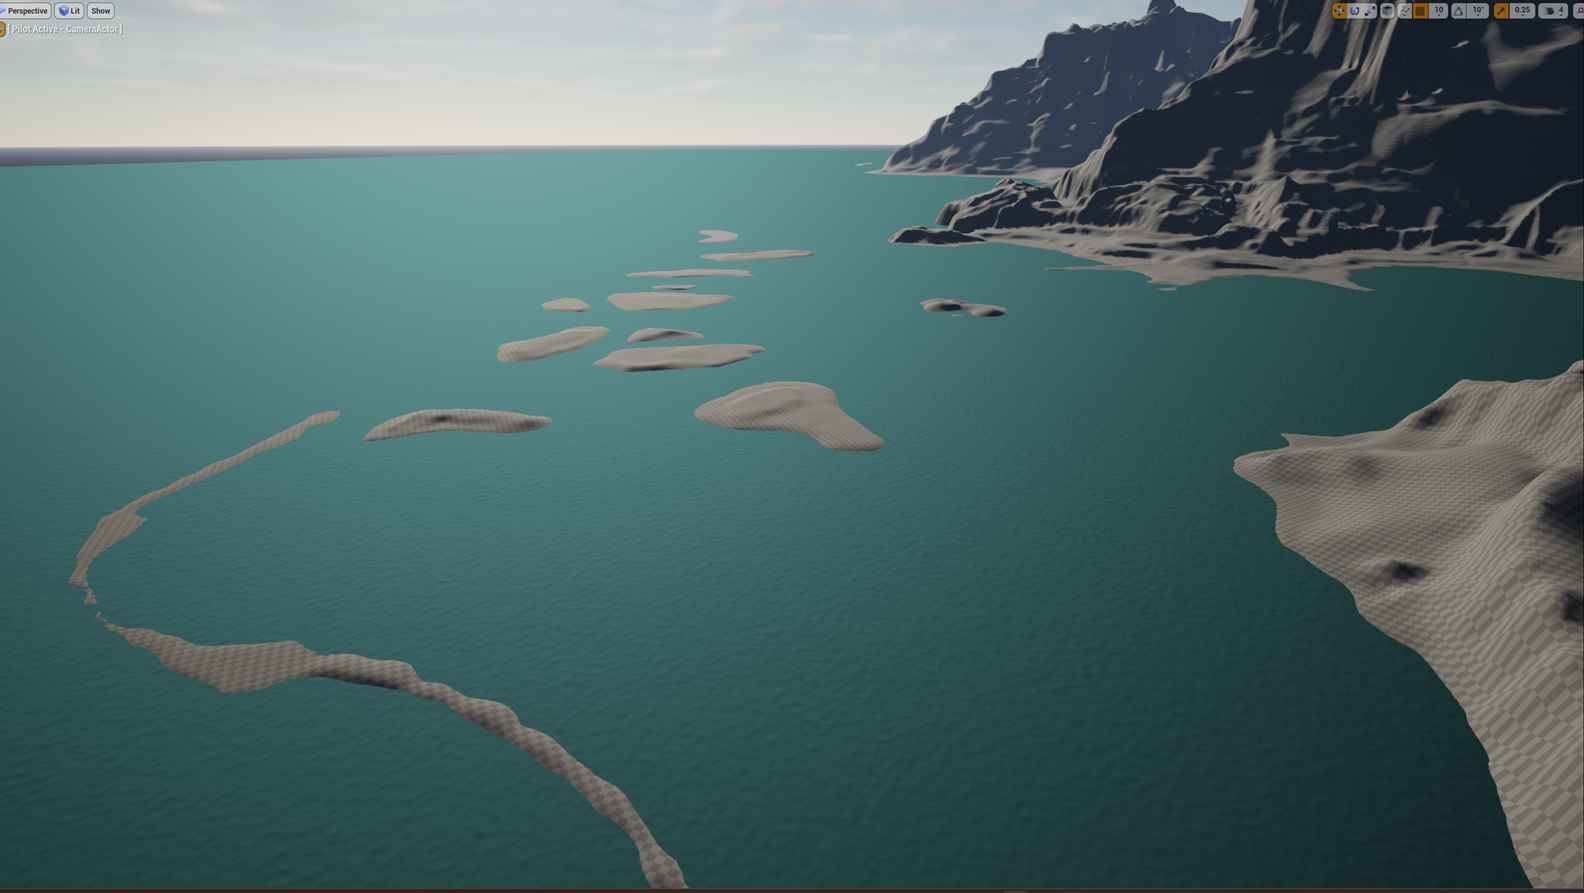
2.6.4 Add Cube Reflection
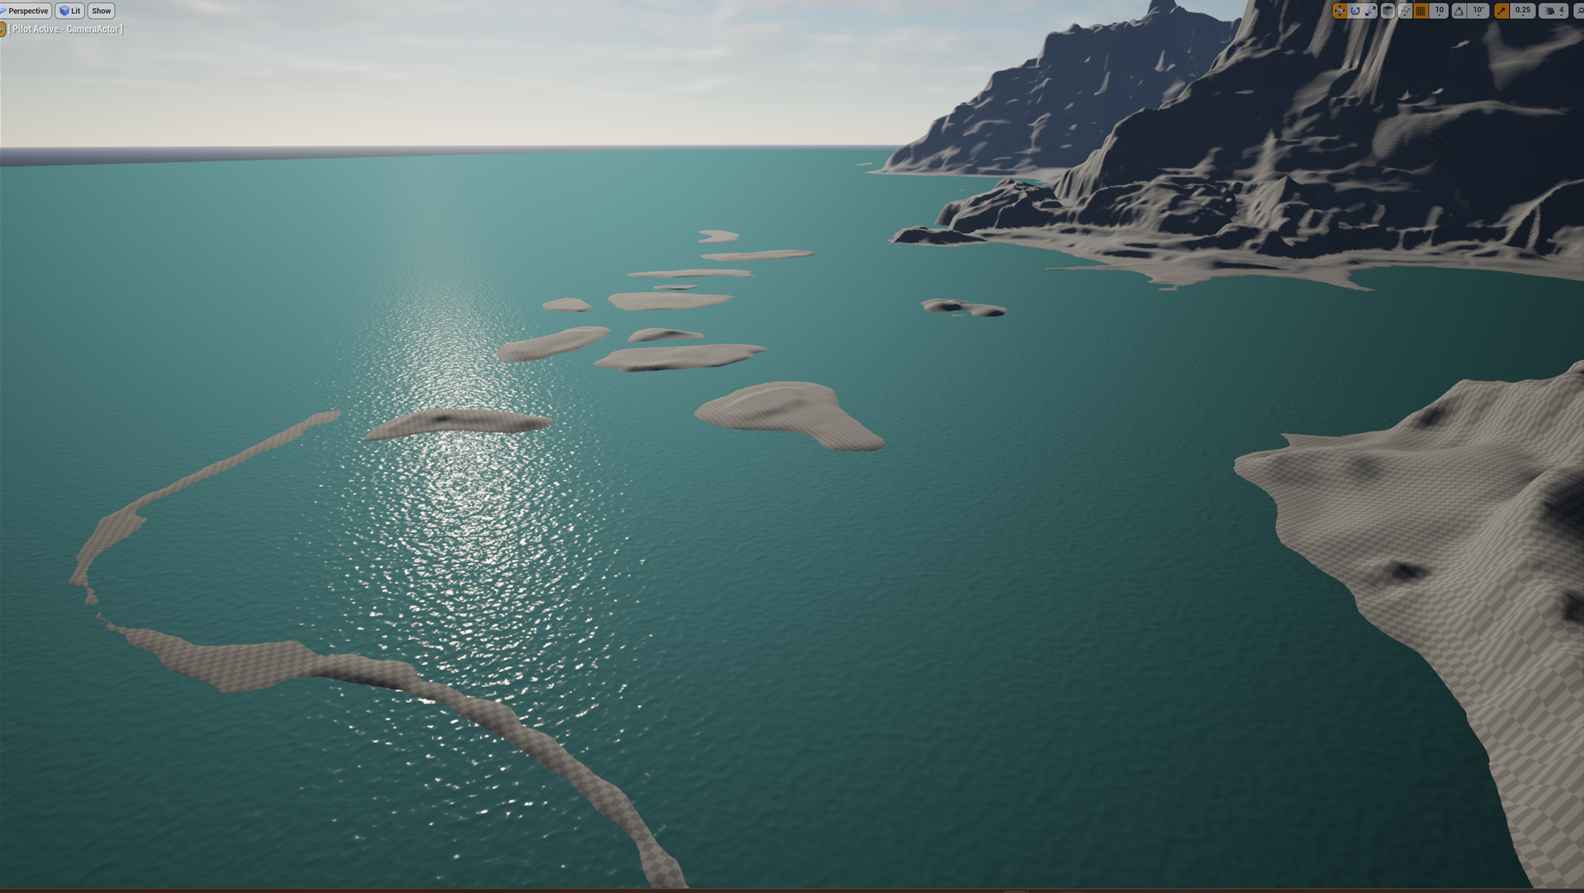
2.6.5 Add Screen Reflection
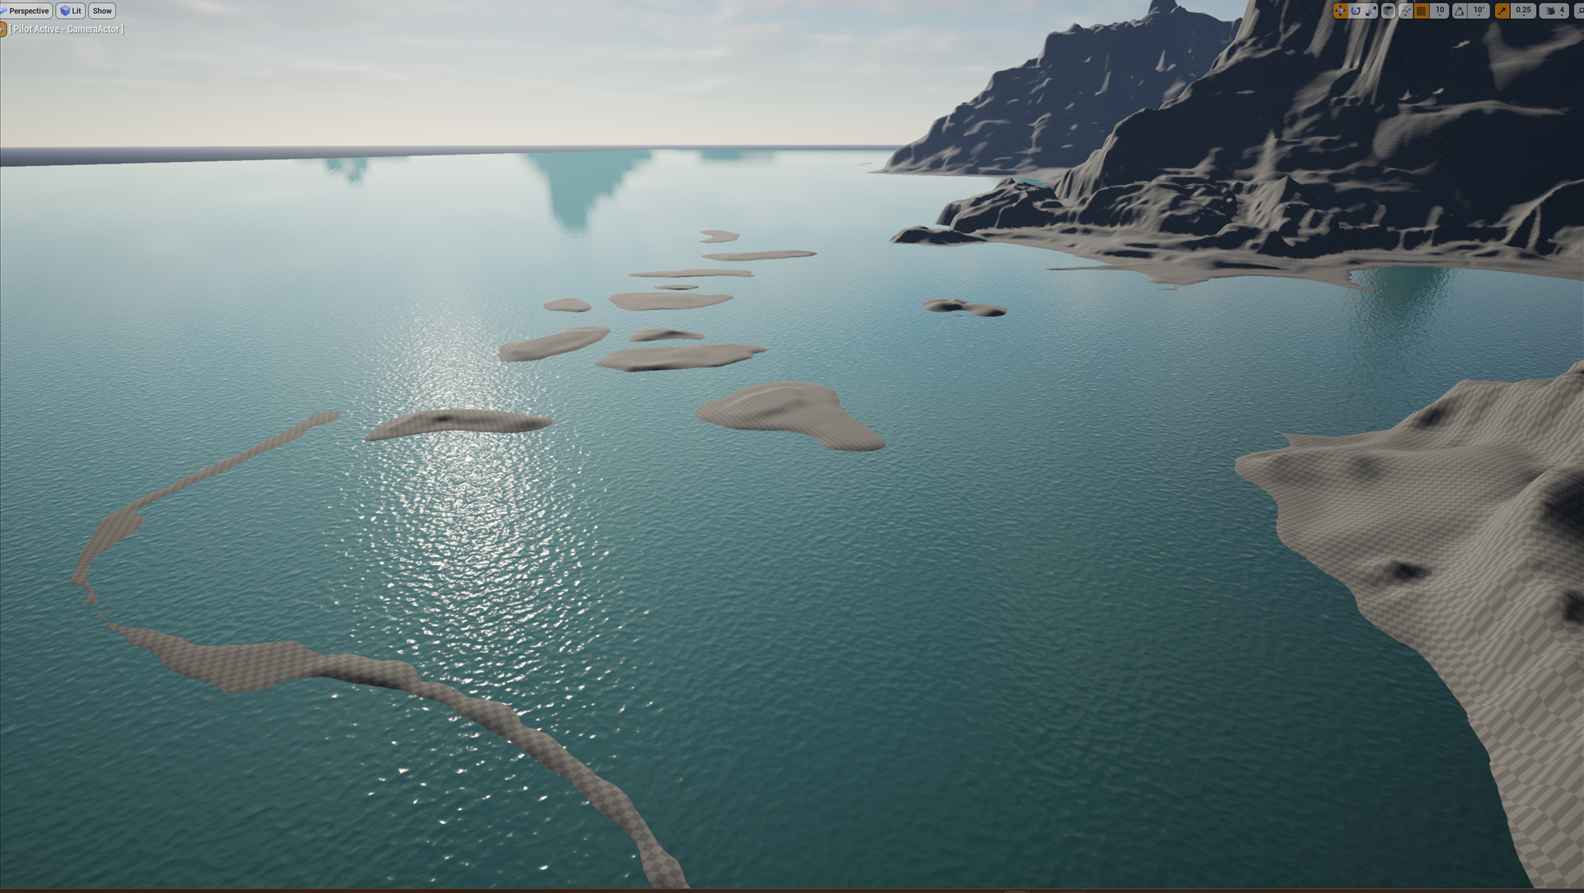
2.6.6 Add Absorption
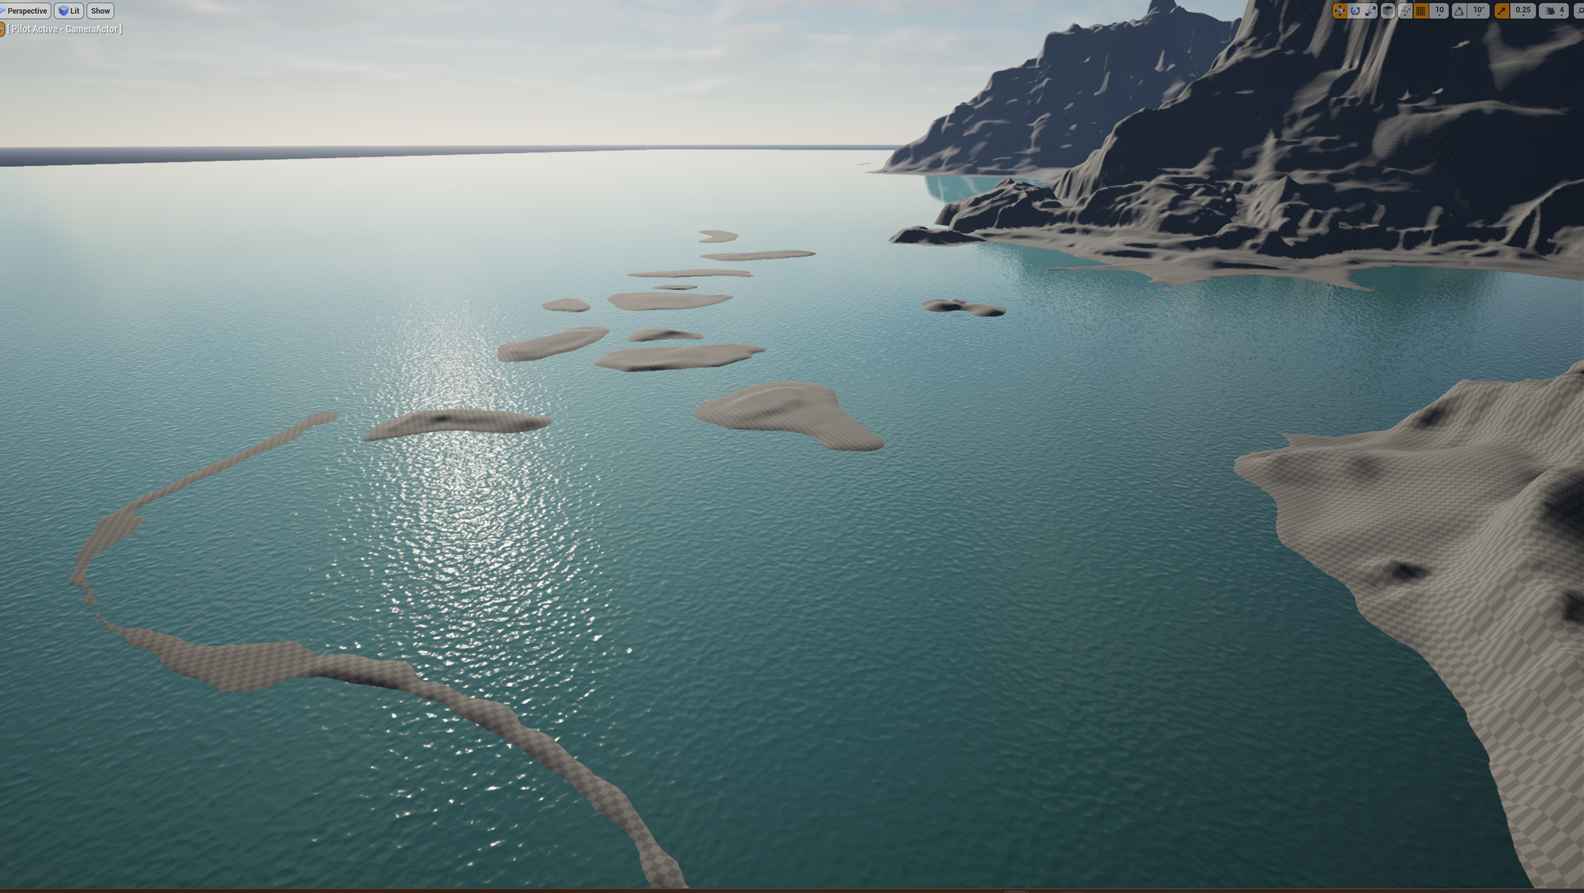
三、Under Water
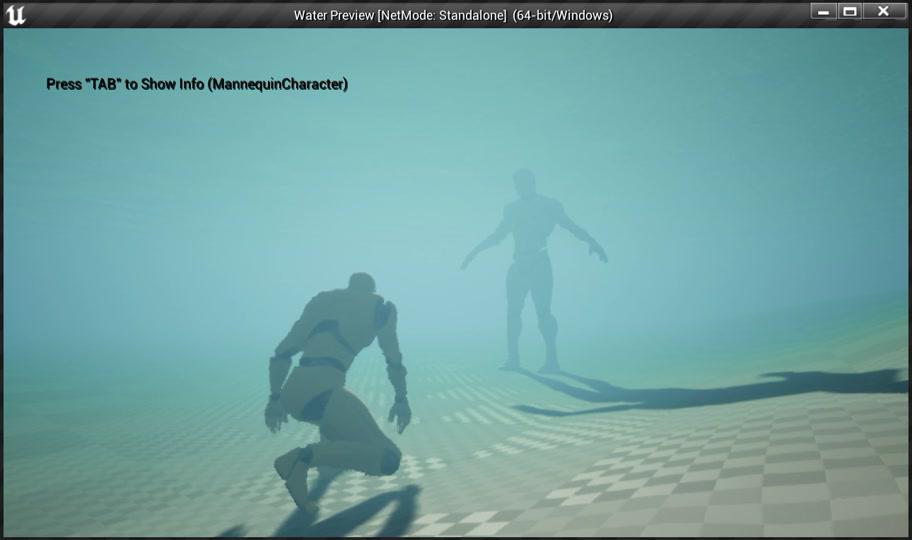
- 除了表面的水面渲染,水下也是很重要的一环。
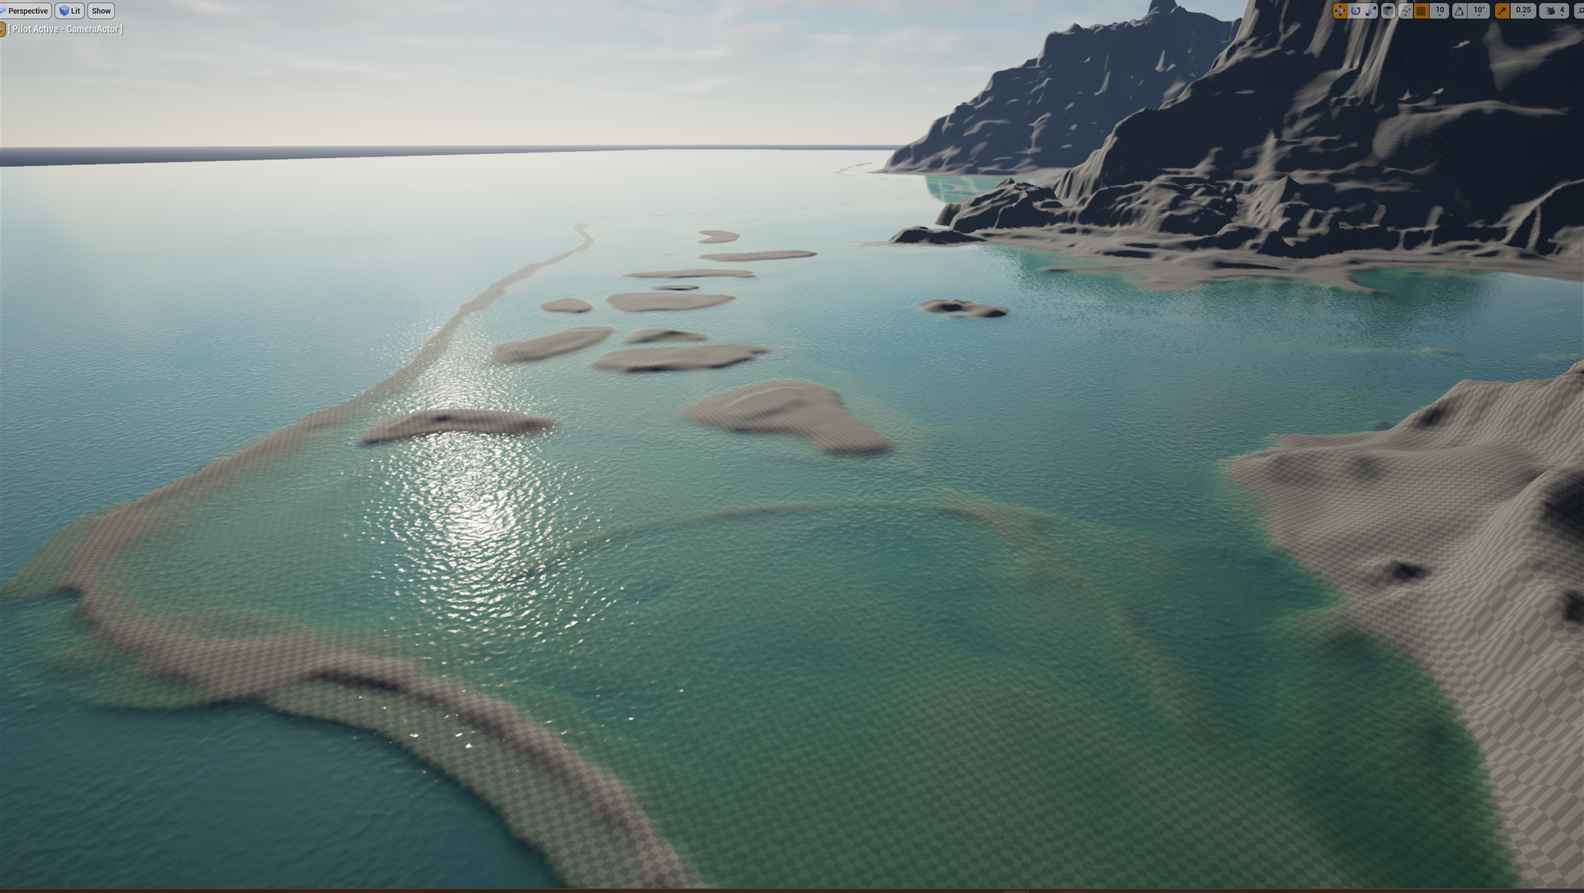
3.1 Under Haze
- 水下吸收与散射的算法与之前表面着色的算法是一样的,只是将深度差换成了场景的深度。
3.2 Cutline Effect
- 在多数游戏中,玩家的视角从水面到水下的切换通常是瞬时的,没有过渡效果。为了实现一个更为真实和无缝的水上到水下的视角切换体验,我们采用了以下技术策略:
- 逆视图投影 (Inverse Viewport Projection): 我们首先使用
InverseVP对float3(NDCUV, 10(NearClip))进行逆投影,从而获取世界空间中的位置坐标。 - 水平切割遮罩 (Horizontal Cut Mask): 通过计算得到的世界空间坐标与预设水平面的高度之间的差值,我们可以生成一个遮罩,其中上半部分的值为1,而下半部分的值为0。
- 切线遮罩 (Cutline Mask): 对上述遮罩进行绝对值运算,我们可以得到Cutline Mask。进一步应用Step函数,我们可以确定水下的区域遮罩。
- 水下视效混合 (Underwater Effect Blending): 利用得到的水下区域遮罩,我们将水下的视觉效果与水面上的场景颜色进行混合。
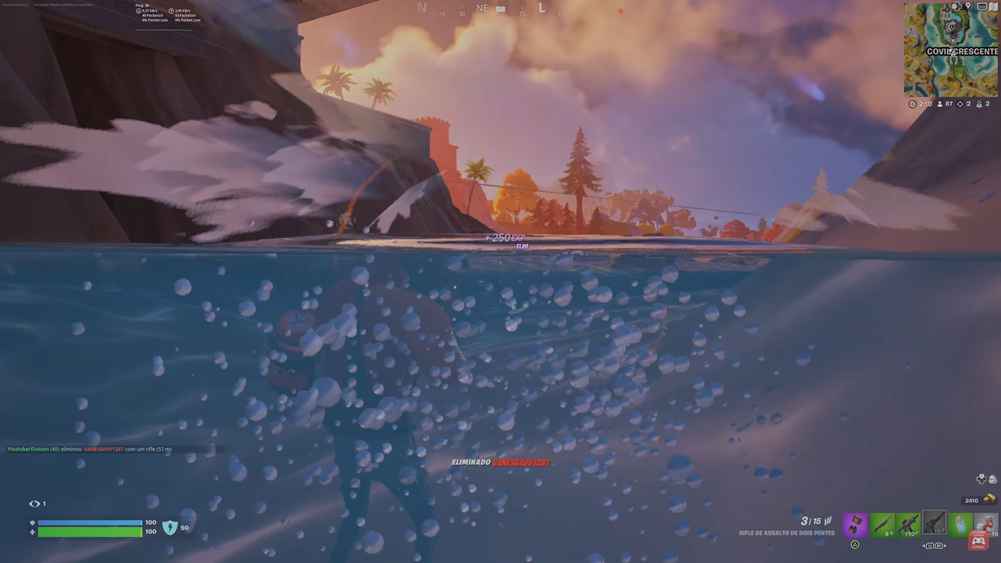
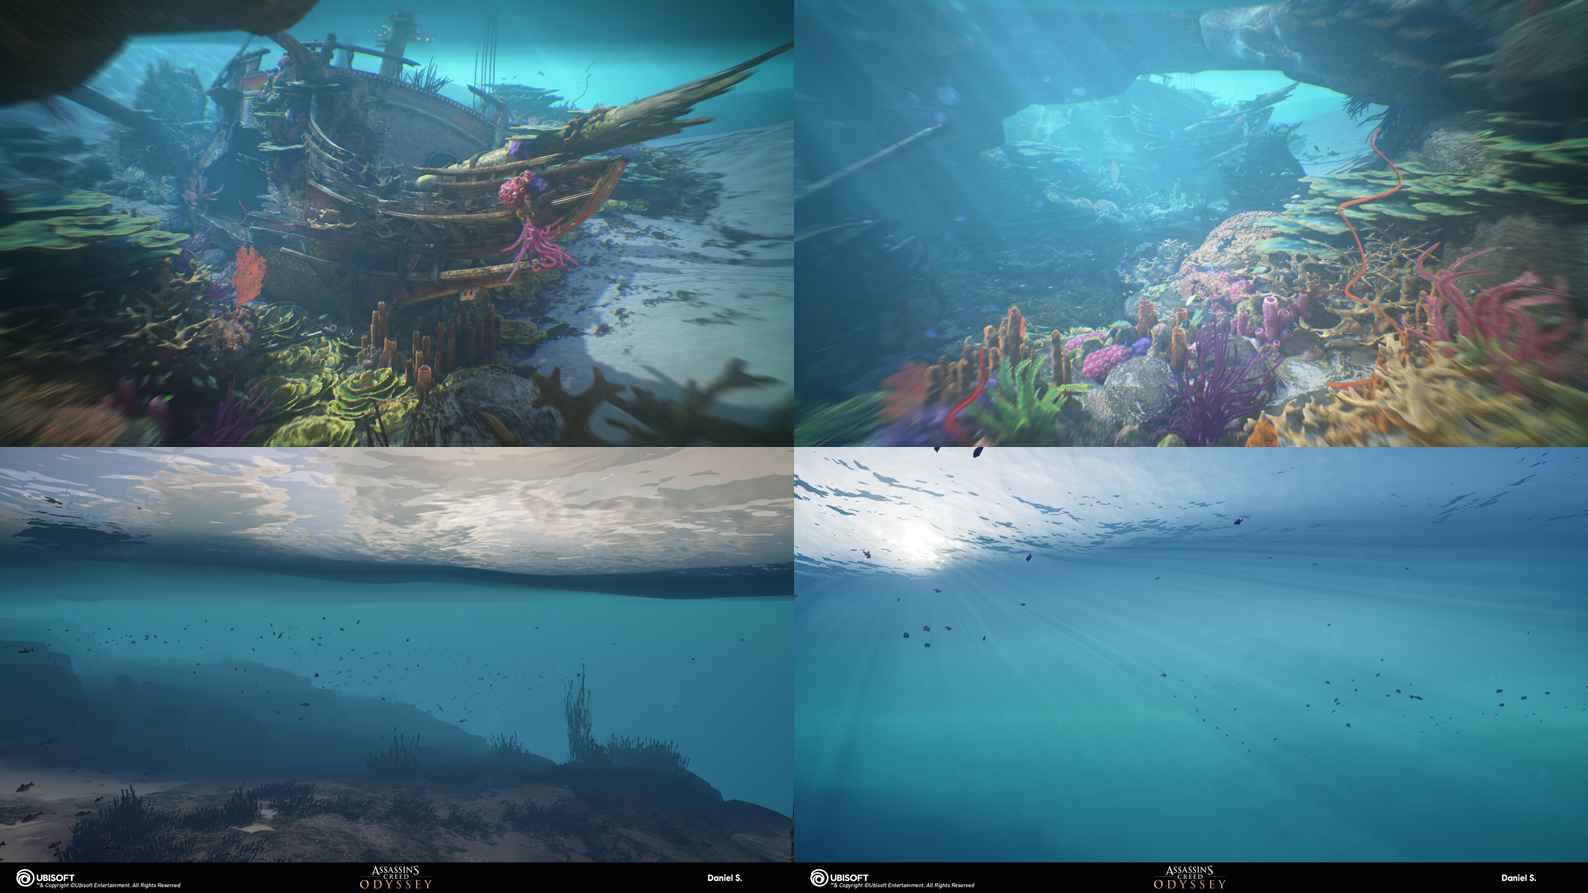
- 水面切割线过渡 (Water Surface Cutline Transition): 最后,我们叠加Cutline Mask与Cutline Color,生成一个表示水面横截面的过渡效果。
3.3 Final
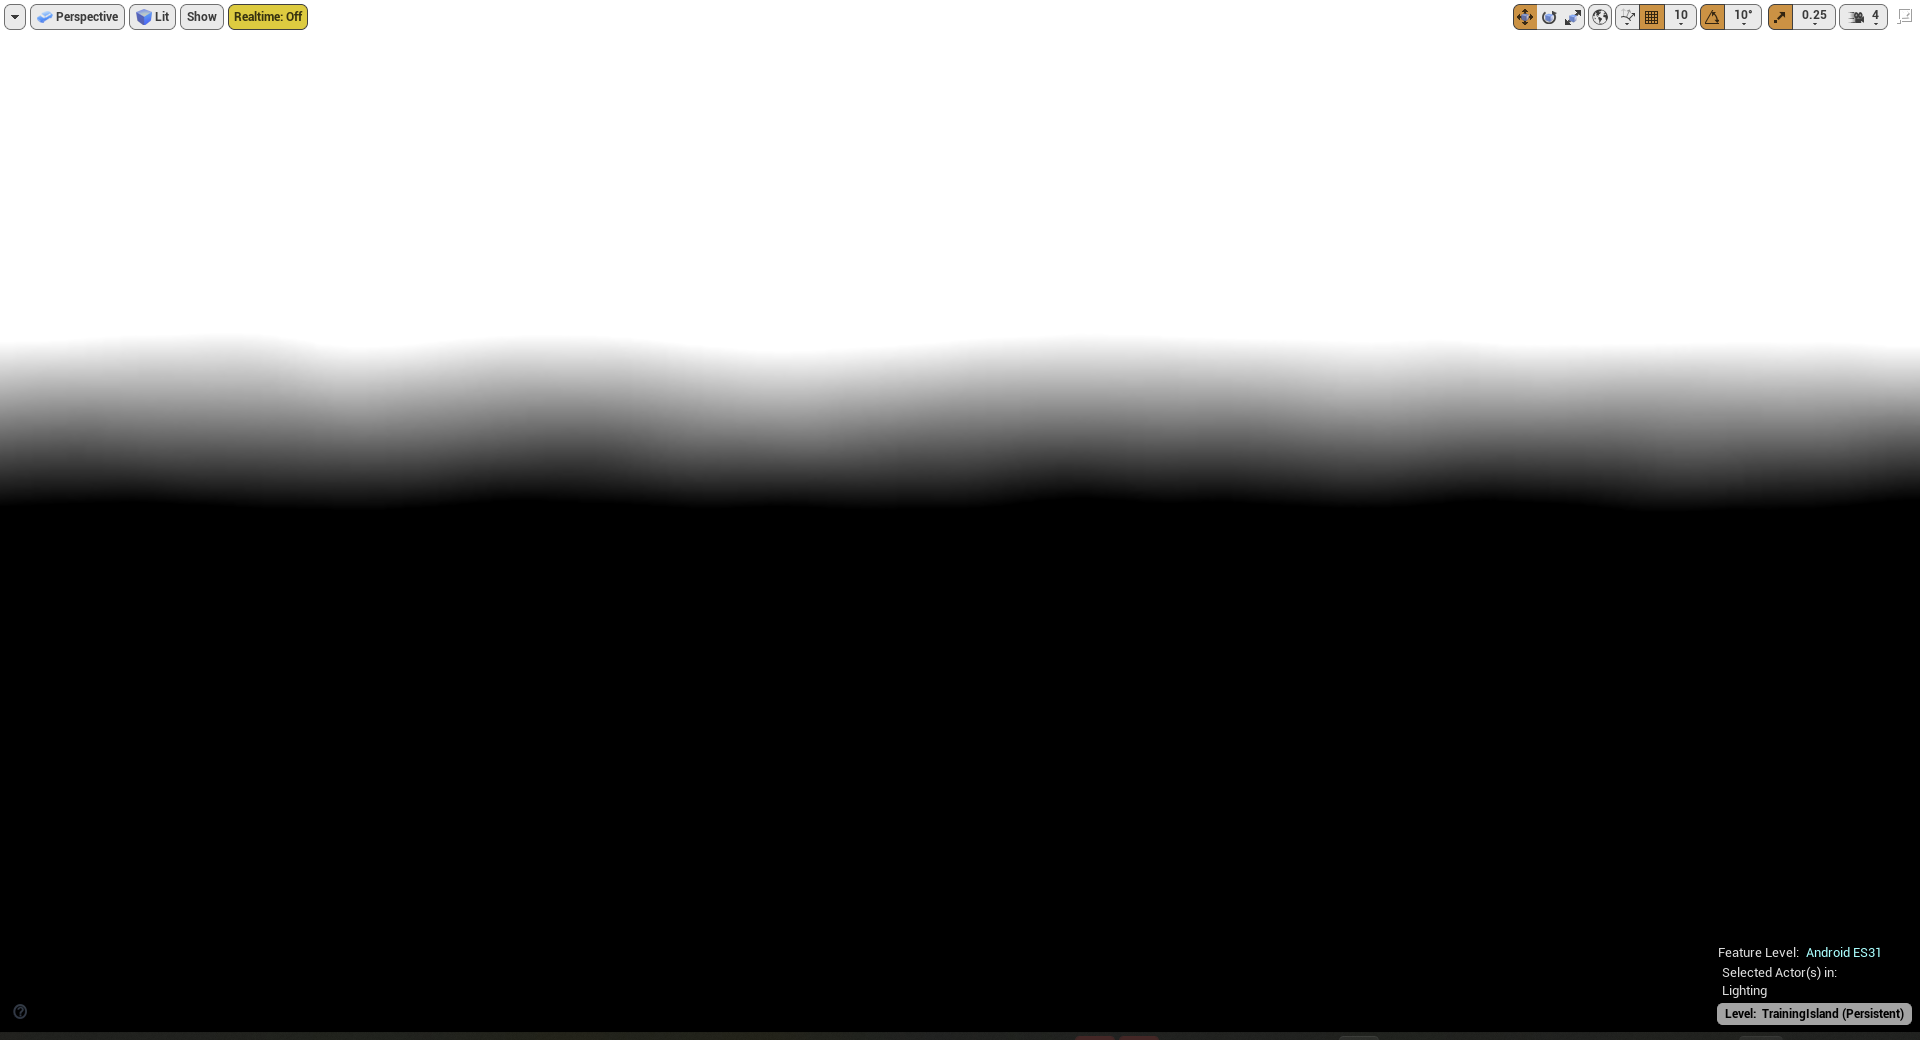
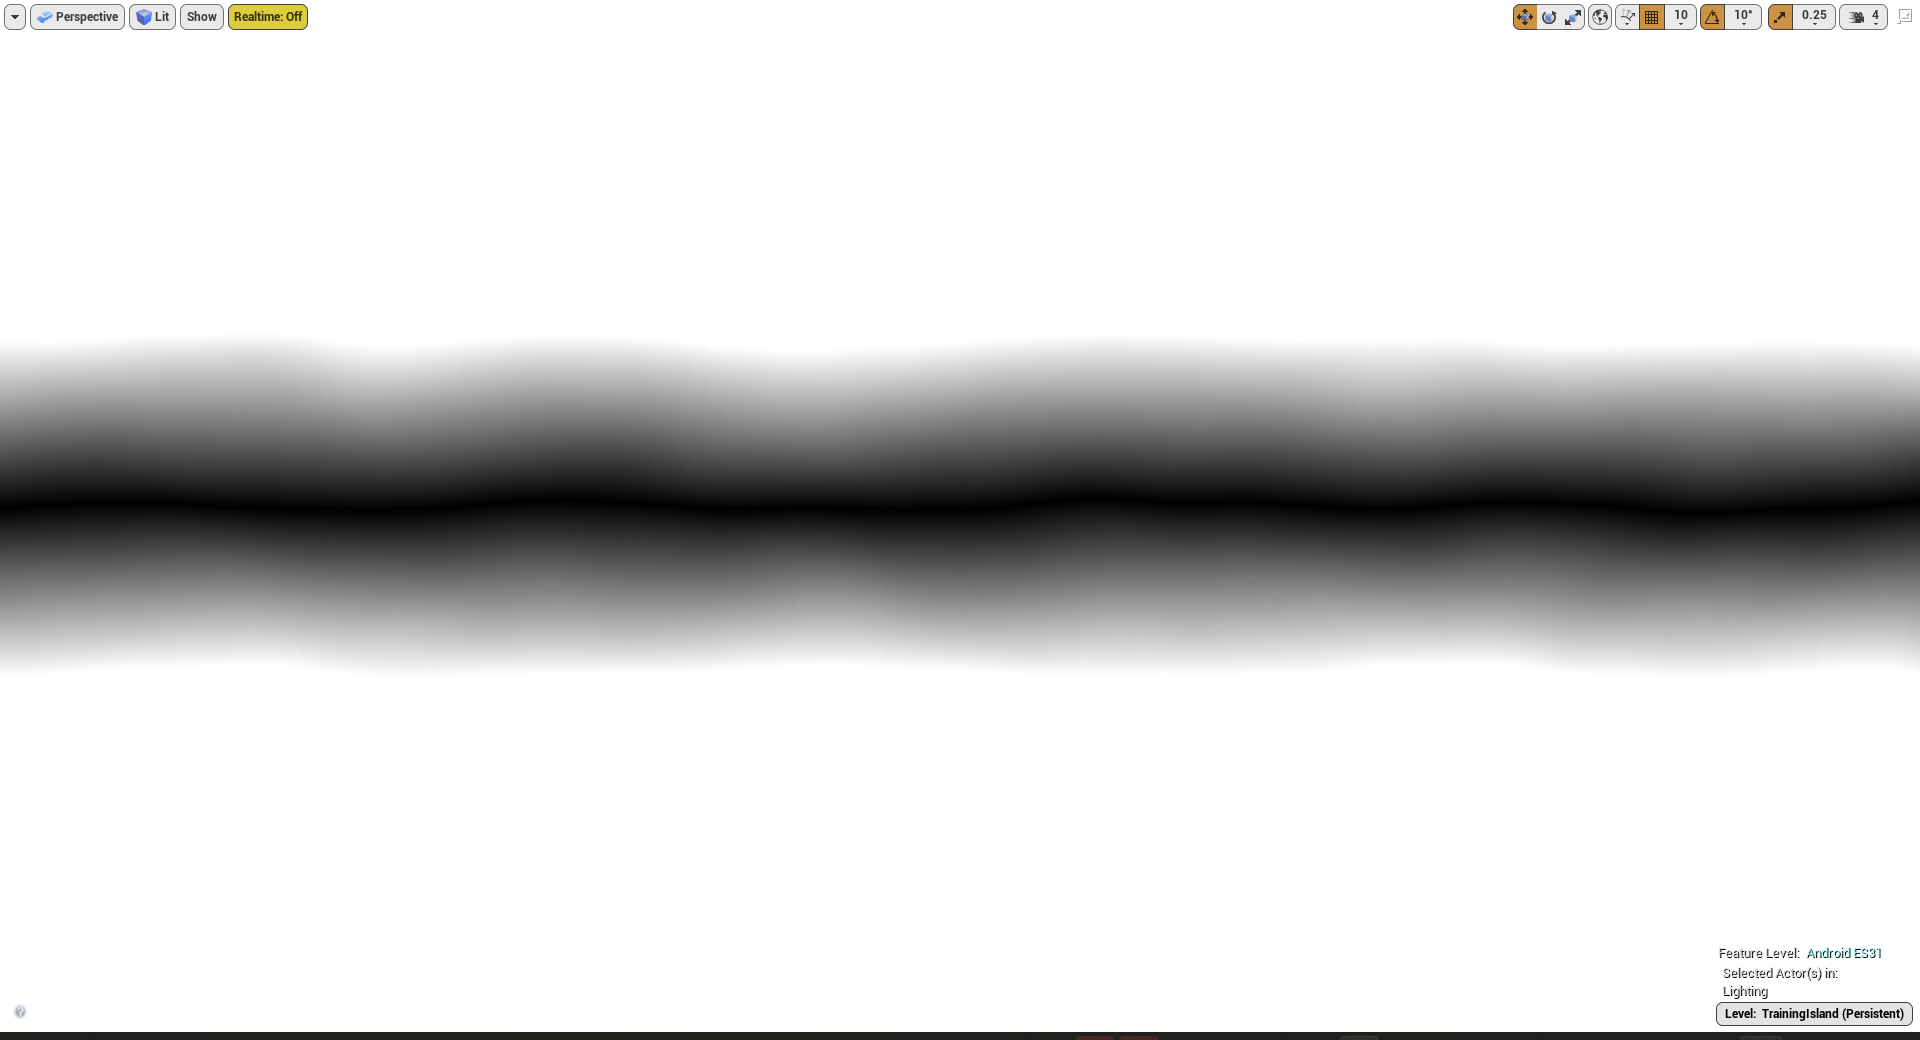
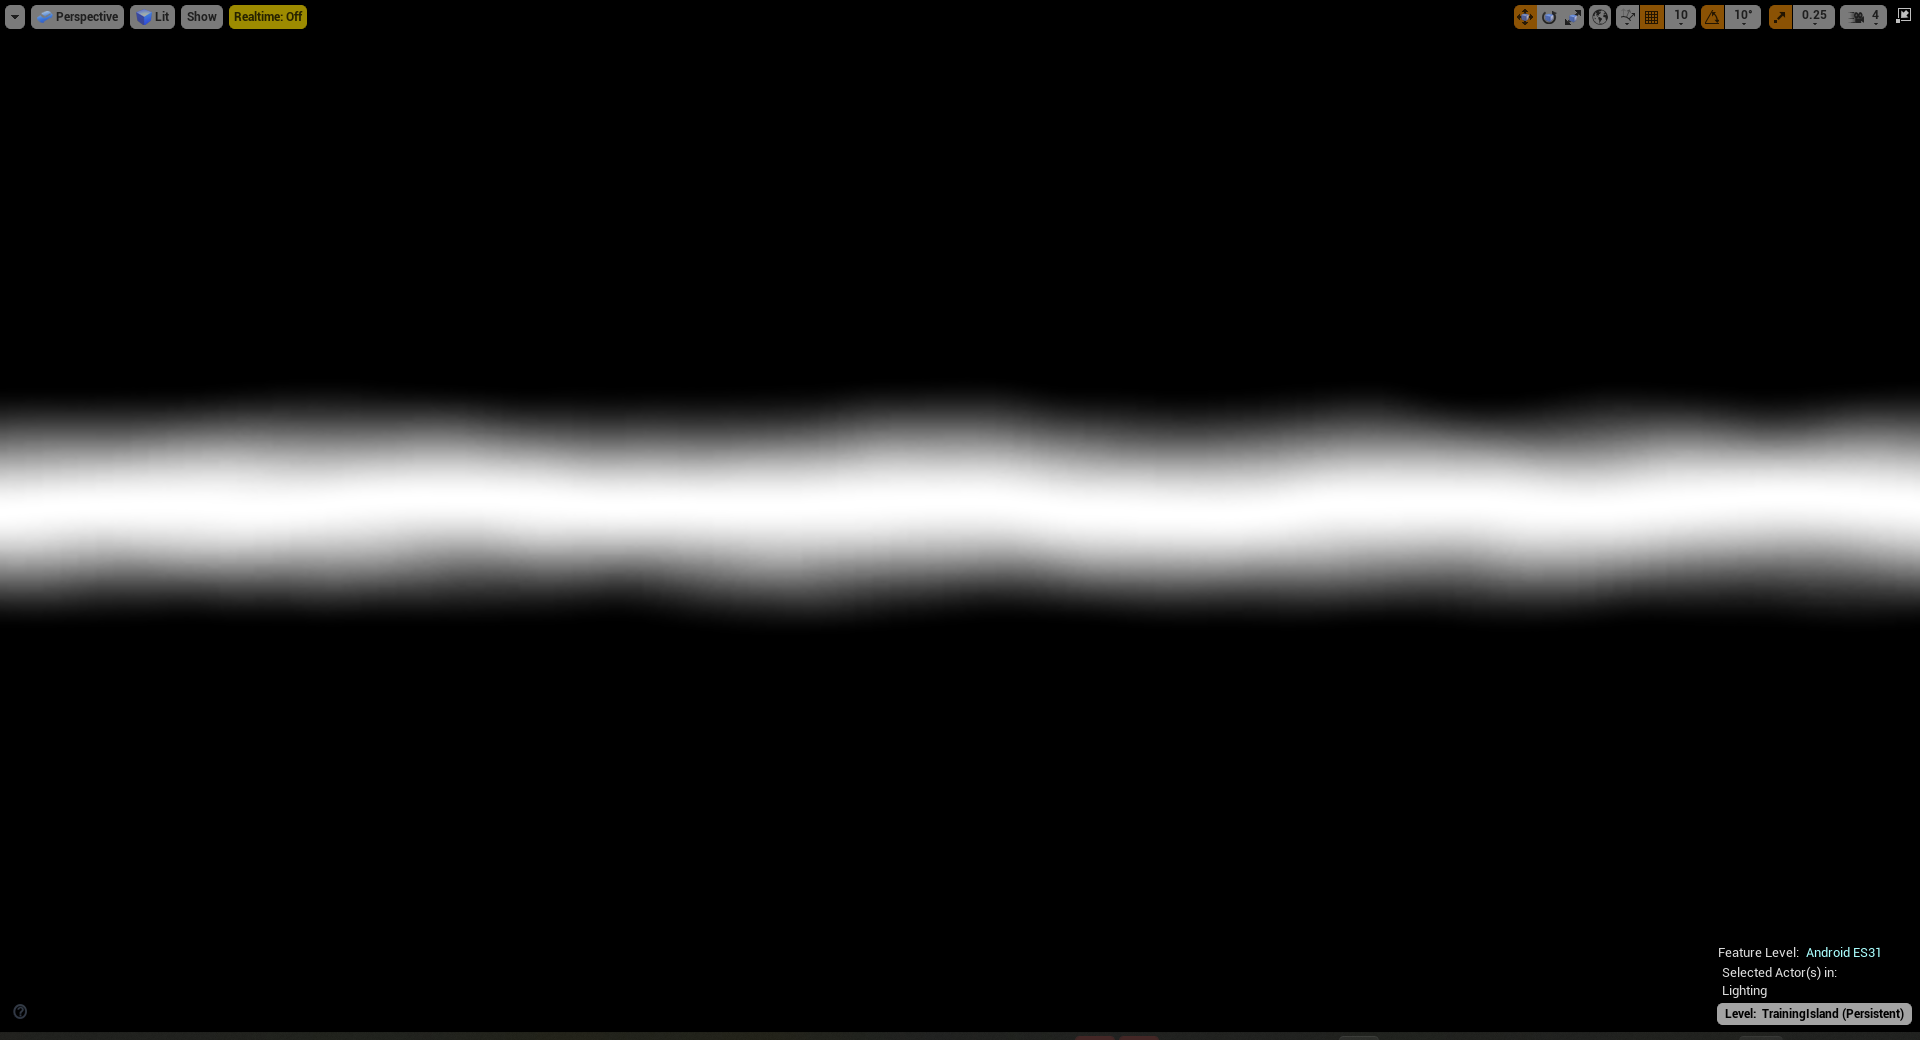
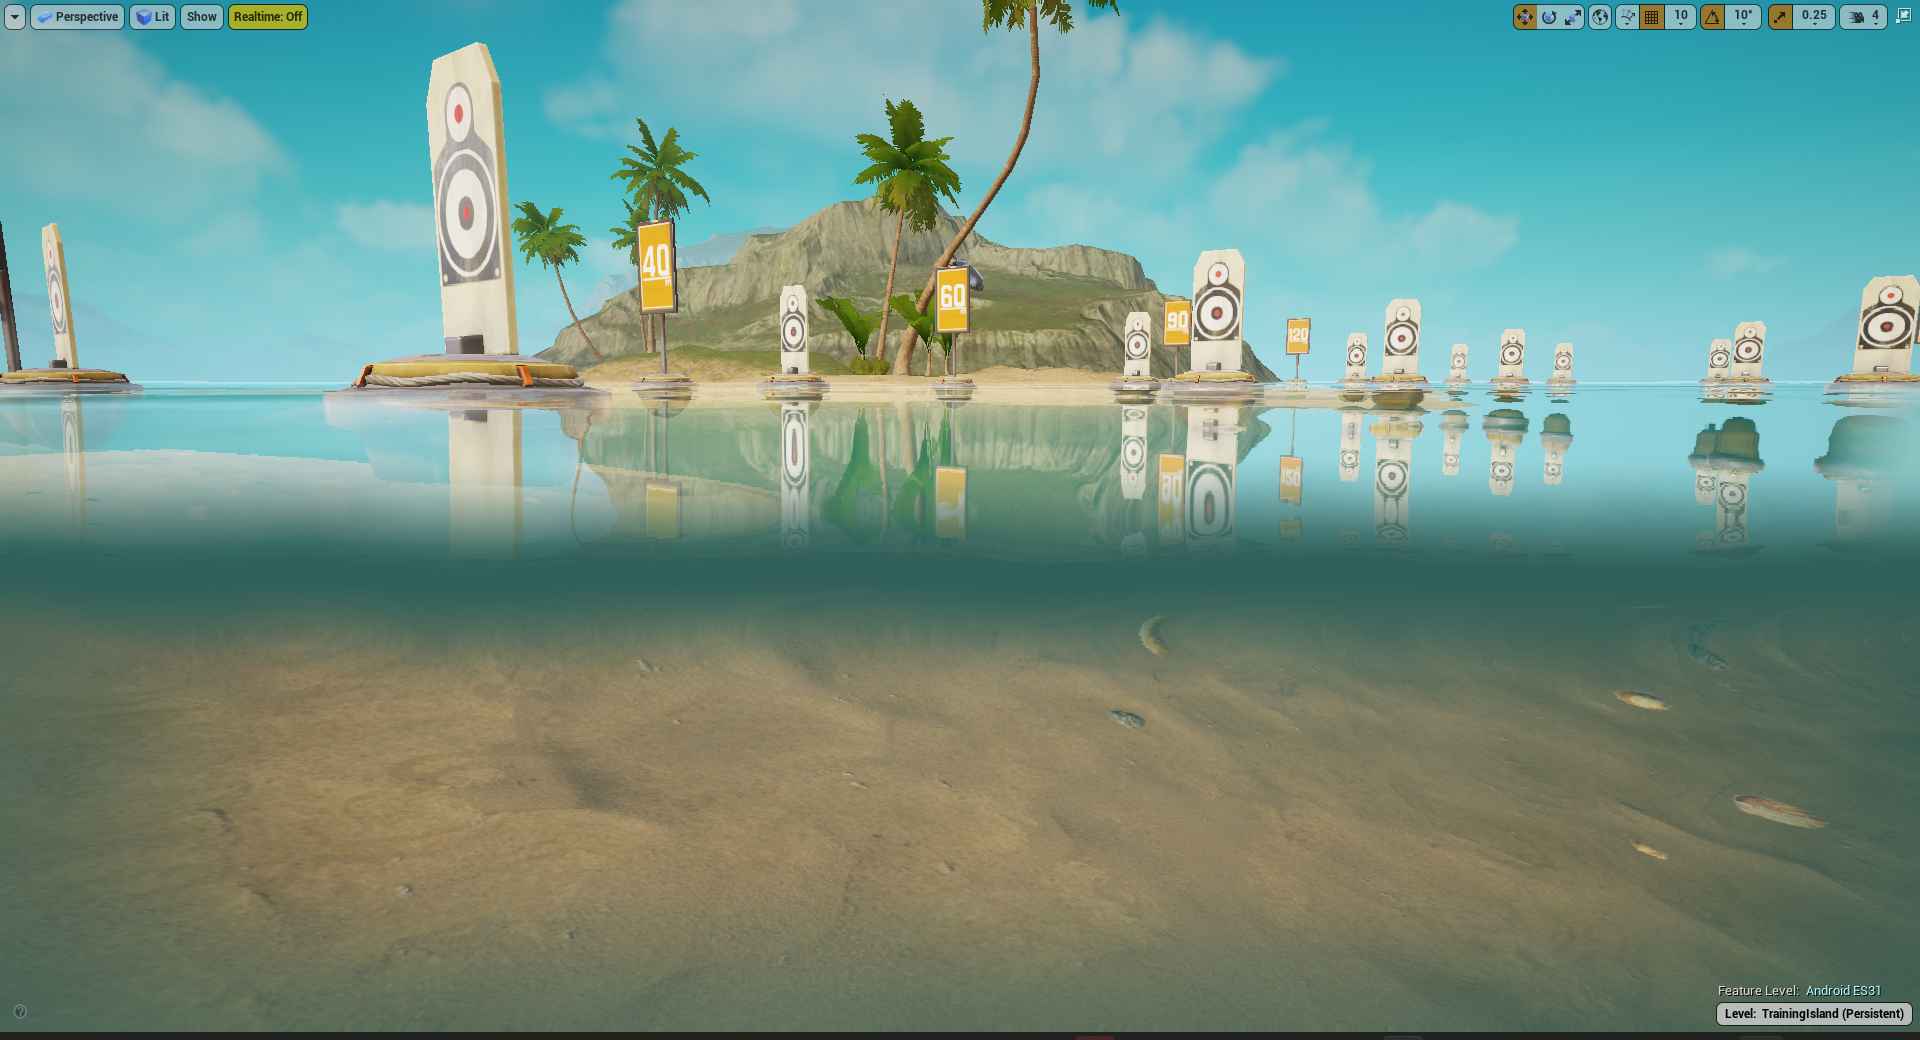
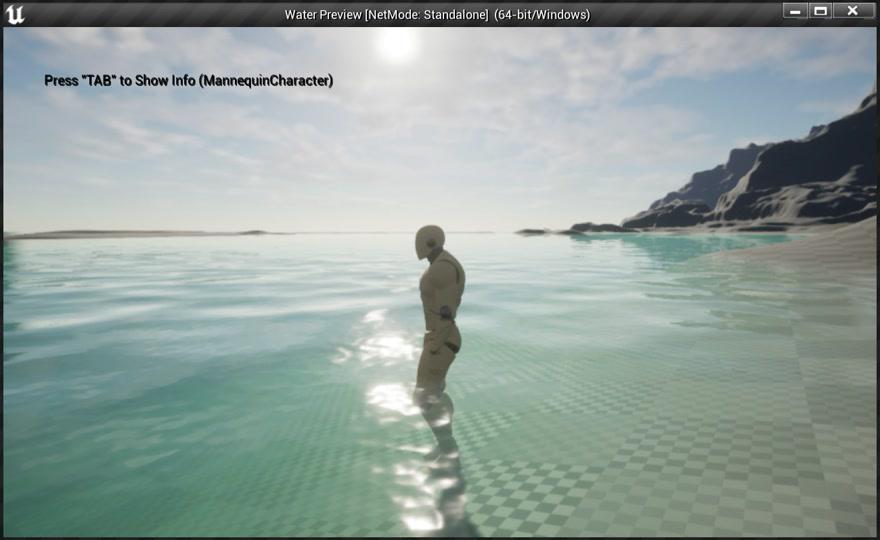
四、Optimization
- 本优化策略可以分为两个核心层次。首先,我们有着色器层的优化,这一层主要集中在Register、IO以及Instruction的优化上。其次,是管线层的优化,这更多地关注于与硬件宏观特性的兼容性,例如Framebuffer Fetch和On-Chip MSAA Resolve等功能。
4.1 Shader Level
4.1.1 Common
- GPU是一种非常适合并行计算的硬件,其本身有相当多的物理线程,但它的调度粒度并不是一个一个线程的模式,而是一组一组线程的模式,比如32个线程一组或者64个线程一组 :
Occupancy :
- 每组每个线程的指令执行是顺序且相同的,当一个组因为贴图采样等访问内存导致Stalled后,隐藏延迟的主要方法就是切换到其他没有Stall的组执行。所以衡量一个Draw/Dispatch中的Active Group的指标,可以表示硬件是否被充分利用,这个指标就是Occupancy。
- 每个线程使用的Register数量是计算Occupancy的关键因素。例如在某个GPU上,每个Group有65536个32位Register,最多可以有2048个线程驻留。在这样的硬件中,如果想要占用率为100%,每个线程最多就只能使用32个Register(65536÷2048=32)。
- 但需要注意一味的提高这个指标并不是永远都有效的,如果当前Program的瓶颈不在于计算,而在于显存的访存上(Sampler/BufferLoad),那么即便拉满占用率也会因为访存导致的Stall而整体等待。好在本文的Water的瓶颈更多的是在计算而非访存上。
4.1.2 ISA Level
- 通过Metal Debug观测,Register有接近200个的占用,这直接导致了Occupancy只有百分之35的占用,Apple8系列的GPU每SP最大可以并行24个线程,也就是说只能支撑9个线程并行运行。最终因为并行效率的低下,导致消耗了1.59ms才完成Water的渲染。
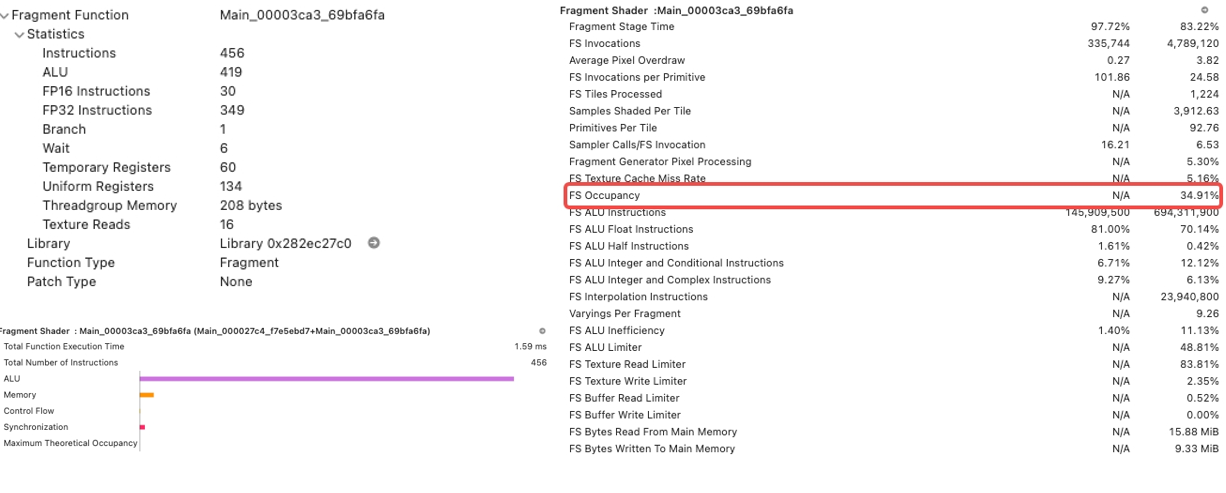
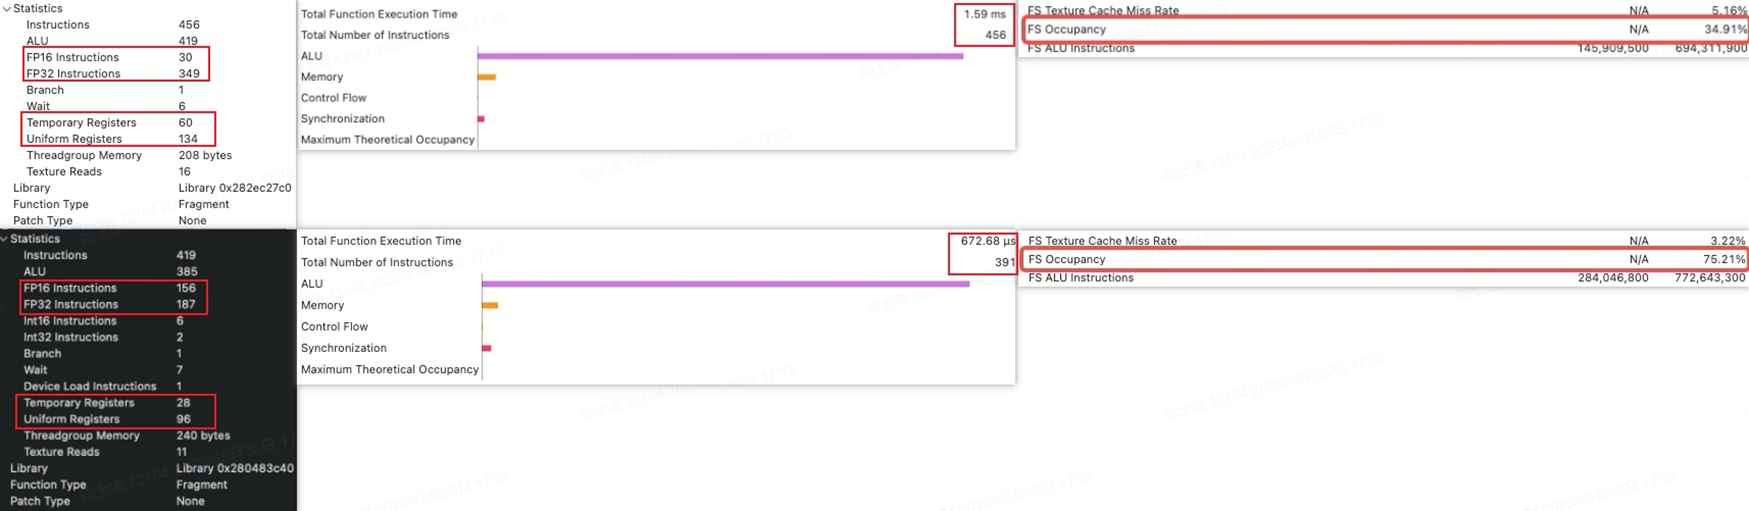
- 移动GPU的一个显著硬件特性是拥有2倍于FP32的FP16管线,因此使用半精度不仅有助于缓解Register压力,还可以加速Shader中算法的计算。相对地,有些现代的GPU可能没有专门的FP16计算单元(Apple8|RDNA|Nvidia),但支持整合或拆分FP32来减轻Register负担以提高利用率。
a. 结合这些特性,对Shader代码进行优化。
- 减少一些重复的纹理采样操作,这是Shader开发中经常遇到的特别是在连连看中。
- 将不太依赖高精度的计算转移到FP16上,以此减少局部变量对寄存器空间的需求。
- 合并计算指令,如将散射与吸收的exp操作合并,使用一个float4来执行,从而节省了一次exp的计算时间(但需要注意这并不适用于任何情况,新的GPU都是超标量设计,老GPU的执行模型是SIMD矢量模式,即XYZW或RGBA四个不同的数据一起执行同一个指令)。
b. 经过这些优化后,结果非常显著:Occupancy、Register,Texture I/O的能力都提升了近2倍,驱使帧率也实现了2倍的提升。
上半部分为优化前,下半部分为优化后
4.1.3 Quality Level
- 除了在Shader ISA层面上的优化,我们还可以根据不同的硬件性能设定多个质量等级,以进一步提高各种设备上的性能。例如 :
- 最高画质设置可以提供水面的折射、散射和吸收效果。
- 而在高画质设置中,我们将取消折射效果,这样会失去扭曲的现象。
- 降到中画质时,吸收效果也会被移除,只保留半透明效果,且会去掉细节法线。
- 而在低画质设置中,连半透明也会被去掉,确保在性能有限的设备上也能流畅运行。
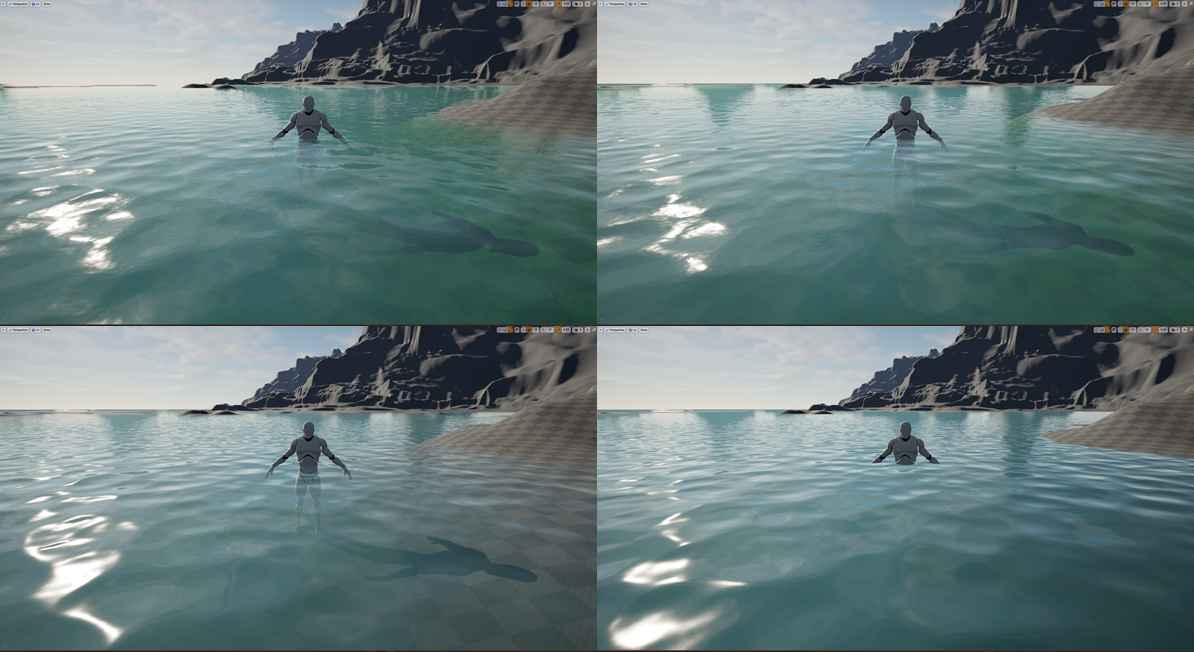
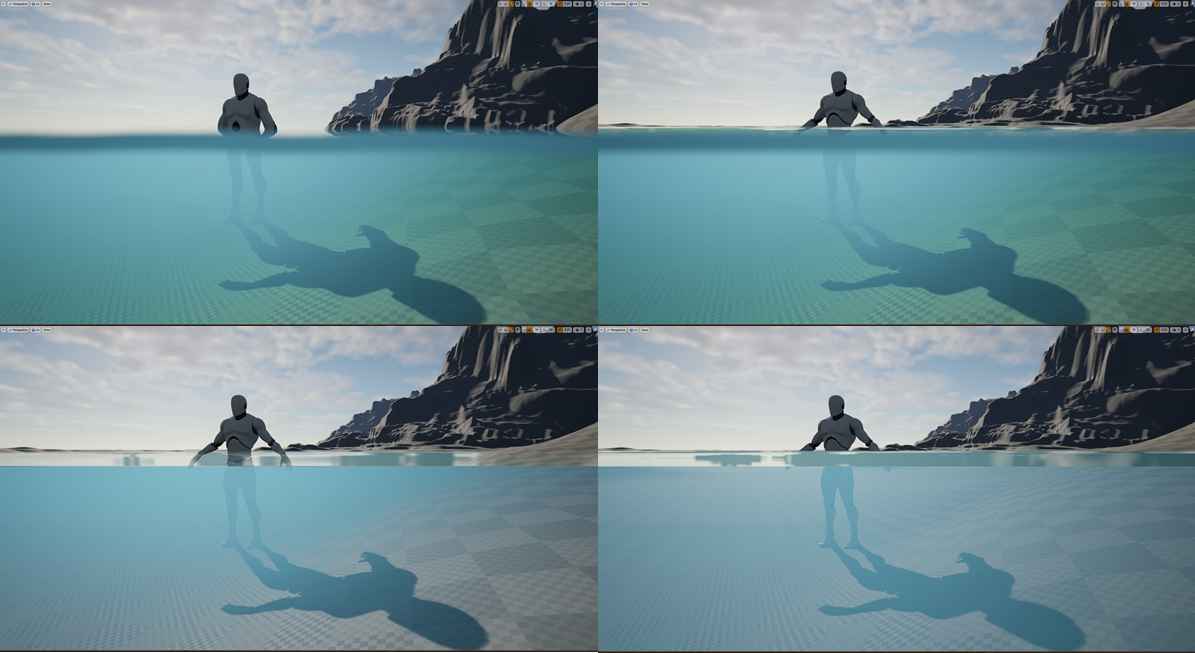
水面折射与边缘颜色与表面高光的细节变化 / 横截面的折射与水下雾的变化
4.2 Pipeline Level
4.2.1 Blending/DepthFade
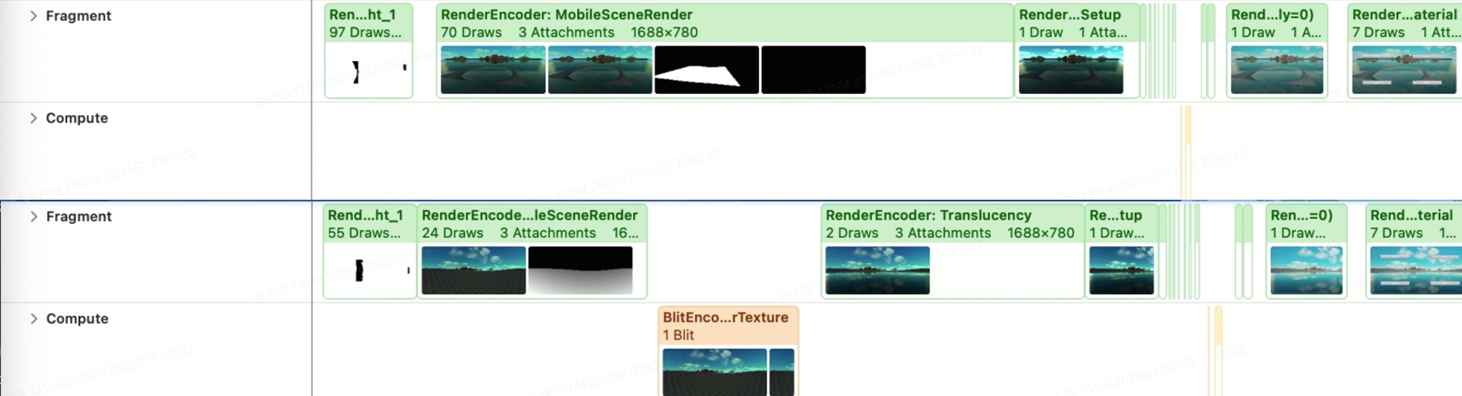
- 传统渲染流程中,OpaquePass与TranslucencyPass之间的颜色读取需要特别的处理。
a. 首先,OpaquePass结束后,为了将图形管线的结果保存,必须执行EndPass驱动GPU的ROBUnit将颜色与深度结果存储到内存中的RenderTexture里。
b. 由于RenderTarget不能在同一时间进行读写操作,这就需要创建一个临时的RenderTexture。并将之前存储的结果复制到这个临时RenderTexture上。
c. 在下一个BeginPass即TranslucencyPass中,供读取背景Color/Depth。但此时,因为是新的BeginPass,RenderTarget需要重新Load,这会引发大量的IO带宽消耗。
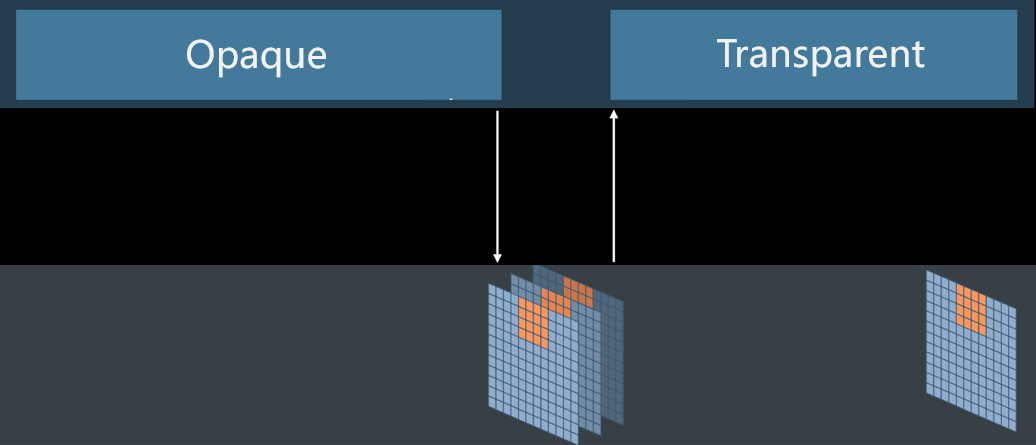
- 而在移动端上,得益于TBDR架构的独特性,我们可以直接在L1Cache上存储这些中间数据,从而避免因重复开始/结束RenderPass导致的带宽开销。为了在PixelShader中读取OnChip的内容,需要开启特定的扩展(有一定设备等级要求)。
a. 在OpenGL ES中,通过FramebufferFetch来实现。
b. 在Vulkan中,则是通过Subpass Fetch来实现。
c. 在Metal中,使用Programmable Blending来实现。
-
因为数据访存都在OnChip Memory上,临时的RenderTexture就可以是Memoryless的,这样它在显存上就不会开辟真正的空间,只是一个资源的Handle。
-
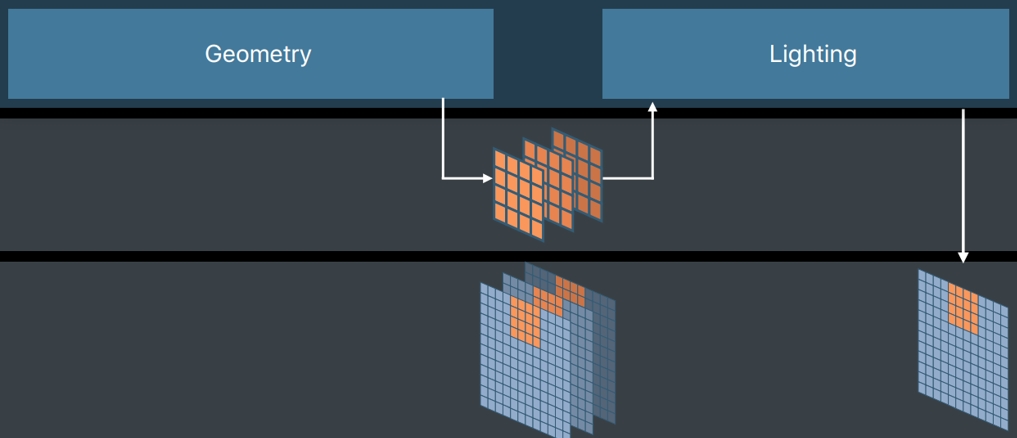
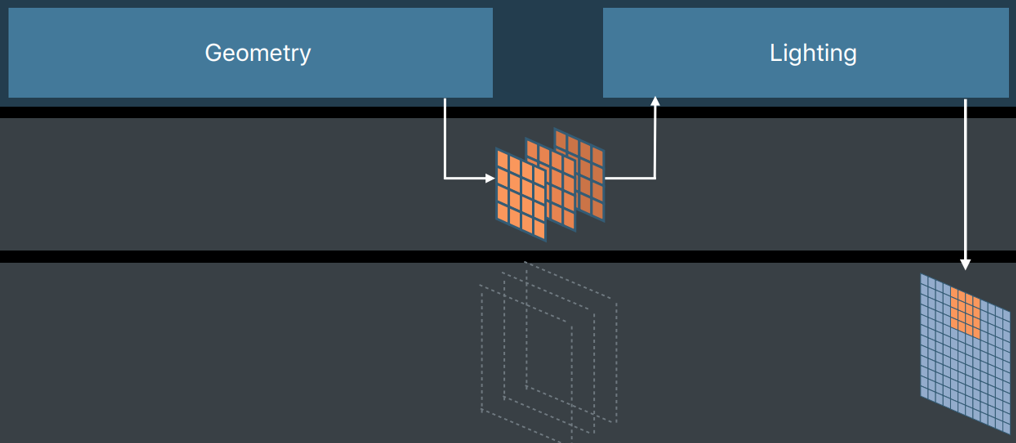
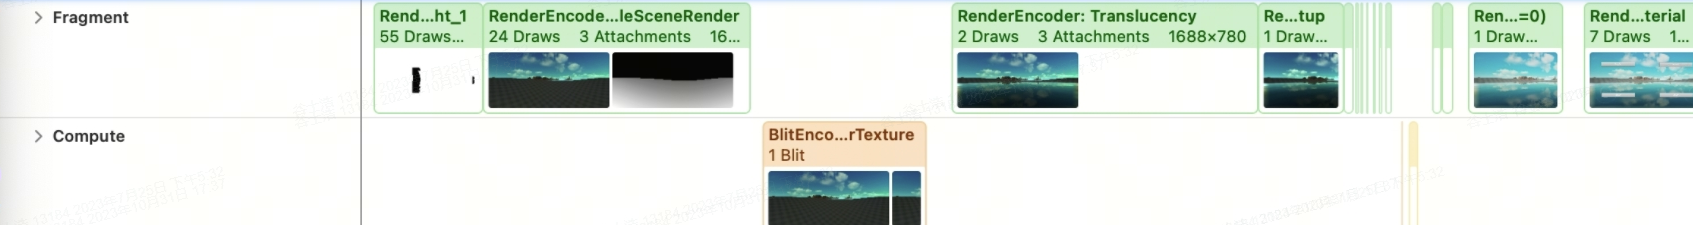
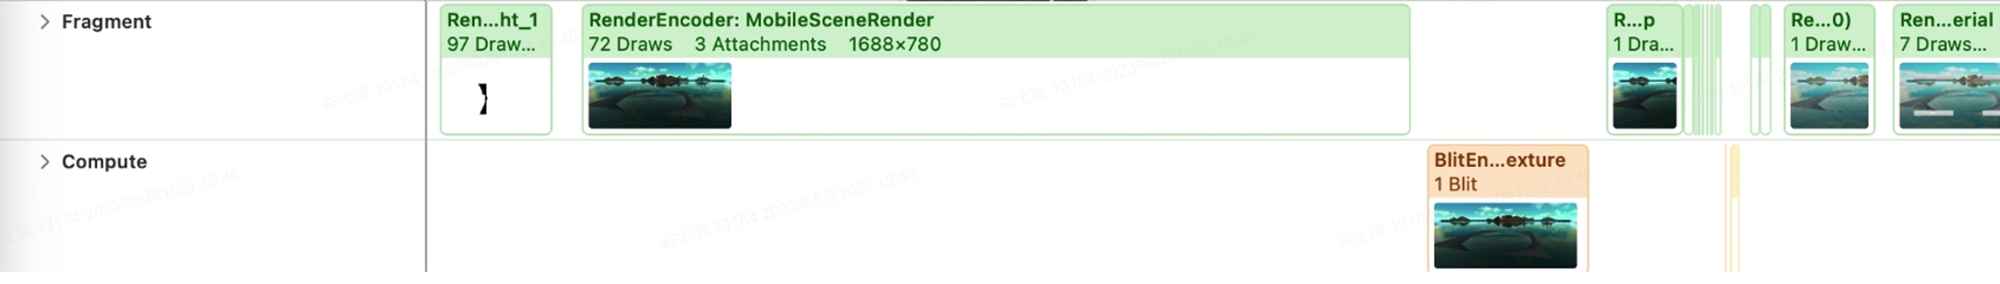
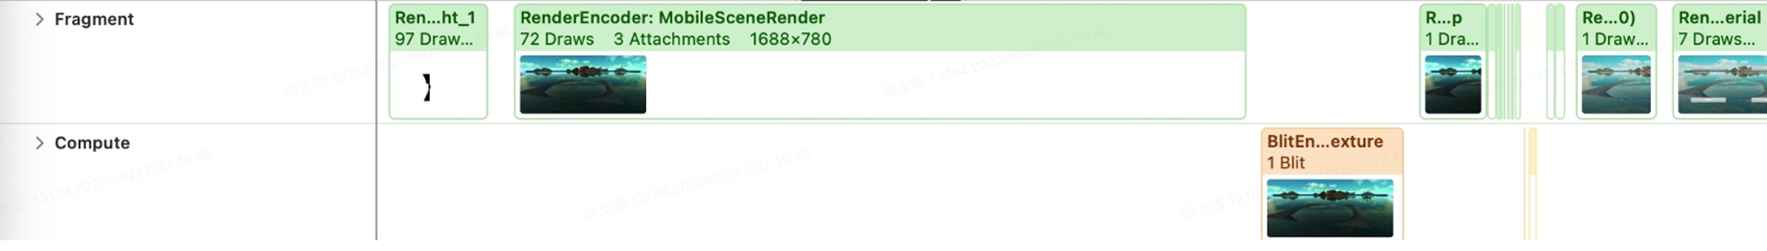
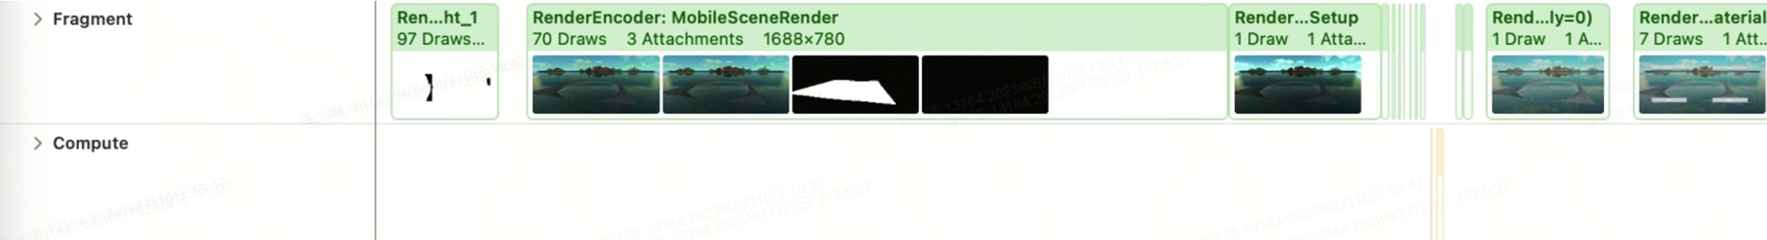
最终,通过Metal Profiler可以看到整个Graphics Pipeline因为OnChip相关的优化实现了无阻断的执行,Opaque与Translucency两个Pass之间依然保持着One Pass的特性。极大的缓解移动端因为频繁IO带来的内存带宽延迟与发热。
上图为优化后,下图为优化前,保持OnePass特性不被Blit打断 :
上图为优化后,下图为优化前,可以看到前面一段带宽使用起伏低很多
4.2.2 Reflection/Refraction
- 在最高画质设置下,水面需要表现出折射和反射的效果。这两种效果的特性都不是基于像素的点对点数据,而是需要跨越屏幕Tile来访问全局内存的背景颜色。因此,OnChip的优化策略对于这类视觉效果并不适用。这里将这个中间数据从之前的Opaque与Translucency之间放到FrameEnd,这样便能保持One Pass特性又能得到跨Tile采样的效果,代价是下一帧计算的时候需要多花费些时间去重投影上一帧的颜色到当前帧位置。
放在中间会打断One Pass / 放在帧尾保持One Pass
- 在MSAA模式下,这个操作可以被进一步优化为无额外成本。直接使用临时的RenderTexture作为TranslucencyPass的ResolveTarget,并借助ROB Unit将OnChip的MSAA结果输出到ResolveTarget。与非MSAA模式相比,此策略还能避免一次Blit拷贝操作,从而节省CopyIO带来的额外带宽。
非MSAA,需要先Store再Copy / MSAA下,直接Resolve到Temp RT
五、Integrated

- 最终在Farlight 84中集成后的效果,依次是训练关卡,死斗关卡,大逃杀01,大逃杀02。
演示视频 : 训练.mp4 (25.03MB) / 死斗.mp4 (20.96MB) / 大逃杀01.mp4 (45.63MB) / 大逃杀02.mp4 (37.83MB)
六、Future Work
- 目前为止只实现了水面的Shading与水下的效果,对于水的表面形状与模型还没有更进一步的内容,以下是未来改进的方向 :
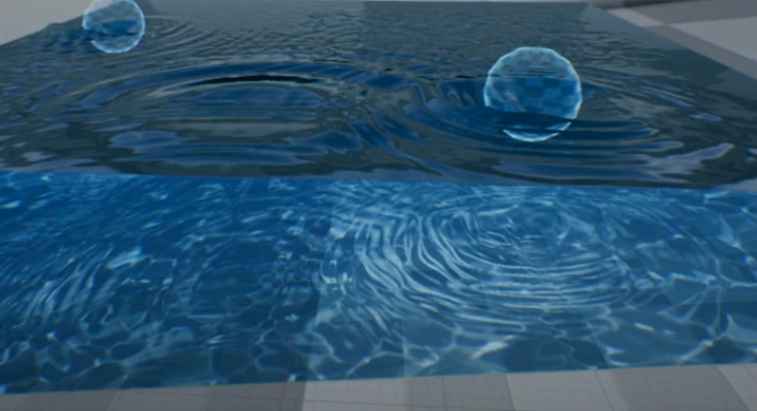
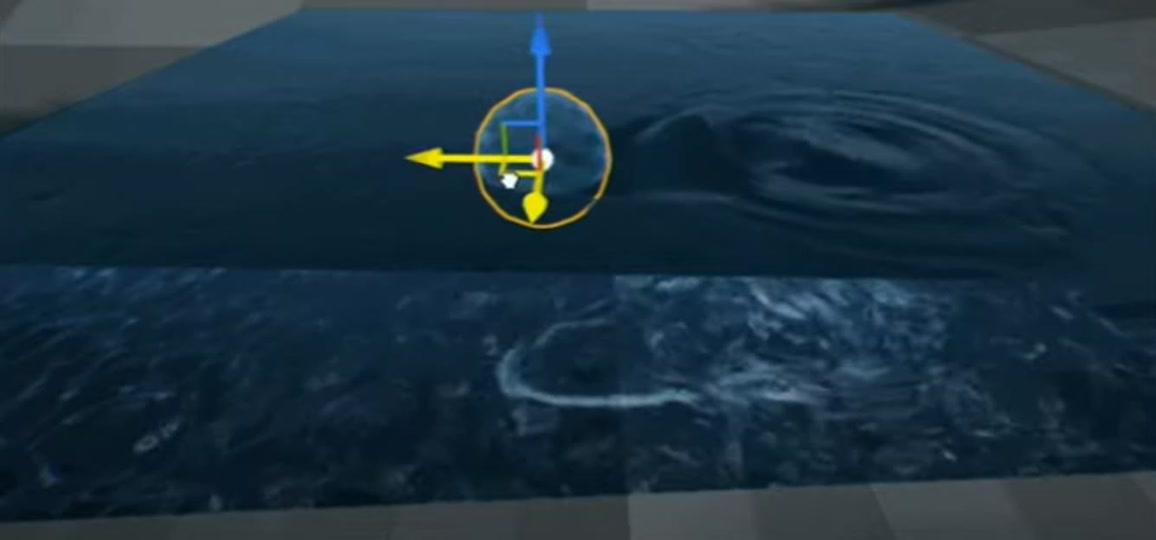
6.1 Fluid Diffusion Interactive
- 基于代理体的RT交替扩散模拟物体与水面交互的效果。正在进行中。
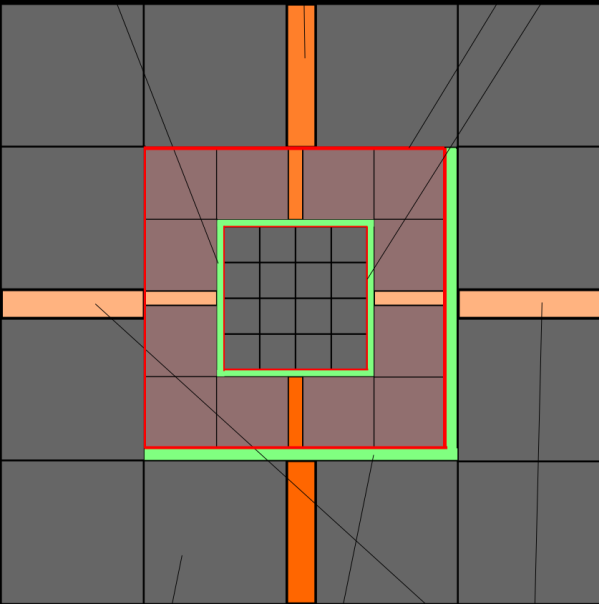
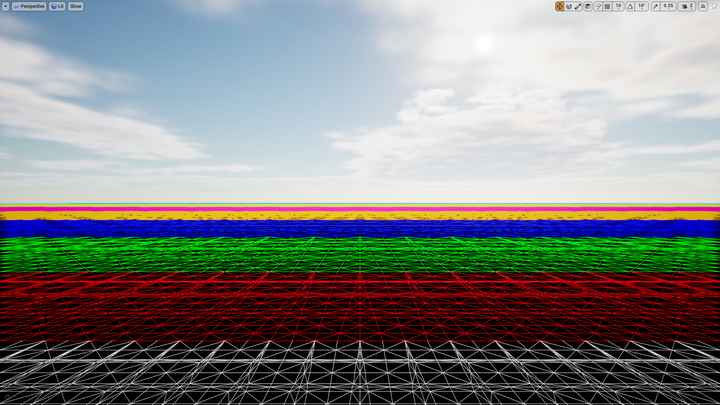
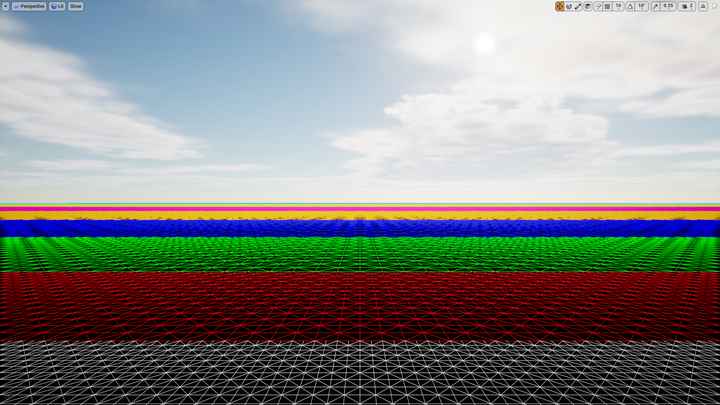
6.2 Continuous Distance Clipmap Mesh
- 基于Clipmap的无限水面网格建模,可保持实现任意高度任意距离的水面模型精度。
6.3 Light Projection Normal Distortion Caustics
- LightSpace采样NormalXY扰动Tiling Caustics实现Normal对焦散的影响。
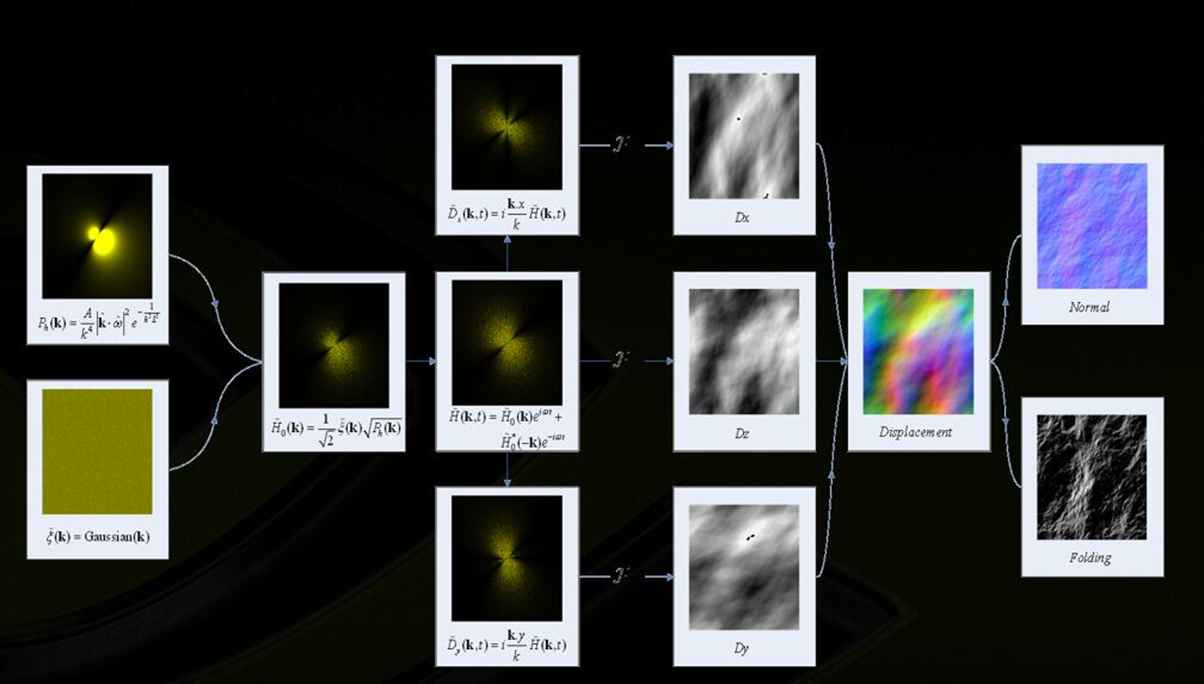
6.4 Inverse FFT Displacement & Normal & Folding
- 基于ComputeShader计算逆傅里叶变换海洋频谱得到更具细节的水面位移/法线与泡沫效果。